
Le 22 septembre 2026, deux modèles frontière ont atterri le même jour. OpenAI a livré GPT-6 Sol (gpt-6-sol), un spécialiste du codage et des agents au sein de la famille GPT-6, lancé aux côtés de GPT-6 Luna. Anthropic a livré Claude Opus 5.5 (claude-opus-5-5), successeur d'Opus 5 et positionné comme son modèle le plus complet à un prix inférieur. Si vous choisissez entre les deux cette semaine, vous ne comparez pas un gagnant et un perdant. Vous comparez deux théories distinctes de la tarification et du réglage d'un modèle.
En tant qu'ingénieur qui intègre quotidiennement des modèles de base dans des agents autonomes et des systèmes de recherche multi-pages, je n'évalue pas les modèles à leur lancement à partir de communiqués de presse. Ce qui suit repose sur les cartes de modèles et annonces officielles, ainsi que sur des mesures indépendantes publiées dans les premières 24 heures — chaque benchmark étant explicitement étiqueté par niveau d'effort, car c'est là que la plupart des comparaisons de lancement trichent en silence.
Si vous n'avez besoin que de la grille tarifaire de GPT-6 Sol, lisez notre guide des prix de GPT-6 Sol. Pour le lancement jumeau d'OpenAI, consultez notre analyse de GPT-6 Astra et la vue d'ensemble de GPT-6 Astra. Côté Anthropic, notre analyse de Claude Fable 5.1 couvre la gamme intermédiaire sur laquelle Opus 5.5 se situe désormais. Vous pouvez aussi consulter les spécifications brutes sur la page du modèle GPT-6 Sol (English) et la page du modèle Claude Opus 5.5 (English). Cet article est l'affrontement direct d'ingénierie.
Points essentiels
Le réglage par défaut d'un éditeur bat le maximum de l'autre : Claude Opus 5.5 à son niveau medium par défaut atteint 51,2 points d'Intelligence Index à 1,34 $ par tâche, au-dessus du réglage max de GPT-6 Sol (47,5 points, 1,06 $ par tâche). Au-dessus d'environ 44 points d'intelligence demandée, Opus 5.5 gagne à dépense comparable.
La remise de 2× de Sol a une expiration claire : les tarifs non mis en cache représentent la moitié de ceux d'Opus 5.5 (2,00 $/10,00 $ contre 4,00 $/20,00 $ par million de tokens), mais dès que l'entrée d'une requête dépasse 272K tokens, l'intégralité de la requête Sol bascule aux tarifs long contexte de 4,00 $/15,00 $ — parité, pas remise.
L'automatisation courante est le terrain de Sol : sur AutomationBench-AA, Sol en xhigh (61,7 %) égale Opus 5.5 en medium (61,2 %) pour un coût environ 40 % inférieur, et son niveau
nonedésactive entièrement la réflexion étendue.Le travail en terminal et le codage frontière appartiennent à Opus 5.5 : il mène Terminal-Bench 4.0 de 8,6 points même en medium (52,5 % contre 43,9 % pour Sol en max) ; Anthropic rapporte 66,4 % en xhigh.
La verbosité est une variable de facturation : en max, Opus 5.5 génère environ 119K tokens de sortie par tâche contre ~31K pour Sol. À 20 $ par million de tokens de sortie, cet écart de 3,8× se transforme en différence réelle de facture sur les tâches ouvertes.
Le nombre qui décide de ce match : le défaut bat le plafond
La tension centrale de cette comparaison est un duo que la couverture du lancement a largement manqué. Les mesures indépendantes au 23 septembre 2026 situent Claude Opus 5.5 à son medium par défaut à 51,2 points d'Intelligence Index, à 1,34 $ par tâche. GPT-6 Sol à son réglage le plus élevé, max, atteint 47,5 points à 1,06 $ par tâche.
Score par dollar (mesures indépendantes, 2026-09-23) :
Claude Opus 5.5  medium (PAR DÉFAUT) :  51,2 pts   1,34 $/tâche
GPT-6 Sol        max   (PLAFOND) :      47,5 pts   1,06 $/tâche

Croisement : en dessous de ~44 points d'intelligence demandée, Sol est moins cher ;
au-dessus, Opus 5.5 gagne clairement à dépense comparable.
La configuration d'usine d'un éditeur bat, au-dessus du croisement, le réglage maximal de l'autre à la fois en score et en score par dollar. C'est la paradoxe du « défaut bat le plafond », confirmé dans les tests communautaires précoces quelques heures après le lancement.
Le deuxième nombre décide où l'avantage de prix de Sol survit réellement. La grille d'OpenAI est propre : 2,00 $ d'entrée et 10,00 $ de sortie par million de tokens sur les requêtes standard à contexte court — exactement la moitié des 4,00 $/20,00 $ d'Opus 5.5. Mais la carte du modèle comporte un seuil que la plupart des gros titres ont ignoré : dès que l'entrée d'une requête dépasse 272K tokens, l'intégralité de la requête est facturée aux tarifs long contexte — 4,00 $ d'entrée, 0,40 $ de lecture cache, 5,00 $ d'écriture cache, 15,00 $ de sortie. À ce stade, Sol à l'intérieur de sa propre fenêtre de contexte annoncée de 1 050 000 tokens coûte autant ou plus qu'Opus 5.5, dont le contexte de 1M n'a pas de falaise équivalente.
Coût d'entrée effectif par 1M tokens :
En dessous de 272K d'entrée :  Sol 2,00 $  vs  Opus 5.5 4,00 $  --> Sol 2× moins cher
Au-dessus de 272K d'entrée :   Sol 4,00 $  vs  Opus 5.5 4,00 $  --> parité (sortie : 15 $ vs 20 $)
Si vos charges de travail sont des boucles d'agents à contextes compacts — le régime où vivent les systèmes de raisonnement agentique —, la remise de Sol est de l'argent réel. Si vos charges de travail remplissent le prompt avec des bases de code entières ou de longs corpus documentaires, la remise s'évapore exactement au moment où vous avez le plus besoin de la fenêtre de contexte.
Spécifications et tarifs en un coup d'œil
Les deux modèles annoncent un contexte d'un million de tokens et des niveaux d'effort échelonnés, mais les mécanismes diffèrent de façon importante pour l'ingénierie des coûts. Les tarifs ci-dessous sont en USD par million de tokens, vérifiés contre les deux cartes officielles le 23 septembre 2026.
| Dimension | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Identifiant API | gpt-6-sol | claude-opus-5-5 |
| Fenêtre de contexte | 1 050 000 tokens | 1 000 000 tokens |
| Sortie maximale | Pas de plafond séparé sous le contexte | 128 000 tokens (300K en bêta Batch) |
| Niveaux d'effort | none / low / medium (défaut) / high / xhigh / max | low / medium (défaut) / high / xhigh / max |
| Interrupteur de réflexion étendue | Désactivable (none) | Non désactivable |
| Entrée (non cachée) | 2,00 $ (4,00 $ au-delà de 272K) | 4,00 $ |
| Lecture cache d'entrée | 0,20 $ (0,40 $ au-delà de 272K) | 0,20 $ (~60 % de remise vs Opus 5) |
| Écriture cache d'entrée | 2,50 $ (5,00 $ au-delà de 272K) | 5,00 $ |
| Sortie | 10,00 $ (15,00 $ au-delà de 272K) | 20,00 $ |
| Tarif Batch | 50 % du standard (Flex) | 2,00 $ entrée / 10,00 $ sortie |
| Niveau rapide | 2× le standard | 8,00 $ / 40,00 $ (~2,5× la vitesse) |
| Coupure de connaissances | Génération de la famille GPT-6 | 2026-06 |
| Affirmation de coût de l'éditeur | — | ~40 % moins cher qu'Opus 5 sur charges typiques (chiffre éditeur) |
Trois détails d'ingénierie ressortent. Premièrement, le niveau none de Sol est unique : il désactive entièrement la réflexion étendue et offre un mode déterministe à faible latence qu'Opus 5.5 ne peut pas répliquer — sa réflexion est toujours active. Deuxièmement, les deux modèles facturent la lecture du cache à 0,20 $ par million : dans les pipelines de production à taux de réussite de cache élevé, le côté entrée de la facture est à égalité et la verbosité de sortie devient la variable décisive. Troisièmement, l'affirmation d'Anthropic « 40 % moins cher qu'Opus 5 » est un cadrage éditeur ; la recomposition communautaire couverte plus loin l'a trouvée proche du plat pour une charge réelle.
Un exemple chiffré rend la mécanique des niveaux concrète. Considérons un pipeline d'automatisation de 50 000 tâches par mois, chacune avec 40K tokens d'entrée (taux de réussite de cache de 90 %) et 2K tokens de sortie, alignées sur un niveau de classe medium, et entièrement sous le seuil de 272K :
GPT-6 Sol (par tâche : 4K d'entrée non cachée × 2,00 $ + 36K de lecture cache × 0,20 $ + 2K de sortie × 10,00 $) : 0,008 + 0,0072 + 0,020 = 0,0352 $ → 1 760 $ / mois
Claude Opus 5.5 (par tâche : 4K d'entrée non cachée × 4,00 $ + 36K de lecture cache × 0,20 $ + 2K de sortie × 20,00 $) : 0,016 + 0,0072 + 0,040 = 0,0632 $ → 3 160 $ / mois
Sol fait tourner le même pipeline pour environ 44 % de moins(soit 56 % de la facture d'Opus 5.5). Refaites le calcul avec 300K tokens d'entrée par tâche : l'intégralité de la requête Sol bascule aux tarifs long contexte (4,00 $ non caché / 0,40 $ lecture cache / 15,00 $ sortie), et le résultat est 12 900 $ contre 10 700 $ pour Opus 5.5 — le modèle nominalement moins cher coûte désormais 20 % de plus. Ce seuil n'est pas une note de bas de page ; c'est la variable décisive des architectures long contexte.
Benchmarks, et combien leur faire confiance
Les tableaux de benchmarks du jour du lancement sont des documents marketing tant que les laboratoires indépendants ne les reproduisent pas. Le tableau ci-dessous mélange des chiffres rapportés par les éditeurs (étiquetés) et des mesures indépendantes, et les notes de calibration qui suivent importent plus que n'importe quel chiffre isolé.
| Benchmark | Claude Opus 5.5 | GPT-6 Sol | Lecture |
|---|---|---|---|
| Intelligence Index (score / $ par tâche) | 51,2 / 1,34 $ (medium) | 47,5 / 1,06 $ (max) | Le défaut d'Opus au-dessus du plafond de Sol ; sous ~44 points Sol est moins cher |
| Terminal-Bench 4.0 | 52,5 % (medium) ; 66,4 % (xhigh, éditeur, ±2,6 EE) | 43,9 % (max) ; 44 % (indépendant) | Opus mène le travail agentique terminal/CLI de ~9 points à coût comparable |
| AutomationBench-AA | 61,2 % (medium) | 61,7 % (xhigh) | Égalité statistique ; Sol la livre ~40 % moins cher |
| GDPval-AA v2.1 | 1846 Elo (éditeur) | ~100 Elo de recul vs frontière (indépendant) | Opus plus fort sur les évaluations de travail du savoir |
| Humanity's Last Exam (avec outils) | 67,7 % (max, éditeur) | non vérifié indépendamment ce cycle | Directionnel seulement |
Avant de traiter l'une de ces lignes comme concluante, quatre mises en garde s'appliquent :
Le décalage de niveaux est la triche la plus courante. La plupart des chiffres de Sol en circulation au lancement venaient de max ou xhigh, tandis que ceux d'Opus venaient de son medium par défaut. Toute affirmation qui ne nomme pas les deux niveaux compare un réglage optimisé à un réglage non optimisé. Cet article nomme toujours le niveau.
Les chiffres d'éditeur portent l'optimisme de l'éditeur. Les 66,4 % de Terminal-Bench et 67,7 % de HLE d'Opus 5.5 sont rapportés par Anthropic dans des conditions nommées ; le chiffre de Terminal-Bench porte une erreur standard de ±2,6. Les 1,06 $ par tâche et les chiffres d'hallucination de Sol sont mesurés indépendamment par Artificial Analysis. Accordez plus de poids aux chiffres indépendants.
L'amélioration d'hallucination de Sol est en partie de l'abstention. La mesure indépendante montre le taux d'hallucination de Sol passer de 92 % à 60 % — mais obtenu en grande partie en refusant de répondre plus souvent. Dans un pipeline d'agents, une abstention n'est pas gratuite : elle se manifeste comme une tâche bloquée ou une escalade humaine, que les pourcentages de benchmark masquent.
La verbosité amplifie la prime de tarif de sortie d'Opus. En max, Opus 5.5 produit ~119K tokens de sortie par tâche contre ~31K pour Sol. Combinée à un tarif de sortie de 20 $/M contre 10 $/M, les tâches ouvertes sur Opus à effort élevé peuvent coûter plusieurs fois plus que le ratio des tarifs ne le suggère. Aux niveaux inférieurs, l'écart se rétrécit sensiblement.
Où Claude Opus 5.5 gagne vraiment
Opus 5.5 n'est pas le modèle le moins cher, et il n'essaie pas de l'être. Il gagne là où le plafond de qualité des tâches, et non la facture, est la contrainte contraignante.
1. Travail agentique en terminal et codage frontière
L'avantage structurel le plus clair se situe sur Terminal-Bench 4.0, qui mesure l'ingénierie logicielle autonome en ligne de commande. Opus 5.5 en medium atteint 52,5 % ; Sol en max parvient à 43,9 %. C'est un écart relatif de ~17 % sur la classe de charge exacte — environnements shell multi-étapes, boucles de construction et correction, réparation pilotée par les tests — que les deux éditeurs ciblent explicitement avec ces lancements. Le chiffre xhigh d'Anthropic, 66,4 %, creuse encore l'écart, avec la réserve de chiffre d'éditeur déjà mentionnée.
2. Travail du savoir et évaluations d'intelligence générale
Sur GDPval-AA v2.1, une évaluation professionnelle du travail du savoir, Anthropic rapporte 1846 Elo. La mesure indépendante a trouvé que Sol recule d'environ 100 Elo face à des modèles frontière comparables sur la même famille d'évaluations. C'est cohérent avec le positionnement de Sol : un spécialiste du codage et de l'automatisation qui échange l'amplitude du savoir général contre l'efficacité de coût. En synthèse de recherche, analyse documentaire et raisonnement à domaine ouvert, le plafond d'Opus 5.5 est plus haut. Notre couverture de l'intermédiaire Claude Fable 5.1 donne un contexte utile sur la distance à laquelle cette famille a poussé la capacité générale sous le prix d'Opus.
3. L'expérience du niveau par défaut
La caractéristique la plus sous-estimée d'Opus 5.5 est que son défaut est son réglage fort. Le niveau medium bat le max de Sol en score par dollar au-dessus du croisement, ce qui signifie que les équipes sans appétit pour l'ajustement des niveaux d'effort obtiennent un comportement frontière dès la sortie de la boîte. La meilleure valeur de Sol exige une configuration délibérée : choisir none pour les tâches déterministes, xhigh pour l'automatisation, et accepter que max reste derrière le défaut d'Opus en capacité générale.
Où GPT-6 Sol gagne vraiment
Le cas de Sol n'est pas « presque aussi bon pour moins cher ». C'est une architecture de coût différente avec trois avantages concrets.
1. Exactement la moitié du tarif affiché, avec un interrupteur d'arrêt de la réflexion
À 2,00 $ d'entrée et 10,00 $ de sortie par million de tokens sans cache à contexte court, Sol coûte 50 % de moins qu'Opus 5.5 — et il offre quelque chose qu'aucun concurrent frontière n'a : un niveau none qui désactive entièrement la réflexion étendue. Pour l'extraction structurée à haut volume, la classification et la génération par gabarits, payer pour un modèle qui ne peut pas arrêter de réfléchir est du gaspillage. Sol vous permet de fermer le compteur de raisonnement. Pour une comparaison transversale de cette grille avec d'autres éditeurs, notre analyse des prix de Kimi K3 utilise la même méthode de coût total.
2. Efficience de coût en automatisation là où la capacité égale
Sur AutomationBench-AA, Sol en xhigh atteint 61,7 % contre 61,2 % pour Opus 5.5 en medium : une égalité statistique livrée pour environ 40 % de moins par tâche. Si votre pipeline est de l'automatisation de navigateur, de l'extraction DOM, de la navigation de formulaires et de l'orchestration d'outils, Sol est le choix rationnel par défaut : la capacité est identique, la facture ne l'est pas.
3. Discipline de sortie
Sol génère environ 31K tokens de sortie par tâche en max, contre ~119K pour Opus 5.5. Pour les agents qui doivent produire des artefacts bornés — charges utiles JSON, diffs de correctifs, résumés structurés —, la concision de Sol est une fonctionnalité, pas une limitation : moins de tokens à analyser, moins de tokens facturés et moins de surface pour les boucles de correction a posteriori.
Ce que la communauté et les développeurs disent vraiment
Dans les 24 heures qui ont suivi le double lancement, les forums de développeurs ont produit plus de signal que la plupart de la couverture du jour J. Six voix représentatives, collectées le 23 septembre 2026 :
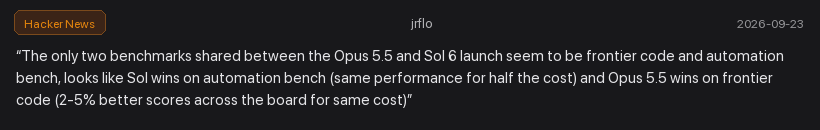
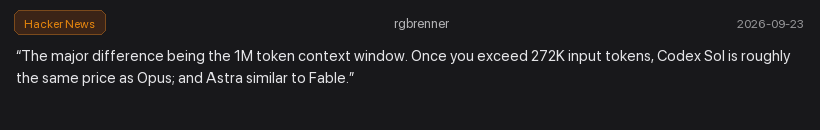
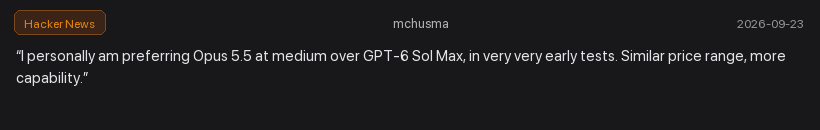
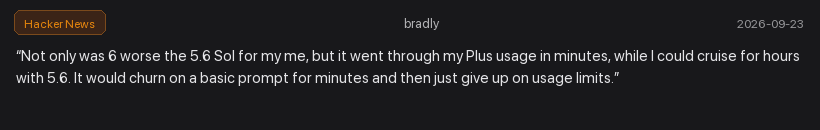
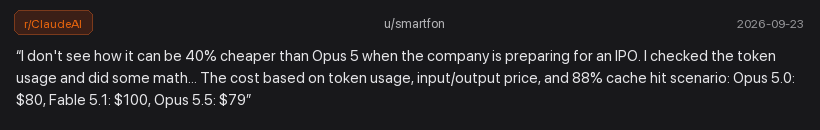
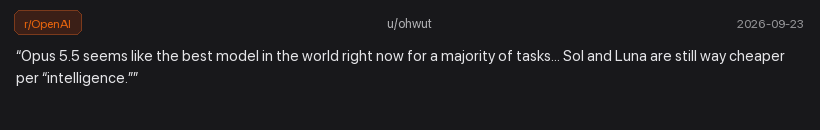
Le motif à travers ces six voix est cohérent avec les données mesurées : la communauté n'a pas couronné de gagnant unique. Elle s'est scindée le long des frontières de charge de travail — automatisation et efficience de coût vers Sol, codage frontière et capacité générale vers Opus 5.5 — et s'est concentrée immédiatement sur l'alignement des niveaux et la comptabilité du coût total, plutôt que sur la position brute au classement.
Le verdict : matrice de décision par charge de travail
| Profil de charge de travail | Modèle recommandé | Raison décisive | Note de coût |
|---|---|---|---|
| Agents de terminal et codage piloté par CLI | Claude Opus 5.5 | Avance de ~9 points sur Terminal-Bench 4.0 en medium (52,5 % contre 43,9 % pour Sol max) | Tarif 2×, justifié par l'écart de capacité |
| Automatisation et extraction web à haut volume | GPT-6 Sol | Égalité sur AutomationBench-AA (61,7 % xhigh contre 61,2 % medium), avec none pour les tâches déterministes | ~40 % moins cher par tâche |
| Boucles d'agents à contexte compact (entrée < 272K) | GPT-6 Sol | La remise non cachée de 2× survit entièrement ; lectures de cache au même prix (0,20 $/M) | La moitié du tarif d'Opus 5.5 |
| Travaux long contexte (entrée > 272K) | Claude Opus 5.5 | Le basculement long contexte de Sol (4 $/15 $) efface sa remise ; Opus n'a pas de falaise équivalente | Parité ou mieux face aux tarifs basculés de Sol |
| Recherche ouverte et travail du savoir | Claude Opus 5.5 | Plafond plus haut sur GDPval-AA et HLE ; le medium par défaut bat Sol max au-dessus de ~44 points | Taxe de verbosité plus élevée en max |
| Assistant général à budget limité | GPT-6 Sol | Intelligence Index de 1,06 $ par tâche en max ; le moins cher sous le croisement de ~44 points | Coût minimal par unité d'intelligence |
Des tokens bruts à l'exécution dans le navigateur : le flux Tabbit
Un score de benchmark ne scrape pas un site web, ne maintient pas une session authentifiée et ne concilie pas une documentation contradictoire entre quarante onglets ouverts. Les modèles de base bruts raisonnent sur du texte ; ils ne gèrent pas par eux-mêmes l'empilement d'onglets, les shadow DOM dynamiques ou les flux web multi-étapes.
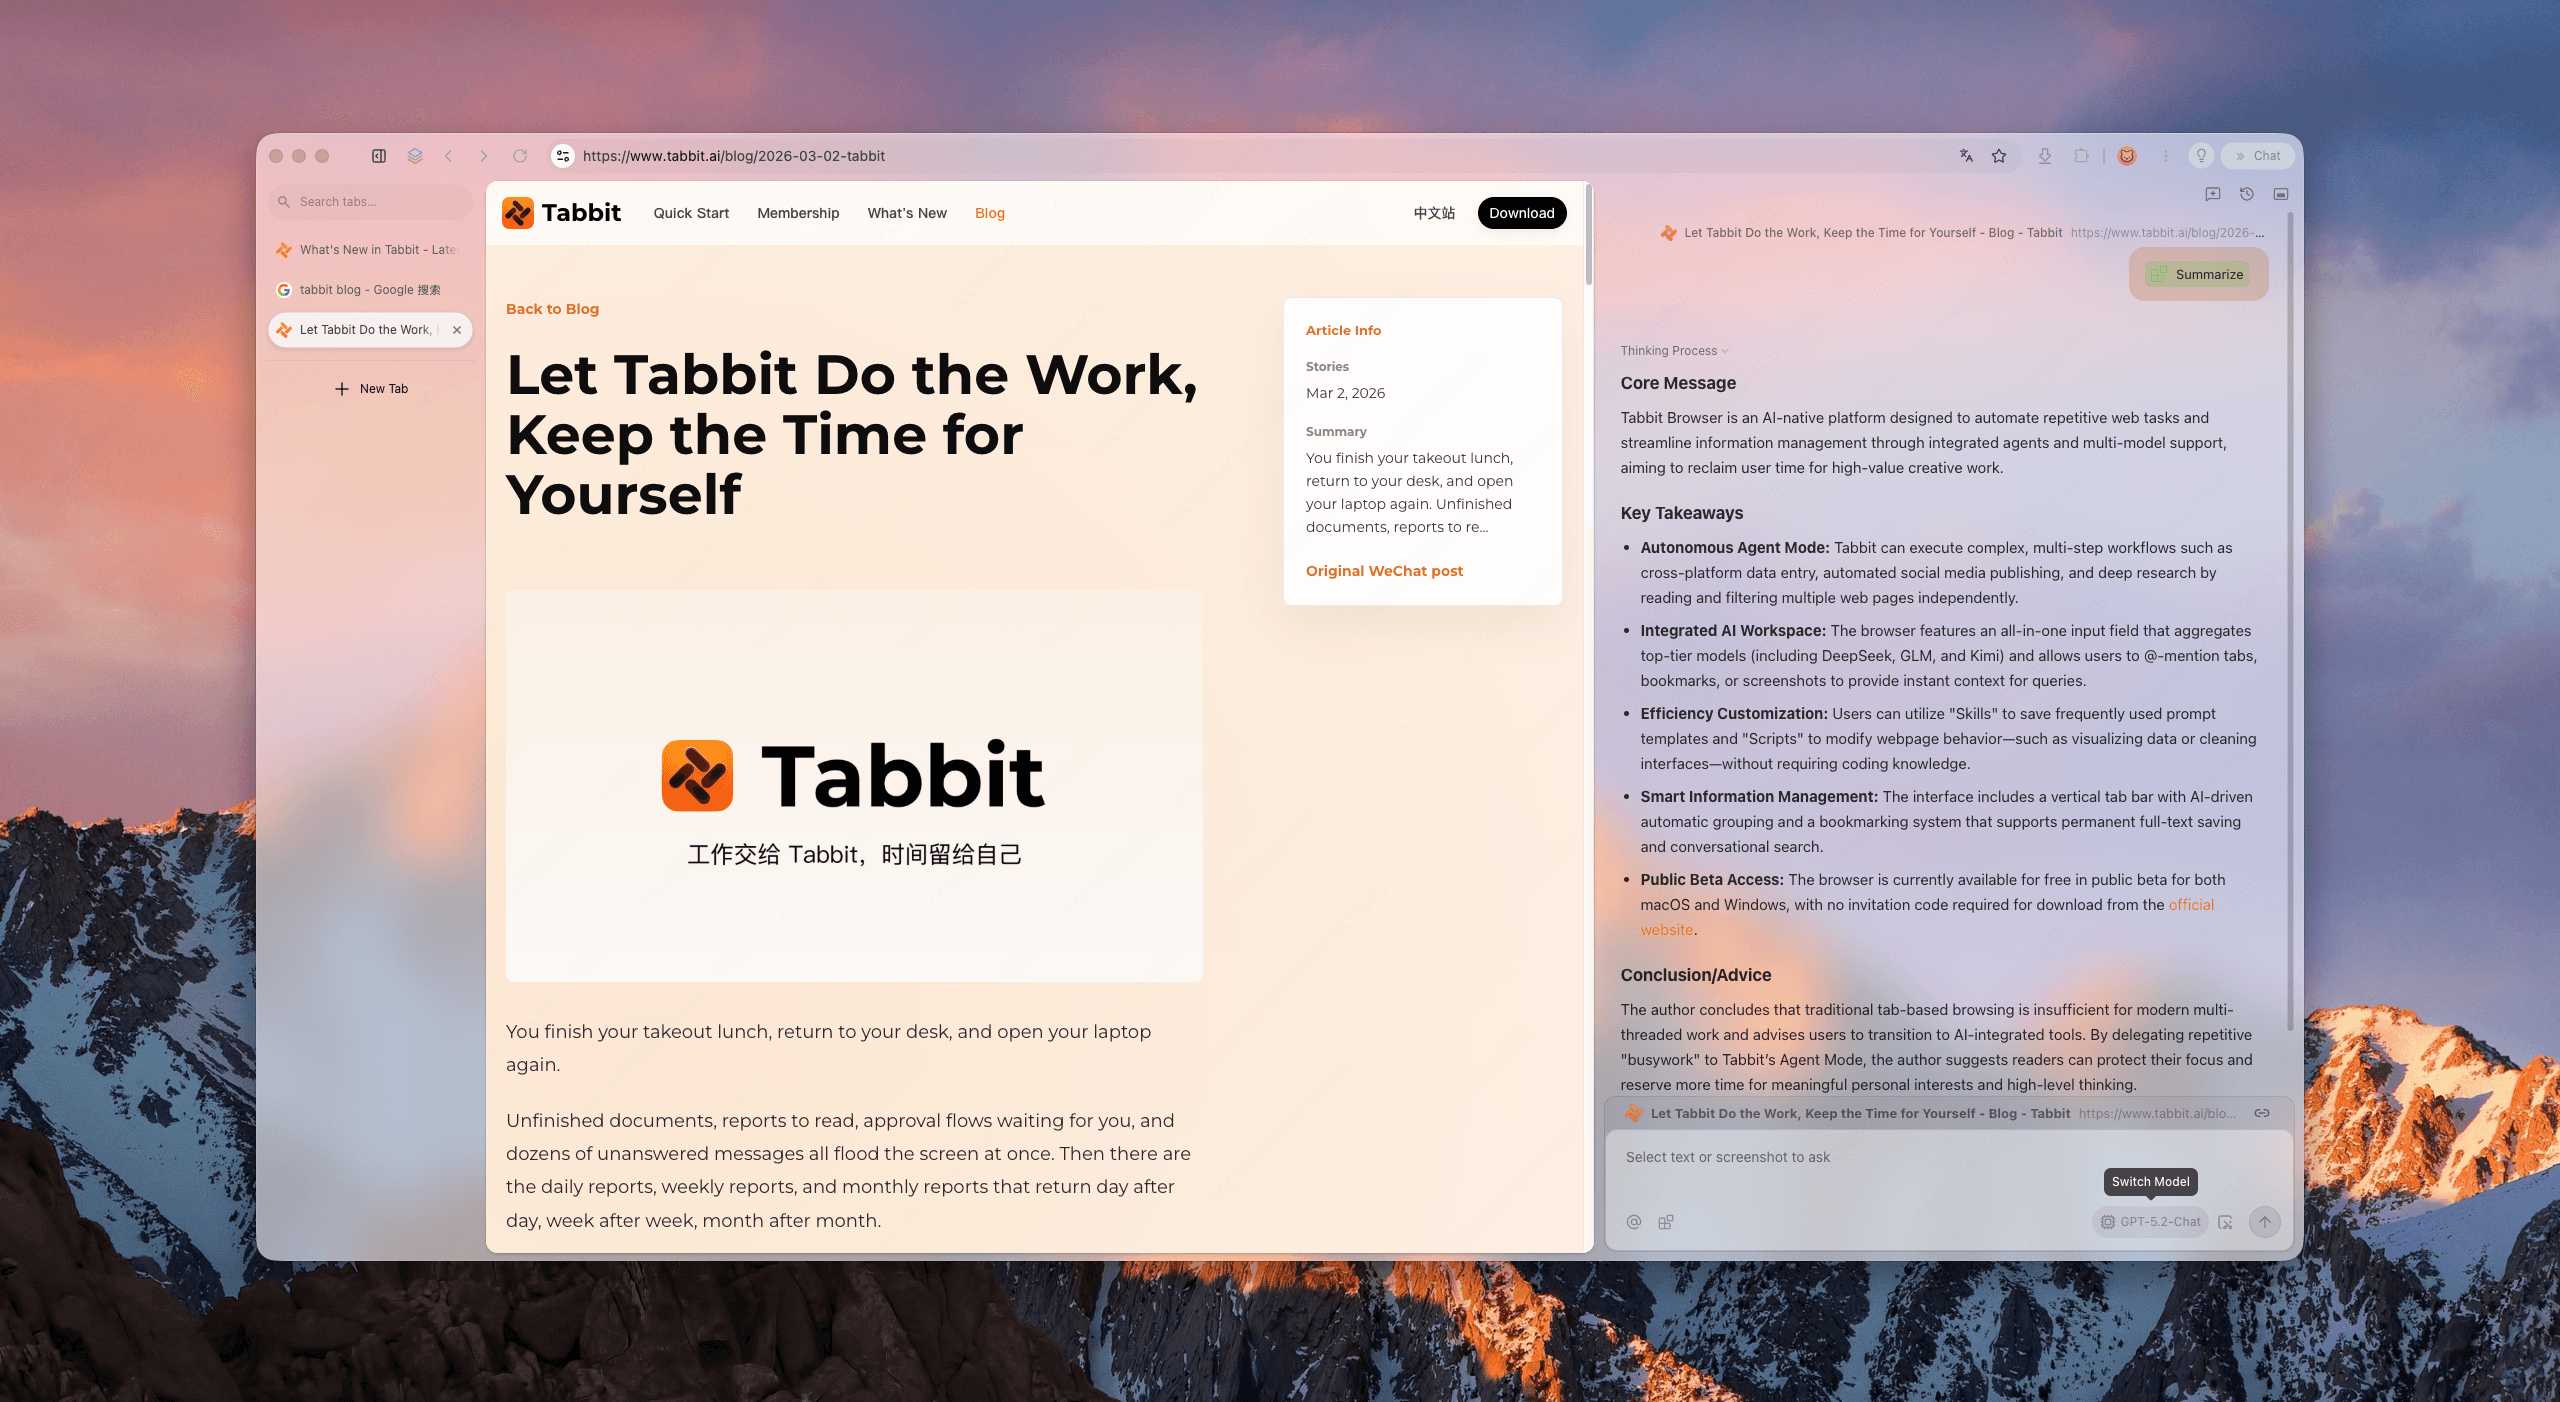
C'est là que les environnements d'orchestration comptent. En exécutant des agents de navigateur dans Tabbit Browser, le modèle fournit le raisonnement tandis que la couche navigateur fournit la mémoire, la navigation et l'exécution. Que vous dirigiez des boucles d'automatisation compactes via GPT-6 Sol ou des agents de codage de niveau terminal via Claude Opus 5.5, un navigateur agentique natif IA est ce qui transforme le prix des tokens en travail achevé. Consultez notre sélection des meilleurs navigateurs IA de 2026 pour le panorama complet.
Remarque : conformément à nos politiques de plateforme, la disponibilité des modèles en direct dans Tabbit dépend du sélecteur de modèles actif de votre compte, des intégrations prises en charge et des conditions de la plateforme. Cette comparaison repose sur des documents officiels et des mesures indépendantes, et non sur des exécutions de benchmark en interne.
 Tabbit Browser

Questions fréquentes
Lequel est le moins cher, GPT-6 Sol ou Claude Opus 5.5 ?
Sur les tarifs non mis en cache à contexte court, GPT-6 Sol coûte exactement la moitié : 2,00 $ d'entrée et 10,00 $ de sortie par million de tokens, contre 4,00 $ et 20,00 $ pour Claude Opus 5.5. Cependant, dès que l'entrée d'une requête dépasse 272K tokens, l'intégralité de la requête Sol est facturée aux tarifs long contexte (4,00 $ d'entrée / 15,00 $ de sortie), ce qui efface la remise. La lecture du cache coûte 0,20 $ par million sur les deux modèles.
Quel modèle obtient les meilleurs scores aux benchmarks ?
Cela dépend du niveau d'effort comparé. Claude Opus 5.5 à son niveau medium par défaut atteint 51,2 points d'Intelligence Index à 1,34 $ par tâche, au-dessus des 47,5 points de GPT-6 Sol à son niveau max à 1,06 $. Opus 5.5 mène aussi Terminal-Bench 4.0 (52,5 % en medium, 66,4 % en xhigh selon Anthropic) contre 43,9 % pour Sol en max, tandis que Sol égale Opus medium sur AutomationBench-AA pour un coût environ 40 % inférieur.
Quels sont les niveaux d'effort de GPT-6 Sol et de Claude Opus 5.5 ?
GPT-6 Sol propose none, low, medium (par défaut), high, xhigh et max — le niveau none désactive entièrement la réflexion étendue. Claude Opus 5.5 propose low, medium (par défaut), high, xhigh et max, et sa réflexion étendue ne peut pas être désactivée. Le niveau d'effort modifie à la fois la capacité et le coût par tâche : toute comparaison doit donc nommer les niveaux utilisés.
Pourquoi tant de comparaisons opposent-elles Opus 5.5 medium à GPT-6 Sol max ?
Parce que ce sont les réglages où le coût total par tâche des deux modèles se rapproche le plus. Les mesures à coût aligné montrent qu'Opus 5.5 en medium dépasse Sol en max au-dessus d'environ 44 points d'intelligence demandée, tandis que Sol devient l'option la moins chère en dessous de ce seuil. Les comparaisons qui ne nomment pas les deux niveaux relèvent du marketing, pas de la mesure.
Claude Opus 5.5 est-il vraiment 40 % moins cher que Claude Opus 5 ?
C'est le chiffre rapporté par Anthropic pour des charges de travail typiques. Une recomposition communautaire à partir de journaux d'utilisation réels avec un taux de réussite de cache de 88 % aboutit à environ 79 $ par unité de travail sur Opus 5.5 contre 80 $ sur Opus 5.0 — à plat, et non 40 % moins cher. Les affirmations de coût des éditeurs doivent être traitées comme indicatives.
Puis-je utiliser GPT-6 Sol et Claude Opus 5.5 dans Tabbit Browser ?
Tabbit Browser fournit un espace de travail natif IA pour la recherche, l'extraction de données et la comparaison multi-modèles. La disponibilité de modèles précis dans Tabbit dépend du sélecteur de modèles en direct de votre compte et des conditions de la plateforme.