
El 22 de septiembre de 2026, dos modelos frontera aterrizaron el mismo día. OpenAI lanzó GPT-6 Sol (gpt-6-sol), un especialista en codificación y agentes dentro de la familia GPT-6, publicado junto a GPT-6 Luna. Anthropic lanzó Claude Opus 5.5 (claude-opus-5-5), sucesor de Opus 5 y posicionado como su modelo más completo a un precio menor. Si estás eligiendo entre ambos esta semana, no estás comparando un ganador y un perdedor. Estás comparando dos teorías distintas sobre cómo se debe fijar el precio y ajustar un modelo.
Como ingeniero que conecta modelos de base en agentes autónomos y sistemas de investigación multipágina a diario, no evalúo modelos de lanzamiento a partir de notas de prensa. Lo que sigue se basa en las tarjetas de modelo y anuncios oficiales, más mediciones independientes publicadas en las primeras 24 horas, con cada benchmark etiquetado explícitamente por nivel de esfuerzo, porque es donde la mayoría de las comparaciones de lanzamiento hacen trampa en silencio.
Si solo necesitas la tarifa de GPT-6 Sol, lee nuestra guía de precios de GPT-6 Sol. Para el lanzamiento hermano de OpenAI, consulta nuestro análisis de GPT-6 Astra y la visión general de GPT-6 Astra. En el lado de Anthropic, nuestro análisis de Claude Fable 5.1 cubre la línea media sobre la que ahora se sitúa Opus 5.5. También puedes consultar las especificaciones en la página del modelo GPT-6 Sol (English) y la página del modelo Claude Opus 5.5 (English). Este artículo es el enfrentamiento directo de ingeniería.
Conclusiones clave
El ajuste predeterminado de un fabricante supera el máximo del otro: Claude Opus 5.5 en su nivel medium predeterminado alcanza 51.2 puntos del Intelligence Index a $1.34 por tarea, por encima del ajuste max de GPT-6 Sol (47.5 puntos, $1.06 por tarea). Por encima de unos 44 puntos de inteligencia demandada, Opus 5.5 gana con un gasto comparable.
El descuento del 2× de Sol tiene una caducidad clara: las tarifas sin caché son la mitad que las de Opus 5.5 ($2.00/$10.00 frente a $4.00/$20.00 por millón de tokens), pero cuando la entrada de una solicitud supera los 272K tokens, toda la solicitud de Sol pasa a tarifas de contexto largo de $4.00/$15.00: paridad, no descuento.
La automatización rutinaria es el territorio de Sol: en AutomationBench-AA, Sol en xhigh (61.7%) iguala a Opus 5.5 en medium (61.2%) con un coste aproximadamente 40% menor, y su nivel
nonedesactiva completamente el razonamiento extendido.El trabajo en terminal y la codificación frontera pertenecen a Opus 5.5: lidera Terminal-Bench 4.0 por 8.6 puntos incluso en medium (52.5% frente al 43.9% de Sol en max); Anthropic reporta un 66.4% en xhigh.
La verbosidad es una variable de facturación: en max, Opus 5.5 genera unos 119K tokens de salida por tarea frente a unos 31K de Sol. A $20 por millón de tokens de salida, esa brecha de 3.8× se convierte en una diferencia real de factura en tareas abiertas.
El número que decide este enfrentamiento: el predeterminado supera al máximo
La tensión central de esta comparación es un emparejamiento que la cobertura de lanzamiento pasó por alto. Las mediciones independientes a 23 de septiembre de 2026 sitúan a Claude Opus 5.5 en su medium predeterminado en 51.2 puntos del Intelligence Index, a $1.34 por tarea. GPT-6 Sol en su ajuste más alto, max, alcanza 47.5 puntos a $1.06 por tarea.
Puntos por dólar (mediciones independientes, 2026-09-23):
Claude Opus 5.5  medium (PREDETERMINADO):  51.2 pts   $1.34/tarea
GPT-6 Sol        max   (MÁXIMO):           47.5 pts   $1.06/tarea

Punto de cruce: por debajo de ~44 puntos de inteligencia demandada Sol es más barato;
por encima, Opus 5.5 gana claramente con un gasto comparable.
La configuración de serie de un fabricante supera en puntos y en puntos por dólar, por encima del cruce, al ajuste máximo del otro. Esta es la paradoja del "predeterminado supera al máximo", y se confirmó en las pruebas tempranas de la comunidad a las pocas horas del lanzamiento.
El segundo número decide dónde sobrevive realmente la ventaja de precio de Sol. La tarifa de OpenAI es limpia: $2.00 de entrada y $10.00 de salida por millón de tokens en solicitudes estándar de contexto corto, exactamente la mitad de los $4.00/$20.00 de Opus 5.5. Pero la tarjeta del modelo incluye un umbral que la mayoría de los titulares omitieron: una vez que la entrada de una solicitud supera los 272K tokens, toda la solicitud se factura a tarifas de contexto largo: $4.00 de entrada, $0.40 de lectura en caché, $5.00 de escritura en caché y $15.00 de salida. En ese punto, Sol dentro de su propia ventana de contexto publicitada de 1,050,000 tokens cuesta lo mismo o más que Opus 5.5, cuyo contexto de 1M no tiene un precipicio equivalente.
Coste efectivo de entrada por 1M tokens:
Por debajo de 272K de entrada:  Sol $2.00  vs  Opus 5.5 $4.00  --> Sol 2× más barato
Por encima de 272K de entrada:  Sol $4.00  vs  Opus 5.5 $4.00  --> paridad (salida: $15 vs $20)
Si tus cargas de trabajo son bucles de agentes con contextos compactos —el régimen donde viven los sistemas de razonamiento agéntico—, el descuento de Sol es dinero real. Si tus cargas de trabajo llenan el prompt con bases de código enteras o corpus documentales largos, el descuento se evapora justo cuando más necesitas la ventana de contexto.
Especificaciones y precios de un vistazo
Ambos modelos anuncian contexto de un millón de tokens y niveles de esfuerzo escalonados, pero las mecánicas difieren de forma relevante para la ingeniería de costes. Las tarifas siguientes son en USD por millón de tokens, verificadas contra ambas tarjetas oficiales el 23 de septiembre de 2026.
| Dimensión | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Identificador de API | gpt-6-sol | claude-opus-5-5 |
| Ventana de contexto | 1,050,000 tokens | 1,000,000 tokens |
| Salida máxima | Sin límite independiente por debajo del contexto | 128,000 tokens (300K en beta Batch) |
| Niveles de esfuerzo | none / low / medium (predeterminado) / high / xhigh / max | low / medium (predeterminado) / high / xhigh / max |
| Interruptor de razonamiento extendido | Se puede desactivar (none) | No se puede desactivar |
| Entrada (sin caché) | $2.00 ($4.00 por encima de 272K) | $4.00 |
| Lectura de caché de entrada | $0.20 ($0.40 por encima de 272K) | $0.20 (~60% de descuento frente a Opus 5) |
| Escritura de caché de entrada | $2.50 ($5.00 por encima de 272K) | $5.00 |
| Salida | $10.00 ($15.00 por encima de 272K) | $20.00 |
| Precio Batch | 50% del estándar (Flex) | $2.00 entrada / $10.00 salida |
| Nivel rápido | 2× el estándar | $8.00 / $40.00 (~2.5× de velocidad) |
| Corte de conocimiento | Generación de la familia GPT-6 | 2026-06 |
| Afirmación de coste del fabricante | — | ~40% más barato que Opus 5 en cargas típicas (dato del fabricante) |
Destacan tres detalles de ingeniería. Primero, el nivel none de Sol es único: desactiva el razonamiento extendido por completo y ofrece un modo determinista de baja latencia que Opus 5.5 no puede replicar, pues su razonamiento siempre está activo. Segundo, ambos modelos facturan la lectura de caché a $0.20 por millón, así que en tuberías productivas con alta tasa de acierto de caché, el lado de entrada de la factura queda en tablas y la verbosidad de salida se convierte en la variable decisiva. Tercero, la afirmación de Anthropic del "40% más barato que Opus 5" es un marco de fabricante; la recomputación comunitaria que se cubre más adelante la encontró prácticamente plana en una carga real.
Un ejemplo numérico concreto aclara la mecánica de niveles. Considera una tubería de automatización de 50,000 tareas al mes, cada una con 40K tokens de entrada (90% de acierto de caché) y 2K tokens de salida, alineada a un nivel medio y por debajo del umbral de 272K:
GPT-6 Sol (por tarea: 4K de entrada sin caché × $2.00 + 36K de lectura de caché × $0.20 + 2K de salida × $10.00): $0.008 + $0.0072 + $0.020 = $0.0352 → $1,760 al mes
Claude Opus 5.5 (por tarea: 4K de entrada sin caché × $4.00 + 36K de lectura de caché × $0.20 + 2K de salida × $20.00): $0.016 + $0.0072 + $0.040 = $0.0632 → $3,160 al mes
Sol ejecuta la misma tubería aproximadamente un 44% más barato(cerca del 56% de la factura de Opus 5.5). Ahora repite el cálculo con 300K tokens de entrada por tarea: toda la solicitud de Sol pasa a tarifas de contexto largo ($4.00 sin caché / $0.40 de lectura en caché / $15.00 de salida), y el resultado es $12,900 frente a $10,700 de Opus 5.5: el modelo nominalmente más barato cuesta ahora un 20% más. El umbral no es una nota al pie; es la variable decisiva de las arquitecturas de contexto largo.
Benchmarks, y cuánto fiarse de ellos
Las tablas de benchmarks de lanzamiento son documentos de marketing hasta que los laboratorios independientes los reproducen. La tabla siguiente mezcla cifras reportadas por los fabricantes (etiquetadas) con mediciones independientes, y las notas de calibración que siguen importan más que cualquier número aislado.
| Benchmark | Claude Opus 5.5 | GPT-6 Sol | Lectura |
|---|---|---|---|
| Intelligence Index (puntos / $ por tarea) | 51.2 / $1.34 (medium) | 47.5 / $1.06 (max) | El predeterminado de Opus supera el máximo de Sol; por debajo de ~44 puntos Sol es más barato |
| Terminal-Bench 4.0 | 52.5% (medium); 66.4% (xhigh, fabricante, ±2.6 EE) | 43.9% (max); 44% (independiente) | Opus lidera el trabajo agéntico en terminal/CLI por ~9 puntos a coste similar |
| AutomationBench-AA | 61.2% (medium) | 61.7% (xhigh) | Empate estadístico; Sol lo entrega ~40% más barato |
| GDPval-AA v2.1 | 1846 Elo (fabricante) | ~100 Elo de retroceso frente a frontera (independiente) | Opus es más fuerte en evaluaciones de trabajo de conocimiento |
| Humanity's Last Exam (con herramientas) | 67.7% (max, fabricante) | sin verificación independiente este ciclo | Solo orientativo |
Antes de tomar cualquiera de estas cifras como concluyente, aplican cuatro advertencias de calibración:
La falta de alineación de niveles es el truco más común. La mayoría de los números de Sol que circularon en el lanzamiento procedían de max o xhigh, mientras que los de Opus venían de su medium predeterminado. Cualquier afirmación que no nombre ambos niveles compara un ajuste tuneado con uno sin tunear. Este artículo siempre nombra el nivel.
Los datos de fabricante llevan el optimismo de fabricante. Las cifras de Terminal-Bench 66.4% y HLE 67.7% de Opus 5.5 son reportadas por Anthropic bajo condiciones nombradas; la de Terminal-Bench lleva un error estándar de ±2.6. Los $1.06 por tarea y las cifras de alucinación de Sol están medidos de forma independiente por Artificial Analysis. Dale más peso a los números independientes.
La mejora de alucinación de Sol es en parte abstención. La medición independiente muestra que la tasa de alucinación de Sol baja del 92% al 60%, pero lograda en gran parte rechazando responder más a menudo. En una tubería de agentes, una abstención no es gratis: se manifiesta como una tarea atascada o una escalada a un humano, algo que los porcentajes de benchmark ocultan.
La verbosidad amplifica la prima de tarifa de salida de Opus. En max, Opus 5.5 produce ~119K tokens de salida por tarea frente a ~31K de Sol. Combinado con una tarifa de salida de $20/M frente a $10/M, las tareas abiertas en Opus con esfuerzo alto pueden costar varias veces más de lo que sugiere la proporción de tarifas. En niveles bajos la brecha se estrecha sustancialmente.
Donde Claude Opus 5.5 gana de verdad
Opus 5.5 no es el modelo más barato, y no pretende serlo. Gana donde el límite de calidad de la tarea, y no la factura, es la restricción vinculante.
1. Trabajo agéntico en terminal y codificación frontera
La ventaja estructural más clara está en Terminal-Bench 4.0, que mide ingeniería de software autónoma en línea de comandos. Opus 5.5 en medium logra un 52.5%; Sol en max alcanza un 43.9%. Es una brecha relativa del ~17% en la clase de carga exacta —entornos shell multipaso, bucles de construcción y corrección, reparación dirigida por pruebas— a la que ambos fabricantes apuntan explícitamente con estos lanzamientos. La cifra de xhigh de Anthropic, 66.4%, amplía la brecha, aunque con la advertencia de dato de fabricante ya mencionada.
2. Trabajo de conocimiento y evaluaciones de inteligencia general
En GDPval-AA v2.1, una evaluación de trabajo profesional del conocimiento, Anthropic reporta 1846 Elo. La medición independiente encontró que Sol retrocede unos 100 Elo frente a modelos frontera comparables en la misma familia de evaluaciones. Esto es coherente con el posicionamiento de Sol: un especialista en codificación y automatización que cambia amplitud de conocimiento general por eficiencia de coste. En síntesis de investigación, análisis documental y razonamiento de dominio abierto, el techo de Opus 5.5 es más alto. Nuestra cobertura del nivel medio Claude Fable 5.1 da contexto sobre hasta dónde ha empujado esa familia la capacidad general por debajo del precio de Opus.
3. La experiencia del nivel predeterminado
La característica más infravalorada de Opus 5.5 es que su predeterminado es su ajuste fuerte. El nivel medium supera en puntos por dólar al max de Sol por encima del cruce, lo que significa que los equipos sin presupuesto para ajustar niveles de esfuerzo obtienen comportamiento frontera desde el primer momento. El mejor valor de Sol exige configuración deliberada: elegir none para tareas deterministas, xhigh para automatización, y aceptar que max sigue por detrás del predeterminado de Opus en capacidad general.
Donde GPT-6 Sol gana de verdad
El caso de Sol no es "casi igual de bueno por menos dinero". Es una arquitectura de coste diferente con tres ventajas concretas.
1. Exactamente la mitad en tarifa, con interruptor de apagado del razonamiento
A $2.00 de entrada y $10.00 de salida por millón de tokens sin caché de contexto corto, Sol cuesta un 50% menos que Opus 5.5, y ofrece algo que ningún competidor frontera tiene: un nivel none que desactiva el razonamiento extendido por completo. Para extracción estructurada de alto volumen, clasificación y generación por plantillas, pagar por un modelo que no puede dejar de pensar es un desperdicio. Sol te permite cerrar el medidor de razonamiento. Para una comparación transversal de estas tarifas con otros fabricantes, nuestro análisis de precios de Kimi K3 usa el mismo método de coste total.
2. Eficiencia de coste en automatización donde la capacidad empata
En AutomationBench-AA, Sol en xhigh anota un 61.7% frente al 61.2% de Opus 5.5 en medium: un empate estadístico entregado a un coste aproximadamente 40% menor por tarea. Si tu tubería es automatización de navegador, extracción DOM, navegación de formularios y orquestación de herramientas, Sol es la opción racional por defecto: la capacidad es idéntica y la factura no.
3. Disciplina de salida
Sol genera unos 31K tokens de salida por tarea en max, frente a unos ~119K de Opus 5.5. Para agentes que deben producir artefactos acotados —payloads JSON, parches diff, resúmenes estructurados—, la concisión de Sol es una característica, no una limitación: menos tokens que parsear, menos tokens que facturar y menos superficie para bucles de corrección posterior.
Lo que la comunidad y los desarrolladores dicen de verdad
En las 24 horas siguientes al doble lanzamiento, los foros de desarrolladores produjeron más señal que la mayoría de la cobertura del día del estreno. Seis voces representativas, recogidas el 23 de septiembre de 2026:
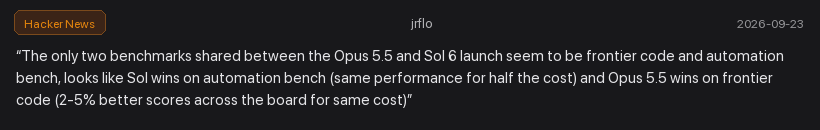
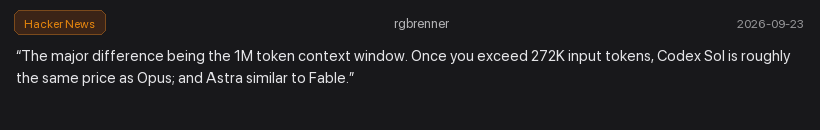
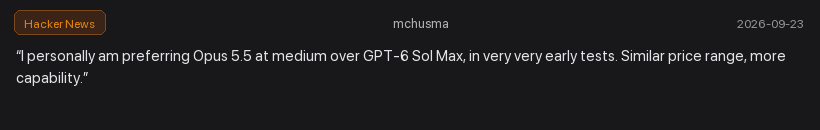
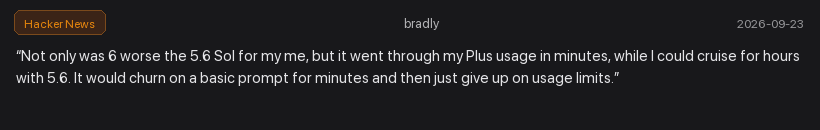
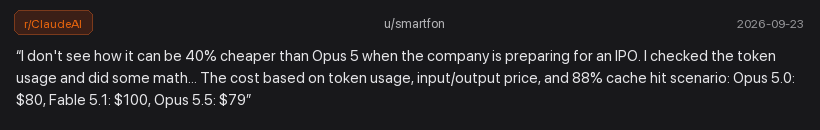
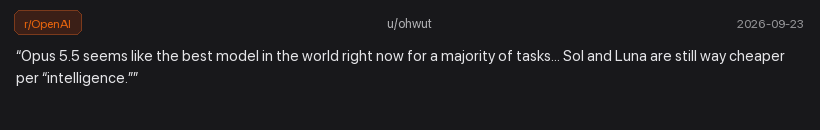
El patrón a través de estas seis voces es coherente con los datos medidos: la comunidad no coronó a un único ganador. Se dividió a lo largo de las fronteras de carga de trabajo —automatización y eficiencia de coste hacia Sol, codificación frontera y capacidad general hacia Opus 5.5— y se centró de inmediato en la alineación de niveles y la contabilidad de coste total, en lugar de en la posición bruta en las clasificaciones.
El veredicto: matriz de decisión por carga de trabajo
| Perfil de carga de trabajo | Modelo recomendado | Razón decisiva | Nota de coste |
|---|---|---|---|
| Agentes de terminal y codificación dirigida por CLI | Claude Opus 5.5 | Ventaja de ~9 puntos en Terminal-Bench 4.0 en medium (52.5% frente al 43.9% de Sol max) | Tarifa 2×, justificada por la brecha de capacidad |
| Automatización y extracción web de alto volumen | GPT-6 Sol | Empate en AutomationBench-AA (61.7% xhigh frente a 61.2% medium), con none para tareas deterministas | ~40% más barato por tarea |
| Bucles de agentes de contexto compacto (entrada < 272K) | GPT-6 Sol | El descuento sin caché del 2× sobrevive completo; lecturas de caché al mismo precio ($0.20/M) | La mitad de la tarifa de Opus 5.5 |
| Trabajos de contexto largo (entrada > 272K) | Claude Opus 5.5 | El giro de contexto largo de Sol ($4/$15) borra su descuento; Opus no tiene un precipicio equivalente | Paridad o mejor frente a las tarifas giradas de Sol |
| Investigación abierta y trabajo de conocimiento | Claude Opus 5.5 | Techo más alto en GDPval-AA y HLE; el medium predeterminado supera a Sol max por encima de ~44 puntos | Mayor impuesto de verbosidad en max |
| Asistente general con presupuesto limitado | GPT-6 Sol | Intelligence Index de $1.06 por tarea en max; el más barato por debajo del cruce de ~44 puntos | Coste mínimo por unidad de inteligencia |
De los tokens del modelo a la ejecución en el navegador: el flujo de Tabbit
Una puntuación de benchmark no raspa un sitio web, no mantiene una sesión autenticada ni confronta documentación contradictoria entre cuarenta pestañas abiertas. Los modelos de base crudos razonan sobre texto; no gestionan por sí mismos el desbordamiento de pestañas, los shadow DOM dinámicos ni los flujos web mult paso.
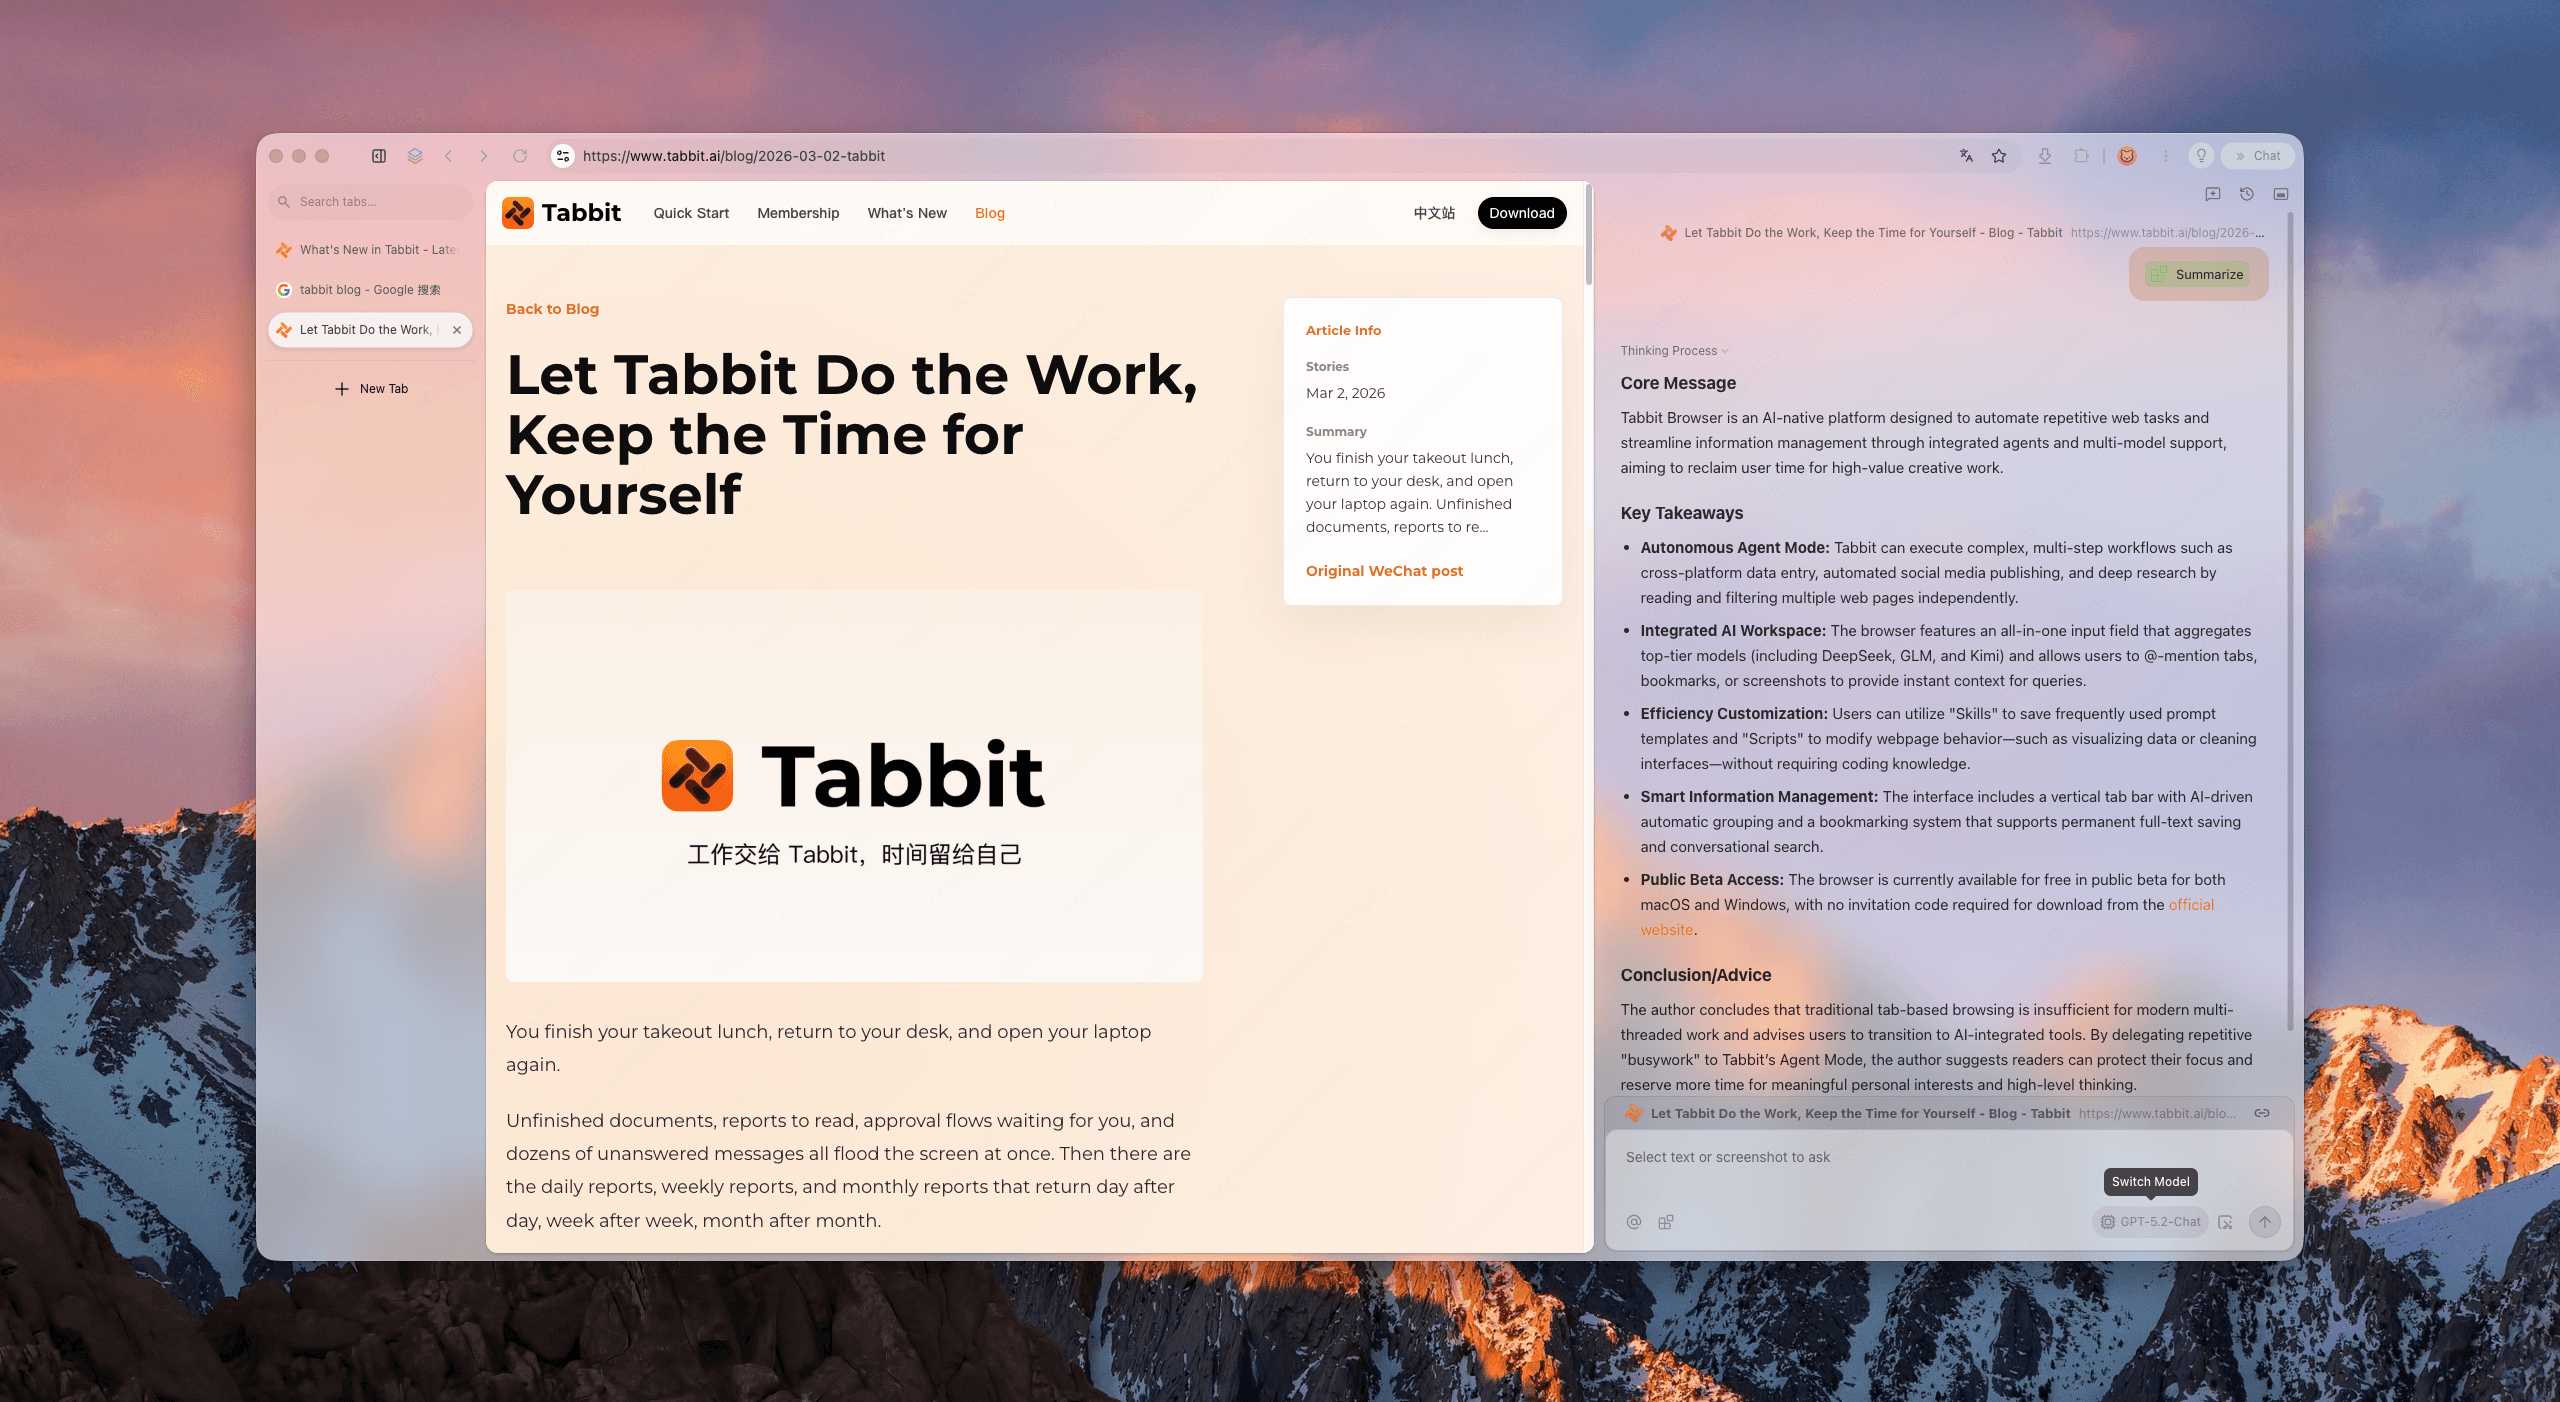
Aquí es donde importan los entornos de orquestación. Al ejecutar agentes de navegador en Tabbit Browser, el modelo aporta el razonamiento mientras la capa del navegador aporta memoria, navegación y ejecución. Ya sea dirigiendo bucles de automatización compactos a través de GPT-6 Sol o agentes de codificación de nivel terminal a través de Claude Opus 5.5, un navegador agéntico nativo de IA es lo que convierte el precio de los tokens en trabajo terminado. Consulta nuestra selección de los mejores navegadores de IA de 2026 para el panorama completo.
Nota: de acuerdo con nuestras políticas de plataforma, la disponibilidad de modelos en vivo en Tabbit depende del selector de modelos activo de tu cuenta, las integraciones soportadas y los términos de la plataforma. Esta comparación se basa en materiales oficiales y mediciones independientes, no en pruebas de benchmark internas.
 Tabbit Browser

Preguntas frecuentes
¿Cuál es más barato, GPT-6 Sol o Claude Opus 5.5?
En tarifas sin caché de contexto corto, GPT-6 Sol cuesta exactamente la mitad: $2.00 de entrada y $10.00 de salida por millón de tokens, frente a $4.00 y $20.00 de Claude Opus 5.5. Sin embargo, cuando la entrada de una solicitud supera los 272K tokens, toda la solicitud de Sol se factura a tarifas de contexto largo ($4.00 de entrada / $15.00 de salida), lo que elimina el descuento. La lectura de caché cuesta $0.20 por millón en ambos modelos.
¿Qué modelo obtiene mejores resultados en benchmarks?
Depende del nivel de esfuerzo comparado. Claude Opus 5.5 en su nivel medium predeterminado alcanza 51.2 puntos del Intelligence Index a $1.34 por tarea, por encima de los 47.5 puntos de GPT-6 Sol en su nivel máximo max a $1.06. Opus 5.5 también lidera Terminal-Bench 4.0 (52.5% en medium, 66.4% en xhigh según Anthropic) frente al 43.9% de Sol en max, mientras que Sol iguala a Opus medium en AutomationBench-AA a un coste aproximadamente 40% menor.
¿Qué niveles de esfuerzo tienen GPT-6 Sol y Claude Opus 5.5?
GPT-6 Sol ofrece none, low, medium (predeterminado), high, xhigh y max; el nivel none desactiva completamente el razonamiento extendido. Claude Opus 5.5 ofrece low, medium (predeterminado), high, xhigh y max, y su razonamiento extendido no se puede desactivar. El nivel de esfuerzo cambia tanto la capacidad como el coste por tarea, por lo que toda comparación debe nombrar los niveles utilizados.
¿Por qué tantas comparaciones enfrentan Opus 5.5 medium con GPT-6 Sol max?
Porque son los ajustes en los que el coste total por tarea de ambos modelos más se aproxima. Las mediciones con costes alineados muestran que Opus 5.5 en medium supera a Sol en max por encima de aproximadamente 44 puntos de inteligencia demandada, mientras que Sol es la opción más barata por debajo de ese umbral. Las comparaciones que no nombran ambos niveles suelen ser marketing, no medición.
¿Es Claude Opus 5.5 realmente un 40% más barato que Claude Opus 5?
Es la cifra reportada por Anthropic para cargas de trabajo típicas. Una recomputación comunitaria a partir de registros de uso reales con una tasa de acierto de caché del 88% arrojó aproximadamente $79 por unidad de trabajo en Opus 5.5 frente a $80 en Opus 5.0: prácticamente plano, no un 40% más barato. Las afirmaciones de coste de los fabricantes deben tratarse como orientativas.
¿Puedo usar GPT-6 Sol y Claude Opus 5.5 en Tabbit Browser?
Tabbit Browser ofrece un espacio de trabajo nativo de IA para investigación, extracción de datos y comparación de múltiples modelos. La disponibilidad de modelos concretos en Tabbit depende del selector de modelos en vivo de tu cuenta y de los términos de la plataforma.