
2026年9月22日、2つのフロンティアモデルが同日に登場しました。OpenAIはGPT-6 Sol(gpt-6-sol)をリリース。これはGPT-6 Lunaと同時に出た、コーディングとエージェント向けの専門モデルです。AnthropicはClaude Opus 5.5(claude-opus-5-5)をリリース。Opus 5の後継で、より低い価格で同社最強のオールラウンドモデルを目指しています。今週この2つから選ぼうとしているなら、あなたが比べているのは勝者と敗者ではありません。モデルの価格付けとチューニングに関する2つのまったく異なる理論です。
自律エージェントやマルチページの研究システムに基盤モデルを組み込む仕事を日々こなすエンジニアとして、私は発売当日のモデルをプレスリリースで評価しません。以下の内容は、公式モデルカードと発表、そして最初の24時間以内に公表された独立測定に基づくものです。そしてすべてのベンチマークにエフォートレベルを明示します。発売日の比較のほとんどがそっとごまかすのがその部分だからです。
GPT-6 Solの料金表だけが必要なら、専用の GPT-6 Sol 料金ガイドをご覧ください。OpenAI側の姉妹モデルは GPT-6 Astra レビューと GPT-6 Astra 概要を。Anthropic側は、Opus 5.5の下にあるミドルレンジの進化を Claude Fable 5.1 レビューがカバーしています。生の仕様は GPT-6 Sol モデルページ (English)と Claude Opus 5.5 モデルページ (English)でも確認できます。本文は実務的な直接対決です。
要点
一方のデフォルトが他方の上限を上回る:Claude Opus 5.5はデフォルトのmediumでインテリジェンス指数タスクあたり51.2ポイント・$1.34。GPT-6 Solの最高設定maxの47.5ポイント・$1.06を上回ります。必要インテリジェンスが約44ポイント以上の領域では、Opus 5.5が同等の支出で勝ちます。
Solの2倍の値引きには明確な期限がある:未キャッシュ料金はOpus 5.5の半分(100万トークンあたり$2.00/$10.00対$4.00/$20.00)ですが、リクエストの入力が272Kトークンを超えると、Solのリクエスト全体が長コンテキスト料金$4.00/$15.00に切り替わります。値引きではなく同価格に。
定常オートメーションはSolの本領:AutomationBench-AAでSolのxhigh(61.7%)は、約40%低コストでOpus 5.5のmedium(61.2%)に並びます。
noneレベルでは拡張思考を完全に止められます。ターミナルとフロンティアコーディングはOpus 5.5のもの:mediumでもTerminal-Bench 4.0で8.6ポイント差をつけます(52.5%対Sol maxの43.9%)。Anthropic報告のxhighは66.4%。
冗長性は請求変数:maxでOpus 5.5はタスクあたり約119K出力トークン、Solは約31K。出力100万トークン$20で請求されるため、この3.8倍の差はオープンエンドのタスクで実際の請求額の差に積算されます。
この対決を決める1つの数字:デフォルトが上限を倒す
この比較の中心的な緊張は、発売日の報道がほぼ見落とした組み合わせです。2026年9月23日時点の独立測定では、Claude Opus 5.5のデフォルトmediumがインテリジェンス指数51.2ポイント、タスクあたり$1.34。GPT-6 Solの最高のmax設定は47.5ポイント、タスクあたり$1.06です。
ドルあたりスコア(独立測定、2026-09-23):
Claude Opus 5.5  medium(デフォルト):  51.2ポイント   $1.34/タスク
GPT-6 Sol        max   (上限):        47.5ポイント   $1.06/タスク

クロスオーバー:必要スコア約44ポイント未満ではSolが安い。
44ポイント超ではOpus 5.5が同等支出で明確に勝る。
一方のベンダーの初期設定が、交差点以上ではスコアとドルあたりスコアの両方で他方の最大設定を上回ります。これが「デフォルトが上限を倒す」パラドックスで、発売から数時間以内のコミュニティ初期テストでも裏付けられました。
2つ目の数字は、Solの価格優位がどこで実際に成立するかを決めます。OpenAIの料金表は明快です。標準の短コンテキストリクエストは100万トークンあたり入力$2.00、出力$10.00——Opus 5.5の$4.00/$20.00のちょうど半分。ただしモデルカードには、ほとんどの見出しが見落とした閾値があります。リクエストの入力が272Kトークンを超えると、リクエスト全体が長コンテキスト料金に切り替わる——入力$4.00、キャッシュ読み取り$0.40、キャッシュ書き込み$5.00、出力$15.00。この時点で、自社謳いの1,050,000トークンコンテキスト内でSolはOpus 5.5と同じかそれ以上のコストになります。Opus 5.5の1Mコンテキストに同等の崖はありません。
100万トークンあたりの実効入力コスト:
272K入力未満:  Sol $2.00  対  Opus 5.5 $4.00  --> Solが半額
272K入力超: Sol $4.00 対 Opus 5.5 $4.00 --> 同価格(出力$15対$20)ワークロードがコンパクトなコンテキストのエージェントループ——エージェンティックリサーチシステムが生息する領域——なら、Solの割引は実際のお金です。コードベース全体や長大な文書コーパスをプロンプトに詰め込むワークロードなら、その割引はコンテキストウィンドウを最も必要とする瞬間に消えます。
仕様と料金一覧
両モデルとも100万トークンコンテキストと段階的エフォートレベルを謳いますが、その機構の違いはコストエンジニアリングに効きます。以下の料金は100万トークンあたりの米ドルで、2026年9月23日に両公式モデルカードで確認済みです。
| 項目 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| API識別子 | gpt-6-sol | claude-opus-5-5 |
| コンテキストウィンドウ | 1,050,000トークン | 1,000,000トークン |
| 最大出力 | コンテキスト以下で個別の上限なし | 128,000トークン(Batchベータで300K) |
| エフォートレベル | none / low / medium(デフォルト)/ high / xhigh / max | low / medium(デフォルト)/ high / xhigh / max |
| 拡張思考の切替 | 無効化可能(none) | 無効化不可 |
| 入力(未キャッシュ) | $2.00(272K超で$4.00) | $4.00 |
| キャッシュ読み取り | $0.20(272K超で$0.40) | $0.20(Opus 5比で約60%割引) |
| キャッシュ書き込み | $2.50(272K超で$5.00) | $5.00 |
| 出力 | $10.00(272K超で$15.00) | $20.00 |
| Batch料金 | 標準の50%(Flex) | 入力$2.00 / 出力$10.00 |
| 高速ティア | 標準の2× | $8.00 / $40.00(約2.5×速度) |
| 知識カットオフ | GPT-6ファミリー世代 | 2026-06 |
| ベンダーのコスト主張 | — | 典型的ワークロードでOpus 5比約40%安(ベンダー口径) |
注目すべきエンジニアリング上の細部は3つ。1つ目、Solのnoneレベルは独自です。拡張思考を完全に停止させ、Opus 5.5が再現できない決定論的低遅延モードを提供します。2つ目、両モデルのキャッシュ読み取りはともに100万トークン$0.20のため、キャッシュヒット率の高い本番パイプラインでは請求の入力側は互角になり、出力の冗長性が決定変数になります。3つ目、Anthropicの「Opus 5比40%安」はベンダー口径で、後述するコミュニティの再計算では実際のワークロードではほぼ横ばいでした。
具体例でレベルの仕組みを確かめましょう。月間5万タスク、タスクあたり40K入力トークン(キャッシュヒット率90%)、2K出力トークン、medium級レベルに整合、すべて272K閾値以下のオートメーションパイプラインを考えます。
GPT-6 Sol(タスクあたり:未キャッシュ入力4K×$2.00+キャッシュ読み取り36K×$0.20+出力2K×$10.00):$0.008+$0.0072+$0.020=$0.0352 → 月$1,760
Claude Opus 5.5(タスクあたり:未キャッシュ入力4K×$4.00+キャッシュ読み取り36K×$0.20+出力2K×$20.00):$0.016+$0.0072+$0.040=$0.0632 → 月$3,160
同じパイプラインをSolが走らせるコストは約44%低く(Opus 5.5 の請求額の約 56%)です。ここでタスクあたりの入力を300Kトークンに変えるとどうでしょう。Solのリクエスト全体が長コンテキスト料金(未キャッシュ$4.00、キャッシュ読み取り$0.40、出力$15.00)に切り替わり、$12,900対Opus 5.5の$10,700——名目上安いモデルのほうが20%高くなります。この閾値は脚注ではなく、長コンテキストアーキテクチャの決定変数です。
ベンチマーク、そしてどこまで信じるべきか
発売日のベンチマーク表は、独立系ラボが再現するまではマーケティング資料です。下表はベンダー報告(注記あり)と独立測定を混ぜており、その後の4つのキャリブレーション注意のほうがどの数字よりも重要です。
| ベンチマーク | Claude Opus 5.5 | GPT-6 Sol | 読み取り |
|---|---|---|---|
| インテリジェンス指数(スコア / タスクあたり$) | 51.2 / $1.34(medium) | 47.5 / $1.06(max) | OpusデフォルトがSol上限を上回る。44ポイント未満はSolが安い |
| Terminal-Bench 4.0 | 52.5%(medium);66.4%(xhigh、ベンダー、±2.6標準誤差) | 43.9%(max);44%(独立) | Opusがターミナル/エージェントCLIで約9ポイント先行 |
| AutomationBench-AA | 61.2%(medium) | 61.7%(xhigh) | 統計上の互角。Solは約40%低コスト |
| GDPval-AA v2.1 | 1846 Elo(ベンダー) | フロンティア比で約100 Elo後退(独立) | Opusが知識ワーク評価で強い |
| Humanity's Last Exam(ツール使用) | 67.7%(max、ベンダー) | 今サイクル未検証 | 方向性の参考としてのみ |
これらを決断材料にする前に、4つのキャリブレーションが適用されます。
レベルの不整合が最もありがちなカンニング。 発売時に流通したSolの数字の多くはmaxかxhighから来ており、Opusの数字はmediumデフォルトから来ています。両方のレベルを明示しない主張は、調整済みの設定と未調整の設定を比べています。本文は常にレベルを明示します。
ベンダー報告にはベンダー報告の楽観が付属する。 Opus 5.5のTerminal-Bench 66.4%とHLE 67.7%は、Anthropicが条件を明示して報告した数値で、Terminal-Benchには±2.6の標準誤差があります。Solの$1.06/タスクや幻覚率はArtificial Analysisによる独立測定です。独立系の数字により重きを置いてください。
Solの幻覚率改善の一部は棄却による。 独立測定ではSolの幻覚率が92%から60%に低下していますが、それは棄却の増加によって達成された面が大きい。エージェントパイプラインで棄却は無料ではありません。タスクの停滞や人間へのエスカレーションとして表面化し、ベンチマークのパーセントはそれを隠します。
冗長性はOpusの出力料金プレミアムを増幅する。 maxでOpus 5.5はタスクあたり約119Kの出力トークンを生成し、Solは約31K。出力レート$20/M対$10/Mと組み合わさり、高エフォートでのオープンエンドタスクは、料金比が示すより何倍も高くなりえます。低レベルでは差はかなり縮まります。
Claude Opus 5.5が本当に勝つ場所
Opus 5.5は安いモデルではなく、安くしようともしていません。請求書ではなくタスク品質の天井が制約になる場所で勝ちます。
1. ターミナルとフロンティアコーディングのエージェント作業
最も明確な構造上の優位はTerminal-Bench 4.0——自律型コマンドラインソフトウェア工学を測るベンチマークです。Opus 5.5はmediumで52.5%、Solはmaxで43.9%。両社が明確に狙うワークロード群——マルチステップのシェル環境、ビルド・修正ループ、テスト駆動の修復——で約17%の相対差です。Anthropic報告のxhigh 66.4%は差をさらに広げますが、前述のベンダー報告上の注意が付きます。
2. 知識ワークと汎用知能評価
職業的知識ワーク評価GDPval-AA v2.1で、Anthropicは1846 Eloを報告しています。独立測定では、Solは同族の評価でフロンティア比で約100 Elo後退しています。これはSolのポジショニングと整合的です。コーディングとオートメーションのスペシャリストが、汎用知識の幅をコスト効率と交換している。研究統合、文書分析、オープンドメイン推論ではOpus 5.5の上限のほうが高い。Anthropicのミドルレンジ Claude Fable 5.1 の記事は、そのファミリーがOpusの価格帯の下で汎用能力をどこまで伸ばしたかの文脈として有用です。
3. デフォルトレベルの体験
Opus 5.5の最も過小評価されている特性は、デフォルトが強い設定だということです。mediumレベルは交差点以上でSolのmaxよりドルあたりスコアが良く、レベル予算のチューニングに時間を割けないチームでも最初からフロンティア性能が得られます。Solの最適な価値は意図的な設定を要求します。確定的タスクではnone、オートメーションではxhighを選び、maxでも汎用能力でOpusデフォルトに後れることを受け入れる。
GPT-6 Solが本当に勝つ場所
Solの主張は「少し安くてほぼ同じ」ではありません。異なるコストアーキテクチャを持つ3つの具体的な優位です。
1. 料金はちょうど半額、思考オフのスイッチ付き
未キャッシュ短コンテキストで100万トークンあたり$2.00入力、$10.00出力のSolは、Opus 5.5より50%安い——そしてフロンティア競合にないものを提供します。noneレベルは拡張思考を完全に停止させる。高スループットの構造化抽出、分類、テンプレート生成では、思考を止められないモデルに払うのは浪費です。Solは推論メーターを止められます。他社の料金表との横断比較は、同じ総コスト手法を使った Kimi K3 料金 分析をご覧ください。
2. 能力が並ぶ場所でのオートメーションコスト効率
AutomationBench-AAで、Solのxhighは61.7%、Opus 5.5のmediumは61.2%——統計上の互角をタスクあたり約40%安く届けます。パイプラインがブラウザオートメーション、DOM抽出、フォーム操作、ツールオーケストレーションなら、Solが合理的なデフォルトです。能力は同じ、請求書は違う。
3. 出力の規律性
Solはmaxでタスクあたり約31Kの出力トークン、Opus 5.5は約119K。有界な成果物——JSONペイロード、パッチdiff、構造化サマリー——を出さなければならないエージェントにとって、Solの簡潔さは制限ではなく機能です。解析するトークンが減り、課金されるトークンが減り、事後修正ループの余地が減ります。
開発者とコミュニティの本音
二重発売から24時間以内に、開発者フォーラムは発売日の報道以上の信号を出しました。2026年9月23日に収集した6つの代表的な声です。
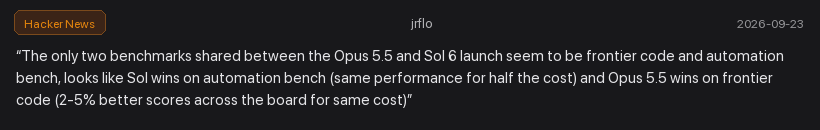
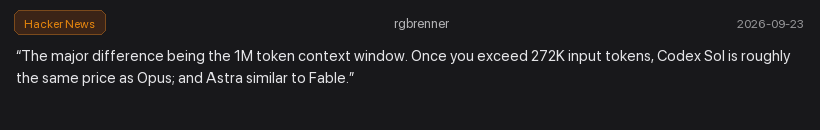
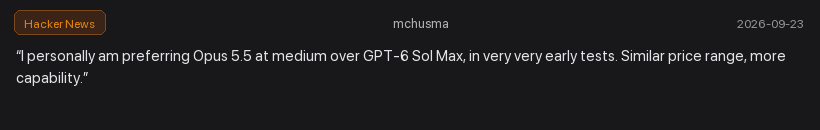
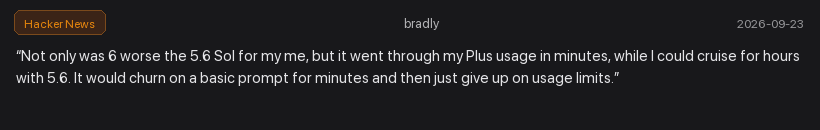
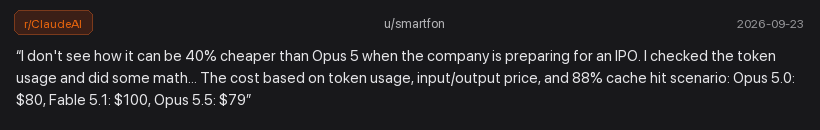
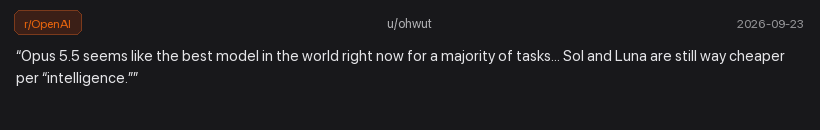
この6つの声が示すパターンは測定データと一致しています。コミュニティは単一の勝者を戴冠しませんでした。ワークロードの境界で分裂しています。オートメーションとコスト効率はSolへ、フロンティアコーディングと汎用能力はOpus 5.5へ。そしてすぐにレベルの整合と総コスト計算に注目し、生のランキング順位ではなく。
結論:ワークロード別意思決定マトリクス
| ワークロード | 推奨モデル | 決定的理由 | コスト上の注意 |
|---|---|---|---|
| ターミナルエージェントとCLI駆動コーディング | Claude Opus 5.5 | Terminal-Bench 4.0でmediumが約9ポイント先行(52.5%対Sol max 43.9%) | 料金は2倍。能力差が正当化 |
| 高スループットブラウザオートメーションと抽出 | GPT-6 Sol | AutomationBench-AA互角(61.7% xhigh対61.2% medium)。確定的タスクにはnone | タスクあたり約40%安 |
| コンパクトコンテキストのエージェントループ(入力 < 272K) | GPT-6 Sol | 未キャッシュ2倍割引が完全に成立。キャッシュ読み取りは同額($0.20/M) | Opus 5.5料金の半分 |
| 長コンテキストジョブ(入力>272K) | Claude Opus 5.5 | Solの長コンテキスト反転($4/$15)が割引を消滅させる。Opusに同等の崖なし | 反転後のSol料金と比べ同等かそれ以上 |
| オープンエンドの研究と知識ワーク | Claude Opus 5.5 | GDPval-AAとHLEで上限が高い。デフォルトmediumが約44ポイント超でSol maxに勝る | maxの冗長性税が高い |
| 予算制約のある汎用アシスタント | GPT-6 Sol | maxでインテリジェンス指数$1.06/タスク。約44ポイント交差点以下で最安 | 単位インテリジェンスあたり最安 |
生のモデルトークンからブラウザ実行へ:Tabbitワークフロー
ベンチマークスコアはウェブサイトをスクレイピングしたり、認証済みセッションを維持したり、開いた40のタブの間で矛盾する文書を突き合わせたりはしません。生の基盤モデルはテキストについて推論します。タブの氾濫、動的shadow DOM、マルチステップのウェブワークフローを自分で管理することはありません。
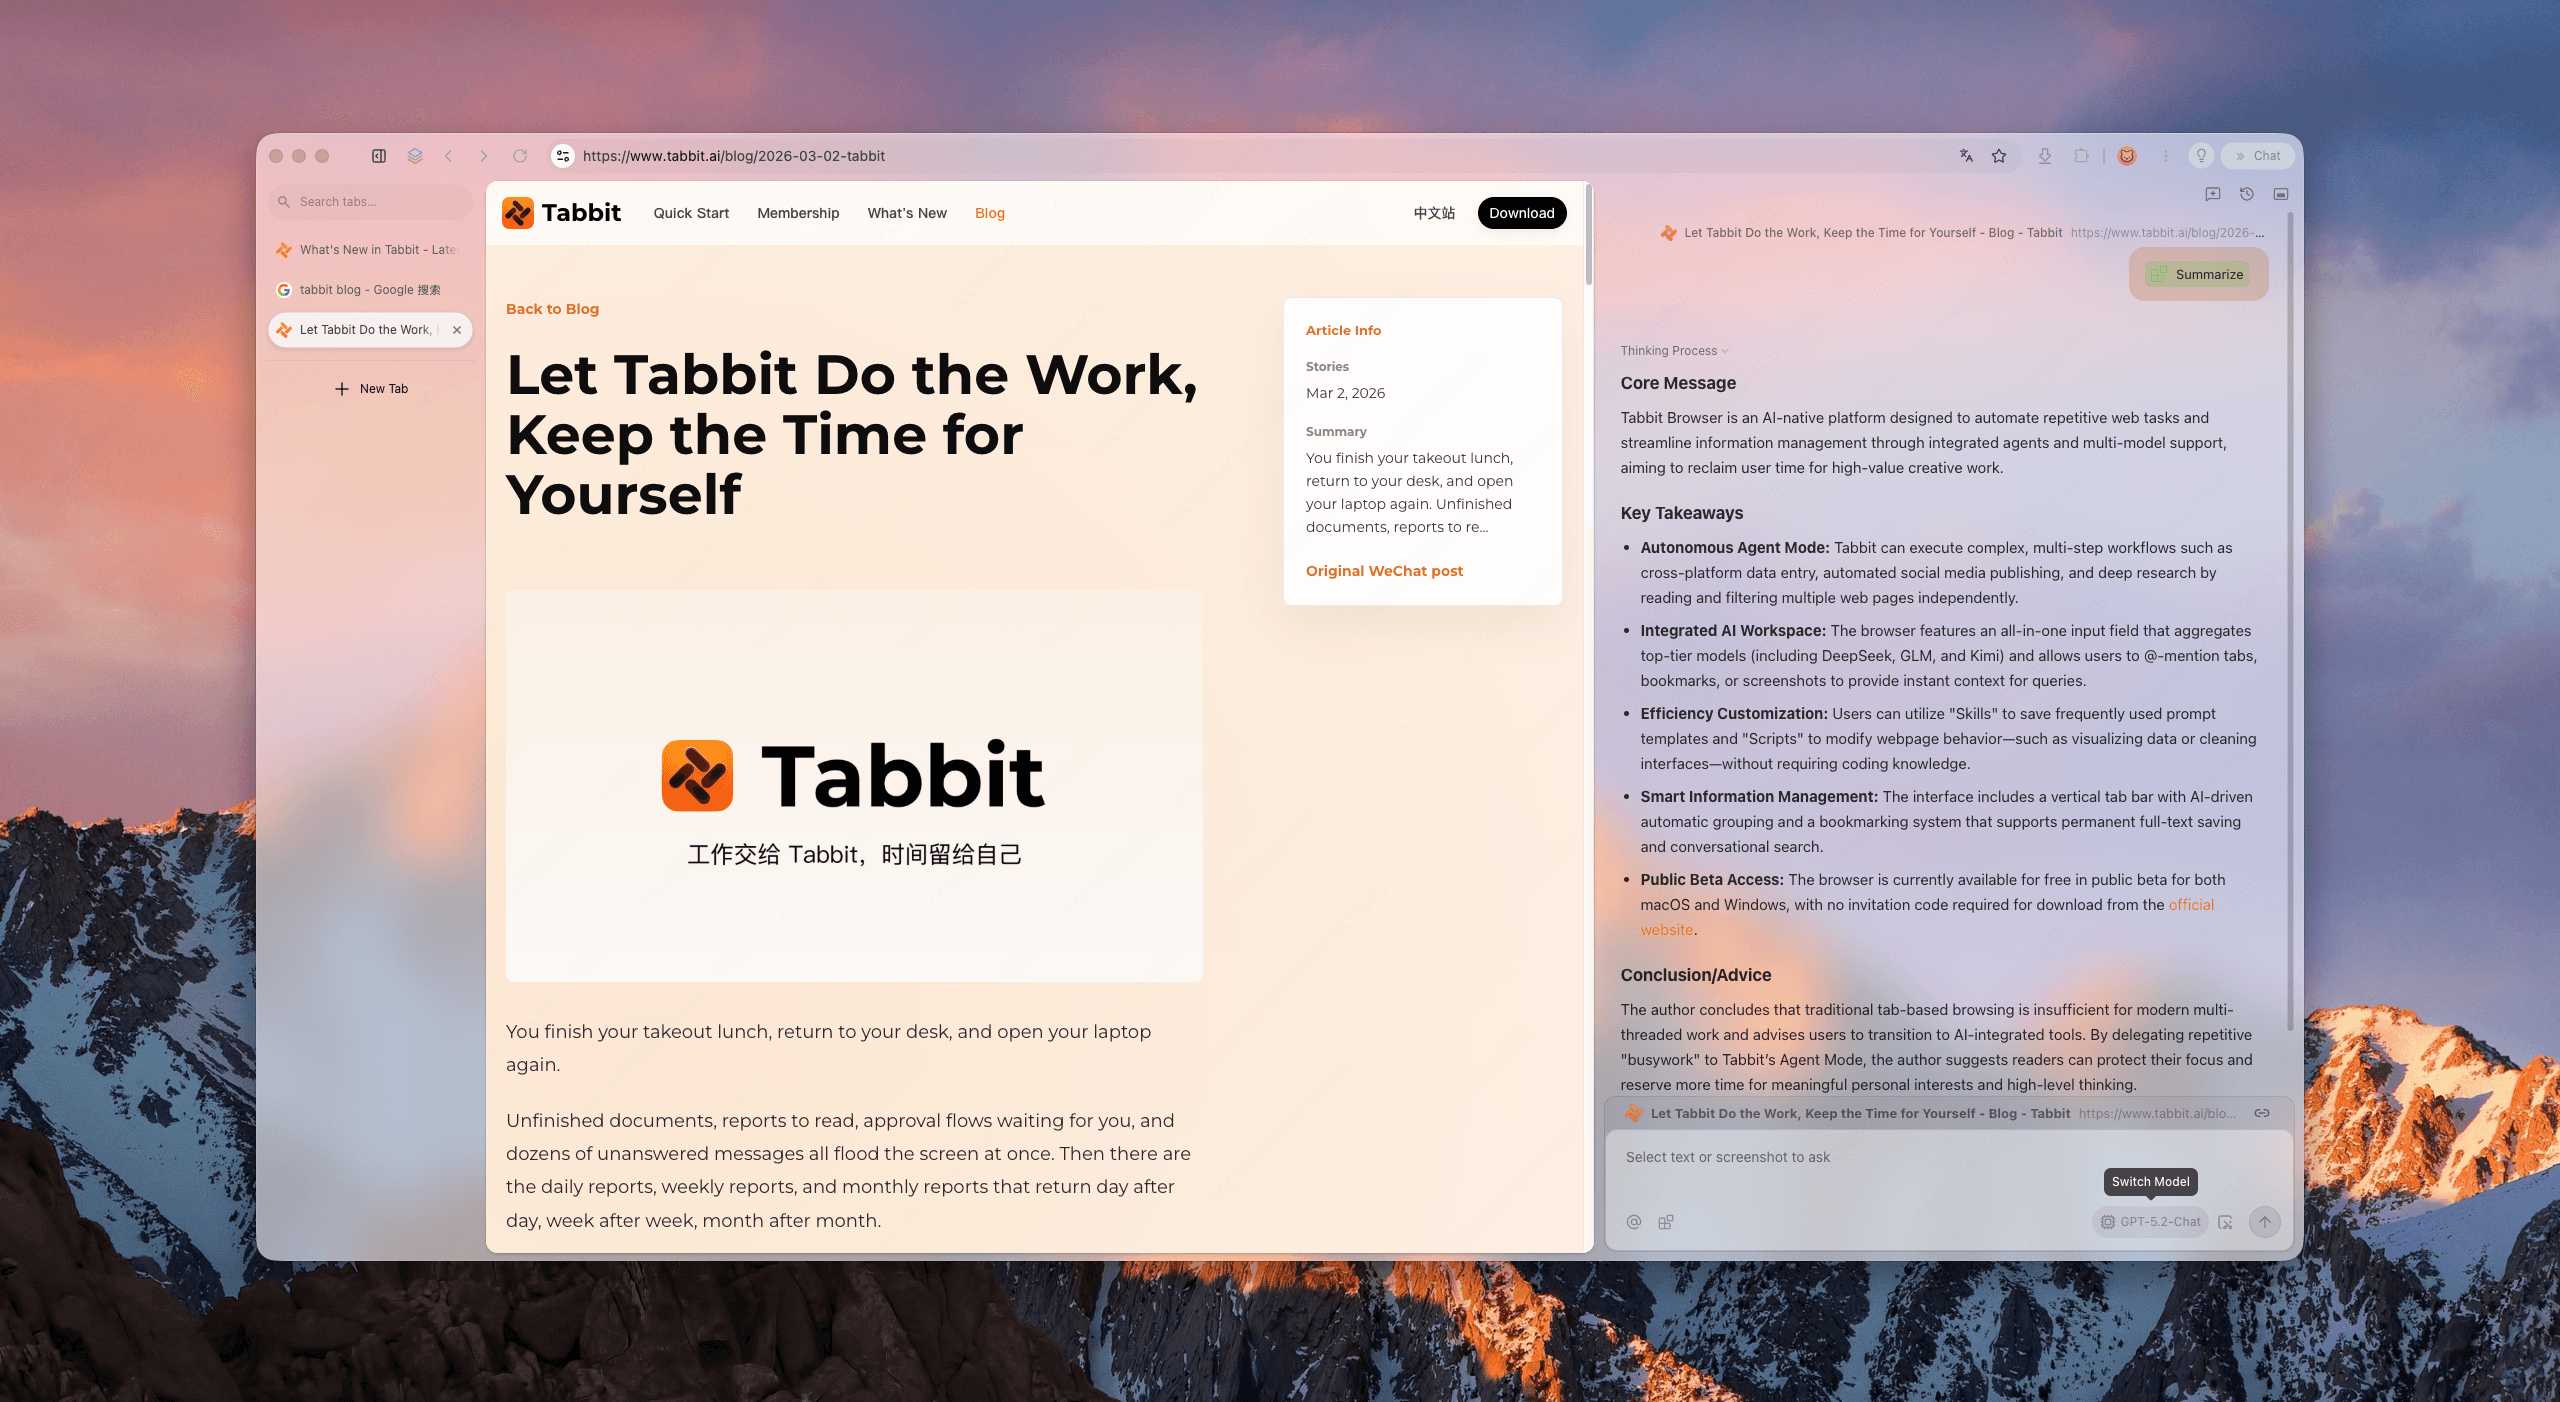
そこでオーケストレーション環境が重要になります。Tabbit Browser でブラウザエージェントを実行する際、モデルは推論を担い、ブラウザ層はメモリ、ナビゲーション、実行を担います。GPT-6 Solでコンパクトな自動化ループを回しても、Claude Opus 5.5でターミナル級のコーディングエージェントを動かしても、AIネイティブのエージェンティックブラウザ がトークン料金を完成した仕事に変えるものです。全体像は 2026年のベストAIブラウザ のまとめをご覧ください。
注:プラットフォームポリシーに従い、Tabbitでのモデルの実際の利用可能性は、アカウントのアクティブなモデルセレクター、サポートされている統合、プラットフォーム条項に依存します。本比較は社内ベンチマーク実行ではなく、公式資料と独立測定に基づいています。
 Tabbit Browser

よくある質問
GPT-6 SolとClaude Opus 5.5のどちらが安い?
未キャッシュの短コンテキスト料金では、GPT-6 SolはOpus 5.5のちょうど半額です。入力100万トークンあたり$2.00、出力$10.00に対し、Opus 5.5は$4.00と$20.00。ただしリクエストの入力が272Kトークンを超えると、Solのリクエスト全体が長コンテキスト料金(入力$4.00、出力$15.00)に切り替わり、割引は消失します。キャッシュ読み取りは両モデルとも100万トークンあたり$0.20です。
ベンチマークスコアはどちらが高い?
比較するエフォートレベル次第です。Claude Opus 5.5はデフォルトのmediumでインテリジェンス指数51.2ポイント・タスクあたり$1.34、GPT-6 Solは最高のmaxで47.5ポイント・$1.06です。Terminal-Bench 4.0でもOpus 5.5が先行(medium 52.5%、Anthropic報告のxhigh 66.4%)しますが、AutomationBench-AAではSolが約40%低コストでOpus mediumに並びます(61.7%対61.2%)。
GPT-6 SolとClaude Opus 5.5のエフォートレベルは?
GPT-6 Solはnone、low、medium(デフォルト)、high、xhigh、maxの6段階で、noneは拡張思考を完全に無効化します。Claude Opus 5.5はlow、medium(デフォルト)、high、xhigh、maxの5段階で、拡張思考は無効化できません。エフォートレベルは能力とタスクあたりコストの両方を変えるため、どの比較も両方のレベルを明示する必要があります。
なぜ多くの比較でOpus 5.5 mediumとGPT-6 Sol maxが対比されるの?
この2つの設定で両モデルのタスクあたり総コストが最も近づくためです。コスト整合の測定では、必要インテリジェンスが約44ポイント以上の領域でOpus 5.5 mediumがSol maxを上回り、その閾値以下ではSolが安くなります。両方のレベルを明示しない比較は、測定ではなくマーケティングです。
Claude Opus 5.5は本当にClaude Opus 5より40%安いの?
これはAnthropicが公表するベンダー口径(典型的なワークロード)です。実利用ログと88%のキャッシュヒット率でコミュニティが再計算したところ、Opus 5.5は単位作業あたり約$79、Opus 5.0は約$80——ほぼ横ばいで、40%安くはありません。ベンダーのコスト主張は自社のトークン構成で再計算するべきです。
Tabbit BrowserでGPT-6 SolとClaude Opus 5.5は使えるの?
Tabbit Browserは調査、データ抽出、マルチモデル比較のためのAIネイティブワークスペースを提供します。特定モデルがTabbitで利用可能かどうかは、アカウントのライブモデルセレクターとプラットフォーム条項に依存します。