
Em 22 de setembro de 2026, dois modelos de fronteira pousaram no mesmo dia. A OpenAI lançou o GPT-6 Sol (gpt-6-sol), um especialista em codificação e agentes dentro da família GPT-6, lançado junto com o GPT-6 Luna. A Anthropic lançou o Claude Opus 5.5 (claude-opus-5-5), sucessor do Opus 5 e posicionado como seu modelo mais completo a um preço menor. Se você está escolhendo entre os dois nesta semana, não está comparando um vencedor e um perdedor. Está comparando duas teorias distintas de como um modelo deve ser precificado e ajustado.
Como engenheiro que conecta modelos de base em agentes autônomos e sistemas de pesquisa multipágina diariamente, não avalio modelos no dia do lançamento com base em press releases. O que segue se baseia nos cards de modelo e anúncios oficiais, mais medições independentes publicadas nas primeiras 24 horas — com cada benchmark explicitamente rotulado por nível de esforço, porque é onde a maioria das comparações de lançamento trapaceia em silêncio.
Se você só precisa da tabela de preços do GPT-6 Sol, leia nosso guia de preços do GPT-6 Sol. Para o lançamento irmão da OpenAI, veja nossa análise do GPT-6 Astra e a visão geral do GPT-6 Astra. No lado da Anthropic, nossa análise do Claude Fable 5.1 cobre a linha intermediária sobre a qual o Opus 5.5 agora se situa. Você também pode consultar as especificações brutas na página do modelo GPT-6 Sol (English) e na página do modelo Claude Opus 5.5 (English). Este artigo é o confronto direto de engenharia.
Conclusões principais
O padrão de um fabricante supera o teto do outro: o Claude Opus 5.5 no nível medium padrão alcança 51,2 pontos no Intelligence Index a US$ 1,34 por tarefa, acima do ajuste max do GPT-6 Sol (47,5 pontos, US$ 1,06 por tarefa). Acima de cerca de 44 pontos de inteligência demandada, o Opus 5.5 vence com gasto comparável.
O desconto de 2× do Sol tem validade clara: as tarifas sem cache são a metade das do Opus 5.5 (US$ 2,00/US$ 10,00 contra US$ 4,00/US$ 20,00 por milhão de tokens), mas quando a entrada de uma solicitação ultrapassa 272K tokens, a solicitação inteira do Sol muda para as tarifas de contexto longo de US$ 4,00/US$ 15,00 — paridade, não desconto.
A automação rotineira é o território do Sol: no AutomationBench-AA, o Sol em xhigh (61,7%) empata com o Opus 5.5 em medium (61,2%) por um custo cerca de 40% menor, e seu nível
nonedesativa completamente o raciocínio estendido.O trabalho em terminal e a codificação de fronteira pertencem ao Opus 5.5: ele lidera o Terminal-Bench 4.0 por 8,6 pontos mesmo em medium (52,5% contra 43,9% do Sol em max); a Anthropic relata 66,4% em xhigh.
A verbosidade é uma variável de cobrança: em max, o Opus 5.5 gera cerca de 119K tokens de saída por tarefa contra ~31K do Sol. A US$ 20 por milhão de tokens de saída, essa lacuna de 3,8× se acumula em diferença real de fatura em tarefas abertas.
O número que decide este confronto: o padrão supera o teto
A tensão central desta comparação é um par que a cobertura do lançamento em grande parte ignorou. Medições independentes em 23 de setembro de 2026 situam o Claude Opus 5.5 no medium padrão em 51,2 pontos no Intelligence Index, a US$ 1,34 por tarefa. O GPT-6 Sol em seu ajuste mais alto, max, atinge 47,5 pontos a US$ 1,06 por tarefa.
Pontos por dólar (medições independentes, 2026-09-23):
Claude Opus 5.5  medium (PADRÃO):  51,2 pts   US$ 1,34/tarefa
GPT-6 Sol        max   (TETO):     47,5 pts   US$ 1,06/tarefa

Cruzamento: abaixo de ~44 pontos de inteligência demandada o Sol é mais barato;
acima de 44, o Opus 5.5 vence claramente com gasto comparável.
A configuração de fábrica de um fabricante supera, acima do cruzamento, o ajuste máximo do outro tanto em pontos quanto em pontos por dólar. Este é o paradoxo do "padrão supera o teto", confirmado em testes comunitários precoces algumas horas após o lançamento.
O segundo número decide onde a vantagem de preço do Sol realmente sobrevive. A tabela da OpenAI é limpa: US$ 2,00 de entrada e US$ 10,00 de saída por milhão de tokens em solicitações padrão de contexto curto — exatamente a metade dos US$ 4,00/US$ 20,00 do Opus 5.5. Mas o card do modelo traz um limiar que a maioria das manchetes pulou: assim que a entrada de uma solicitação ultrapassa 272K tokens, a solicitação inteira passa a ser cobrada pelas tarifas de contexto longo — US$ 4,00 de entrada, US$ 0,40 de leitura de cache, US$ 5,00 de escrita de cache e US$ 15,00 de saída. Nesse ponto, o Sol dentro de sua própria janela de contexto anunciada de 1.050.000 tokens custa o mesmo ou mais que o Opus 5.5, cujo contexto de 1M não tem precipício equivalente.
Custo efetivo de entrada por 1M tokens:
Abaixo de 272K de entrada:  Sol US$ 2,00  vs  Opus 5.5 US$ 4,00  --> Sol 2× mais barato
Acima de 272K de entrada:   Sol US$ 4,00  vs  Opus 5.5 US$ 4,00  --> paridade (saída: US$ 15 vs US$ 20)
Se suas cargas de trabalho são loops de agentes com contextos compactos — o regime onde vivem os sistemas de raciocínio agêntico —, o desconto do Sol é dinheiro real. Se suas cargas de trabalho lotam o prompt com bases de código inteiras ou longos corpos documentais, o desconto evapora exatamente quando você mais precisa da janela de contexto.
Especificações e preços em um relance
Ambos os modelos anunciam contexto de um milhão de tokens e níveis de esforço escalonados, mas as mecânicas diferem de formas relevantes para a engenharia de custos. As tarifas abaixo são em USD por milhão de tokens, verificadas contra ambos os cards oficiais em 23 de setembro de 2026.
| Dimensão | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Identificador de API | gpt-6-sol | claude-opus-5-5 |
| Janela de contexto | 1.050.000 tokens | 1.000.000 tokens |
| Saída máxima | Sem teto separado abaixo do contexto | 128.000 tokens (300K na beta Batch) |
| Níveis de esforço | none / low / medium (padrão) / high / xhigh / max | low / medium (padrão) / high / xhigh / max |
| Interruptor de raciocínio estendido | Pode ser desativado (none) | Não pode ser desativado |
| Entrada (sem cache) | US$ 2,00 (US$ 4,00 acima de 272K) | US$ 4,00 |
| Leitura de cache de entrada | US$ 0,20 (US$ 0,40 acima de 272K) | US$ 0,20 (~60% de desconto vs Opus 5) |
| Escrita de cache de entrada | US$ 2,50 (US$ 5,00 acima de 272K) | US$ 5,00 |
| Saída | US$ 10,00 (US$ 15,00 acima de 272K) | US$ 20,00 |
| Preço Batch | 50% do padrão (Flex) | US$ 2,00 entrada / US$ 10,00 saída |
| Nível rápido | 2× o padrão | US$ 8,00 / US$ 40,00 (~2,5× a velocidade) |
| Corte de conhecimento | Geração da família GPT-6 | 2026-06 |
| Afirmação de custo do fabricante | — | ~40% mais barato que o Opus 5 em cargas típicas (número do fabricante) |
Três detalhes de engenharia se destacam. Primeiro, o nível none do Sol é único: ele desativa o raciocínio estendido completamente, oferecendo um modo determinístico de baixa latência que o Opus 5.5 não pode replicar — o raciocínio dele está sempre ligado. Segundo, ambos os modelos cobram leitura de cache a US$ 0,20 por milhão, de modo que em pipelines de produção com alta taxa de acertos de cache, o lado de entrada da fatura empata e a verbosidade de saída vira a variável decisiva. Terceiro, a afirmação da Anthropic de "40% mais barato que o Opus 5" é um enquadramento de fabricante; a recomputação comunitária coberta adiante a encontrou próxima de estável em uma carga real.
Um exemplo numérico torna a mecânica dos níveis concreta. Considere um pipeline de automação de 50.000 tarefas por mês, cada uma com 40K tokens de entrada (90% de acertos de cache) e 2K tokens de saída, alinhadas a um nível de classe medium e inteiramente abaixo do limiar de 272K:
GPT-6 Sol (por tarefa: 4K de entrada sem cache × US$ 2,00 + 36K de leitura de cache × US$ 0,20 + 2K de saída × US$ 10,00): US$ 0,008 + US$ 0,0072 + US$ 0,020 = US$ 0,0352 → US$ 1.760 por mês
Claude Opus 5.5 (por tarefa: 4K de entrada sem cache × US$ 4,00 + 36K de leitura de cache × US$ 0,20 + 2K de saída × US$ 20,00): US$ 0,016 + US$ 0,0072 + US$ 0,040 = US$ 0,0632 → US$ 3.160 por mês
O Sol executa o mesmo pipeline por aproximadamente 44% menos(cerca de 56% da fatura do Opus 5.5). Agora refaça com 300K tokens de entrada por tarefa: a solicitação inteira do Sol muda para as tarifas de contexto longo (US$ 4,00 sem cache / US$ 0,40 de leitura de cache / US$ 15,00 de saída), e o resultado é US$ 12.900 contra US$ 10.700 do Opus 5.5 — o modelo nominalmente mais barato agora custa 20% a mais. Esse limiar não é nota de rodapé; é a variável decisiva das arquiteturas de contexto longo.
Benchmarks, e quanto confiar neles
Tabelas de benchmarks de dia de lançamento são documentos de marketing até que laboratórios independentes os reproduzam. A tabela abaixo mistura números relatados pelos fabricantes (rotulados) com medições independentes, e as notas de calibração que seguem importam mais do que qualquer número isolado.
| Benchmark | Claude Opus 5.5 | GPT-6 Sol | Leitura |
|---|---|---|---|
| Intelligence Index (pontos / US$ por tarefa) | 51,2 / US$ 1,34 (medium) | 47,5 / US$ 1,06 (max) | O padrão do Opus acima do teto do Sol; abaixo de ~44 pontos o Sol é mais barato |
| Terminal-Bench 4.0 | 52,5% (medium); 66,4% (xhigh, fabricante, ±2,6 EE) | 43,9% (max); 44% (independente) | Opus lidera o trabalho agêntico em terminal/CLI por ~9 pontos a custo comparável |
| AutomationBench-AA | 61,2% (medium) | 61,7% (xhigh) | Empate estatístico; Sol entrega ~40% mais barato |
| GDPval-AA v2.1 | 1846 Elo (fabricante) | ~100 Elo de recuo vs fronteira (independente) | Opus é mais forte em avaliações de trabalho de conhecimento |
| Humanity's Last Exam (com ferramentas) | 67,7% (max, fabricante) | sem verificação independente neste ciclo | Somente direcional |
Antes de tratar qualquer uma dessas linhas como conclusiva, aplicam-se quatro advertências de calibração:
O desalinhamento de níveis é a trapaça mais comum. A maioria dos números do Sol em circulação no lançamento vinha de max ou xhigh, enquanto os do Opus vinham de seu medium padrão. Qualquer afirmação que não nomeie os dois níveis está comparando um ajuste otimizado com um não otimizado. Este artigo sempre nomeia o nível.
Números de fabricante carregam o otimismo de fabricante. Os 66,4% de Terminal-Bench e 67,7% de HLE do Opus 5.5 são relatados pela Anthropic sob condições nomeadas; o número de Terminal-Bench carrega um erro padrão de ±2,6. Os US$ 1,06 por tarefa e as taxas de alucinação do Sol são medidos independentemente pela Artificial Analysis. Dê mais peso aos números independentes.
A melhoria de alucinação do Sol é em parte abstinência. A medição independente mostra a taxa de alucinação do Sol caindo de 92% para 60% — mas alcançada em grande parte recusando responder mais vezes. Em um pipeline de agentes, uma abstinência não é de graça: ela se manifesta como tarefa travada ou escalonamento humano, o que os percentuais de benchmark escondem.
A verbosidade amplifica o prêmio da tarifa de saída do Opus. Em max, o Opus 5.5 produz ~119K tokens de saída por tarefa contra ~31K do Sol. Combinada com tarifa de saída de US$ 20/M contra US$ 10/M, tarefas abertas no Opus com esforço alto podem custar várias vezes mais do que a proporção das tarifas sugere. Em níveis mais baixos, a lacuna estreita substancialmente.
Onde o Claude Opus 5.5 realmente vence
O Opus 5.5 não é o modelo mais barato, e não tenta ser. Ele vence onde o teto de qualidade da tarefa, e não a fatura, é a restrição vinculante.
1. Trabalho agêntico em terminal e codificação de fronteira
A vantagem estrutural mais clara está no Terminal-Bench 4.0, que mede engenharia de software autônoma em linha de comando. O Opus 5.5 em medium alcança 52,5%; o Sol em max consegue 43,9%. Essa é uma lacuna relativa de ~17% na classe de carga exata — ambientes shell multi-etapa, loops de construção e correção, reparo dirigido por testes — que ambos os fabricantes miram explicitamente com esses lançamentos. O número xhigh da Anthropic, 66,4%, amplia a lacuna, embora com a ressalva de número de fabricante já mencionada.
2. Trabalho de conhecimento e avaliações de inteligência geral
No GDPval-AA v2.1, uma avaliação profissional de trabalho de conhecimento, a Anthropic relata 1846 Elo. A medição independente encontrou o Sol recuando cerca de 100 Elo frente a modelos de fronteira comparáveis na mesma família de avaliações. Isso é consistente com o posicionamento do Sol: um especialista em codificação e automação que troca amplitude de conhecimento geral por eficiência de custo. Em síntese de pesquisa, análise documental e raciocínio de domínio aberto, o teto do Opus 5.5 é mais alto. Nossa cobertura do intermediário Claude Fable 5.1 dá contexto sobre até onde essa família empurrou a capacidade geral abaixo do preço do Opus.
3. A experiência do nível padrão
A característica mais subestimada do Opus 5.5 é que o padrão é o ajuste forte dele. O nível medium supera o max do Sol em pontos por dólar acima do cruzamento, o que significa que equipes sem apetite para ajustar orçamentos de esforço obtêm comportamento de fronteira fora da caixa. O melhor valor do Sol exige configuração deliberada: escolher none para tarefas determinísticas, xhigh para automação, e aceitar que o max ainda fica atrás do padrão do Opus em capacidade geral.
Onde o GPT-6 Sol realmente vence
O caso do Sol não é "quase tão bom por menos dinheiro". É uma arquitetura de custo diferente com três vantagens concretas.
1. Exatamente metade da tarifa, com interruptor de desligamento do raciocínio
A US$ 2,00 de entrada e US$ 10,00 de saída por milhão de tokens sem cache de contexto curto, o Sol custa 50% menos que o Opus 5.5 — e oferece algo que nenhum concorrente de fronteira tem: um nível none que desativa o raciocínio estendido completamente. Para extração estruturada de alto volume, classificação e geração por modelos, pagar por um modelo que não consegue parar de pensar é desperdício. O Sol deixa você fechar o medidor de raciocínio. Para uma comparação transversal dessa tabela com outros fabricantes, nossa análise de preços do Kimi K3 usa o mesmo método de custo total.
2. Eficiência de custo em automação onde a capacidade empata
No AutomationBench-AA, o Sol em xhigh marca 61,7% contra 61,2% do Opus 5.5 em medium: um empate estatístico entregue a um custo cerca de 40% menor por tarefa. Se o seu pipeline é automação de navegador, extração de DOM, navegação de formulários e orquestração de ferramentas, o Sol é a escolha racional padrão: a capacidade é idêntica, a fatura não é.
3. Disciplina de saída
O Sol gera cerca de 31K tokens de saída por tarefa em max, contra ~119K do Opus 5.5. Para agentes que devem produzir artefatos delimitados — payloads JSON, diffs de patch, resumos estruturados —, a concisão do Sol é um recurso, não uma limitação: menos tokens para analisar, menos tokens cobrados e menos superfície para loops de correção posterior.
O que desenvolvedores e a comunidade realmente dizem
Dentro de 24 horas do lançamento duplo, os fóruns de desenvolvedores produziram mais sinal do que a maioria da cobertura do dia de estreia. Seis vozes representativas, coletadas em 23 de setembro de 2026:
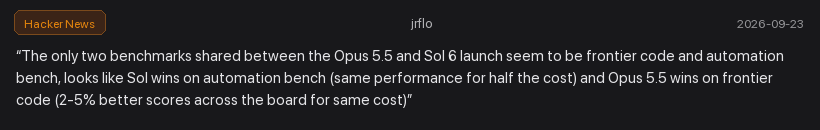
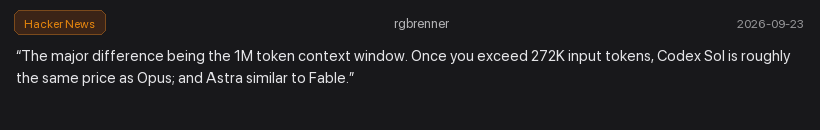
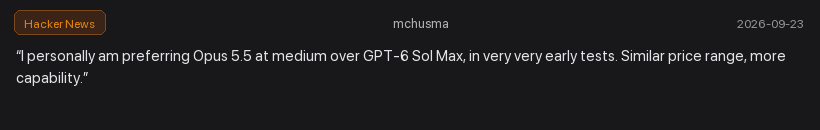
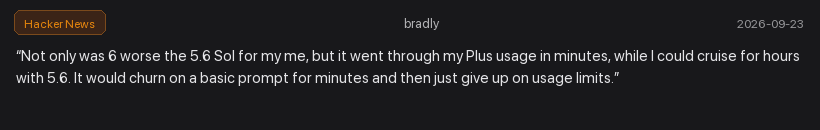
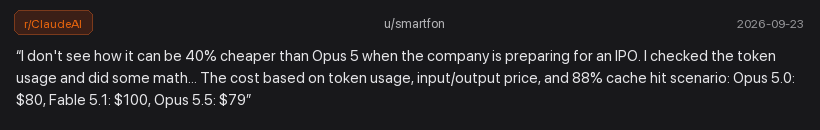
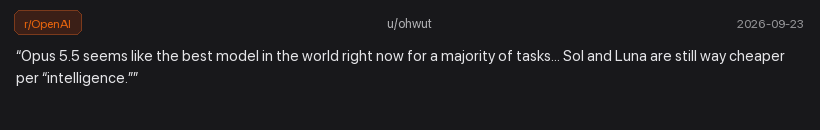
O padrão através dessas seis vozes é consistente com os dados medidos: a comunidade não coroou um único vencedor. Ela se dividiu ao longo das fronteiras de carga de trabalho — automação e eficiência de custo para o Sol, codificação de fronteira e capacidade geral para o Opus 5.5 — e concentrou-se imediatamente no alinhamento de níveis e na contabilidade de custo total, em vez da posição bruta nos rankings.
O veredito: matriz de decisão por carga de trabalho
| Perfil de carga de trabalho | Modelo recomendado | Razão decisiva | Nota de custo |
|---|---|---|---|
| Agentes de terminal e codificação via CLI | Claude Opus 5.5 | Vantagem de ~9 pontos no Terminal-Bench 4.0 em medium (52,5% contra 43,9% do Sol max) | Tarifa 2×, justificada pela lacuna de capacidade |
| Automação e extração web de alto volume | GPT-6 Sol | Empate no AutomationBench-AA (61,7% xhigh contra 61,2% medium), com none para tarefas determinísticas | ~40% mais barato por tarefa |
| Loops de agentes de contexto compacto (entrada < 272K) | GPT-6 Sol | O desconto sem cache de 2× sobrevive inteiro; leituras de cache ao mesmo preço (US$ 0,20/M) | Metade da tarifa do Opus 5.5 |
| Trabalhos de contexto longo (entrada > 272K) | Claude Opus 5.5 | A inversão de contexto longo do Sol (US$ 4/US$ 15) apaga seu desconto; Opus não tem precipício equivalente | Paridade ou melhor contra as tarifas invertidas do Sol |
| Pesquisa aberta e trabalho de conhecimento | Claude Opus 5.5 | Teto mais alto no GDPval-AA e HLE; o medium padrão supera o Sol max acima de ~44 pontos | Imposto de verbosidade maior em max |
| Assistente geral com orçamento limitado | GPT-6 Sol | Intelligence Index de US$ 1,06 por tarefa em max; o mais barato abaixo do cruzamento de ~44 pontos | Custo mínimo por unidade de inteligência |
Dos tokens crus do modelo à execução no navegador: o fluxo Tabbit
Uma pontuação de benchmark não raspa um site, não mantém uma sessão autenticada e não reconcilia documentação contraditória entre quarenta abas abertas. Modelos de base crus raciocinam sobre texto; eles não gerenciam sozinhos a proliferação de abas, shadow DOMs dinâmicos ou fluxos web multi-etapa.
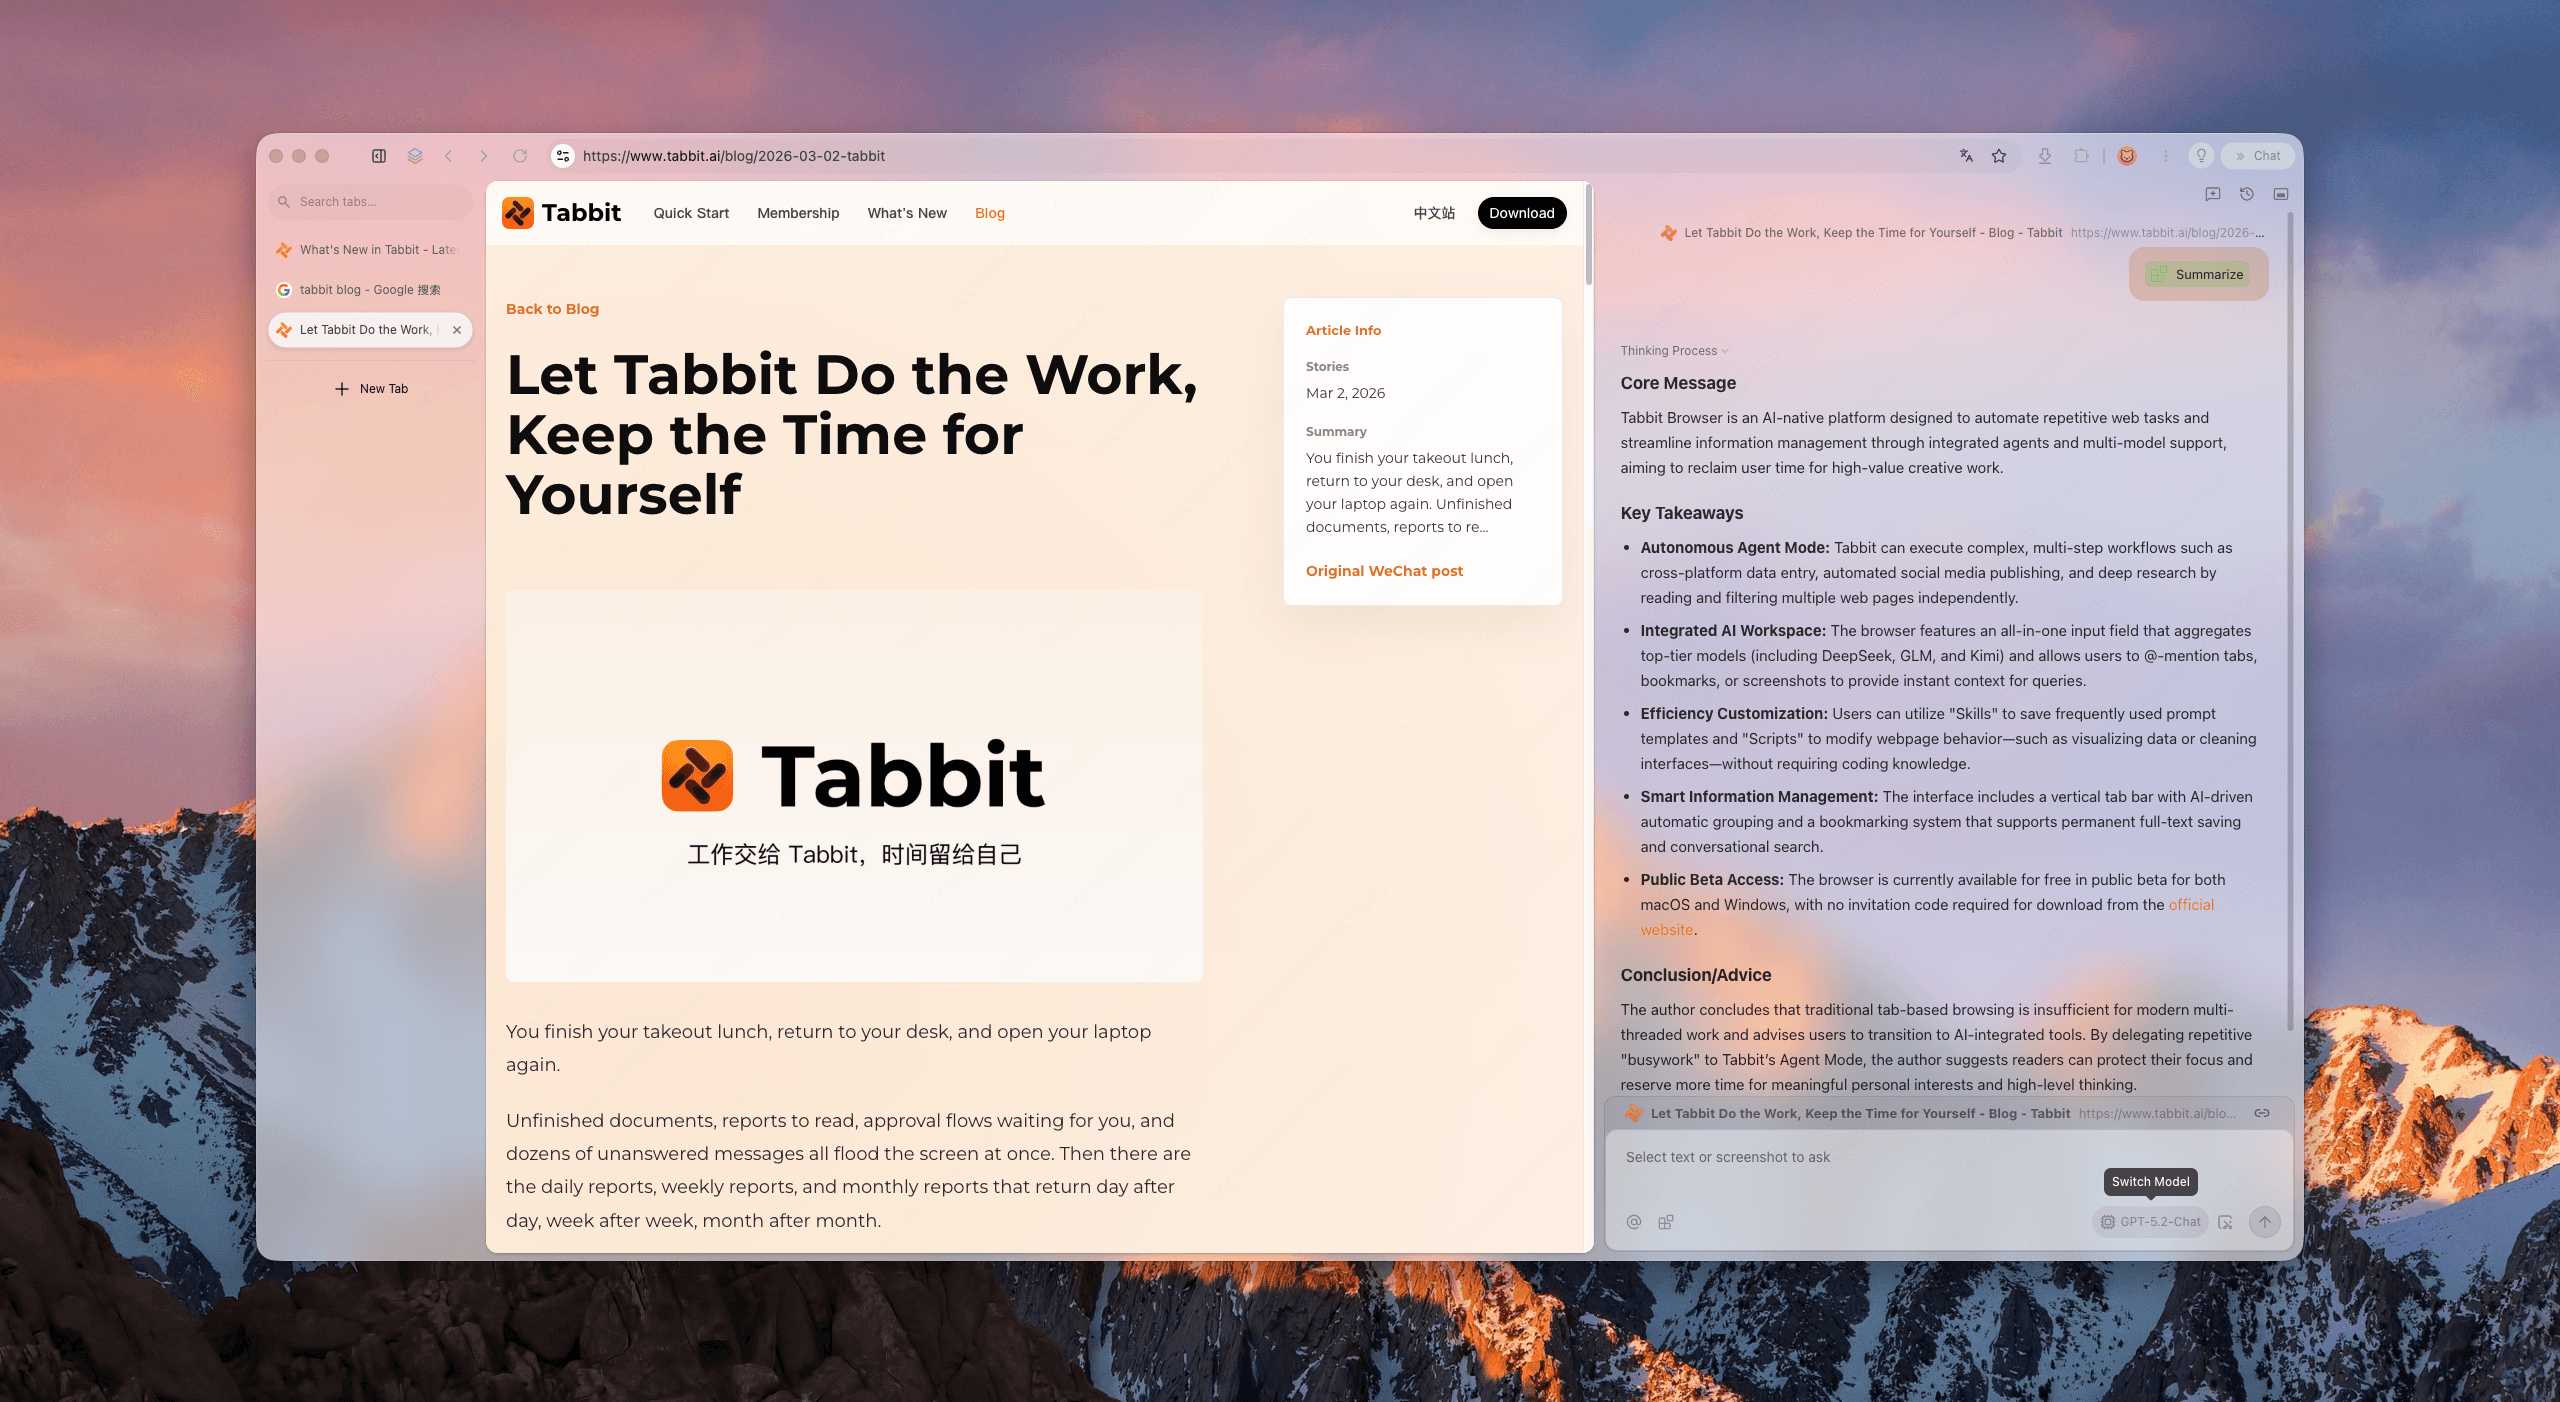
É aqui que ambientes de orquestração importam. Ao executar agentes de navegador no Tabbit Browser, o modelo fornece o raciocínio enquanto a camada do navegador fornece memória, navegação e execução. Seja dirigindo loops de automação compactos via GPT-6 Sol ou agentes de codificação de nível terminal via Claude Opus 5.5, um navegador agêntico nativo de IA é o que transforma o preço dos tokens em trabalho concluído. Veja nossa seleção dos melhores navegadores de IA de 2026 para o panorama completo.
Observação: de acordo com nossas políticas de plataforma, a disponibilidade de modelos em tempo real no Tabbit depende do seletor de modelos ativo da sua conta, das integrações suportadas e dos termos da plataforma. Esta comparação se baseia em materiais oficiais e medições independentes, e não em execuções internas de benchmark.
 Tabbit Browser

Perguntas frequentes
Qual é mais barato, GPT-6 Sol ou Claude Opus 5.5?
Nas tarifas sem cache de contexto curto, o GPT-6 Sol custa exatamente metade: US$ 2,00 de entrada e US$ 10,00 de saída por milhão de tokens, contra US$ 4,00 e US$ 20,00 do Claude Opus 5.5. Porém, quando a entrada de uma solicitação ultrapassa 272K tokens, a solicitação inteira do Sol passa a ser cobrada pelas tarifas de contexto longo (US$ 4,00 de entrada / US$ 15,00 de saída), o que elimina o desconto. A leitura de cache custa US$ 0,20 por milhão em ambos os modelos.
Qual modelo tem pontuação mais alta em benchmarks?
Depende do nível de esforço comparado. O Claude Opus 5.5 no nível medium padrão alcança 51,2 pontos no Intelligence Index a US$ 1,34 por tarefa, acima dos 47,5 pontos do GPT-6 Sol no nível máximo max a US$ 1,06. O Opus 5.5 também lidera o Terminal-Bench 4.0 (52,5% em medium, 66,4% em xhigh segundo a Anthropic) contra 43,9% do Sol em max, enquanto o Sol empata com o Opus medium no AutomationBench-AA por um custo cerca de 40% menor.
Quais são os níveis de esforço do GPT-6 Sol e do Claude Opus 5.5?
O GPT-6 Sol oferece none, low, medium (padrão), high, xhigh e max — o nível none desativa completamente o raciocínio estendido. O Claude Opus 5.5 oferece low, medium (padrão), high, xhigh e max, e seu raciocínio estendido não pode ser desativado. O nível de esforço altera tanto a capacidade quanto o custo por tarefa, portanto toda comparação deve nomear os níveis usados.
Por que tantas comparações enfrentam Opus 5.5 medium com GPT-6 Sol max?
Porque são os ajustes em que o custo total por tarefa dos dois modelos mais se aproxima. Medições com custos alinhados mostram que o Opus 5.5 em medium supera o Sol em max acima de aproximadamente 44 pontos de inteligência demandada, enquanto o Sol é a opção mais barata abaixo desse limiar. Comparações que não nomeiam os dois níveis costumam ser marketing, não medição.
O Claude Opus 5.5 é realmente 40% mais barato que o Claude Opus 5?
É o número divulgado pela Anthropic para cargas de trabalho típicas. Uma recomputação da comunidade a partir de registros de uso reais com 88% de acertos de cache chegou a cerca de US$ 79 por unidade de trabalho no Opus 5.5 contra US$ 80 no Opus 5.0 — praticamente estável, e não 40% mais barato. As afirmações de custo dos fabricantes devem ser tratadas como direcionais.
Posso usar GPT-6 Sol e Claude Opus 5.5 no Tabbit Browser?
O Tabbit Browser oferece um espaço de trabalho nativo de IA para pesquisa, extração de dados e comparação de múltiplos modelos. A disponibilidade de modelos específicos no Tabbit depende do seletor de modelos em tempo real da sua conta e dos termos da plataforma.