
Commencez par DeepSeek V4.1 Flash si vous avez besoin de poids téléchargeables ou pouvez programmer vos appels en heures creuses. Essayez LongCat 2.5 sur les tâches visuelles ou de code proches de ses points forts annoncés. L’API DeepSeek utilise désormais la version 1017, non identifiée comme telle dans le tableau LongCat.
Sur Reddit, un utilisateur a signalé des boucles lors de l’analyse de cinq classes C# avec la précédente Preview. Cette expérience isolée sur une tâche complexe ne mesure pas la version finale.
À retenir
Le tarif promotionnel LongCat égale le tarif de pointe DeepSeek ; ce dernier est réduit de moitié en heures creuses. Les deux annoncent environ 1M de contexte. Comparez les résultats acceptés, les reprises et la facture avec des versions et outils identiques.
LongCat annonce 1,6T de paramètres et environ 48B actifs par token. DeepSeek décrit un MoE de 552B avec 8B actifs en entrée et 16B en sortie. Ces chiffres ne permettent pas de comparer directement le calcul.
Pour situer les familles, consultez notre guide DeepSeek V4.1 Flash et celui de LongCat 2.0. Ce dernier décrit la génération précédente, pas un essai de 2.5.
Comparaison des caractéristiques
| Critère | LongCat 2.5 | DeepSeek V4.1 Flash |
|---|---|---|
| Contexte total API | 1,048,576 | 1M |
| Sortie maximale | 262,144 | 384K |
| Entrée visuelle | Images et vidéos documentées | Vision ; vérifier la prise en charge vidéo |
| Poids | Annoncés à venir | Téléchargeables |
| Prix par million de tokens | $0.30 / $0.006 / $1.20 | pointe: $0.30 / $0.006 / $1.20; creuse: $0.15 / $0.003 / $0.60 |
Prix en dollars pour entrée non mise en cache, entrée en cache et sortie, dans cet ordre. Données vérifiées le 3 novembre 2026. LongCat indique désormais une limite de 256K en sortie, contre 128K dans certains articles tiers. Vérifiez la limite de votre API avant déploiement. Le nombre de paramètres ne classe pas à lui seul la qualité ou la vitesse. LongCat · LongCat API · DeepSeek
Coût : égal en pointe, moitié prix en heures creuses
Les heures de pointe DeepSeek sont du lundi au vendredi de 01:00 à 04:00 et de 06:00 à 10:00 UTC, hors jours fériés chinois. Pour 300 000 tokens entrants sans cache, 200 000 en cache et 100 000 en sortie, LongCat et DeepSeek en pointe coûtent $0,2112 ; DeepSeek en heures creuses coûte $0,1056. Ce calcul suppose une consommation identique, pas un taux de réussite identique. Recherche, extraction et reprises peuvent s’ajouter. LongCat · DeepSeek
Le calcul distingue les trois catégories de tokens :
LongCat = 0,3 × $0,30 + 0,2 × $0,006 + 0,1 × $1,20 = $0,2112
DeepSeek en pointe = $0,2112
DeepSeek en heures creuses = 0,3 × $0,15 + 0,2 × $0,003 + 0,1 × $0,60 = $0,1056
Pour 1 000 tâches identiques, cela donne respectivement $211,20 et $105,60 avant autres frais. Les modèles peuvent produire des quantités de raisonnement différentes ou nécessiter plus de reprises ; mesurez le coût par résultat accepté. Notre guide tarifaire DeepSeek V4 Flash porte sur une génération antérieure : vérifiez le tarif actuel chez le fournisseur.
Tests de code : le résultat dépend de la tâche
Le tableau LongCat affiche 88,4 contre 90,6 sur Terminal Bench v2.1 ; 38,5 contre 31,2 sur v4.0 ; 25,5 contre 20,3 sur Program Bench ; 64,6 contre 74,2 sur DeepSWE v1.1. Sur BrowseComp : 91,9 contre 91,5. Les scores concurrents marqués d’un astérisque viennent de sources publiques, les autres de tests LongCat. Les versions et configurations ne sont pas nécessairement identiques. LongCat
| Test publié | LongCat 2.5 | DeepSeek V4.1 Flash | Écart indiqué |
|---|---|---|---|
| Terminal Bench v2.1 | 88,4 | 90,6 | DeepSeek +2,2 points |
| Terminal Bench v4.0 | 38,5 | 31,2 | LongCat +7,3 points |
| Program Bench | 25,5 | 20,3 | LongCat +5,2 points |
| DeepSWE v1.1 | 64,6 | 74,2 | DeepSeek +9,6 points |
| BrowseComp | 91,9 | 91,5 | LongCat +0,4 point |
LongCat précise que le raisonnement était activé et décrit certains environnements de test. Cela ne garantit pas un budget, un environnement ou une version identiques dans les deux colonnes. La version 1017 de DeepSeek n’est pas identifiée dans ce tableau. Un écart de 0,4 point sur BrowseComp ne démontre pas un avantage pratique sans estimation de l’incertitude.
Pour choisir un agent, utilisez les mêmes tâches de dépôt, figez les versions, les outils et le nombre de reprises, puis relevez tests réussis, temps et tokens. Notre article sur le raisonnement des agents explique le rôle des outils et de la récupération après erreur.
Vision, contexte et déploiement
LongCat documente les images et vidéos ; DeepSeek propose aussi la vision. Vérifiez les formats et limites de votre fournisseur. Un contexte de 1M représente une capacité, pas une garantie de restitution parfaite. Testez le rappel à plusieurs endroits et la latence. DeepSeek publie ses poids ; LongCat annonce ceux de 2.5 à venir. Vérifiez licence, matériel et coûts avant un hébergement interne. LongCat · DeepSeek
Pour les longs documents, réservez de la place pour la réponse et testez le rappel au début, au milieu et à la fin. Pour les images, essayez des captures contenant du texte fin et des tableaux. LongCat documente des URL publiques pour les vidéos ; vérifiez les formats et limites avant l’envoi. Une fenêtre plus large ne remplace pas ces essais.
Retours sur la Preview
Dans un test Terminal Bench, un utilisateur rapporte moins d’exceptions et de délais pour la Preview, avec une tâche affectée par une panne locale et des essais à des dates différentes. Un autre décrit des boucles sur une migration de code, interrompues par une intervention. Ces retours ne prouvent pas le comportement de la version finale.
Fixez un plafond de reprises et consignez les appels répétés pour repérer les boucles. Vérifiez les modifications et lancez les tests avant d’accepter le code. Ces retours concernent la Preview et ne mesurent pas le taux d’échec de la version finale.
Organiser les sources dans Tabbit Browser
Ouvrez les documents officiels et vos résultats dans Tabbit. Avec Chat with Page, relevez version, tarif et date, puis vérifiez chaque élément à la source. La capture montre d’autres modèles : elle ne prouve pas la disponibilité des deux modèles comparés. Consultez le sélecteur ; si nécessaire, testez chaque API séparément.
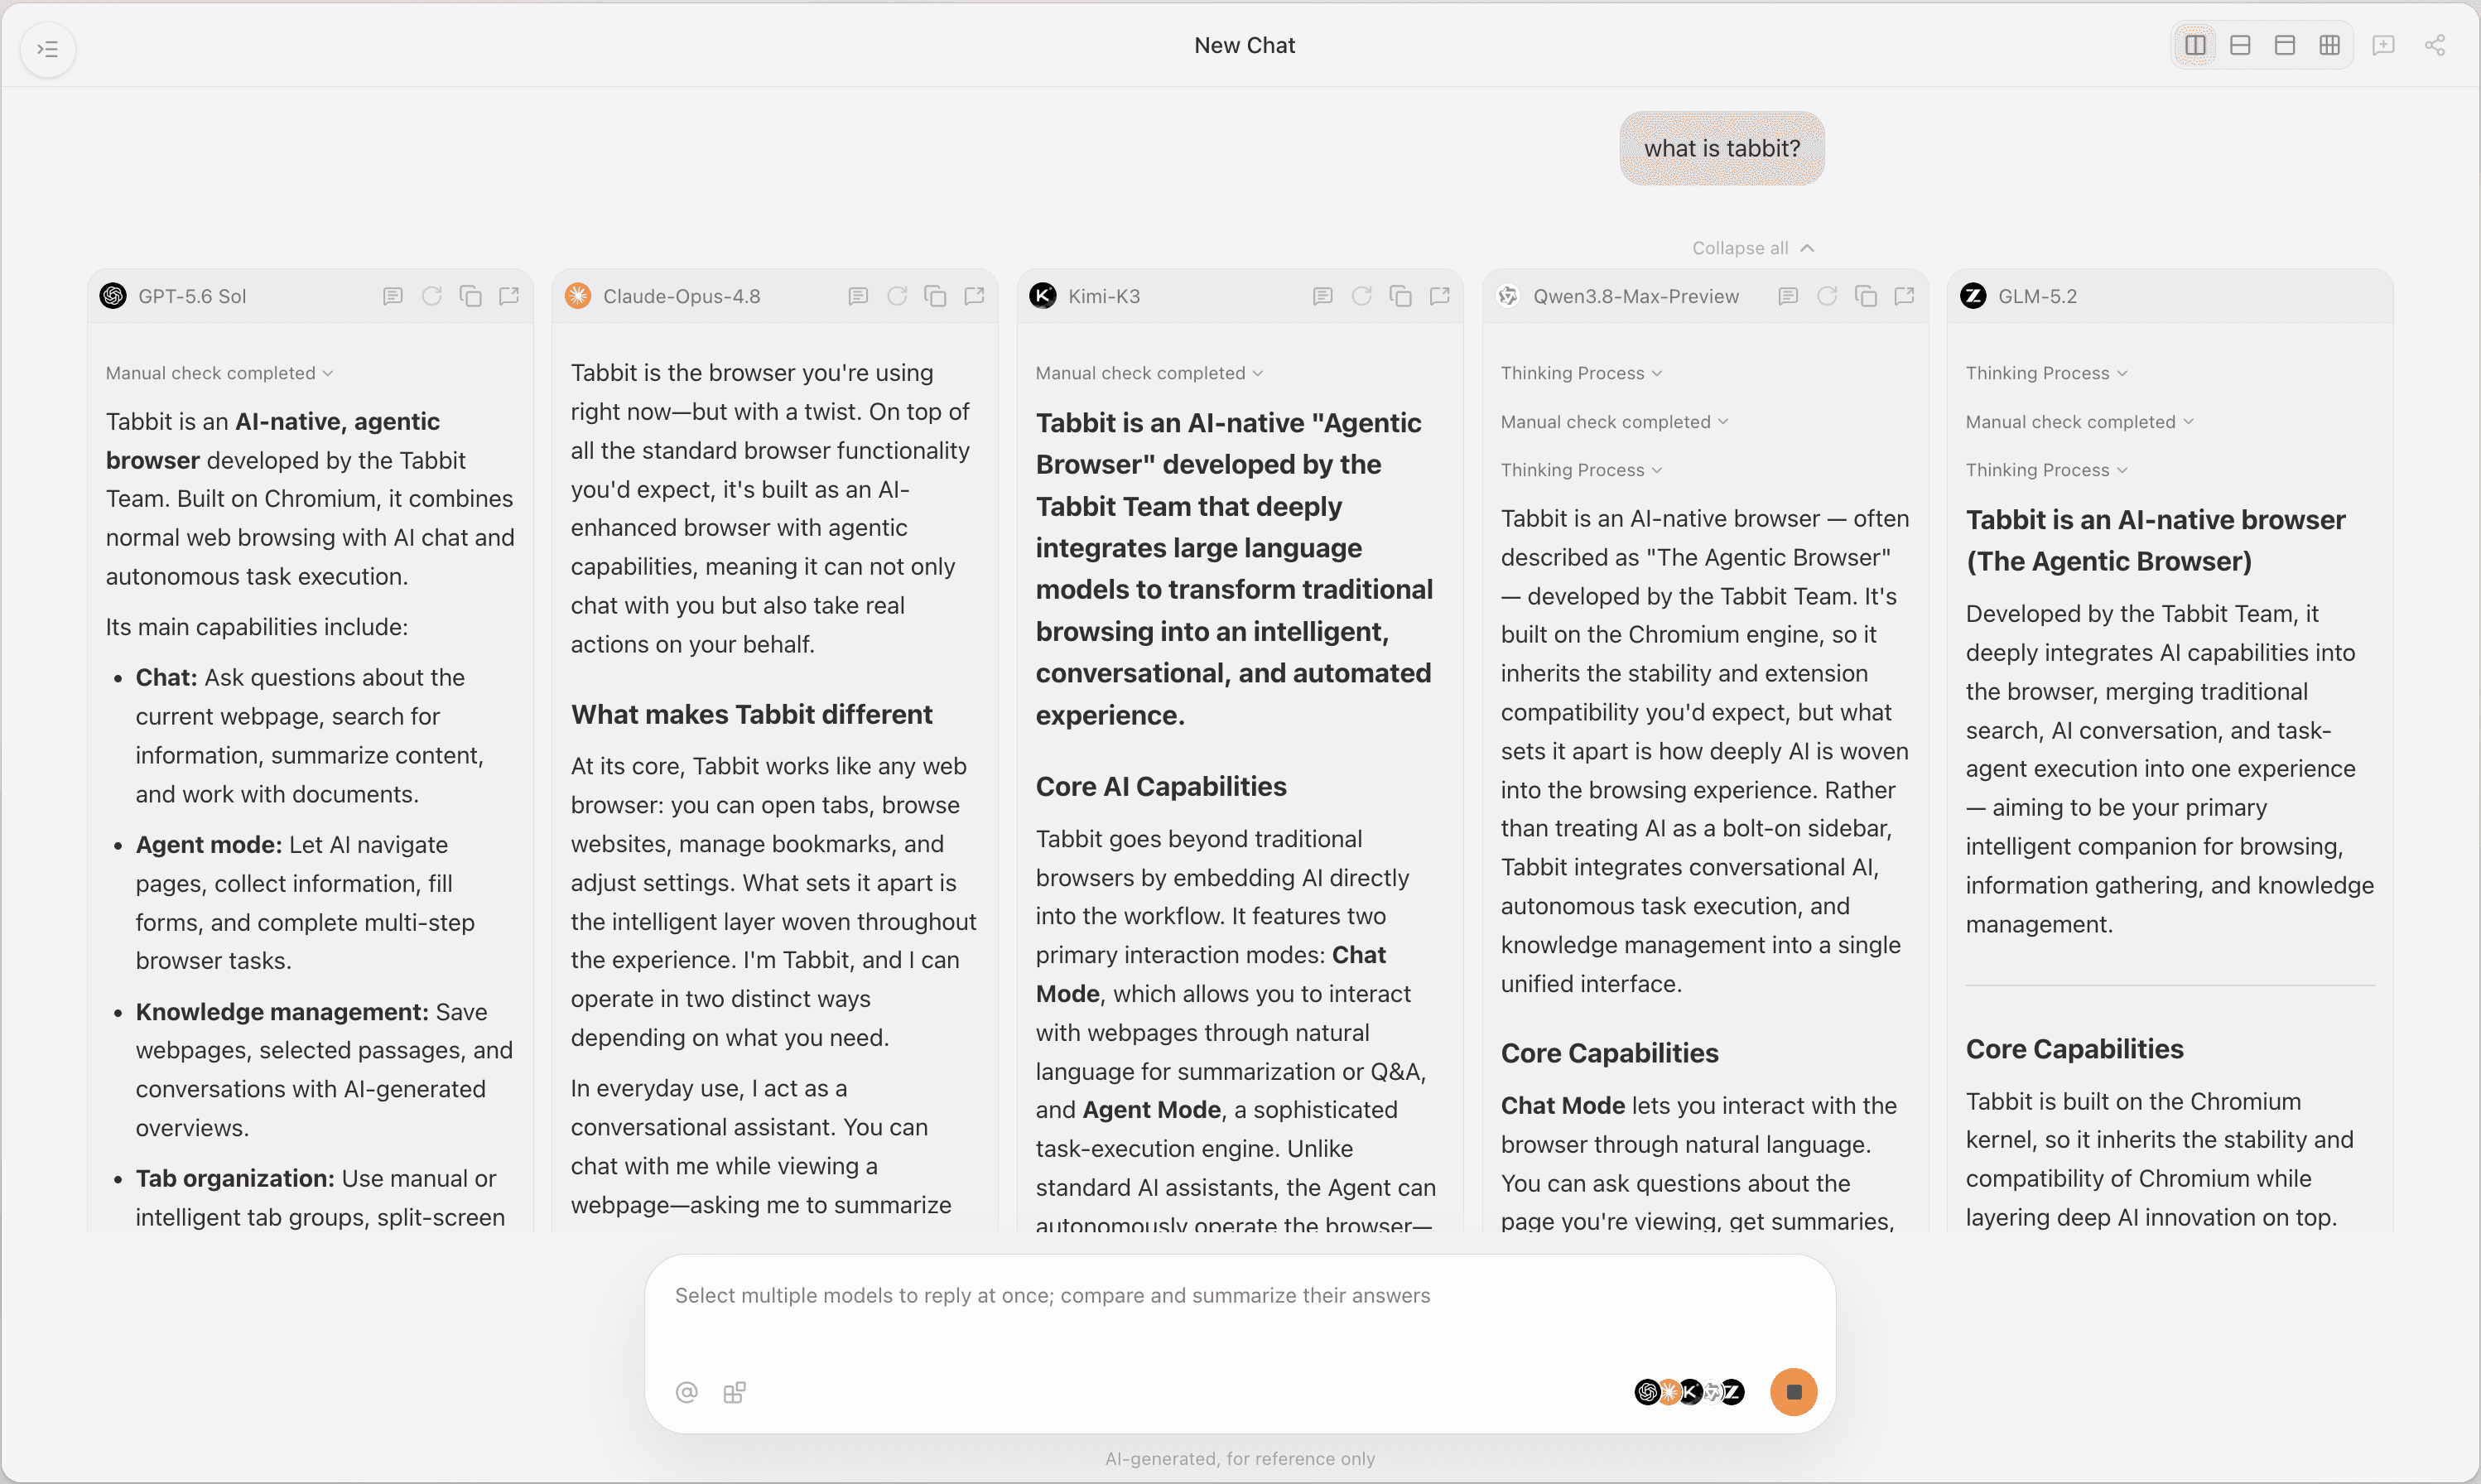
Par exemple, ouvrez les deux pages tarifaires et le tableau du fournisseur. Demandez à Chat with Page d’en extraire la version, la date et les unités, puis vérifiez chaque donnée à la source. Conservez vos résultats sur les mêmes tâches. Le guide Tabbit décrit les fonctions de contexte. Pour automatiser la navigation, lisez aussi ce que fait un navigateur agentique et notre comparatif des navigateurs IA. Les réponses parallèles aident à repérer les désaccords, mais ne remplacent pas un test contrôlé.
Quel modèle choisir ?
| Priorité | Point de départ | À vérifier |
|---|---|---|
| API économique pour tâches programmables | DeepSeek | Horaires, tokens et frais des outils |
| Télécharger les poids maintenant | DeepSeek | Licence, matériel et hébergement |
| Images ou vidéos | LongCat | Format, précision et limites |
| Code et longs documents | LongCat + DeepSeek | Mêmes tâches, versions et reprises |
DeepSeek constitue une première référence si le tarif creux ou les poids disponibles sont décisifs. Si les entrées visuelles ou un test précis favorisent LongCat, comparez les deux sur les mêmes tâches en incluant la révision humaine.
Si le tarif creux et les poids disponibles déterminent votre choix, prenez DeepSeek comme première référence. Pour les tâches visuelles ou les tests favorables à LongCat, comparez les deux sur un échantillon représentatif. Une autre comparaison de modèles montre pourquoi le résultat dépend du travail demandé.

Questions fréquentes
Quelle API officielle coûte le moins cher ?
Au 3 novembre 2026, le tarif promotionnel LongCat égalait le tarif de pointe DeepSeek. Le tarif creux DeepSeek était deux fois moins élevé, hors frais supplémentaires.
Quel modèle est le meilleur pour coder ?
Le tableau de LongCat donne des résultats favorables aux deux modèles selon le test. Comparez des versions et outils fixes sur vos propres tâches.
Quelles sont les limites de contexte et de sortie ?
LongCat indique 1 048 576 tokens au total et une limite max_tokens de 262 144. DeepSeek annonce un contexte de 1M et une sortie maximale de 384K, dans la limite du contexte total.
Peut-on télécharger les poids ?
DeepSeek fournit un lien de téléchargement. La page de lancement LongCat annonce ses dépôts 2.5 comme à venir ; vérifiez leur disponibilité et leur licence.
Les deux acceptent-ils images et vidéos ?
Les deux proposent une compréhension visuelle et LongCat documente les images et vidéos. Les formats et limites varient selon le fournisseur.
Ces deux modèles sont-ils dans Tabbit ?
La disponibilité dépend du sélecteur actuel, du compte et de la région. La capture montre d’autres modèles.