
MiniMax M3.1 Flash cuesta 0,15 USD por millón de tokens de entrada nuevos, 0,015 USD por millón de entrada en caché y 0,60 USD por millón de salida, según la tarifa oficial, consultada el 21 de octubre de 2026. Esas tarifas corresponden al uso de la API. Las suscripciones a M Plan, la oferta gratuita de lanzamiento de un proveedor y el acceso desde Tabbit Browser son decisiones de compra distintas.
La cifra que conviene usar en el presupuesto es 0,015 USD por la entrada en caché. Es un 90 % menos que la tarifa de entrada nueva de Flash y un 75 % menos que la tarifa estándar de lectura de caché de M3. Eso puede cambiar el coste de un agente que vuelve a leer el mismo contexto. No significa que cada tarea completada cueste un 90 % menos. Una conversación entre desarrolladores señala algo práctico: las lecturas de caché más baratas pueden coincidir con un mayor volumen de tokens de salida. Más adelante explicamos cómo comprobar el acceso en Tabbit antes de considerarlo una opción de ejecución.
Tarifas de un vistazo
Todos los valores siguientes son USD por millón de tokens y proceden de la misma página de precios de MiniMax. La comparación con M3 usa su nivel Standard, no Priority ni una ruta de revendedor con descuento.
| Concepto de facturación | M3.1 Flash | M3 Standard, entrada de hasta 512K | Cambio frente a esa fila de M3 |
|---|---|---|---|
| Entrada nueva | $0.15 | $0.30 | 50 % menos |
| Entrada en caché | $0.015 | $0.06 | 75 % menos |
| Salida | $0.60 | $1.20 | 50 % menos |
| Entrada por encima de 512K | Las mismas tarifas planas de Flash | $0.60 entrada / $0.12 caché / $2.40 salida | Flash es un 75 % / 87,5 % / 75 % más barato |
Las tarifas de entrada y salida de Flash son la mitad que las de M3 para entradas cortas. La tarifa de entrada en caché baja aún más. En M3, superar 512K tokens de entrada cambia la fila aplicable; no significa que solo se facture el exceso a una tarifa mayor. Comprueba el número exacto de tokens de entrada de cada solicitud. El total acumulado de una sesión no es la medida del umbral.
El número de tokens no equivale al de caracteres. MiniMax estima que 1.000 tokens corresponden aproximadamente a 750 palabras en inglés, aunque el consumo real varía según el caso. No encontramos un porcentaje verificado de cambio del tokenizador para Flash. Por eso los ejemplos indican tokens medidos o supuestos, en vez de inventar una conversión de texto a tokens.
Puntos clave
Las entradas de Flash atendidas desde la caché cuestan una décima parte de las nuevas. Una tasa alta de aciertos importa sobre todo cuando la salida sigue controlada.
La reducción del 70 % en el coste por tarea es una afirmación sobre cargas de trabajo del proveedor, distinta de la reducción del 50 % en las tarifas de entrada y salida.
La API directa usa
maxpor defecto. Thinking sigue activo con los niveles inferiores.La búsqueda web del servidor cuesta 0,01 USD por solicitud, además de los tokens del modelo.
El periodo gratuito de lanzamiento de OpenRouter tiene una hora de finalización explícita. Usa las tarifas de pago para planificar presupuestos de producción.
La cifra que cambia el presupuesto de un agente: 0,015 USD
La documentación de caché de MiniMax describe el almacenamiento automático en caché de prefijos para solicitudes de al menos 512 tokens de entrada. El orden de coincidencia es herramientas, prompts de sistema y, después, mensajes de usuario. Coloca primero las instrucciones estables y el material de referencia reutilizable; deja al final los detalles cambiantes de cada tarea. Una ventana de contexto grande por sí sola no genera aciertos de caché.
Supongamos que un agente lee un prefijo de 100.000 tokens en 40 llamadas. Si la primera usa solo entrada nueva y las 39 siguientes son aciertos completos de caché, esa entrada cuesta $0.015 + 39 × $0.0015 = $0.0735. Sin aciertos, los mismos cuatro millones de tokens de entrada cuestan $0.60. Es un escenario ilustrativo con muchos aciertos, no una garantía observada de caché. Un historial que crece o prefijos modificados elevan el coste.
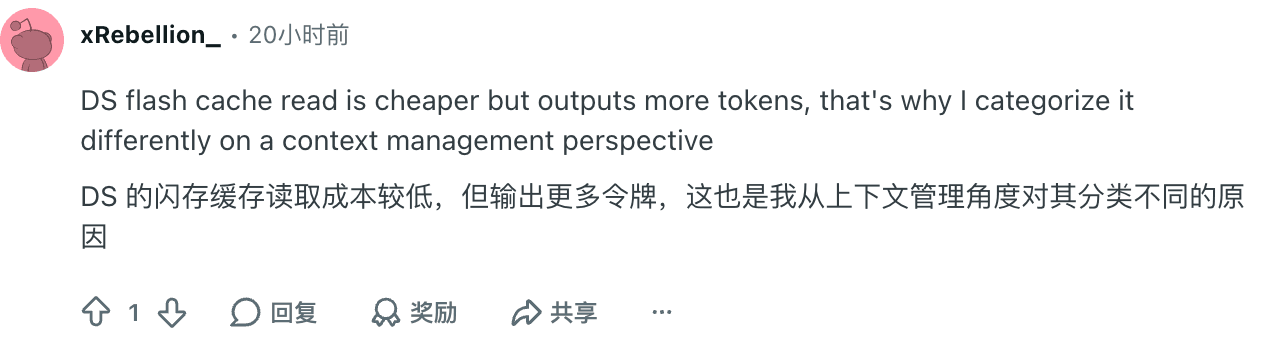
Lee el comentario original. Su conclusión sirve para decidir una compra: compara el total de tokens generados en la misma tarea antes de elegir un modelo por el precio de su caché.
Un detalle contable evita cobrar dos veces lo mismo en tu hoja de cálculo. En la respuesta compatible con Anthropic, usage.input_tokens representa la entrada nueva; suma usage.cache_read_input_tokens a la tarifa de caché. En la respuesta compatible con OpenAI, usage.prompt_tokens ya incluye la entrada en caché; resta usage.prompt_tokens_details.cached_tokens antes de aplicar la tarifa de entrada nueva. La guía oficial de caché documenta ambas convenciones.
Qué significa realmente la afirmación de un ahorro del 70 %
La publicación de lanzamiento del 19 de octubre afirma que el uso en tareas agénticas cuesta un 70 % menos que con el modelo predecesor. Es la cifra agregada del proveedor para el coste por tarea. La tarifa establece por separado que la entrada nueva y la salida cuestan un 50 % menos que en M3 para entradas cortas, y las lecturas de caché un 75 % menos. Son magnitudes distintas.
Para reproducir un ahorro del 70 % en tu trabajo, mantén constantes la tarea, los criterios de éxito, el entorno de ejecución y la política de reintentos. Registra la entrada nueva, la entrada en caché, la salida facturable, las solicitudes a herramientas y el número de resultados aceptados. Una tarea que cuesta menos por intento puede acabar costando más por resultado aceptado si necesita más intentos. Este artículo no ha realizado una comparación de producción de siete días ni presenta el porcentaje del proveedor como un ahorro medido con Tabbit.
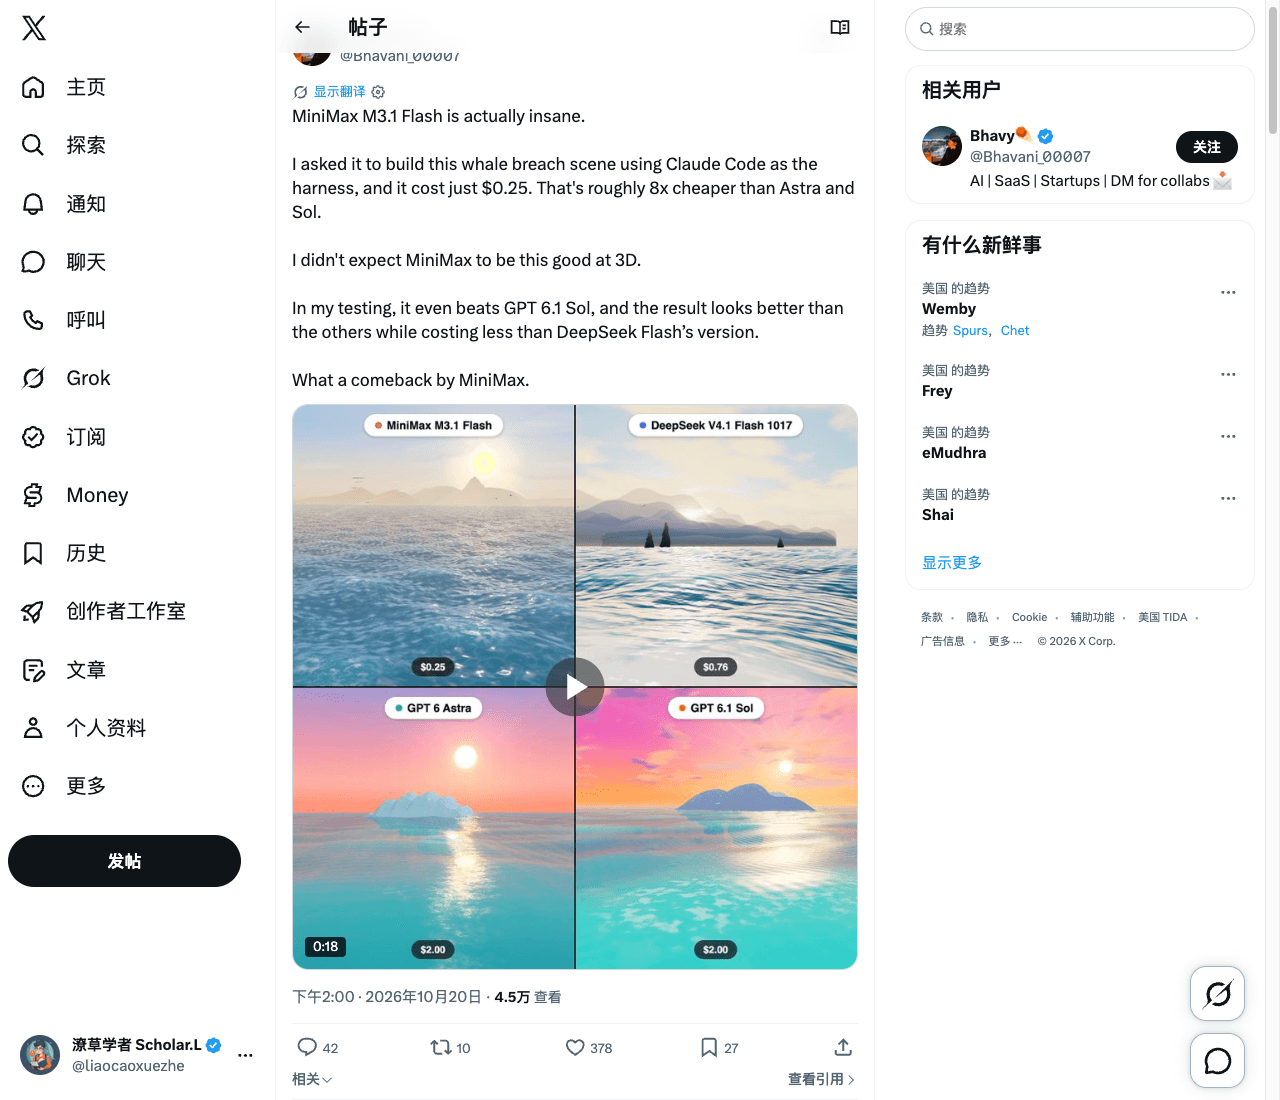
Bhavy publica un ejemplo positivo en X: afirma haber gastado 0,25 USD en crear una animación de una ballena con Claude Code. Es un informe concreto de una tarea, pero la publicación no incluye una factura completa de tokens, un nivel de esfuerzo fijo ni intentos repetidos. Sirve como evidencia de un resultado declarado por un usuario, no como previsión para tu aplicación.
Conceptos de facturación fuera de la tabla de tokens
La página oficial de precios indica que web_search en el servidor cuesta 0,01 USD por solicitud. Diez mil búsquedas suman 100 USD antes de los tokens. La línea MCP API-vlm también cuesta 0,01 USD por solicitud. Las herramientas externas de cada cliente pueden usar otros servicios y tarifas, así que no asignes estos cargos a todas las llamadas de funciones locales.
El precio de lanzamiento de Flash se describe como plano. No verificamos descuentos por procesamiento por lotes para Flash, recargos regionales, multiplicadores Priority ni la caducidad de promociones en la tarifa directa de la API. Calcula el presupuesto con las tarifas publicadas; que no aparezca una línea no demuestra que todos los proveedores ofrezcan las mismas condiciones. El calculador excluye impuestos, conversión de divisa, ejecución externa y costes de reintentos.
La página de Venice indica 0,19 USD por entrada, 0,02 USD por entrada en caché y 0,75 USD por salida. El aviso del modelo en OpenRouter describe un periodo gratuito temporal que termina el 22 de octubre de 2026 a las 12:00 UTC, o a las 20:00 en Singapur. Indica que la variante :free se retirará después e indica a las integraciones que cambien a minimax/minimax-m3.1-flash. Tómalo como un aviso fechado del proveedor, no como un nivel gratuito permanente.
La escala de modelos y el control de esfuerzo
| Modelo o fila de facturación | Entrada nueva / entrada en caché / salida por millón | Cuándo elegirlo | Condición principal del presupuesto |
|---|---|---|---|
| M3.1 Flash | $0.15 / $0.015 / $0.60 | Probar tareas de programación cotidianas y ciclos repetidos de herramientas | Controla la salida generada y confirma los aciertos de caché |
| M3 Standard, entrada de hasta 512K | $0.30 / $0.06 / $1.20 | Mantener un flujo de trabajo M3 probado durante la comparación | Compara resultados aceptados antes de migrar |
| M3 Standard, entrada por encima de 512K | $0.60 / $0.12 / $2.40 | Una solicitud concreta de M3 necesita la fila de entrada larga | Se aplica a la fila de facturación de esa solicitud |
Esta es una comparación de dos modelos disponibles y tres configuraciones de facturación. La publicación de lanzamiento dice que Pro llegará más adelante; no es un tercer modelo con precio que debamos inventar para el calculador. Nuestro resumen de M3 explica el contexto de acceso al modelo anterior. Sus cifras históricas de suscripción no deben sustituir la tarifa de hoy. Para métodos de comparación, consulta la guía de precios de DeepSeek y la guía de precios de Gemini Flash; comprueba sus precios oficiales antes de comprar.
La limitación inesperada es que optimizar la caché puede convertir la salida en el principal coste. Con un 90 % de entrada en caché, la tarifa efectiva de entrada de Flash es de $0.0285 por millón, mientras que la salida sigue en $0.60 por millón. En esa combinación, un token de salida cuesta unas 21 veces más que uno de entrada.
La guía de invocación de MiniMax admite los niveles de esfuerzo low, medium, high, xhigh y max, con max como valor predeterminado. Indica que un esfuerzo mayor produce más tokens de salida y latencia, y que thinking no se puede desactivar. Prueba niveles bajos en los pasos rutinarios y conserva los más exigentes cuando la calidad lo requiera. Cuenta una sola vez la salida facturada, incluido el razonamiento; no vuelvas a sumar thinking si el total de uso ya lo incluye.
Qué es gratis y qué exención no pudimos verificar
La caché automática está documentada sin requisitos de configuración adicionales, y la tarifa publicada de Flash incluye entrada nueva, lecturas de caché y salida. No encontramos en ella un cargo aparte por almacenamiento de caché o escritura de caché para Flash. Ese es el alcance de la tabla publicada, no una promesa contractual sobre servicios que no aparecen en ella.
No verificamos un reembolso universal por tareas de texto rechazadas, interrumpidas o fallidas. La regla de la página de precios que no descuenta los trabajos de vídeo fallidos se refiere al vídeo y no puede trasladarse a este modelo de texto. Una respuesta que haya que corregir puede haber consumido tokens facturables. No llames gratis al razonamiento, la entrada en caché ni los reintentos del agente.
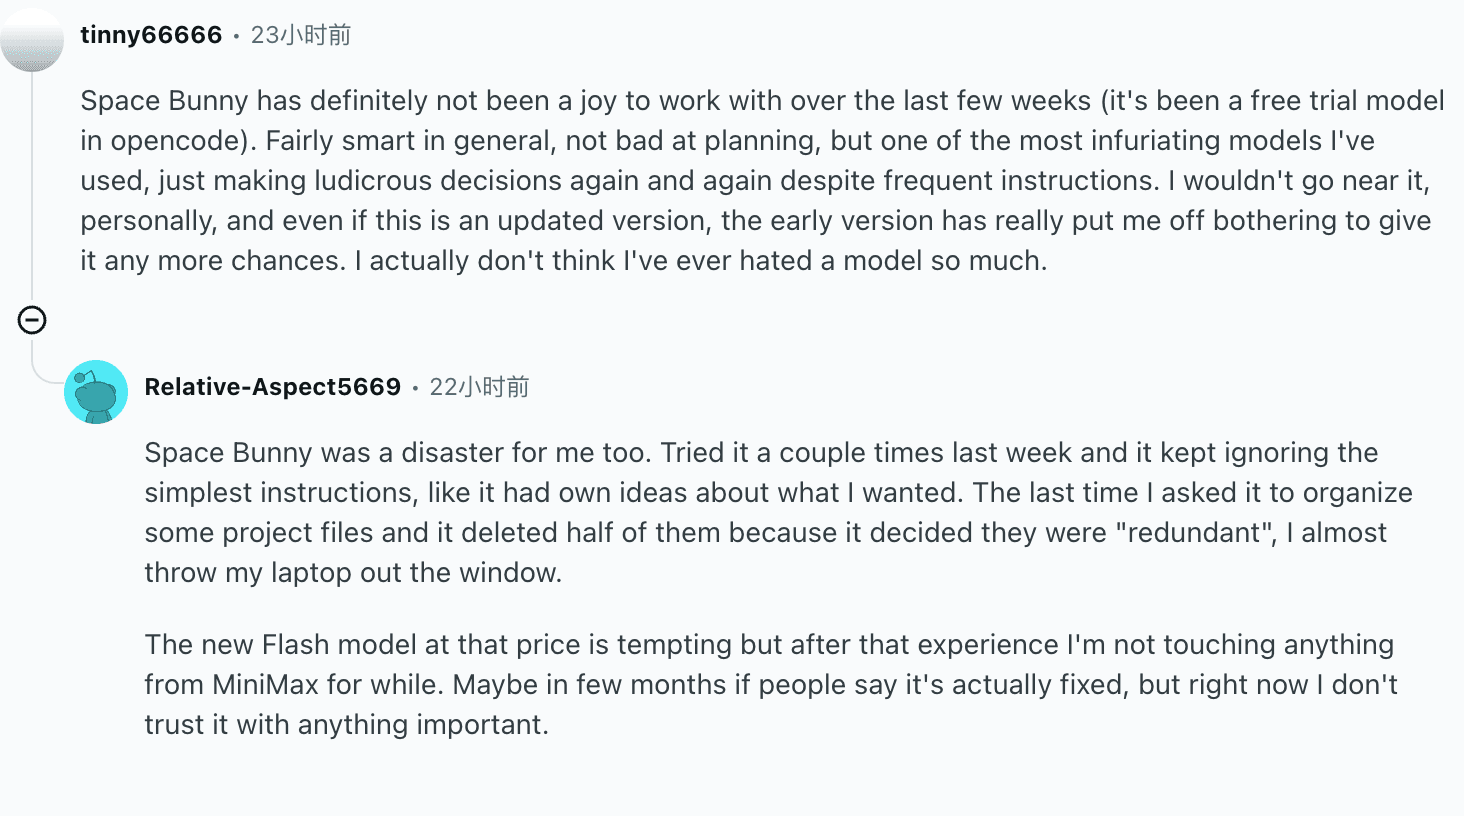
El usuario de Reddit tinny66666 describe decisiones repetidamente malas de Space Bunny mediante OpenCode en su comentario. Se refiere a la versión preliminar anterior, no a una prueba controlada del Flash publicado. Aun así, muestra por qué el presupuesto necesita una provisión para reintentos y un criterio de aceptación.
M Plan es una compra distinta
La página actual de M Plan incluye M3.1 Flash en Go, Explore y Build; Explore muestra 3 veces el uso de Go y Build, 7,5 veces. En la vista anual aparecían 220, 550 y 1.320 USD al año cuando la consultamos. Son totales anuales, no precios mensuales. Comprueba el selector de facturación activo y el pago antes de comprar; no dividas el uso anunciado del plan para deducir un precio de tokens de API.
La tabla comparativa también muestra un uso limitado de Flash en el nivel gratuito del cliente, que no incluye una clave API para herramientas de programación. MiniMax Code está incluido en M Plan. Las preguntas frecuentes indican que una Subscription Key consume la asignación del plan y después los paquetes de crédito disponibles, mientras que una API Key de pago por uso descuenta del saldo de la cuenta. Esa diferencia determina qué pasa cuando se agota una ventana de uso.
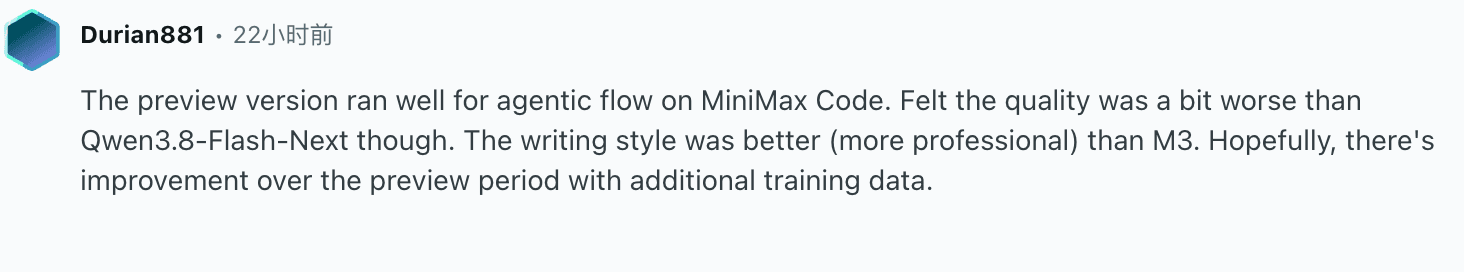
En un comentario, Durian881 afirma que la versión preliminar funcionó bien para flujos agénticos en MiniMax Code, aunque prefiere la calidad de otro modelo. Mantén asociada a esa opinión la versión y el cliente. No demuestra que cualquier flujo de trabajo de M Plan vaya a caber en su asignación.
Dos presupuestos que puedes reproducir
Son ejemplos aritméticos con las tarifas del 21 de octubre, no cargas de trabajo ejecutadas. La entrada es el total de entrada de todas las llamadas de una tarea y la salida es toda la salida facturable de esas llamadas. Una tarea real con varias llamadas en M3 debe elegir la fila tarifaria solicitud por solicitud.
coste = (entrada nueva × 0.15 + entrada en caché × 0.015 + salida × 0.60) / 1,000,000
coste mensual de tokens = coste por tarea × tareas al mes
coste por resultado aceptado = cargos de tokens y herramientas / resultados aceptados| Carga de trabajo supuesta | Entrada total/tarea | Porcentaje en caché | Salida/tarea | Tareas/mes | Tokens Flash/mes |
|---|---|---|---|---|---|
| Extracción de páginas | 20,000 | 20 % | 1,000 | 10,000 | $30.60 |
| Agente con contexto repetido | 200,000 | 90 % | 10,000 | 1,000 | $11.70 |
Para la extracción, (16,000 × 0.15 + 4,000 × 0.015 + 1,000 × 0.60) / 1,000,000 = $0.00306 por página. Diez mil páginas cuestan 30,60 USD en tokens. Sin aciertos, serían 36,00 USD, así que esta carga de trabajo ahorra un 15 %, no un 90 %. Una búsqueda web en el servidor por página añade 100 USD.
Para el agente, (20,000 × 0.15 + 180,000 × 0.015 + 10,000 × 0.60) / 1,000,000 = $0.0117 por tarea. Mil tareas cuestan 11,70 USD, frente a 36,00 USD sin aciertos de caché. Si todos los volúmenes de tokens se mantienen, M3 para entradas cortas costaría 28,80 USD. Si la salida de Flash se duplica a 20.000 tokens, la factura mensual sube a 17,70 USD. Por eso el esfuerzo y los reintentos deben formar parte del presupuesto.
Calculadora local de costes mensuales
Introduce los mismos volúmenes para comparar Flash con las dos filas de M3 Standard. La fila larga de M3 es un escenario de sensibilidad, no una afirmación de que el total acumulado de tokens de una sesión supere el umbral por solicitud. La calculadora usa el total de entrada y el porcentaje en caché, por lo que nunca cuenta dos veces la entrada en caché. No envía a analítica los valores ni las estimaciones introducidos.
Estima el coste mensual de tokens
Tarifas en USD revisadas el 21 de octubre de 2026. Las dos filas M3 son escenarios comparativos; aplica la fila correspondiente a cada solicitud. Excluye herramientas, reintentos, impuestos y cargos del proveedor. Los valores permanecen en el navegador; la analítica solo registra que cambió un campo.
Consultar tarifas oficialesComprobar un flujo de trabajo de navegador con Tabbit
El siguiente paso después de calcular el presupuesto de la API es decidir dónde se ejecutará la tarea. En los agentes basados en navegador, el cliente proporciona el contexto de la página, los permisos de herramientas y el flujo de trabajo que rodea al modelo. Lee la introducción a Tabbit y la guía práctica de uso para conocer esa capa, o la comparación de navegadores al elegir un cliente.
El 21 de octubre comprobamos el selector de modelos del entorno de prueba de Tabbit. Mostraba MiniMax-M3 y Friday-MiniMax-M3, pero no M3.1 Flash. Por eso no enviamos una tarea con un modelo sustituto para etiquetarla como prueba de Flash. Este artículo no incluye transcripción, registro de herramientas ni coste medido de Flash en Tabbit. La página de recursos públicos de M3.1 Flash (English) es un índice de investigación; sus guías de prompts (English) y fuentes de evaluación (English) sirven para preparar una prueba, no demuestran acceso a la cuenta.
Cuando el modelo exacto aparezca en tu cuenta, haz una comprobación reversible: abre la tarifa oficial, pide las tres tarifas de tokens con sus unidades y la URL de la fuente, y compara la respuesta con la página. Registra la etiqueta del modelo, la versión del cliente, los indicadores de herramientas, el prompt y el resultado. Una respuesta correcta solo verifica esa muestra. Las asignaciones de Tabbit siguen siendo independientes de los precios de la API directa indicados arriba.
Veredicto: calcula el coste de la tarea aceptada antes de comprar un plan
Empieza una prueba piloto con las tarifas de pago de M3.1 Flash si tu flujo depende del contexto repetido y puedes controlar la salida. Mide los aciertos de caché y los resultados aceptados, reduce el esfuerzo cuando la calidad lo permita y fija un límite de reintentos. Conserva una ruta M3 funcional hasta que la comparación demuestre una mejora real en tus tareas.
Elige M Plan si sus condiciones de uso y el cliente incluido encajan con tu trabajo; elige pago por uso si necesitas contabilizar por tokens. Si trabajas entre páginas web, descarga Tabbit y comprueba el selector de modelos de tu cuenta antes de planificar un flujo con Flash. Descargarlo no garantiza que M3.1 Flash esté disponible ni convierte estas estimaciones de API en un presupuesto de Tabbit.
 Tabbit Browser

Preguntas frecuentes
¿Cuánto cuesta MiniMax M3.1 Flash?
Según la consulta del 21 de octubre de 2026, MiniMax cobra 0,15 USD por millón de tokens de entrada sin caché, 0,015 USD por millón de entrada en caché y 0,60 USD por millón de tokens de salida. Son tarifas de pago por uso de la API en USD; las suscripciones y otros proveedores tienen condiciones distintas.
¿Un descuento del 90 % en caché reduce un 90 % toda la factura?
No. El descuento solo se aplica a los tokens de entrada servidos desde la caché. La entrada nueva, la salida, las herramientas y los reintentos también suman al coste.
¿M3.1 Flash es gratis en OpenRouter?
El aviso de lanzamiento de OpenRouter dice que el periodo gratuito termina el 22 de octubre de 2026 a las 12:00 UTC. Indica que la variante :free se retirará y que las integraciones deben usar minimax/minimax-m3.1-flash con las tarifas publicadas por MiniMax.
¿Puedo desactivar el modo thinking para reducir el coste?
La documentación actual de MiniMax indica que no se puede desactivar thinking en M3.1 Flash. Los niveles admitidos son low, medium, high, xhigh y max, y max es el valor predeterminado; un nivel menor puede reducir la salida y la latencia.
¿M Plan carga automáticamente mi saldo de API cuando se agota la cuota?
MiniMax indica que una Subscription Key consume el uso de M Plan y después los paquetes de crédito disponibles, sin cargar el saldo de pago por uso. Una API Key de pago por uso sí utiliza ese saldo, así que comprueba qué clave usa tu cliente.
¿Puedo usar M3.1 Flash en Tabbit Browser?
La disponibilidad depende de la cuenta, la región y el selector de modelos activo. En la comprobación del entorno de prueba de Tabbit del 21 de octubre no apareció M3.1 Flash, así que este artículo no afirma que se haya ejecutado una prueba con ese modelo.