
O MiniMax M3.1 Flash custa US$ 0,15 por milhão de tokens de entrada novos, US$ 0,015 por milhão de entrada em cache e US$ 0,60 por milhão de saída, segundo a tabela oficial de preços, consultada em 21 de outubro de 2026. Essas tarifas cobrem o uso da API. Assinaturas do M Plan, a oferta gratuita de lançamento de um provedor e o acesso pelo Tabbit Browser são decisões de compra distintas.
O valor para usar no orçamento é US$ 0,015 pela entrada em cache. Isso representa 90% menos que a tarifa de entrada nova do Flash e 75% menos que a tarifa padrão de leitura do cache do M3. A diferença pode mudar a conta de um agente que relê o mesmo contexto várias vezes. Isso não significa que cada tarefa concluída custe 90% menos. Uma discussão entre desenvolvedores mostra um ponto prático: leituras de cache mais baratas podem vir acompanhadas de mais tokens de saída. Mais adiante, explicamos como verificar o acesso no Tabbit antes de considerá-lo uma opção de execução.
Tabela de preços em resumo
Todos os valores abaixo estão em dólares por milhão de tokens e vêm da mesma página de preços do MiniMax. A comparação com M3 usa o nível Standard, não Priority nem uma rota de revendedor com desconto.
| Item de cobrança | M3.1 Flash | M3 Standard, entrada até 512K | Diferença em relação a essa linha do M3 |
|---|---|---|---|
| Entrada nova | $0.15 | $0.30 | 50% menor |
| Entrada em cache | $0.015 | $0.06 | 75% menor |
| Saída | $0.60 | $1.20 | 50% menor |
| Entrada acima de 512K | As mesmas tarifas fixas do Flash | $0.60 entrada / $0.12 cache / $2.40 saída | Flash é 75% / 87,5% / 75% mais barato |
As tarifas de entrada e saída do Flash são metade das tarifas do M3 para entradas curtas. A tarifa de entrada em cache cai ainda mais. No M3, ultrapassar 512K tokens de entrada muda a linha de preços aplicável; não significa que apenas o excedente seja cobrado por uma tarifa maior. Confira o total exato de tokens de entrada de cada solicitação. O total acumulado da sessão não define esse limite.
Contagem de tokens não é contagem de caracteres. O MiniMax estima cerca de 750 palavras em inglês por 1.000 tokens, mas o consumo real varia conforme o caso. Não encontramos uma porcentagem verificada de mudança no tokenizador do Flash. Por isso, os exemplos identificam tokens medidos ou presumidos em vez de inventar uma conversão de texto em tokens.
O que considerar
Entradas do Flash atendidas pelo cache custam um décimo das entradas novas. Uma taxa alta de acerto importa mais quando a saída permanece sob controle.
A redução de 70% no custo por tarefa é uma alegação do fornecedor sobre uma carga de trabalho, diferente da redução de 50% nas tarifas de entrada e saída.
A API direta usa
maxcomo padrão. O modo thinking continua ativo nos níveis mais baixos.A busca na web do lado do servidor custa US$ 0,01 por solicitação, além dos tokens do modelo.
O período gratuito de lançamento do OpenRouter tem um horário final definido. Faça orçamentos de produção com as tarifas pagas.
O número que muda o orçamento de agentes: US$ 0,015
A documentação de cache do MiniMax descreve o cache automático de prefixos para solicitações com pelo menos 512 tokens de entrada. A ordem de correspondência é ferramentas, prompts de sistema e, depois, mensagens do usuário. Coloque instruções estáveis e referências reutilizáveis no início; deixe os detalhes variáveis da tarefa para o fim. Uma janela de contexto grande, sozinha, não gera acertos de cache.
Suponha que um agente leia um prefixo de 100.000 tokens em 40 chamadas. Se a primeira usar apenas entrada nova e as 39 seguintes forem totalmente atendidas pelo cache, essa entrada custará $0.015 + 39 × $0.0015 = $0.0735. Sem acertos, os mesmos quatro milhões de tokens de entrada custariam $0.60. Esse é um cenário ilustrativo com muitos acertos, não uma garantia observada de cache. Históricos maiores e prefixos alterados aumentam o custo.
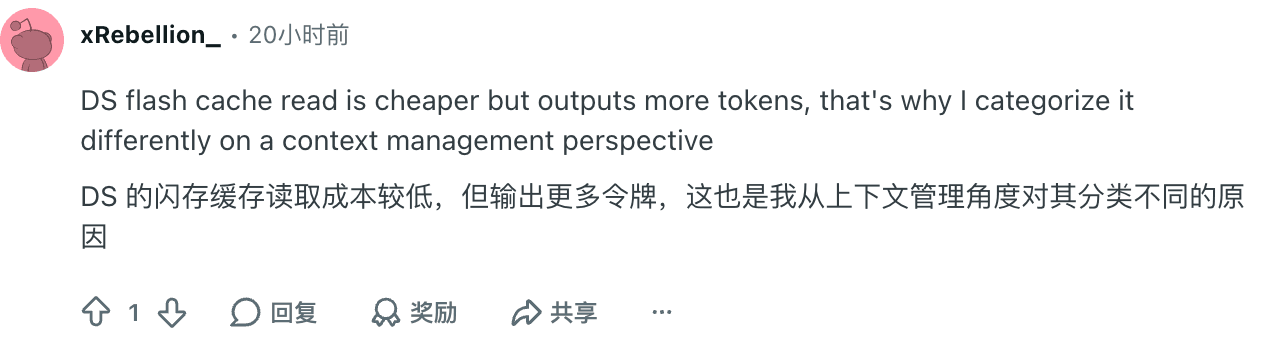
Leia o comentário original. O ponto é útil para a decisão de compra: compare o total de tokens gerados na mesma tarefa antes de escolher um modelo pelo preço do cache.
Um detalhe de contabilização evita cobrar duas vezes pela mesma coisa na sua planilha. Na resposta compatível com Anthropic, usage.input_tokens representa a entrada nova; some usage.cache_read_input_tokens pela tarifa de cache. Na resposta compatível com OpenAI, usage.prompt_tokens já inclui a entrada em cache; subtraia usage.prompt_tokens_details.cached_tokens antes de aplicar a tarifa de entrada nova. O guia oficial de cache documenta as duas convenções.
O que a alegação de economia de 70% realmente significa
A publicação de lançamento de 19 de outubro diz que o uso em tarefas agênticas custa 70% menos que o modelo anterior. Essa é a alegação agregada do fornecedor sobre custo por tarefa. A tabela de preços estabelece, separadamente, tarifas 50% menores para entradas novas e saídas em comparação com o M3 de entrada curta, e 75% menores para leituras de cache. São medidas diferentes.
Para reproduzir uma economia de 70% no seu trabalho, mantenha constantes a tarefa, os critérios de sucesso, o ambiente de execução e a política de novas tentativas. Registre entrada nova, entrada em cache, saída cobrada, chamadas a ferramentas e quantidade de resultados aceitos. Uma tarefa que fica mais barata por tentativa ainda pode custar mais por resultado aceito se exigir mais tentativas. Este artigo não fez uma comparação de produção por sete dias e não apresenta o percentual do fornecedor como uma economia medida no Tabbit.
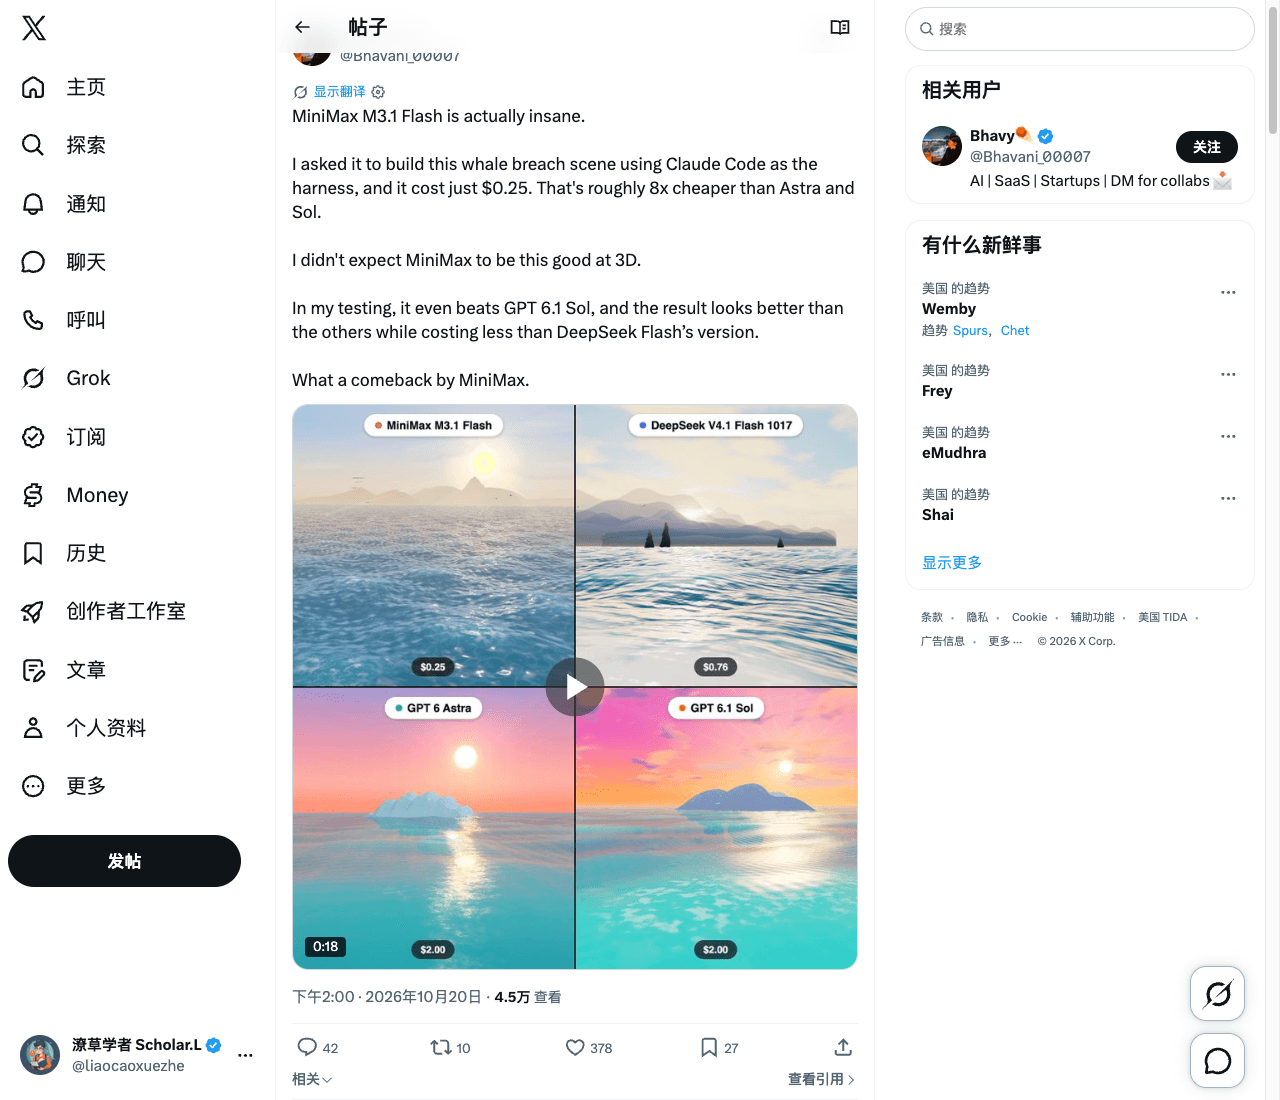
Bhavy publicou um exemplo positivo no X, relatando que gastou US$ 0,25 em uma animação de baleia criada com Claude Code. É um relato concreto de uma tarefa, mas a publicação não traz a fatura completa de tokens, um nível de esforço fixo nem tentativas repetidas. É evidência de um resultado relatado por um usuário, não uma previsão para a sua aplicação.
Itens cobrados fora da tabela de tokens
A página oficial de preços lista web_search no servidor a US$ 0,01 por solicitação. Dez mil buscas, portanto, acrescentam US$ 100 antes das cobranças de tokens. A linha MCP API-vlm também custa US$ 0,01 por solicitação. Ferramentas externas de cada cliente podem usar serviços e tarifas diferentes, então não atribua esses valores a toda chamada de função local.
A tarifa de lançamento do Flash é descrita como fixa. Não verificamos desconto por processamento em lote do Flash, sobretaxa regional, multiplicador Priority ou prazo de validade promocional na tabela da API direta. Faça o orçamento com as tarifas publicadas; a ausência de uma linha não prova que todos os provedores ofereçam os mesmos termos. A calculadora exclui impostos, conversão de moeda, execução externa e custos de novas tentativas.
A página da Venice lista US$ 0,19 para entrada, US$ 0,02 para entrada em cache e US$ 0,75 para saída. O aviso do modelo no OpenRouter, por sua vez, descreve um período gratuito temporário que termina em 22 de outubro de 2026 às 12:00 UTC, ou às 20:00 em Singapura. O aviso diz que a variante :free será encerrada depois desse horário e orienta as integrações a mudar para minimax/minimax-m3.1-flash. Trate isso como um aviso datado do provedor, não como uma faixa gratuita permanente.
A escala da família e o controle de esforço
| Modelo ou linha de cobrança | Entrada nova / entrada em cache / saída por 1 milhão | Quando escolher | Principal condição de orçamento |
|---|---|---|---|
| M3.1 Flash | $0.15 / $0.015 / $0.60 | Testar programação cotidiana e ciclos repetidos de ferramentas | Controle a saída gerada e confirme os acertos de cache |
| M3 Standard, entrada até 512K | $0.30 / $0.06 / $1.20 | Manter um fluxo M3 já testado durante a comparação | Compare resultados aceitos antes de migrar |
| M3 Standard, entrada acima de 512K | $0.60 / $0.12 / $2.40 | Uma solicitação específica do M3 exige a linha de entrada longa | Vale para a linha de cobrança daquela solicitação |
Esta é uma comparação de dois modelos disponíveis e três configurações de cobrança. A publicação de lançamento diz que o Pro chegará mais tarde; ele não é um terceiro modelo com preço que possamos inventar para a calculadora. Nosso resumo do M3 explica o contexto de acesso ao modelo anterior. Os valores históricos da assinatura não devem substituir a tabela atual. Para comparar métodos, consulte o guia de preços do DeepSeek e o guia de preços do Gemini Flash; confira os preços oficiais antes de comprar.
A limitação inesperada é que otimizar o cache pode fazer da saída o principal item da conta. Com 90% de entrada em cache, a tarifa efetiva de entrada do Flash é $0.0285 por milhão, enquanto a saída permanece em $0.60 por milhão. Nessa combinação, um token de saída custa cerca de 21 vezes mais que um token de entrada.
O guia de chamadas do MiniMax oferece os níveis de esforço low, medium, high, xhigh e max, com max como padrão. Ele informa que um esforço maior gera mais tokens de saída e latência, e que não é possível desativar thinking. Teste níveis mais baixos em etapas rotineiras e mantenha os níveis mais altos quando a qualidade exigir. Conte uma só vez a saída cobrada, incluindo raciocínio; não some thinking de novo se o total de uso já o incluir.
O que é gratuito e quais isenções não foram verificadas
O cache automático está documentado sem necessidade de configuração adicional, e a tabela publicada do Flash lista entrada nova, leitura de cache e saída. Não encontramos uma tarifa separada para armazenamento ou gravação de cache do Flash. Esse é o escopo da tabela publicada, não uma promessa contratual sobre serviços não listados.
Não verificamos um reembolso universal para tarefas de texto recusadas, interrompidas ou malsucedidas. A regra de não dedução da página de preços para trabalhos de vídeo malsucedidos vale para vídeo e não pode ser aplicada a este modelo de texto. Uma resposta que precise de correção pode já ter consumido tokens cobrados. Não classifique raciocínio, entrada em cache ou novas tentativas do agente como gratuitos.
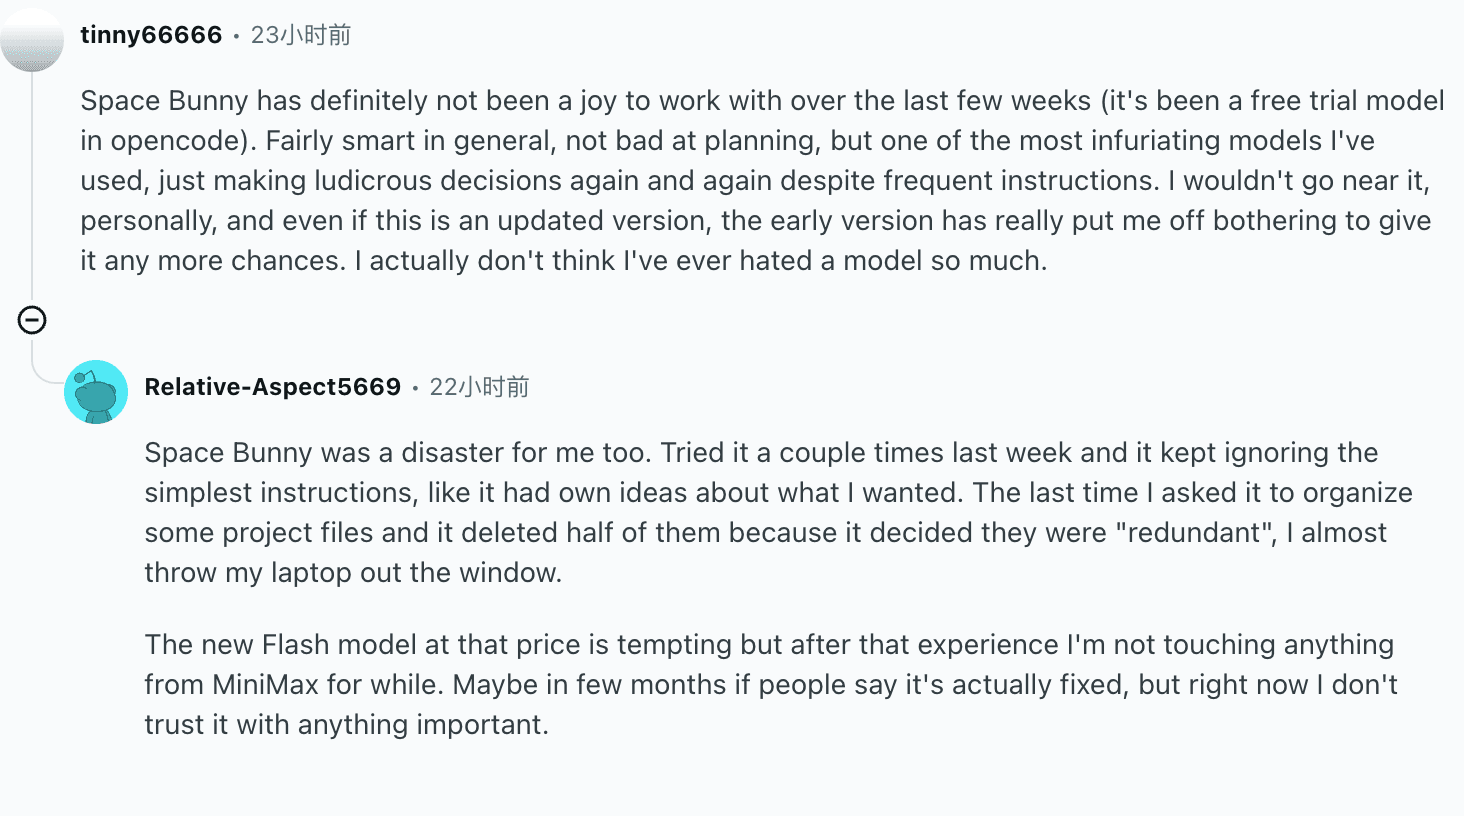
O usuário do Reddit tinny66666 descreve decisões ruins repetidas no Space Bunny pelo OpenCode em seu comentário. O comentário é sobre a versão anônima anterior, não um teste controlado do Flash lançado. Ainda assim, mostra por que o orçamento precisa prever novas tentativas e uma verificação de aceitação.
O M Plan é uma compra diferente
A página atual do M Plan inclui o M3.1 Flash nos planos Go, Explore e Build; o Explore mostra 3 vezes o uso do Go e o Build, 7,5 vezes. Na consulta, a visualização anual mostrava US$ 220, US$ 550 e US$ 1.320 por ano. São totais anuais, não preços mensais. Confira a opção de cobrança ativa e o checkout antes de comprar; não divida o uso anunciado do plano para inferir um preço de token da API.
A tabela de comparação também mostra uso limitado do Flash na faixa gratuita do cliente, que não inclui uma chave de API para ferramentas de programação. O MiniMax Code está incluído no M Plan. A seção de perguntas frequentes diz que uma Subscription Key usa a franquia do plano e depois os pacotes de créditos disponíveis, enquanto uma API Key por uso debita o saldo da conta. Essa diferença define o que acontece quando uma janela de uso se esgota.
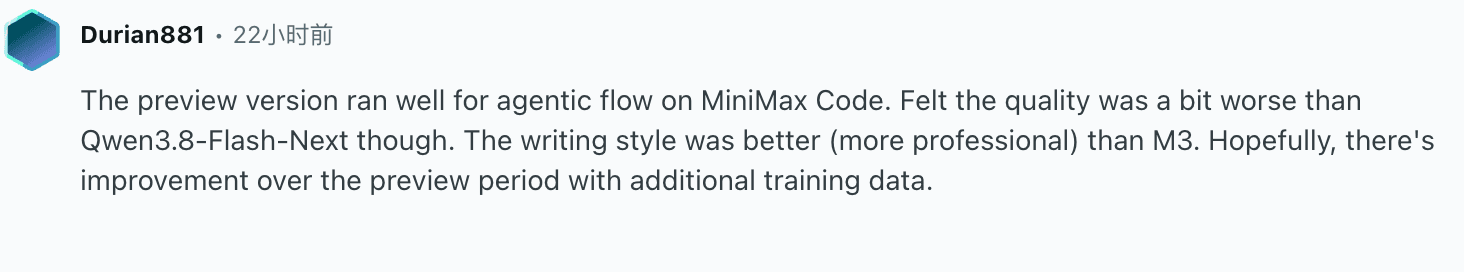
No comentário de Durian881, a pessoa relata que a prévia funcionou bem para fluxos agênticos no MiniMax Code, mas prefere a qualidade de outro modelo. Mantenha a versão e o cliente associados a essa opinião. Ela não prova que todo fluxo do M Plan caberá na franquia.
Dois orçamentos que você pode reproduzir
São exemplos aritméticos com as tarifas de 21 de outubro, não cargas de trabalho executadas. A entrada é o total de entrada em todas as chamadas de uma tarefa, e a saída é toda a saída cobrada nessas chamadas. Uma tarefa real do M3 com várias chamadas precisa escolher a linha de preço solicitação por solicitação.
custo = (entrada nova × 0.15 + entrada em cache × 0.015 + saída × 0.60) / 1,000,000
custo mensal de tokens = custo por tarefa × tarefas por mês
custo por resultado aceito = cobranças de tokens e ferramentas / resultados aceitos| Carga de trabalho presumida | Entrada total/tarefa | Parcela em cache | Saída/tarefa | Tarefas/mês | Tokens do Flash/mês |
|---|---|---|---|---|---|
| Extração de páginas | 20,000 | 20% | 1,000 | 10,000 | $30.60 |
| Agente com contexto repetido | 200,000 | 90% | 10,000 | 1,000 | $11.70 |
Para extração, (16,000 × 0.15 + 4,000 × 0.015 + 1,000 × 0.60) / 1,000,000 = $0.00306 por página. Dez mil páginas custam US$ 30,60 em tokens. Sem acertos, o total seria US$ 36,00; essa carga economiza 15%, não 90%. Uma busca na web do servidor por página acrescenta US$ 100.
Para o agente, (20,000 × 0.15 + 180,000 × 0.015 + 10,000 × 0.60) / 1,000,000 = $0.0117 por tarefa. Mil tarefas custam US$ 11,70, contra US$ 36,00 sem acertos de cache. Mantendo todos os volumes de tokens, o M3 para entradas curtas custaria US$ 28,80. Se a saída do Flash dobrar para 20.000 tokens, a conta mensal sobe para US$ 17,70. Por isso, esforço e novas tentativas fazem parte do orçamento.
Calculadora local de custo mensal
Insira os mesmos volumes para comparar o Flash com as duas linhas do M3 Standard. A linha longa do M3 é um cenário de sensibilidade, não uma afirmação de que a contagem acumulada de uma sessão ultrapassa o limite por solicitação. A calculadora usa a entrada total e a parcela em cache, portanto nunca conta a entrada em cache duas vezes. Ela não envia valores ou estimativas inseridos para a análise de dados.
Estime o custo mensal de tokens
Tarifas em USD verificadas em 21 de outubro de 2026. As duas linhas M3 são cenários comparativos; escolha a linha aplicável a cada solicitação. Exclui ferramentas, novas tentativas, impostos e taxas do provedor. Os valores ficam no navegador; a análise registra apenas que um campo mudou.
Verificar tarifas oficiaisVerifique um fluxo de trabalho no navegador com o Tabbit
Depois de definir o orçamento da API, o próximo passo é decidir onde a tarefa será executada. Nos agentes baseados em navegador, o cliente fornece o contexto da página, as permissões de ferramentas e o fluxo de trabalho em torno do modelo. Leia a apresentação do Tabbit e o guia prático de uso para entender essa camada, ou a comparação de navegadores para escolher um cliente.
Verificamos o seletor de modelos do ambiente de teste do Tabbit em 21 de outubro. Ele listava MiniMax-M3 e Friday-MiniMax-M3, mas não M3.1 Flash. Por isso, não enviamos uma tarefa por um modelo substituto e a rotulamos como teste do Flash. Este artigo não tem transcrição, registro de ferramentas nem custo medido do Flash no Tabbit. A página pública de recursos do M3.1 Flash (English) é um índice de pesquisa; os guias de prompts (English) e as fontes de avaliação (English) ajudam a preparar um teste, mas não provam o acesso à conta.
Quando o modelo exato aparecer na sua conta, faça uma verificação reversível: abra a tabela oficial de preços, peça as três tarifas de tokens com suas unidades e o URL da fonte e compare a resposta com a página. Registre o nome do modelo, a versão do cliente, os indicadores de ferramentas, o prompt e o resultado. Uma resposta correta verifica apenas aquela amostra. As franquias do Tabbit continuam separadas dos preços diretos da API acima.
Conclusão: calcule o custo por tarefa aceita antes de comprar um plano
Comece um piloto com as tarifas pagas do M3.1 Flash quando o fluxo depender de contexto repetido e você puder controlar a saída. Meça os acertos de cache e os resultados aceitos, reduza o esforço quando a qualidade permitir e defina um limite para novas tentativas. Mantenha uma rota M3 funcionando até que a comparação mostre uma melhora real nas suas tarefas.
Escolha o M Plan se o cliente incluído e as condições de uso atenderem ao seu trabalho; escolha o pagamento por uso se precisar contabilizar tokens. Se o seu trabalho acontece em páginas da web, baixe o Tabbit e confira o seletor de modelos da conta antes de planejar um fluxo com o Flash. O download não garante que o M3.1 Flash esteja disponível nem transforma essas estimativas de API em uma cotação do Tabbit.
 Tabbit Browser

Perguntas frequentes
Quanto custa o MiniMax M3.1 Flash?
Na consulta de 21 de outubro de 2026, o MiniMax cobrava US$ 0,15 por milhão de tokens de entrada sem cache, US$ 0,015 por milhão de entrada em cache e US$ 0,60 por milhão de tokens de saída. Esses são preços da API por uso em dólares; assinaturas e outros provedores têm condições próprias.
Um desconto de 90% no cache reduz a conta inteira em 90%?
Não. O desconto vale apenas para os tokens de entrada atendidos pelo cache. Novas entradas, saídas, ferramentas e tentativas adicionais continuam gerando custos.
O M3.1 Flash é gratuito no OpenRouter?
O aviso de lançamento do OpenRouter diz que o período gratuito termina em 22 de outubro de 2026 às 12:00 UTC. A variante :free será encerrada depois disso, e as integrações devem usar minimax/minimax-m3.1-flash pelos preços publicados pelo MiniMax.
Posso desativar o modo thinking para reduzir os custos?
A documentação atual do MiniMax diz que não é possível desativar thinking no M3.1 Flash. Os níveis de esforço disponíveis são low, medium, high, xhigh e max, com max como padrão; reduzir o nível pode diminuir o volume de saída e a latência.
O M Plan debita automaticamente meu saldo de API quando a franquia acaba?
O MiniMax informa que uma Subscription Key consome o uso do M Plan e depois os pacotes de créditos disponíveis, sem debitar o saldo da conta por uso. Uma API Key por uso usa esse saldo; confira qual chave o seu cliente utiliza.
Posso usar o M3.1 Flash no Tabbit Browser?
A disponibilidade depende da conta, da região e do seletor de modelos ativo. Na verificação do ambiente de teste do Tabbit em 21 de outubro, o M3.1 Flash não apareceu; por isso, este artigo não afirma que uma execução com esse modelo foi concluída.