
MiniMax M3.1 Flash coûte 0,15 $ par million de tokens d’entrée nouveaux, 0,015 $ par million de tokens d’entrée en cache et 0,60 $ par million de tokens de sortie, selon la grille tarifaire officielle, consultée le 21 octobre 2026. Ces tarifs concernent l’API. L’abonnement M Plan, l’offre gratuite de lancement d’un fournisseur et l’accès à Tabbit Browser sont des décisions d’achat distinctes.
Le chiffre à retenir pour votre budget est 0,015 $ pour l’entrée en cache. C’est 90 % de moins que le tarif d’entrée nouvelle de Flash et 75 % de moins que le tarif standard de lecture du cache de M3. Cela peut changer le coût d’un agent qui relit souvent le même contexte. Cela ne signifie pas que chaque tâche terminée coûte 90 % moins cher. Une discussion entre développeurs souligne un point concret : des lectures du cache moins chères peuvent aller de pair avec davantage de tokens de sortie. Plus loin, nous expliquons comment vérifier l’accès dans Tabbit avant d’en faire une option d’exécution.
La grille tarifaire en bref
Toutes les valeurs ci-dessous sont en dollars par million de tokens et proviennent de la même page de tarifs MiniMax. La comparaison avec M3 porte sur son niveau Standard, et non sur Priority ou un accès revendeur à tarif réduit.
| Poste de facturation | M3.1 Flash | M3 Standard, entrée jusqu’à 512K | Écart par rapport à cette ligne M3 |
|---|---|---|---|
| Nouvelle entrée | $0.15 | $0.30 | 50 % de moins |
| Entrée en cache | $0.015 | $0.06 | 75 % de moins |
| Sortie | $0.60 | $1.20 | 50 % de moins |
| Entrée au-delà de 512K | Les mêmes tarifs fixes Flash | $0.60 entrée / $0.12 cache / $2.40 sortie | Flash est 75 % / 87,5 % / 75 % moins cher |
Les tarifs d’entrée et de sortie de Flash représentent la moitié de ceux de M3 pour les entrées courtes. Le tarif de l’entrée en cache baisse davantage. Pour M3, dépasser 512K tokens d’entrée change la ligne tarifaire applicable ; seul le dépassement n’est pas facturé au tarif supérieur. Vérifiez le nombre exact de tokens d’entrée de chaque requête. Le total cumulé d’une session ne détermine pas ce seuil.
Le nombre de tokens n’est pas un nombre de caractères. MiniMax estime qu’un millier de tokens correspond à environ 750 mots anglais, mais la consommation varie selon le cas d’usage. Nous n’avons trouvé aucun pourcentage vérifié de changement du tokenizer pour Flash. Les exemples utilisent donc des tokens mesurés ou supposés au lieu d’inventer une conversion du texte en tokens.
À retenir
Une entrée Flash lue dans le cache coûte un dixième d’une nouvelle entrée. Un taux élevé de cache compte surtout si le volume de sortie reste maîtrisé.
La baisse de 70 % du coût par tâche annoncée par le fournisseur concerne une charge de travail ; elle diffère de la baisse de 50 % des tarifs d’entrée et de sortie.
L’API directe utilise
maxpar défaut. Le mode thinking reste activé avec les niveaux d’effort inférieurs.La recherche web côté serveur coûte 0,01 $ par requête, en plus des tokens du modèle.
La période gratuite de lancement d’OpenRouter a une heure de fin précise. Établissez les budgets de production avec les tarifs payants.
Le chiffre qui change le budget d’un agent : 0,015 $
La documentation du cache MiniMax décrit la mise en cache automatique des préfixes pour les requêtes comptant au moins 512 tokens d’entrée. L’ordre de correspondance est le suivant : outils, prompts système, puis messages utilisateur. Placez les consignes stables et les références réutilisables au début, puis les détails variables de la tâche. Une grande fenêtre de contexte ne suffit pas à produire des cache hits.
Supposons qu’un agent lise un préfixe de 100 000 tokens au cours de 40 appels. Si le premier utilise uniquement de nouvelles entrées et que les 39 suivants sont entièrement servis depuis le cache, cette entrée coûte $0.015 + 39 × $0.0015 = $0.0735. Sans cache hit, les mêmes quatre millions de tokens d’entrée coûteraient $0.60. C’est un scénario illustratif avec un taux de cache élevé, pas une garantie de cache observée. Un historique qui s’allonge et des préfixes modifiés augmentent le coût.
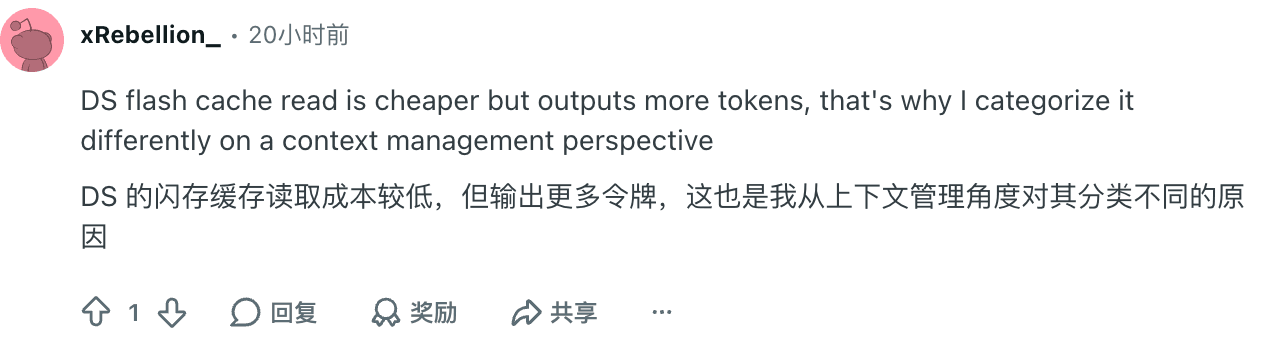
Lire le commentaire d’origine. Son conseil est utile au moment de choisir : comparez le nombre total de tokens générés pour la même tâche avant de choisir un modèle selon le prix du cache.
Un détail comptable évite les doubles facturations dans votre propre feuille de calcul. Dans une réponse compatible avec Anthropic, usage.input_tokens désigne les nouvelles entrées ; ajoutez usage.cache_read_input_tokens au tarif du cache. Dans une réponse compatible avec OpenAI, usage.prompt_tokens comprend déjà les entrées en cache ; soustrayez usage.prompt_tokens_details.cached_tokens avant d’appliquer le tarif des nouvelles entrées. Le guide officiel du cache décrit les deux conventions.
Ce que signifie réellement l’annonce d’économies de 70 %
L’annonce de lancement du 19 octobre indique que l’usage pour les tâches agentiques coûte 70 % de moins qu’avec le modèle précédent. C’est l’estimation globale du fournisseur pour le coût par tâche. La grille tarifaire établit séparément des tarifs 50 % plus bas pour les nouvelles entrées et les sorties que M3 avec des entrées courtes, et 75 % plus bas pour les lectures du cache. Ces pourcentages portent sur des mesures différentes.
Pour vérifier des économies de 70 % sur votre travail, gardez la tâche, les critères de réussite, l’environnement d’exécution et la politique de nouvelle tentative constants. Notez les nouvelles entrées, les entrées en cache, les sorties facturables, les requêtes d’outils et le nombre de résultats acceptés. Une tâche moins chère à chaque tentative peut coûter davantage par résultat accepté si elle exige plus de tentatives. Cet article ne présente pas une comparaison de production sur sept jours et ne traite pas le pourcentage du fournisseur comme une économie mesurée avec Tabbit.
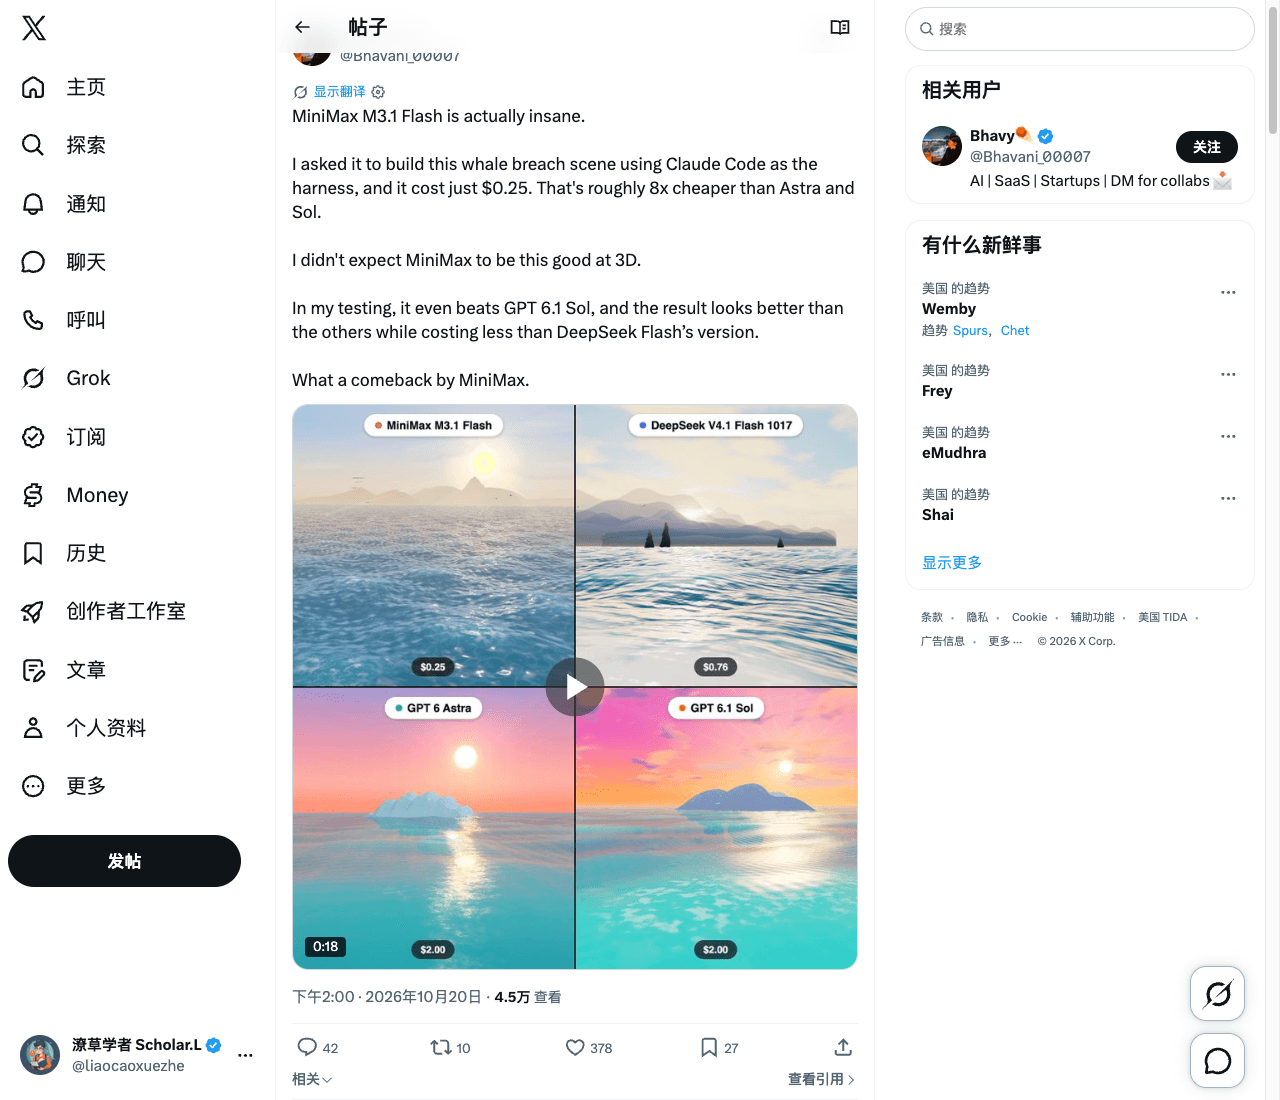
Bhavy donne un exemple positif sur X : il indique avoir dépensé 0,25 $ pour créer une animation de baleine avec Claude Code. C’est le compte rendu concret d’une tâche, mais le post ne fournit ni facture complète des tokens, ni niveau d’effort fixe, ni essais répétés. C’est un résultat déclaré par un utilisateur, pas une prévision pour votre application.
Les postes de facturation hors du tableau des tokens
La page officielle des tarifs affiche web_search côté serveur à 0,01 $ par requête. Dix mille recherches ajoutent donc 100 $ avant les frais de tokens. La ligne MCP API-vlm coûte également 0,01 $ par requête. Les outils externes d’un client peuvent utiliser d’autres services et tarifs ; n’appliquez donc pas ces frais à chaque appel de fonction local.
Le tarif de lancement de Flash est présenté comme fixe. Nous n’avons pas vérifié de réduction batch Flash, de supplément régional, de multiplicateur Priority ou de date d’expiration promotionnelle sur la grille directe de l’API. Établissez votre budget avec les tarifs affichés ; l’absence d’une ligne ne prouve pas que tous les fournisseurs appliquent les mêmes conditions. Le calculateur exclut les taxes, la conversion de devise, l’exécution externe et le coût des nouvelles tentatives.
La page de Venice affiche 0,19 $ pour l’entrée, 0,02 $ pour l’entrée en cache et 0,75 $ pour la sortie. L’avis de modèle d’OpenRouter décrit au contraire une période gratuite temporaire qui prend fin le 22 octobre 2026 à 12 h UTC, soit 20 h à Singapour. Il indique que la variante :free sera ensuite retirée et demande aux intégrations de passer à minimax/minimax-m3.1-flash. Considérez-le comme un avis fournisseur daté, pas comme une offre gratuite permanente.
Les modèles de la gamme et le réglage d’effort
| Modèle ou ligne de facturation | Nouvelle entrée / entrée en cache / sortie par million | À choisir si… | Condition principale du budget |
|---|---|---|---|
| M3.1 Flash | $0.15 / $0.015 / $0.60 | Vous testez le codage courant et des boucles d’outils répétées | Maîtrisez les sorties générées et confirmez les cache hits |
| M3 Standard, entrée jusqu’à 512K | $0.30 / $0.06 / $1.20 | Vous gardez un flux M3 testé pendant la comparaison | Comparez les résultats acceptés avant de migrer |
| M3 Standard, entrée au-delà de 512K | $0.60 / $0.12 / $2.40 | Une requête M3 précise nécessite la ligne des entrées longues | S’applique à la ligne de facturation de cette requête |
Cette comparaison porte sur deux modèles disponibles et trois configurations de facturation. L’annonce de lancement indique que Pro arrivera plus tard ; il ne s’agit pas d’un troisième modèle tarifé à inventer pour le calculateur. Notre présentation de M3 explique le contexte d’accès à l’ancien modèle. Ses anciens tarifs d’abonnement ne doivent pas remplacer la grille actuelle. Pour comparer les méthodes, consultez le guide de tarifs DeepSeek et le guide de tarifs Gemini Flash ; vérifiez leurs prix officiels avant tout achat.
La contrainte inattendue est que l’optimisation du cache peut rendre les sorties dominantes dans la facture. Avec 90 % d’entrées en cache, le tarif effectif de l’entrée Flash est de $0.0285 par million, tandis que la sortie reste à $0.60 par million. Dans ce mélange, un token de sortie coûte environ 21 fois plus qu’un token d’entrée.
Le guide d’appel de MiniMax propose les niveaux d’effort low, medium, high, xhigh et max, avec max par défaut. Il indique qu’un effort supérieur produit plus de tokens de sortie et de latence, et que thinking ne peut pas être désactivé. Testez un effort plus faible pour les étapes courantes et gardez les niveaux élevés là où la qualité l’exige. Comptez une seule fois les sorties facturées, raisonnement compris ; n’ajoutez pas une seconde fois thinking si le total d’usage l’inclut déjà.
Ce qui est gratuit et les exonérations que nous n’avons pas vérifiées
La mise en cache automatique est documentée sans configuration supplémentaire, et la grille publiée de Flash indique les nouvelles entrées, les lectures du cache et les sorties. Nous n’y avons trouvé aucun supplément séparé pour le stockage ou l’écriture du cache Flash. C’est le périmètre de la grille publiée, pas une promesse contractuelle sur les services non mentionnés.
Nous n’avons pas vérifié de remboursement universel pour les tâches texte refusées, interrompues ou échouées. La règle de non-déduction affichée sur la page des tarifs pour les travaux vidéo échoués concerne la vidéo et ne s’applique pas à ce modèle texte. Une réponse à corriger peut déjà avoir consommé des tokens facturables. Ne considérez jamais le raisonnement, les entrées en cache ou les nouvelles tentatives de l’agent comme gratuits.
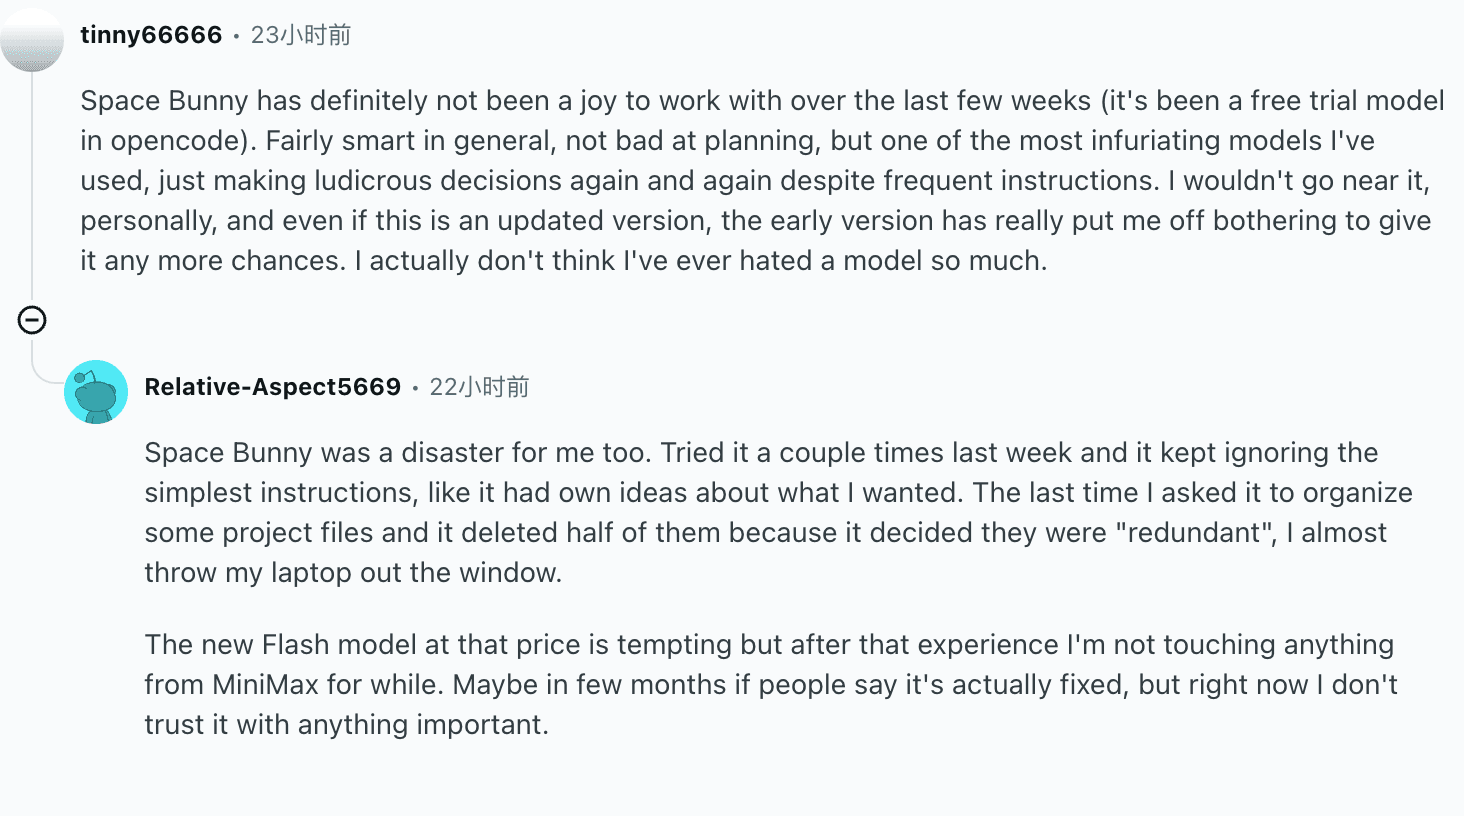
L’utilisateur Reddit tinny66666 décrit dans son commentaire des décisions médiocres répétées de Space Bunny via OpenCode. Il parle de l’ancienne version anonyme, pas d’un test contrôlé de la version Flash publiée. Cela montre tout de même pourquoi un budget doit prévoir des tentatives supplémentaires et un contrôle d’acceptation.
M Plan correspond à un achat différent
La page actuelle de M Plan inclut M3.1 Flash dans Go, Explore et Build ; Explore affiche trois fois l’usage de Go, et Build 7,5 fois. La vue annuelle affichait 220 $, 550 $ et 1 320 $ par an lors de notre consultation. Ce sont des montants annuels, pas mensuels. Vérifiez le sélecteur de facturation et le paiement avant l’achat ; ne divisez pas l’usage annoncé du plan pour en déduire un tarif API par token.
Le tableau comparatif indique également un usage limité de Flash dans le niveau client gratuit, qui ne comprend pas de clé API pour les outils de codage. MiniMax Code est inclus dans M Plan. La FAQ précise qu’une Subscription Key utilise le quota du plan, puis les packs de crédits disponibles, tandis qu’une API Key à l’usage débite le solde du compte. Cette différence détermine ce qui se passe quand une fenêtre d’usage est épuisée.
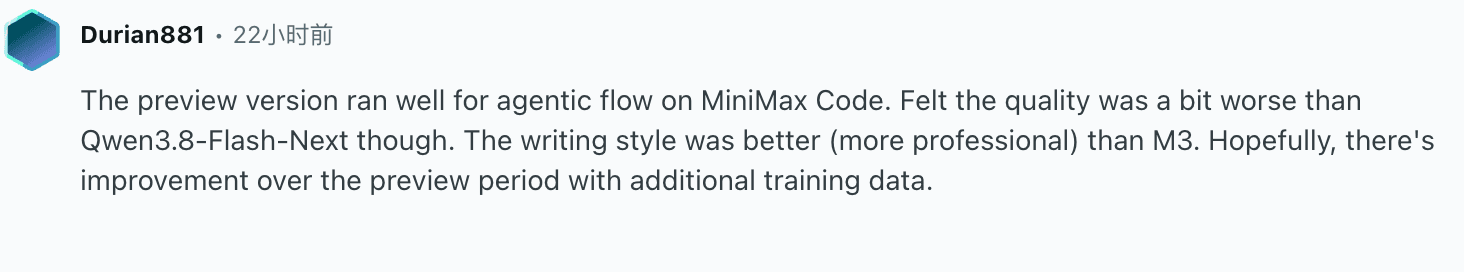
Dans son commentaire, Durian881 indique que la préversion fonctionnait bien pour les flux agentiques dans MiniMax Code, tout en préférant la qualité d’un autre modèle. Gardez la version et le client associés à cet avis. Il ne prouve pas que tous les flux M Plan respecteront le quota.
Deux budgets que vous pouvez reproduire
Il s’agit d’exemples arithmétiques utilisant les tarifs du 21 octobre, pas de charges de travail exécutées. L’entrée correspond au total de toutes les requêtes d’une tâche et la sortie à toutes les sorties facturables de ces requêtes. Une vraie tâche M3 en plusieurs appels doit choisir sa ligne tarifaire requête par requête.
coût = (nouvelle entrée × 0.15 + entrée en cache × 0.015 + sortie × 0.60) / 1,000,000
coût mensuel des tokens = coût par tâche × tâches par mois
coût par résultat accepté = frais de tokens et d’outils / résultats acceptés| Charge de travail supposée | Entrée totale/tâche | Part en cache | Sortie/tâche | Tâches/mois | Tokens Flash/mois |
|---|---|---|---|---|---|
| Extraction de pages | 20,000 | 20 % | 1,000 | 10,000 | $30.60 |
| Agent avec contexte répété | 200,000 | 90 % | 10,000 | 1,000 | $11.70 |
Pour l’extraction, (16,000 × 0.15 + 4,000 × 0.015 + 1,000 × 0.60) / 1,000,000 = $0.00306 par page. Dix mille pages coûtent 30,60 $ en tokens. Sans cache hit, le total atteint 36,00 $ : cette charge économise donc 15 %, pas 90 %. Une recherche web côté serveur par page ajoute 100 $.
Pour l’agent, (20,000 × 0.15 + 180,000 × 0.015 + 10,000 × 0.60) / 1,000,000 = $0.0117 par tâche. Mille tâches coûtent 11,70 $, contre 36,00 $ sans cache hit. À volumes de tokens constants, M3 pour les entrées courtes coûterait 28,80 $. Si la sortie Flash double et atteint 20 000 tokens, la facture mensuelle monte à 17,70 $. C’est pourquoi l’effort et les nouvelles tentatives doivent figurer dans le budget.
Calculateur local de coût mensuel
Saisissez les mêmes volumes pour comparer Flash aux deux lignes M3 Standard. La ligne M3 des entrées longues est un scénario de sensibilité, pas l’affirmation que le total cumulé d’une session dépasse le seuil par requête. Le calculateur utilise le volume total d’entrées et la part en cache, sans compter deux fois les entrées en cache. Il n’envoie aucune valeur ni estimation saisie aux outils d’analyse.
Estimer le coût mensuel des tokens
Tarifs en USD vérifiés le 21 octobre 2026. Les deux lignes M3 sont des scénarios comparatifs ; choisissez la ligne applicable à chaque requête. Hors outils, nouvelles tentatives, taxes et frais du fournisseur. Les valeurs restent dans le navigateur ; les statistiques enregistrent uniquement la modification d’un champ.
Vérifier les tarifs officielsVérifier un flux de navigation avec Tabbit
Après avoir établi un budget API, il faut décider où la tâche s’exécutera. Pour les agents dans le navigateur, le client fournit le contexte de page, les autorisations des outils et le flux de travail autour du modèle. Consultez la présentation de Tabbit et le guide pratique d’utilisation pour cette couche, ou la comparaison de navigateurs pour choisir un client.
Nous avons vérifié le sélecteur de modèles de l’environnement de test Tabbit le 21 octobre. Il affichait MiniMax-M3 et Friday-MiniMax-M3, mais pas M3.1 Flash. Nous n’avons donc pas envoyé une tâche avec un modèle de remplacement en la présentant comme un test Flash. Cet article ne contient aucune transcription, trace d’outil ou mesure de coût Flash dans Tabbit. La page publique de ressources M3.1 Flash (English) est un index de recherche ; ses guides de prompts (English) et ses sources d’évaluation (English) aident à préparer un test, mais ne prouvent pas l’accès au compte.
Quand le modèle exact apparaît dans votre compte, procédez à une vérification réversible : ouvrez la grille officielle, demandez les trois tarifs par token avec leurs unités et l’URL de la source, puis comparez la réponse à la page. Notez le libellé du modèle, la version du client, les indicateurs d’outils, le prompt et le résultat. Une réponse correcte ne vérifie que cet échantillon. Les quotas Tabbit restent distincts des tarifs directs de l’API ci-dessus.
Conclusion : calculez le coût d’une tâche acceptée avant de souscrire
Lancez un pilote aux tarifs payants de M3.1 Flash si votre flux repose sur un contexte répété et une sortie maîtrisable. Mesurez les cache hits et les résultats acceptés, réduisez l’effort quand la qualité le permet et fixez un budget de tentatives. Gardez une voie M3 fonctionnelle tant que la comparaison ne montre pas une amélioration réelle sur vos tâches.
Choisissez M Plan si le client inclus et ses conditions d’usage conviennent à votre travail ; choisissez le paiement à l’usage si vous avez besoin d’une comptabilité par tokens. Si votre travail se déroule sur des pages web, téléchargez Tabbit et vérifiez le sélecteur de modèles du compte avant de planifier un flux Flash. Le téléchargement ne garantit pas la disponibilité de M3.1 Flash et ne transforme pas ces estimations API en devis Tabbit.
 Tabbit Browser

Questions fréquentes
Combien coûte MiniMax M3.1 Flash ?
Selon les tarifs MiniMax consultés le 21 octobre 2026, le million de tokens d’entrée non mis en cache coûte 0,15 $, le million de tokens d’entrée en cache 0,015 $ et le million de tokens de sortie 0,60 $. Il s’agit des tarifs API à l’usage en dollars américains ; les abonnements et les autres fournisseurs appliquent des conditions différentes.
Une remise de 90 % sur le cache réduit-elle toute la facture de 90 % ?
Non. La remise concerne uniquement les tokens d’entrée servis depuis le cache. Les nouvelles entrées, les sorties, les outils et les tentatives supplémentaires restent facturés.
M3.1 Flash est-il gratuit sur OpenRouter ?
L’annonce de lancement d’OpenRouter indique que la période gratuite prend fin le 22 octobre 2026 à 12 h UTC. La variante :free sera alors retirée et les intégrations devront utiliser minimax/minimax-m3.1-flash aux tarifs publiés par MiniMax.
Puis-je désactiver le mode thinking pour réduire les coûts ?
La documentation actuelle de MiniMax indique que thinking ne peut pas être désactivé pour M3.1 Flash. Les niveaux d’effort disponibles sont low, medium, high, xhigh et max, max étant la valeur par défaut ; un niveau inférieur peut réduire le volume de sortie et la latence.
M Plan débite-t-il automatiquement mon solde API quand mon quota est épuisé ?
MiniMax indique qu’une Subscription Key consomme l’usage M Plan puis les packs de crédits disponibles, sans débiter le solde du compte à l’usage. Une API Key à l’usage utilise ce solde ; vérifiez donc quelle clé votre client utilise.
Puis-je utiliser M3.1 Flash dans Tabbit Browser ?
La disponibilité dépend du compte, de la région et du sélecteur de modèles actif. Lors de notre vérification de l’environnement de test Tabbit le 21 octobre, M3.1 Flash n’apparaissait pas ; cet article ne prétend donc pas avoir exécuté de test avec ce modèle.