
MiniMax M3.1 Flash merece una prueba en análisis de datos y tareas con herramientas que tengan revisión humana. Sus tarifas bajas y sus resultados publicados lo convierten en candidato, pero no demuestran que termine antes tus cambios de código ni que necesite menos supervisión. Esta evaluación distingue datos del fabricante, pruebas independientes y experiencias de la comunidad. No presenta un benchmark de rendimiento realizado por el autor.
El contraste decisivo está en la prueba de Plotly: la versión final pasó de 38/43 respuestas correctas de Space Bunny Alpha a 41/43, pero el tiempo mediano por pregunta subió de 36 segundos a 3 minutos. Esa relación entre precisión y espera determina la recomendación. Tabbit Browser aparece como entorno para organizar el trabajo con páginas, después de comprobar el acceso al modelo exacto.
Qué es realmente MiniMax M3.1 Flash
MiniMax lanzó la versión general el 19 de octubre de 2026. Su identificador de API es MiniMax-M3.1-Flash. La documentación de modelos describe un modelo de programación multimodal con 1.000.000 de tokens de contexto. Hay que distinguir esta versión de Preview y de los modelos anónimos Space Bunny. La guía de MiniMax M3 trata la generación anterior.
Según la guía de invocación, el razonamiento es obligatorio. Admite low, medium, high, xhigh y max; si omites el parámetro, usa max. Desactivar el razonamiento o enviar none devuelve un error 400. Comprueba el campo que corresponde al protocolo de tu cliente: una interfaz conocida no garantiza una configuración equivalente en el servidor.
Puntos clave
Compara tiempo total y coste por tarea aceptada, además de tokens por segundo.
El 41/43 de Plotly justifica probar análisis supervisado, con una espera considerable.
Las tarifas bajas no eliminan el coste del razonamiento, los reintentos ni la validación.
Los comentarios sobre Preview y Space Bunny necesitan etiquetas de versión.
Antes de probarlo en Tabbit, confirma el nombre exacto en el selector de tu cuenta.
La cifra decisiva son 3 minutos, pese a la generación rápida
En su informe del 20 de octubre, Plotly registra 3 minutos de mediana por pregunta para la versión final y 36 segundos para Space Bunny Alpha. Son tres aciertos adicionales en 43 preguntas, con cinco veces más espera. Puede compensar en análisis en segundo plano; penaliza una conversación interactiva.
Las llamadas por pregunta aumentaron de 15 a 45 y la salida de unos 8.500 a 32.000 tokens. El examen completo, recalculado con las tarifas de MiniMax, pasó de $0.82 a $4.09. Son resultados del agente analítico de un evaluador, no una garantía de latencia ni una comparación con MiniMax M3.
Tiempo de tarea = generación + herramientas + espera + reintentos
Coste de tarea = entradas + entradas en caché + salida facturable + herramientas
Coste por tarea aceptada = gasto total / resultados que superan la validación
Una ejecución barata que falla también consume recursos. La guía de navegadores agénticos explica por qué conviene evaluar por separado el modelo y la ejecución en el navegador.
M3.1 Flash de un vistazo
| Aspecto | Información verificada | Consecuencia |
|---|---|---|
| Modelo | MiniMax-M3.1-Flash, versión general | Anotar el identificador exacto |
| Contexto | 1.000.000 de tokens | Capacidad no equivale a recuperación precisa |
| Razonamiento | Obligatorio; cinco niveles; max por defecto | Configurar effort explícitamente |
| API por millón de tokens | $0.15 entrada; $0.60 salida; $0.015 entrada en caché | Contar razonamiento y fallos de caché |
| Análisis de Plotly | 41/43; mediana de 3 minutos | Probar tareas en segundo plano |
| Pesos abiertos | El anuncio los sitúa para más adelante | Verificar archivos y licencia |
Datos de la guía de invocación y la tarifa oficial, consultados el 21 de octubre. El anuncio promete los pesos para después; una promesa no es un archivo descargable.
Evidencia práctica antes de la clasificación
Plotly usa un almacén sintético de datos eólicos y una clave privada de respuestas. El modelo encontró los cinco patrones ocultos, pero falló dos preguntas. En una, explicó que había dividido la suma de siete días entre siete, aunque su SQL omitía la división. Una explicación convincente puede acompañar un cálculo incorrecto.
El informe permite inspeccionar un resultado y un fallo concreto. Sigue siendo una prueba analítica de alcance corto: no demuestra cómo funcionará en un repositorio grande, un proceso autónomo ni tu base de datos. Ejecuta de nuevo la consulta y comprueba el resultado.
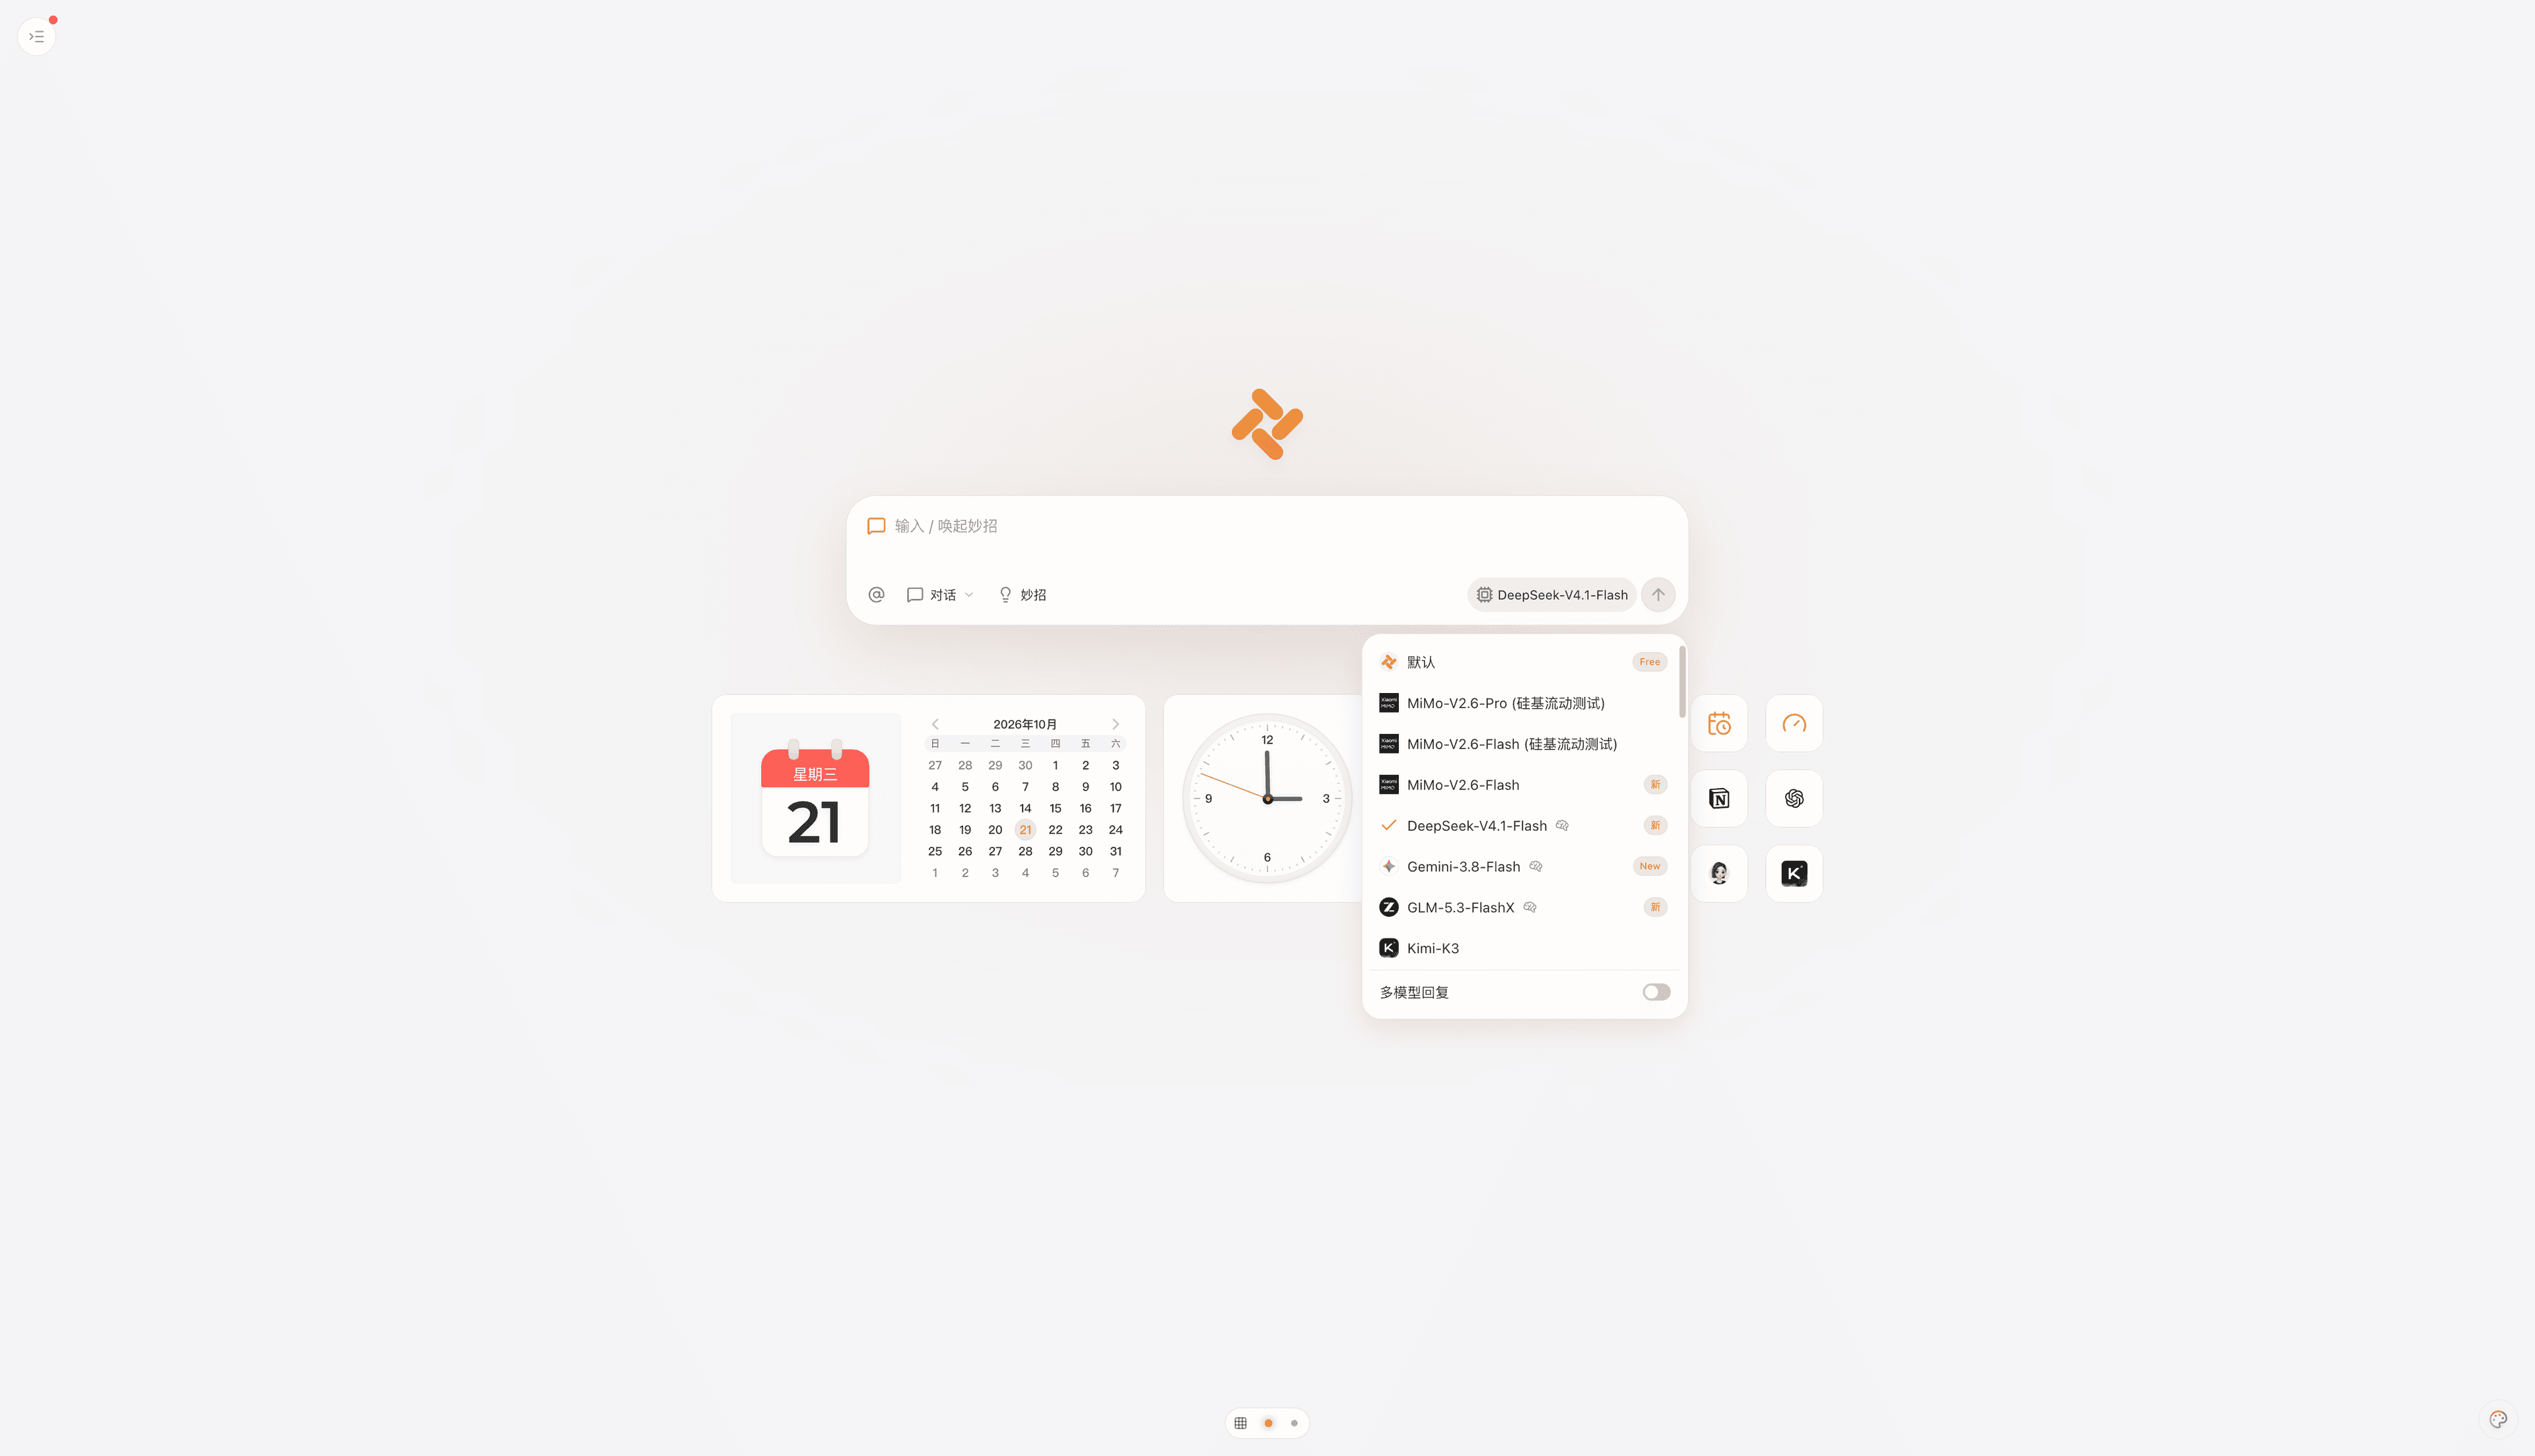
La comprobación local de Tabbit fue más limitada. El 21 de octubre, el selector de conversación de la cuenta de pruebas mostraba MiniMax-M3 y Friday-MiniMax-M3, pero no M3.1 Flash. No se envió ninguna tarea al modelo. La captura registra acceso, no un benchmark fallido, y no establece disponibilidad en otras cuentas o regiones.
Benchmarks del fabricante y sus límites
| Benchmark | Resultado publicado por MiniMax | Qué ayuda a evaluar |
|---|---|---|
| DeepSWE v1.1 | 73.7% | Ingeniería de software con pruebas |
| OSWorld V2 | 61.7 | Operaciones entre aplicaciones |
| Agents' Last Exam | 29.6 | Trabajo profesional de valor económico |
| BankerToolBench | 76.2 | Herramientas financieras en varios pasos |
| CyberGym | 82% en el texto del anuncio | Descubrimiento y validación de vulnerabilidades |
Los resultados proceden del anuncio oficial; no se reprodujeron aquí. Su texto redondea CyberGym a 82%. Otra precisión de visualización no constituye evidencia independiente. La tabla no ofrece un paquete completo de reproducción, intervalos de incertidumbre ni comparaciones controladas de todos los clientes y niveles de esfuerzo. Sirve para decidir qué probar, no para justificar una sustitución general.
Plotly informa de 41/43 para M3.1 Flash, Claude Opus 5.5, Gemini 4 Argon y GPT-6 Sol, frente a 38/43 para GLM 5.3 Flash y Qwen 3.8 27B. Empatar en 43 preguntas no demuestra equivalencia general. Consulta la guía de DeepSeek V4.1 Flash y el contexto de GLM Flash, verifica sus endpoints actuales y compara con las mismas tareas.
Tres ventajas que merece la pena comprobar
Análisis en segundo plano con cálculos verificables
Los patrones que encontró en Plotly justifican probar la versión final en análisis que puedan ejecutarse mientras haces otro trabajo. La entrega útil incluye consulta y tabla de resultados. Un analista capaz de verificar los cálculos puede aceptar mayor espera a cambio de más cobertura; quien necesita respuestas inmediatas puede decidir lo contrario.
Tarifas bajas para contexto repetido
Un ejemplo de 200.000 tokens de entrada sin caché y 20.000 de salida facturable cuesta $0.042 en tokens, sin herramientas ni otros cargos. Es aritmética, no una medición. Con 100.000 tokens de salida, ese coste sube a $0.09. El razonamiento y los reintentos afectan a la factura aunque la respuesta visible sea breve.
La entrada en caché tiene otra tarifa. Comprueba los aciertos reales en los registros, sin aplicar el descuento a todo texto repetido. La reducción del 70% en coste global de tareas agénticas que anuncia MiniMax no es un descuento universal en cualquier carga o suscripción.
Esfuerzo ajustable en una integración existente
La documentación admite formatos compatibles con Anthropic y OpenAI. Esto facilita evaluar el modelo sin rehacer la aplicación. Verifica que el cliente envía output_config.effort o reasoning_effort y conserva los resultados de herramientas entre turnos. Compara un nivel menor con max usando los mismos criterios de aceptación. Mantener la calidad con menos esfuerzo es una hipótesis que hay que probar.
Tres límites que cambian la recomendación
No se puede desactivar el razonamiento
Incluso una extracción breve pasa por razonamiento adaptativo. Menos effort no significa un modo sin razonamiento. Registra resultado, consumo total, tiempo y llamadas a herramientas. La evaluación de Gemini 3.8 Flash ofrece otro marco basado en tareas; no es una clasificación directa frente a este modelo.
Una explicación correcta puede ocultar trabajo incorrecto
La división omitida en el SQL de Plotly es un problema concreto que puedes comprobar. Revisa directamente fórmulas y código. En extracción, compara una muestra fija con la fuente. En programación, exige una prueba que falle antes del arreglo y pase después. La revisión humana forma parte del coste por resultado aceptado.
Versiones y acceso diferentes confunden los primeros comentarios
Los suscriptores de Preview, los usuarios de endpoints anónimos gratuitos y los de la API general pueden haber usado versiones y herramientas distintas. Comprueba también los pesos y su licencia: estar en una API no basta para autohospedar. Una página sobre el modelo tampoco demuestra que tu cuenta de Tabbit lo ofrezca.
Voces de la comunidad con límites de versión
Una experiencia positiva de Preview y una defensa de los benchmarks
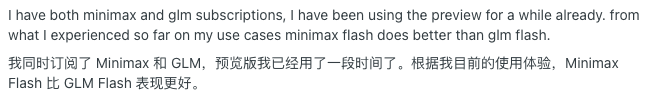
Sovairon, 19 de octubre, prefirió MiniMax Flash a GLM Flash en su suscripción. Después aclaró que usaba 3.1 Flash Preview. No publicó tareas ni método de puntuación: es una preferencia personal por Preview, no una victoria medida de la versión general.
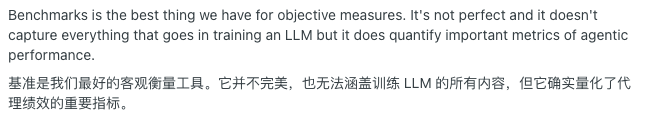
ApprehensiveDelay238, 19 de octubre, defendió los benchmarks como medidas imperfectas pero útiles del rendimiento agéntico. Es un argumento metodológico, no el registro de una tarea. Evita descartar todos los datos tras una mala sesión.
Bucles de razonamiento y una preferencia opuesta
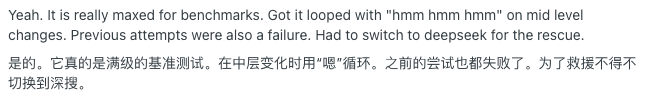
Pepek91, 20 de octubre, describió razonamiento repetitivo en cambios de complejidad media y un cambio a DeepSeek. No indicó endpoint, effort ni repositorio. Es un modo de fallo para incluir en tu prueba, no una tasa de fallos.
RepulsiveRaisin7, 19 de octubre, prefirió GLM Flash y cuestionó los benchmarks sin aportar registros. Su preferencia contradice la de Sovairon. No es válido sumar ambos comentarios como votos de una comparación controlada.
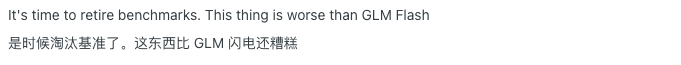
La conclusión práctica es buscar bucles en las pruebas, separar versiones y conservar los benchmarks como una fuente más. Ninguno de estos comentarios predice tu tasa de éxito.
El veredicto depende de la tarea
| Carga de trabajo | Recomendación | Comprobación |
|---|---|---|
| Análisis en segundo plano con revisión | Incluir M3.1 Flash entre candidatos | Ejecutar SQL y validar unidades y agregados |
| Extracción y respuestas interactivas | Comparar effort antes de migrar | Tiempo total y resultados correctos |
| Cambios difíciles de repositorio | Mantener el modelo actual como control | Mismos problemas, pruebas y permisos |
| Acciones externas sin supervisión | No aprobar solo por estas puntuaciones | Validar recuperación y límites de acción |
| Autohospedaje inmediato | Confirmar pesos y licencia | El acceso a la API no basta |
| Investigación con Tabbit | Comprobar el selector primero | M3 no equivale a M3.1 Flash |
En análisis revisado puede compensar esperar más por mayor precisión. Para interacciones rápidas, la mediana de tres minutos exige medir antes de migrar. La evidencia no justifica reemplazar todos los modelos de programación ni retirar la revisión humana.
Llevar el flujo a Tabbit después de comprobar el acceso
Tabbit organiza las páginas y conversaciones usadas para evaluar una tarea del navegador. La explicación del producto y las prácticas de uso describen ese flujo. No demuestran que Tabbit exponga los controles effort de la API ni que todos los planes incluyan el modelo.
La cuenta observada no ofrecía M3.1 Flash, por lo que aquí no hay un resultado ejecutado dentro de Tabbit. Consulta los recursos de M3.1 Flash (English) y confirma el nombre en tu selector. Si no aparece, prueba con un cliente admitido por MiniMax. No etiquetes un resultado de M3 como M3.1 Flash.
Una prueba útil consiste en abrir el anuncio y la guía de invocación, extraer tarifas y esfuerzo predeterminado en una tabla con fuentes, y separar hechos de incógnitas. Revisa cada celda contra la página original. Anota región, versión del cliente, modelo mostrado, indicadores de herramientas, entrada y captura. Es una prueba propuesta, no realizada para este artículo.
Empieza con una tarea controlada y tu modelo habitual como referencia. El botón descarga Tabbit para ese flujo; no garantiza acceso a M3.1 Flash ni uso gratuito de la API.
 Tabbit Browser

Preguntas frecuentes
¿Qué es MiniMax M3.1 Flash?
Es el modelo de programación y agentes de MiniMax lanzado el 19 de octubre de 2026. La API usa MiniMax-M3.1-Flash y la documentación indica 1.000.000 de tokens de contexto.
¿Se puede desactivar el razonamiento?
No. La guía admite cinco niveles de esfuerzo y utiliza max si se omite el parámetro. Desactivarlo o enviar none devuelve un error 400.
¿Cuánto cuesta la API?
A 21 de octubre, las tarifas por millón de tokens son $0.15 de entrada, $0.60 de salida y $0.015 de entrada en caché. El coste real depende del consumo, razonamiento, caché, herramientas y reintentos.
¿Es más rápido y preciso que Space Bunny?
La prueba analítica de Plotly pasó de 38/43 a 41/43 respuestas correctas. La mediana por pregunta subió de 36 segundos a 3 minutos, por lo que no demuestra tareas más rápidas.
¿Ya hay pesos para autohospedarlo?
El anuncio sitúa los pesos para más adelante. Verifica el archivo y la licencia antes de desplegarlo; aparecer en una API no demuestra que los pesos se puedan descargar.
¿Puedo seleccionar M3.1 Flash en Tabbit?
Depende de tu cuenta, región y selector actual. La cuenta de pruebas observada no lo incluía, por lo que no se afirma ningún resultado de rendimiento dentro de Tabbit.