
MiniMax M3.1 Flash 值得用於有人工覆核的資料分析和工具任務試用。API 單價低,公開測試也有可取之處,但這些證據還不足以證明它能更快完成你的程式碼任務,或減少覆核工作。本文區分官方資料、獨立測試和社群體驗,不把資料研究寫成作者親測。
真正影響選型的是這組取捨:Plotly 測得正式版答對 41/43 題,早期 Space Bunny Alpha 為 38/43 題;每題中位耗時卻從 36 秒升至 3 分鐘。下文圍繞準確率與等待時間展開。Tabbit Browser 在這裡用於組織瀏覽器工作流,開始模型測試前,必須先核對帳號能否選擇對應模型。
MiniMax M3.1 Flash 到底是什麼
MiniMax 於 2026 年 10 月 19 日發佈正式版,API 識別名稱為 MiniMax-M3.1-Flash。模型文件將其定義為支援多模態輸入、擁有 1,000,000 token 上下文的程式設計模型。比較體驗時,需分別標明正式版、9 月 Preview 和匿名 Space Bunny 版本。上一代可參閱 MiniMax M3 總覽。
呼叫指南明確要求始終開啓思考。五檔強度為 low、medium、high、xhigh、max,省略參數時預設 max。關閉思考或傳入 none 會返回 400 錯誤。不同協議的欄位不同,熟悉的用戶端介面並不意味著伺服器端收到的設定相同。
關鍵結論
同時比較完整任務耗時、合格結果成本和 token 吞吐。
Plotly 的 41/43 成績支援有監督的分析試用,但等待時間明顯增加。
低單價不會免除思考、重試和驗證產生的成本。
Preview 的好評和 Space Bunny 的差評都需要版本標籤。
在 Tabbit 執行模型任務前,先核對帳號選擇器中的準確名稱。
決定選型的是 3 分鐘,而不只是輸出速度
Plotly 在 10 月 20 日的資料分析報告中記錄,正式版每題中位耗時為 3 分鐘,Space Bunny Alpha 為 36 秒。43 道題中多答對三題,等待時間增加到五倍。背景分析可能接受這一取捨,需要即時響應的助手則必須計入這個代價。
報告將耗時增加歸因於更多模型呼叫和生成內容。每題呼叫從 15 次增至 45 次,輸出從約 8,500 token 增至 32,000 token。按 MiniMax 標價重新計算,整套測試成本從 0.82 美元增至 4.09 美元。這是該評測機構的分析 Agent 結果,不是所有任務的延遲保證,也不是與 MiniMax M3 的對比。
因此,單看每秒生成多少 token,無法回答是否值得換用。可以先按以下方式記賬:
任務耗時 = 模型生成 + 工具執行 + 等待 + 重試
任務成本 = 全部輸入 + 快取輸入 + 全部計費輸出 + 工具費用
合格任務成本 = 總支出 / 通過檢查的結果數分母不能省略。便宜但失敗的執行同樣消耗時間和費用。Agent 瀏覽器指南解釋了模型選擇與瀏覽器執行為何需要分別評估。
M3.1 Flash 速覽
| 項目 | 已核實資訊 | 對選型的影響 |
|---|---|---|
| 模型 | 正式版 MiniMax-M3.1-Flash | 記錄準確識別名稱 |
| 上下文 | 1,000,000 token | 容量不等於召回準確率 |
| 思考 | 始終開啓,五檔,預設 max | 顯式設定 effort |
| 每百萬 token API 費率 | 輸入 $0.15;輸出 $0.60;快取輸入 $0.015 | 統計思考和快取未命中 |
| Plotly 資料分析 | 答對 41/43;每題中位耗時 3 分鐘 | 適合試用背景分析 |
| 開放權重 | 發佈文稱後續提供 | 部署前核對檔案和授權條款 |
規格來自呼叫文件和官方價格表,核對日期為 10 月 21 日。發佈文章稱權重將在後續發佈,未來發佈計劃不等於當前已有可下載文件。
先看實際任務證據,再看排行榜
Plotly 使用合成風電資料倉庫和私有答案進行測試。正式版發現了全部五個隱藏模式,但總共仍錯了兩題。其中一題很有代表性:文字解釋稱已將七天總和除以七,SQL 卻遺漏了除法。說明寫得可信,不代表計算正確。
這條證據同時給出了產物與具體錯誤,因此比籠統評價更有用。不過,它只是一套短程分析題,不能證明模型在大型程式碼庫、無人值守業務流程或你的資料庫中的表現。應重新執行查詢、檢查結果,而不是只相信模型對過程的描述。
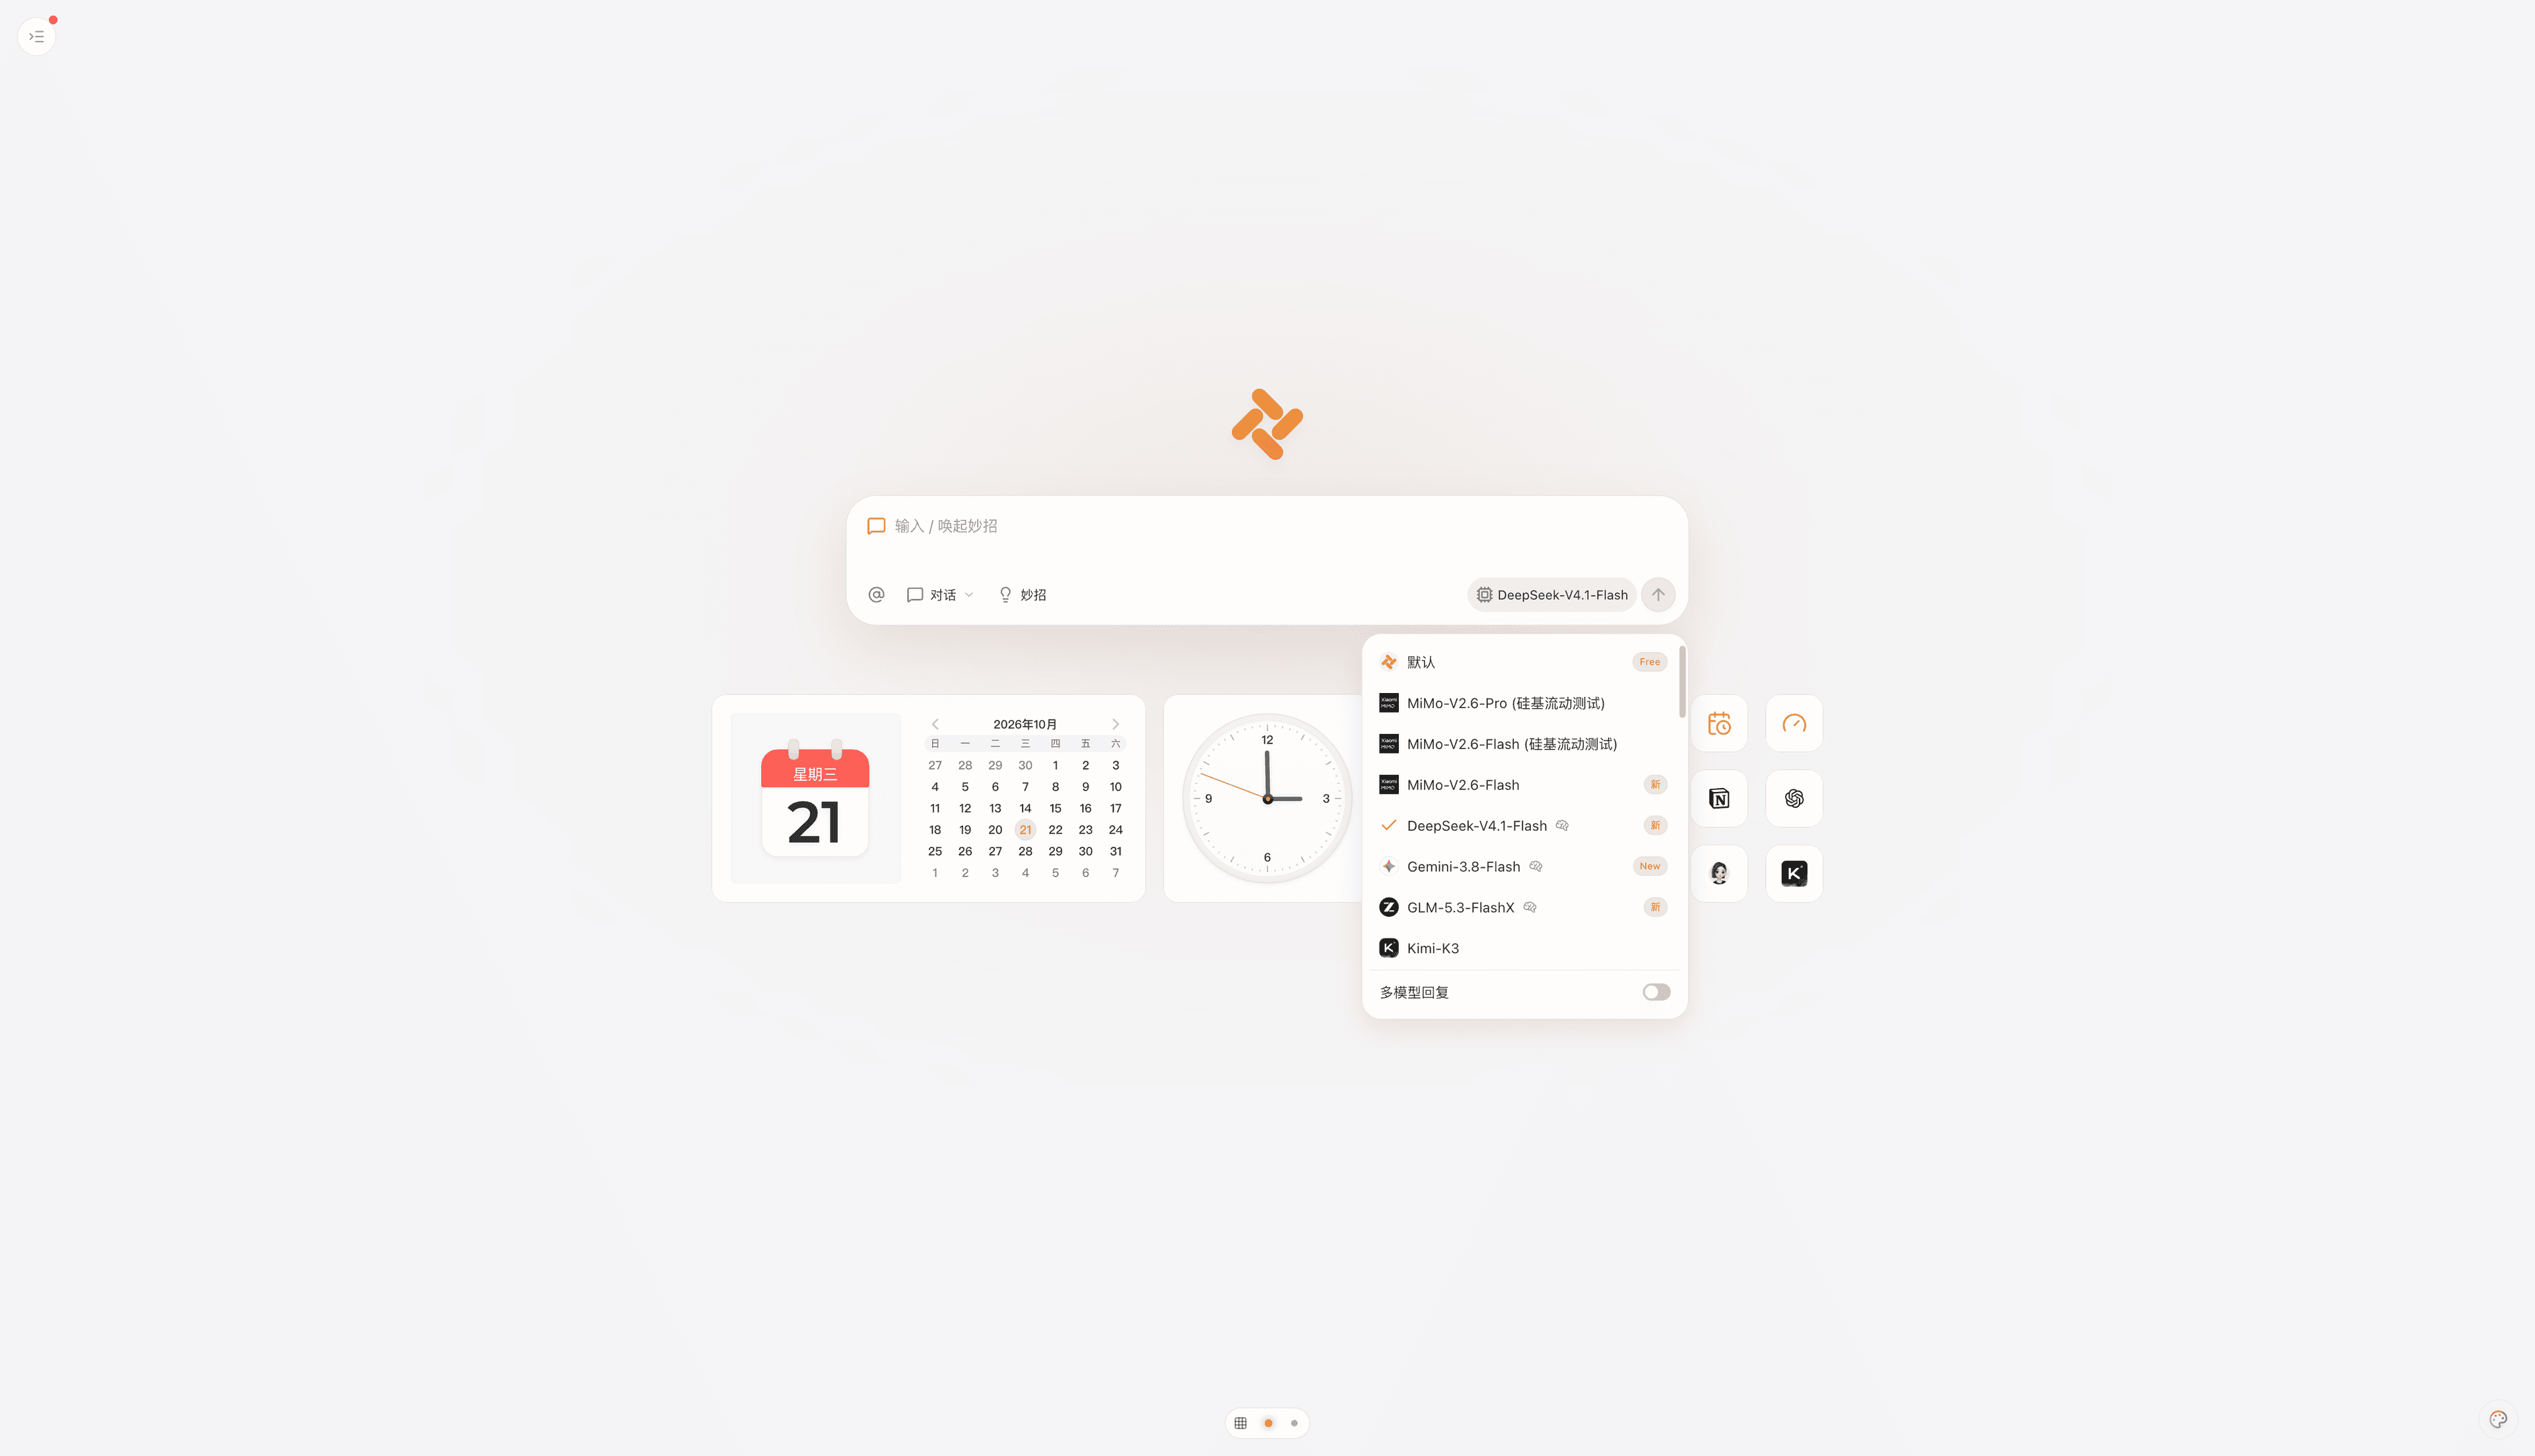
本文的本地 Tabbit 檢查範圍更小。10 月 21 日,測試帳號的對話模型列表中有 MiniMax-M3 和 Friday-MiniMax-M3,沒有 M3.1 Flash。因此沒有提交該模型的任務。截圖記錄的是存取條件檢查,不是模型測評失敗,也不能據此判斷其他帳號或地區的可用性。
官方基準成績該信到什麼程度
| 基準 | MiniMax 公佈的 M3.1 Flash 成績 | 可輔助評估的能力 |
|---|---|---|
| DeepSWE v1.1 | 73.7% | 帶測試的軟體工程任務 |
| OSWorld V2 | 61.7 | 跨應用電腦操作 |
| Agents' Last Exam | 29.6 | 具有經濟價值的專業任務 |
| BankerToolBench | 76.2 | 多步驟金融工具呼叫 |
| CyberGym | 發佈正文為 82% | 漏洞發現與驗證 |
這些成績來自官方發佈文章,本文沒有復現。正文將 CyberGym 四捨五入為 82%,不同展示精度不能算作獨立證據。表格沒有提供完整復現材料、誤差區間,或覆蓋每個用戶端和思考檔位的受控對比。它支援開展試用,不能直接支援全面替換。
在獨立分析測試中,Plotly 報告 M3.1 Flash、Claude Opus 5.5、Gemini 4 Argon、GPT-6 Sol 均答對 41/43 題,GLM 5.3 Flash 和 Qwen 3.8 27B 為 38/43。43 道題上的同分不等於全面能力相同。其他候選可以從 DeepSeek V4.1 Flash 總覽和 GLM Flash 背景資料開始瞭解,再核實當前端點,用同一套任務比較。
值得驗證的三個優點
能檢查計算過程的背景分析
Plotly 的隱藏模式成績支援將正式版加入背景分析候選。真正有用的交付物是可檢查的查詢和結果表。有能力驗證計算的分析人員,可能願意為更完整的發現多等一會兒。需要即時答案的人,可能會根據相同證據做出相反選擇。
重複工具上下文的單價較低
按當前標價,假設一次執行包含 200,000 個非快取輸入 token 和 20,000 個計費輸出 token,token 成本為 0.042 美元,未計工具等費用。這是算例,不是實測價格。若同一次執行生成 100,000 個輸出 token,成本變成 0.09 美元。即使最終答案很短,思考深度和重試也會改變賬單。
快取輸入單獨計費。必須查看用量記錄中的實際命中情況,不能將所有重複提示詞按快取價計算。MiniMax 宣稱的 Agent 任務整體成本降低 70%,不等於所有工作負載或訂閱均享同樣折扣。
可以在現有集成中調節思考強度
呼叫指南提供 Anthropic 和 OpenAI 相容請求格式,便於開發者重用現有應用進行評估。先檢查用戶端是否正確傳遞 output_config.effort 或 reasoning_effort,以及是否保留輪次間的工具結果。隨後使用相同驗收標準對比低檔和 max。降低檔位能否保持品質,必須測試後才能下結論。
會改變推薦的三個限制
不能關閉思考
只需簡短提取的請求,仍然經過自適應思考。較低 effort 不等於無思考模式。記錄結果、總用量、耗時和工具呼叫,避免只看吞吐而忽略冗長交互。Gemini 3.8 Flash 測評提供了另一種按工作流判斷的框架,不構成它與 M3.1 Flash 的直接性能排名。
正確解釋也可能對應錯誤產物
Plotly 的 SQL 漏除法,比沒有來源的“模型不可靠”更具體。應直接檢查公式和程式碼;資訊提取按固定樣本核對原文;修復程式碼則要求先復現失敗,再驗證修復後通過。人工覆核仍屬於合格任務成本。
早期版本和存取條件混雜
Preview 訂閱用戶、匿名免費端點用戶和正式版 API 用戶,可能使用不同構建與工具。權重可用性也需要單獨確認,API 上架不能證明部署授權條款。網站上有模型介紹,同樣不能證明某個 Tabbit 帳號今天就能選擇該模型。
社群原聲:有參考價值,也有版本邊界
Preview 好評與對基準的辯護
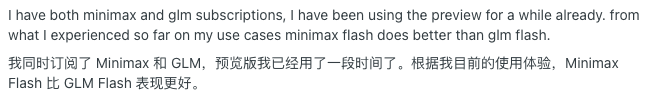
Sovairon,10 月 19 日稱,其 MiniMax 訂閱體驗中 Flash 優於 GLM Flash;後續回復明確說使用的是 MiniMax 3.1 Flash Preview。具體任務和評分方法未披露。這支援 Preview 的個人偏好,不能作為正式版勝出的測量結果。
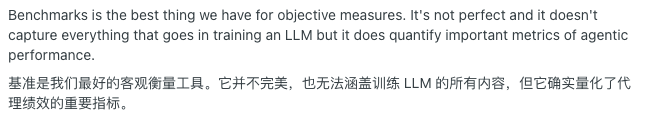
ApprehensiveDelay238,10 月 19 日認為,基準雖不完善,仍能量化部分 Agent 能力。這是評估方法的討論,不是任務完成記錄;它提醒我們,不應因一次糟糕體驗而否定所有公開資料。
思考循環與相反的模型偏好
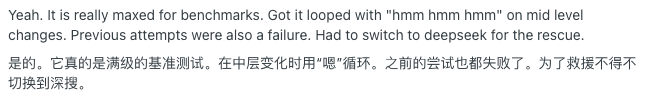
Pepek91,10 月 20 日稱,處理中等複雜度修改時出現重複思考,最後切換到 DeepSeek。評論未提供準確端點、effort 配置和程式碼倉庫。這是值得納入試用的失敗模式,不能據此計算失敗率。
RepulsiveRaisin7,10 月 19 日更偏好 GLM Flash,並質疑基準敘事,但沒有附測試日誌。它與 Sovairon 的偏好相反,也說明不能把這些評論拼成勝負票數。
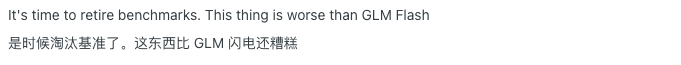
可執行的編輯判斷是:測試循環問題,區分版本,同時保留基準作為證據之一。這些評論都不能證明你的未來成功率。
最終建議按工作負載劃分
| 工作負載 | 建議 | 驗收重點 |
|---|---|---|
| 有覆核的背景分析 | 將 M3.1 Flash 列入候選 | 重跑 SQL,檢查單位和聚合 |
| 交互式提取、快速問答 | 換用前先比較 effort 檔位 | 完整耗時和正確結果數 |
| 高難程式碼庫修改 | 保留當前模型作對照 | 相同問題、測試及工具權限 |
| 無人值守的外部操作 | 不憑這些分數批准上線 | 先驗證恢復和動作邊界 |
| 今天必須自行部署 | 確認權重檔案和授權條款 | API 存取不滿足這一要求 |
| Tabbit 瀏覽器調研 | 先檢查模型選擇器 | M3 選項不等於 M3.1 Flash |
對有覆核的背景任務,準確率提升可能值得多等。對快速交互,報告中的三分鐘中位耗時意味著遷移前必須測量。現有證據不足以推薦全面替換程式設計模型,更不能據此取消人工驗證。
先核對存取條件,再將工作流放入 Tabbit
Tabbit 可以組織評估瀏覽器任務時使用的來源頁面和對話。產品說明與使用實踐介紹了相關工作流,但並不證明 Tabbit 暴露 MiniMax 的 API effort 參數,或每種套餐都包含該模型。
由於本次測試帳號沒有 M3.1 Flash,本文不能給出站內模型運行結果。可先查看 M3.1 Flash 資料頁 (简体中文),再核對自己選擇器中的準確名稱。若沒有該選項,應通過 MiniMax 正式支援的用戶端測試,不能用 M3 替代後標成 M3.1 Flash。
一個實用測試是:打開發佈文章和呼叫指南,提取費率與預設思考檔位,輸出附來源的表格,並區分已確認和未知事項。逐格核對原文,記錄帳號地區、用戶端版本、模型顯示名、工具標記、輸入與截圖。這是建議測試,本文並未完成該實驗。
先做一個受控任務,以當前模型為參照。下方按鈕用於下載 Tabbit、開展瀏覽器工作流試用,不保證 M3.1 Flash 存取權限或免費 API 用量。
 Tabbit Browser

常見問題
MiniMax M3.1 Flash 是什麼?
它是 MiniMax 於2026年10月19日推出的正式版程式設計與Agent模型。API識別名稱為 MiniMax-M3.1-Flash,文件列出的上下文為1,000,000 token。
M3.1 Flash 可以關閉思考嗎?
不可以。官方指南提供五檔effort,省略參數時預設max。關閉思考或指定none會傳回400錯誤。
M3.1 Flash API 如何計費?
截至10月21日,每百萬token輸入0.15美元、輸出0.60美元、快取輸入0.015美元。實際任務成本還取決於用量、思考、快取命中、工具與重試。
它比 Space Bunny 更快、更準確嗎?
Plotly分析測試的正確答案從38/43提高至41/43。每題中位耗時從36秒增加至3分鐘,因此該測試不支持任務完成更快的結論。
現在能下載權重自行部署嗎?
發布文章表示權重將於後續提供。部署前應核實實際檔案與授權條款,API清單上架不代表權重已可下載。
Tabbit 可以選擇 M3.1 Flash 嗎?
可用性取決於帳號、地區與目前的模型選擇器。本次測試帳號未列出M3.1 Flash,因此本文不聲稱完成了Tabbit內的效能測試。