
MiniMax M3.1 Flash mérite un essai pour l’analyse de données supervisée et les tâches utilisant des outils. Ses tarifs API bas et ses bons résultats publiés en font un candidat crédible. Ils ne prouvent pas qu’il terminera votre tâche de programmation plus vite ni qu’il nécessitera moins de vérifications. Cette analyse distingue les déclarations du fournisseur, les tests indépendants et les témoignages de la communauté. Elle ne prétend pas présenter un benchmark de performances réalisé par l’auteur.
Le point de tension est précis. Dans le test de Plotly sur les modèles publiés, le score est passé de 38/43 bonnes réponses pour Space Bunny Alpha à 41/43 pour M3.1 Flash, tandis que le temps médian par question est passé de 36 secondes à 3 minutes. C’est ce compromis, plutôt qu’un classement de lancement, qui détermine la recommandation ci-dessous. Tabbit Browser est évoqué comme un moyen d’organiser un flux de travail dans le navigateur, avec une vérification explicite de la disponibilité avant tout test propre au modèle.
Ce qu’est réellement MiniMax M3.1 Flash
MiniMax a lancé la version générale le 19 octobre 2026. L’identifiant API est MiniMax-M3.1-Flash. La documentation du modèle le décrit comme un modèle multimodal de programmation avec une fenêtre de contexte d’un million de tokens. Il faut distinguer la version publiée, l’aperçu de septembre et les builds Space Bunny anonymes lors de la comparaison des résultats. Notre présentation de MiniMax M3 traite du membre précédent de la famille.
Selon le guide d’invocation, la réflexion est obligatoire. Il existe cinq niveaux d’effort : low, medium, high, xhigh et max. Si le champ est omis, max est sélectionné. Les requêtes qui désactivent la réflexion ou utilisent none renvoient une erreur 400. Utilisez le champ d’effort adapté à votre protocole ; une interface cliente familière ne garantit pas que les mêmes paramètres parviennent au serveur.
Points clés
Évaluez le temps écoulé et le coût total par tâche acceptée, en plus du débit de tokens.
Le résultat de Plotly, 41/43, justifie un essai analytique supervisé, avec un compromis important sur le temps d’attente.
Les faibles tarifs des tokens n’éliminent pas le coût du raisonnement, des nouvelles tentatives et de la vérification.
Les éloges de la version Preview et les critiques de Space Bunny doivent être associés à leur version.
Confirmez la présence du modèle exact dans votre compte avant de suivre un flux Tabbit propre au modèle.
Le chiffre décisif est de 3 minutes, malgré une génération rapide
Dans son rapport analytique du 20 octobre, Plotly indique une médiane de 3 minutes par question pour la version publiée, contre 36 secondes pour Space Bunny Alpha. Le score a progressé de trois réponses sur un examen de 43 questions. Cinq fois plus d’attente peut être acceptable pour une analyse en arrière-plan ; c’est une pénalité importante pour un assistant interactif.
Le rapport attribue cette durée accrue à un plus grand nombre d’appels au modèle et à davantage de texte généré. Le nombre d’appels par question est passé de 15 à 45, tandis que la sortie a augmenté d’environ 8 500 à 32 000 tokens. Le coût de l’examen complet, recalculé aux tarifs publics de MiniMax, est passé de 0,82 $ à 4,09 $. Ce sont les résultats d’un évaluateur sur son agent d’analyse, et non une garantie générale de latence ni une comparaison avec MiniMax M3.
C’est pourquoi un chiffre élevé de tokens par seconde ne suffit pas à trancher cette analyse. Un calcul approximatif est le suivant :
Temps de tâche = génération du modèle + exécution des outils + attente + nouvelles tentatives
Coût de tâche = toutes les entrées + entrées mises en cache + toutes les sorties facturables + outils
Coût par tâche acceptée = dépenses totales / sorties qui passent vos contrôles
Gardez le dénominateur visible. Une exécution ratée mais peu coûteuse consomme quand même du temps et de l’argent. Le guide des navigateurs agentiques explique pourquoi le choix du modèle et l’exécution dans le navigateur sont deux éléments distincts du flux de travail.
M3.1 Flash en un coup d’œil
| Élément | Informations vérifiées | Conséquence pour la décision |
|---|---|---|
| Modèle | MiniMax-M3.1-Flash, version générale | Consignez l’identifiant exact |
| Contexte | 1 000 000 tokens | La capacité ne prouve pas la précision du rappel |
| Réflexion | Toujours active ; cinq niveaux d’effort ; max par défaut | Définissez explicitement le niveau d’effort |
| Tarifs API par million de tokens | 0,15 $ en entrée ; 0,60 $ en sortie ; 0,015 $ pour l’entrée en cache | Comptabilisez le raisonnement et les absences de cache |
| Analyse Plotly | 41/43 correctes ; médiane de 3 minutes par question | À essayer pour l’analyse en arrière-plan |
| Poids ouverts | L’annonce indique qu’ils seront disponibles ultérieurement | Vérifiez les fichiers et la licence avant déploiement |
Les caractéristiques proviennent du guide d’invocation et des tarifs officiels, consultés le 21 octobre. L’annonce de lancement précise que les poids seront publiés plus tard. L’annonce d’une publication future ne signifie pas qu’un checkpoint est téléchargeable.
Des éléments pratiques avant le tableau des benchmarks
L’examen de Plotly utilise un entrepôt synthétique d’énergie éolienne et un corrigé privé. Le modèle publié a trouvé les cinq motifs cachés, mais a manqué deux questions au total. Un échec est particulièrement instructif : son explication indiquait qu’il avait divisé une somme sur sept jours par sept, alors que la requête SQL omettait cette division. Un récit convaincant ne rend pas le calcul exact.
C’est un témoignage pratique utile, car il présente à la fois un résultat et un échec concret. Il reste limité à un test analytique de courte durée. Il ne démontre pas les performances sur un grand dépôt, un processus métier sans supervision ou votre propre base de données. Réexécutez la requête concernée et inspectez le résultat au lieu d’accepter la description du modèle.
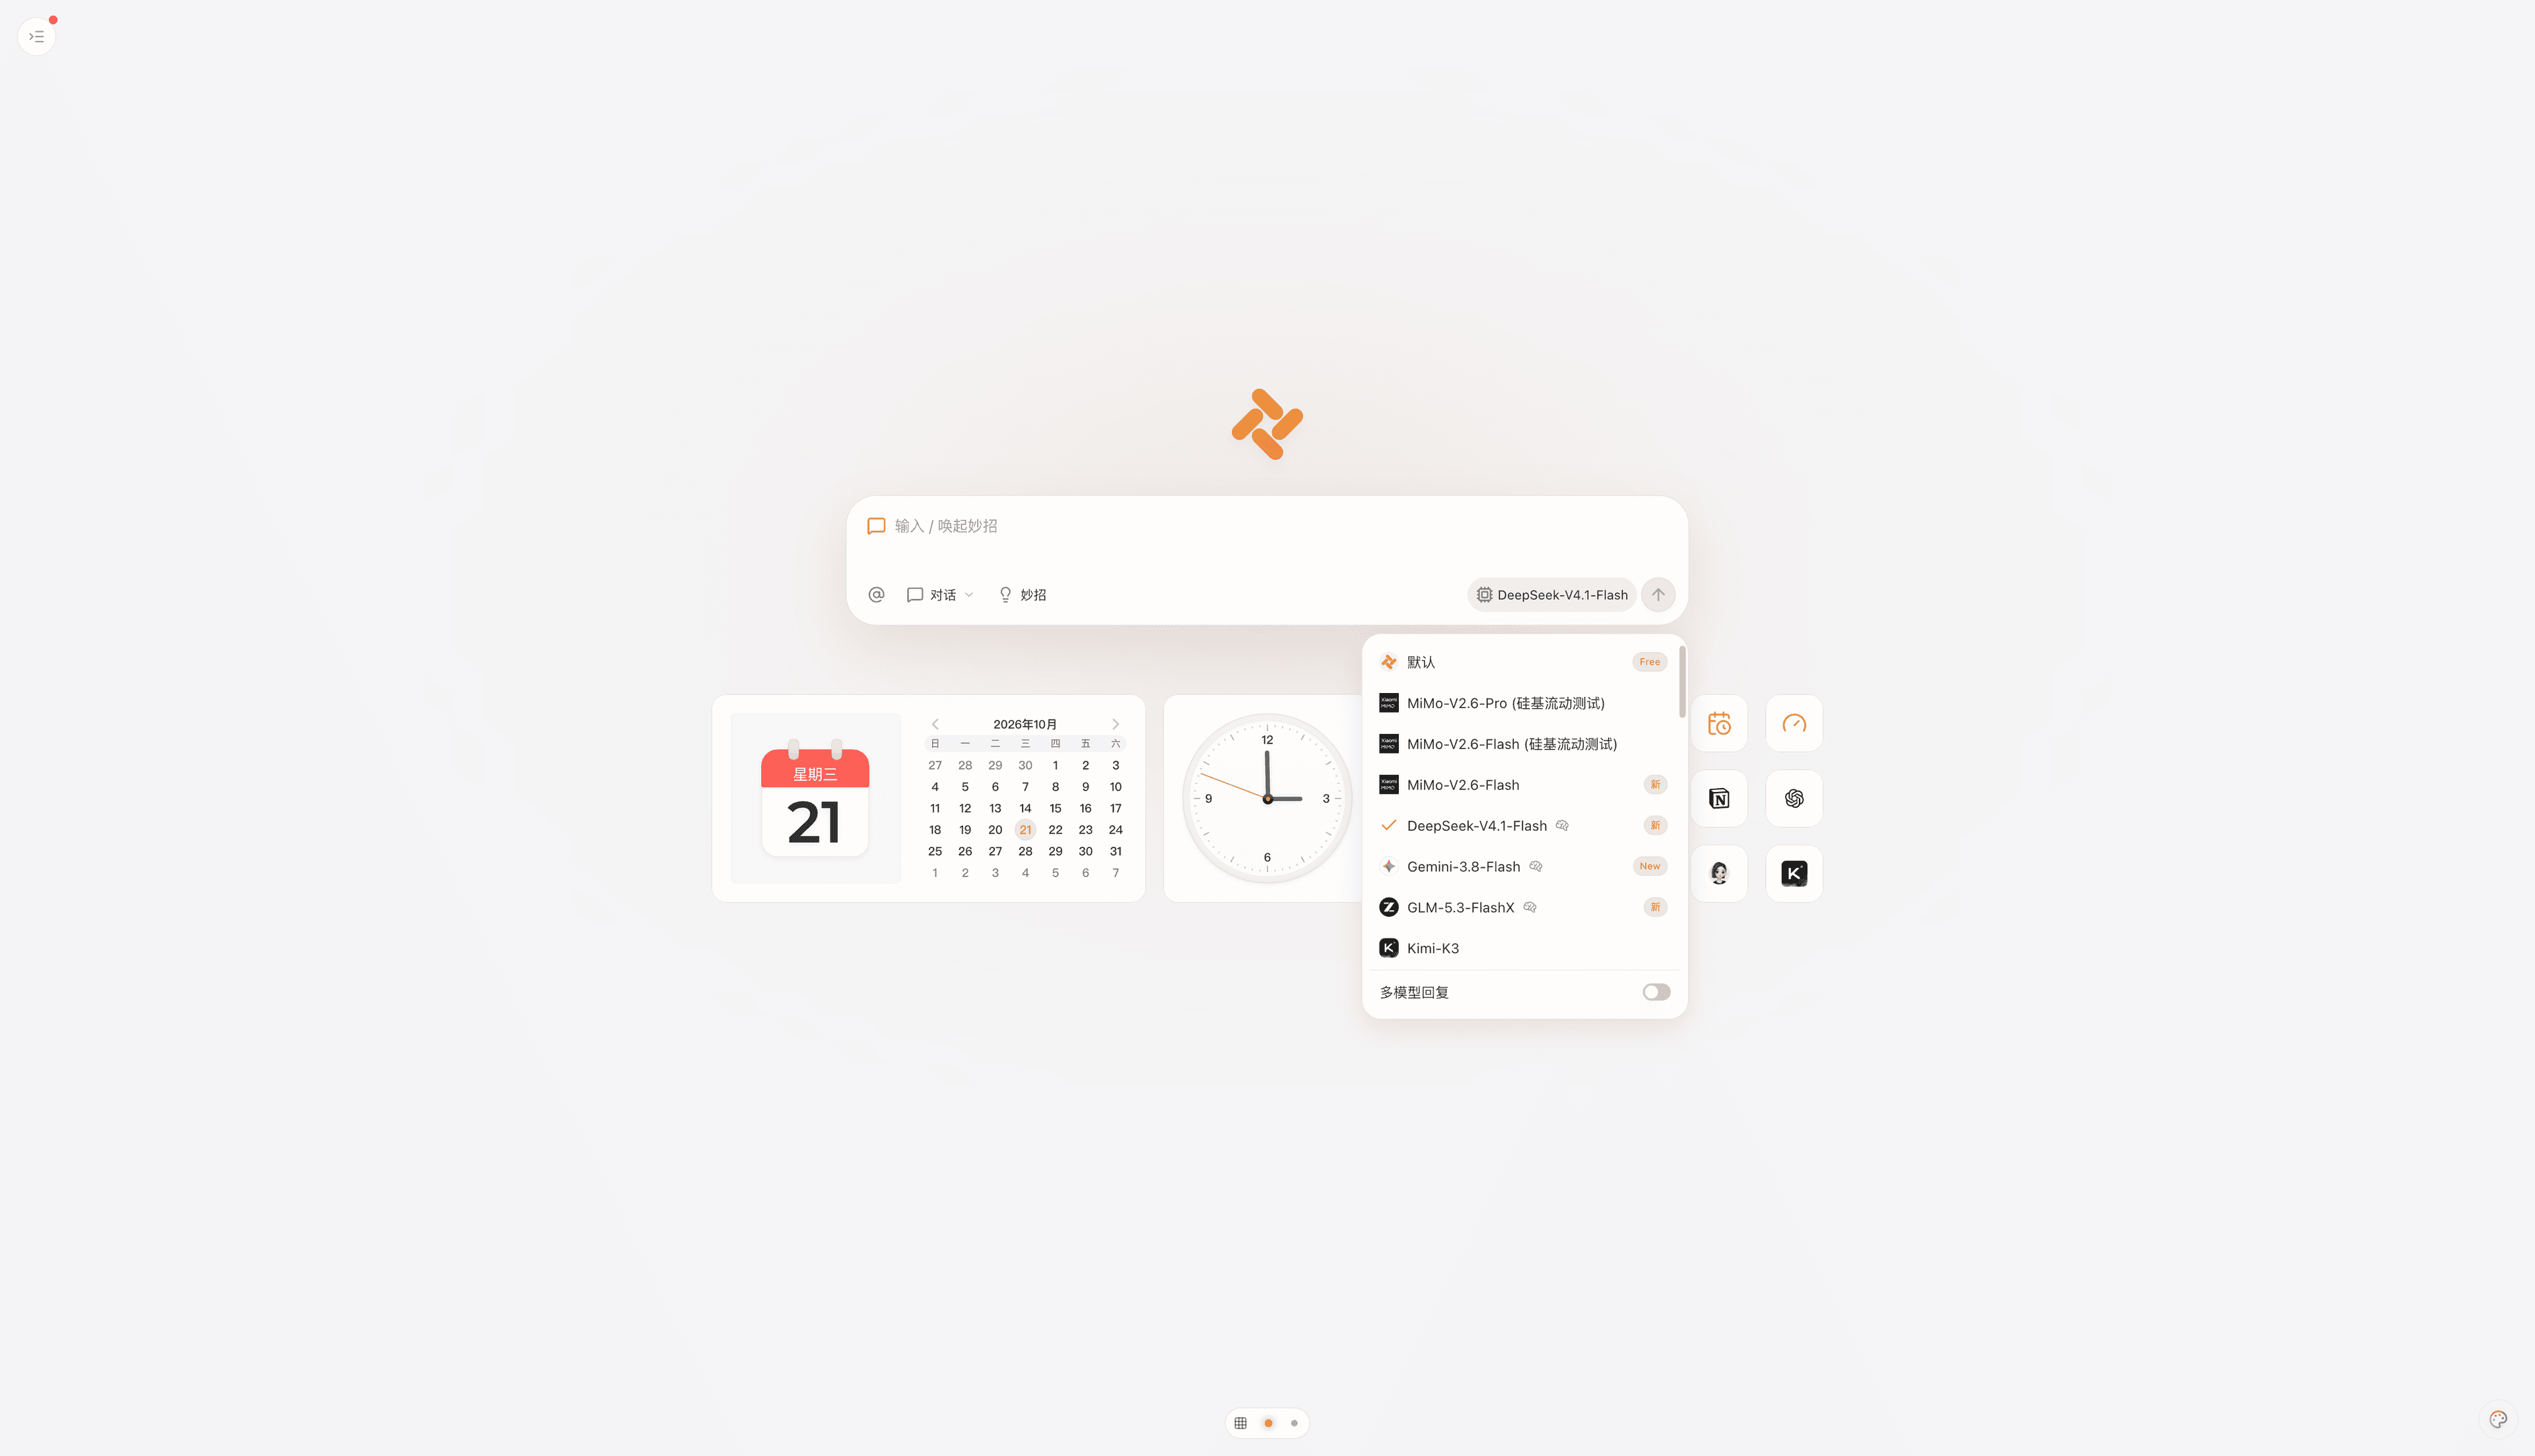
La vérification locale de Tabbit pour cet article était plus limitée. Le 21 octobre, le sélecteur de chat du compte de test disponible affichait MiniMax-M3 et Friday-MiniMax-M3, mais pas M3.1 Flash. Aucune tâche M3.1 Flash n’a été soumise. La capture d’écran documente cette vérification d’accès, pas l’échec d’un benchmark du modèle. Elle ne prouve pas la disponibilité dans d’autres comptes ou régions.
Benchmarks du fournisseur et degré de confiance à leur accorder
| Benchmark | Résultat M3.1 Flash rapporté par MiniMax | Ce qu’il peut aider à évaluer |
|---|---|---|
| DeepSWE v1.1 | 73,7 % | Ingénierie logicielle avec tests |
| OSWorld V2 | 61,7 | Utilisation d’un ordinateur dans différentes applications |
| Agents' Last Exam | 29,6 | Tâches professionnelles à valeur économique |
| BankerToolBench | 76,2 | Utilisation d’outils financiers en plusieurs étapes |
| CyberGym | 82 % dans le texte de lancement | Découverte et validation de vulnérabilités |
Il s’agit de résultats rapportés par le fournisseur dans l’article de lancement, et non de tests reproduits ici. Le texte arrondit CyberGym à 82 % ; des précisions d’affichage différentes ne constituent pas des preuves indépendantes. Le tableau ne fournit pas de dossier complet de réplication, d’intervalles d’incertitude ni de comparaison contrôlée entre tous les clients et niveaux d’effort. Ces scores justifient un essai, pas une décision générale de remplacement.
Pour une comparaison indépendante en analyse de données, Plotly rapporte 41/43 pour M3.1 Flash, Claude Opus 5.5, Gemini 4 Argon et GPT-6 Sol, contre 38/43 pour GLM 5.3 Flash et Qwen 3.8 27B. Une égalité sur 43 questions ne prouve pas une équivalence générale. Pour les autres familles candidates, consultez d’abord la présentation de DeepSeek V4.1 Flash et le contexte de GLM Flash, puis vérifiez leurs points de terminaison actuels et exécutez le même jeu de tâches.
Trois atouts qui méritent un essai
Analyse en arrière-plan avec calculs vérifiables
Le résultat de Plotly sur les motifs cachés justifie d’essayer le modèle publié sur une analyse qui peut s’exécuter pendant que vous faites autre chose. Le résultat utile est une requête et un tableau de résultats que l’on peut inspecter. Un analyste capable de valider le calcul peut accepter une attente plus longue pour une meilleure couverture. Une personne qui a besoin d’une réponse immédiate peut prendre une autre décision à partir des mêmes éléments.
Tarifs bas pour le contexte d’outils répété
Aux tarifs publiés, une exécution hypothétique avec 200 000 tokens d’entrée non mis en cache et 20 000 tokens de sortie facturables coûte 0,042 $ avant les outils et autres frais. C’est un calcul, pas le prix mesuré d’une tâche. Si la même exécution génère 100 000 tokens de sortie, son coût en tokens atteint 0,09 $. La profondeur du raisonnement et les nouvelles tentatives peuvent modifier la facture même si la réponse visible est courte.
L’entrée mise en cache est facturée séparément. Vérifiez les vrais succès du cache dans les relevés d’utilisation au lieu d’appliquer le tarif de cache à chaque prompt répété. L’affirmation de MiniMax selon laquelle le coût global des tâches agentiques baisse de 70 % diffère d’une remise universelle sur chaque charge de travail ou abonnement.
Effort réglable dans une intégration existante
Le guide d’invocation documente des formats de requête compatibles avec Anthropic et OpenAI. Les développeurs disposent ainsi d’un moyen pratique d’évaluation sans reconstruire l’application environnante. Commencez par vérifier que votre client transmet correctement output_config.effort ou reasoning_effort et conserve les résultats des outils entre les tours. Comparez ensuite un niveau d’effort inférieur à max avec les mêmes critères d’acceptation. Un effort inférieur est une hypothèse à tester, pas une promesse de qualité identique.
Trois limites qui changent la recommandation
Le raisonnement ne peut pas être désactivé
Même une requête qui ne demande qu’une courte extraction utilise un modèle à réflexion adaptative. Un niveau d’effort inférieur peut réduire le raisonnement, mais ne constitue pas un mode sans réflexion. Consignez le résultat final, l’utilisation totale, le temps écoulé et les appels aux outils. La vitesse des tokens peut masquer une interaction inutilement longue. L’analyse de Gemini 3.8 Flash propose un autre cadre de comparaison fondé sur les flux de travail, plutôt qu’un classement direct des performances de ce modèle.
Une explication correcte peut accompagner un travail erroné
La division manquante dans le SQL de Plotly est plus exploitable qu’une affirmation sans source selon laquelle le modèle serait peu fiable. Vérifiez directement les formules et le code générés. Pour l’extraction, vérifiez un échantillon fixe par rapport au texte source. Pour le code, exigez un test en échec avant la correction et un test réussi après. La vérification humaine reste incluse dans le coût d’une tâche acceptée.
Les écarts de version et d’accès compliquent les premiers témoignages
Les abonnés Preview, les utilisateurs de points de terminaison gratuits anonymes et les utilisateurs de l’API en version générale ont pu voir des builds et des outils différents. La disponibilité des poids doit aussi être vérifiée séparément. Ne déduisez pas une licence de déploiement d’une fiche API. De même, la page d’un modèle sur un site ne prouve pas qu’un compte Tabbit donné puisse le sélectionner aujourd’hui.
Témoignages de la communauté : utiles, avec des limites de version
Expérience positive de la Preview et défense des benchmarks
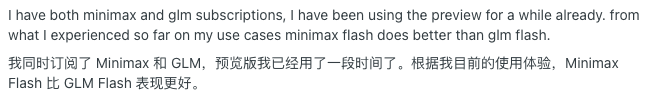
Sovairon, le 19 octobre, a indiqué que son expérience de l’abonnement MiniMax favorisait Flash par rapport à GLM Flash. Dans un message de suivi, cette personne a précisé qu’il s’agissait de MiniMax 3.1 Flash Preview. La charge de travail et la méthode de notation n’ont pas été divulguées. Cela étaye une préférence subjective pour la Preview, pas une victoire mesurée de la version générale.
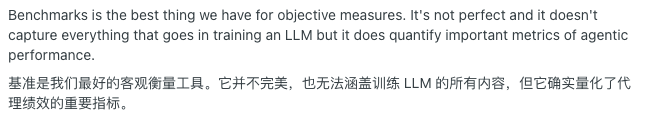
ApprehensiveDelay238, le 19 octobre, a défendu les benchmarks comme des mesures imparfaites mais utiles des performances des agents. Il s’agit d’un argument méthodologique, pas du compte rendu d’une tâche achevée. C’est un contrepoint utile au rejet de tous les scores publiés après une session décevante.
Boucles de raisonnement et préférence opposée
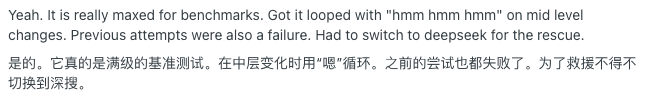
Pepek91, le 20 octobre, a signalé des raisonnements répétitifs lors de modifications de complexité moyenne et être passé à DeepSeek. Le point de terminaison exact, la configuration d’effort et le dépôt n’ont pas été précisés. Considérez ce message comme un mode d’échec à inclure dans votre essai, pas comme une estimation du taux d’échec.
RepulsiveRaisin7, le 19 octobre, préférait GLM Flash et mettait en doute le récit autour des benchmarks. Aucun journal de tâche n’accompagnait le commentaire. Ce témoignage contredit la préférence de Sovairon, ce qui montre précisément pourquoi ces avis ne peuvent pas être additionnés pour désigner un gagnant.
Le jugement pratique consiste à tester la présence de boucles, à distinguer les versions et à conserver les benchmarks comme une source de preuves parmi d’autres. Aucun de ces messages n’établit votre taux de réussite futur.
Le verdict dépend de la charge de travail
| Votre charge de travail | Recommandation | Contrôle d’acceptation |
|---|---|---|
| Analyse en arrière-plan avec vérification | Présélectionnez M3.1 Flash | Réexécutez le SQL et validez unités et agrégats |
| Extraction interactive ou réponses rapides | Comparez les niveaux d’effort avant de changer | Mesurez le temps écoulé et les résultats corrects |
| Modifications difficiles dans un dépôt | Gardez votre modèle actuel comme référence | Utilisez les mêmes problèmes, tests et autorisations d’outils |
| Actions externes sans supervision | Ne vous décidez pas sur ces seuls scores | Vérifiez d’abord la récupération et les limites d’action |
| Hébergement autonome requis aujourd’hui | Confirmez la disponibilité réelle des poids et de la licence | L’accès API ne répond pas à cette exigence |
| Recherche dans le navigateur avec Tabbit | Vérifiez le sélecteur avant le test | Une option M3 n’est pas M3.1 Flash |
Pour une tâche en arrière-plan avec vérification, le gain de précision peut justifier l’attente. Pour des échanges rapides, la médiane déclarée de trois minutes incite à mesurer soigneusement avant toute migration. Rien ici ne justifie le remplacement de tous les modèles de programmation ni l’abandon de la vérification humaine.
Intégrer le flux de travail dans Tabbit après vérification de l’accès
Tabbit peut organiser les pages sources et la conversation utilisées pour évaluer une tâche dans le navigateur. Son explication du produit et ses conseils d’utilisation décrivent ce flux. Cela ne prouve pas que Tabbit expose les contrôles d’effort de l’API MiniMax ni que le modèle soit inclus dans chaque offre.
Le compte de test observé ne proposait pas M3.1 Flash ; cet article ne peut donc pas présenter de résultat du modèle dans Tabbit. Consultez la page de ressources M3.1 Flash (English) pour des informations de configuration sourcées, puis confirmez le nom affiché exact dans votre propre sélecteur. S’il est absent, utilisez un client MiniMax officiellement pris en charge pour tester le modèle. Ne remplacez pas le modèle par M3 en étiquetant le résultat M3.1 Flash.
Une tâche d’essai utile consiste à ouvrir l’article de lancement et le guide d’invocation, à extraire les tarifs et les valeurs d’effort par défaut dans un tableau lié aux sources, puis à distinguer les faits confirmés des inconnues. Vérifiez chaque cellule sur la page originale. Consignez la région du compte, la version du client, le modèle affiché, les indicateurs d’outils, le prompt et une capture d’écran. Il s’agit d’un test proposé, pas d’une expérience effectuée pour cette analyse.
Commencez par une tâche contrôlée et utilisez votre modèle actuel comme référence. Le bouton ci-dessous permet de télécharger Tabbit pour le flux de travail dans le navigateur ; il ne garantit ni l’accès à M3.1 Flash ni l’utilisation gratuite de l’API.
 Tabbit Browser

Questions fréquentes
Qu’est-ce que MiniMax M3.1 Flash ?
C’est le modèle de programmation et d’agents lancé par MiniMax le 19 octobre 2026. Son identifiant API est MiniMax-M3.1-Flash et la documentation indique un contexte d’un million de tokens.
Peut-on désactiver le raisonnement ?
Non. Le guide propose cinq niveaux d’effort et sélectionne max si le champ est omis. La désactivation ou la valeur none provoque une erreur 400.
Combien coûte l’API ?
Au 21 octobre, le million de tokens coûte 0,15 $ en entrée, 0,60 $ en sortie et 0,015 $ en entrée mise en cache. Le coût réel dépend du volume, du raisonnement, du cache, des outils et des nouvelles tentatives.
Est-il plus rapide et précis que Space Bunny ?
Dans le test analytique de Plotly, le score passe de 38/43 à 41/43. Le temps médian par question monte de 36 secondes à 3 minutes, ce qui ne prouve pas une exécution plus rapide.
Les poids sont-ils disponibles pour l’auto-hébergement ?
L’annonce indique une publication ultérieure. Vérifiez les fichiers et la licence avant tout déploiement ; une présence dans l’API ne prouve pas que les poids sont téléchargeables.
Peut-on choisir M3.1 Flash dans Tabbit ?
Cela dépend du compte, de la région et du sélecteur actuel. Le compte de test consulté ne le proposait pas ; aucun résultat de performances dans Tabbit n’est donc revendiqué.