
MiniMax M3.1 Flashは、監督付きのデータ分析やツールを使う作業で試す価値があります。API料金が低く、公表された評価結果も良好なため、有力な候補です。ただし、コーディング作業をより速く終えたり、レビューの手間を減らしたりできる証拠にはなりません。このレビューでは、ベンダーの主張、独立したテスト、コミュニティの報告を分けて扱います。筆者自身が性能ベンチマークを実施したとは主張しません。
注目すべきトレードオフは明確です。Plotlyのリリース版テストでは、Space Bunny Alphaの正答数が38/43だったのに対し、M3.1 Flashは41/43に向上しました。一方、設問ごとの中央値は36秒から3分に延びました。以下の推奨は、ローンチ時の順位ではなく、このトレードオフを踏まえています。Tabbit Browserはブラウザー作業の整理に使える場として取り上げますが、モデル固有のテストを行う前に利用可否を確認します。
MiniMax M3.1 Flashとは
MiniMaxは2026年10月19日に一般公開版をリリースしました。API識別子は MiniMax-M3.1-Flash です。モデルのドキュメントでは、コンテキストウィンドウが1,000,000トークンのマルチモーダルなコーディングモデルと説明されています。結果を比較するときは、リリース版、9月のPreview、匿名のSpace Bunnyビルドを区別する必要があります。前世代についてはMiniMax M3の概要をご覧ください。
呼び出しガイドによると、thinkingは必須です。effortレベルは low、medium、high、xhigh、max の5段階です。省略すると max が選択されます。thinkingを無効にするリクエストや none を使うリクエストは400エラーになります。プロトコルに適したeffortフィールドを使ってください。使い慣れたクライアントの画面でも、同じ設定がサーバーに届くとは限りません。
要点
トークン生成速度に加え、経過時間と受け入れ可能なタスクあたりの総費用を評価してください。
Plotlyの41/43という結果は、待ち時間との大きなトレードオフを考慮した、監督付き分析の試行を後押しします。
トークン料金が安くても、推論、再試行、検証の費用はなくなりません。
Previewへの好意的な評価とSpace Bunnyへの不満には、バージョンを明記してください。
モデル固有のTabbitワークフローを試す前に、自分のアカウントで正確なモデル名を確認してください。
出力が速くても、判断を左右するのは3分
10月20日の分析レポートで、Plotlyはリリース版の設問ごとの中央値を3分、Space Bunny Alphaを36秒と報告しています。43問の試験で正答数は3問増えました。待ち時間が5倍でも、バックグラウンド分析なら許容できる場合がありますが、対話型アシスタントには大きな不利です。
レポートは、実行時間が延びた理由として、モデルの呼び出し回数と生成テキスト量の増加を挙げています。設問あたりの呼び出しは15回から45回に増え、出力は約8,500トークンから32,000トークンになりました。MiniMaxの通常料金で再計算した試験全体の費用は、$0.82から$4.09に上がりました。これは1つの評価者が自社の分析エージェントで得た結果であり、一般的なレイテンシの保証でも、MiniMax M3との比較でもありません。
そのため、tokens per secondの数値が高いだけでは、このレビューの結論は出せません。概算の考え方は次のとおりです。
タスク時間 = モデル生成 + ツール実行 + 待ち時間 + 再試行
タスク費用 = すべての入力 + キャッシュ済み入力 + 課金対象の出力 + ツール
受け入れ可能なタスクあたりの費用 = 総支出 / 検証に合格した出力数分母を見えるようにしてください。安価な失敗でも、時間と費用はかかります。エージェント型ブラウザーのガイドでは、モデル選択とブラウザー実行がワークフローの別要素である理由を説明しています。
M3.1 Flashの概要
| 項目 | 確認できた情報 | 判断への影響 |
|---|---|---|
| モデル | MiniMax-M3.1-Flash、一般公開版 | 正確な識別子を記録する |
| コンテキスト | 1,000,000トークン | 容量の大きさは想起精度を証明しない |
| Thinking | 常時有効、effortは5段階、既定値はmax | effortを明示的に設定する |
| 100万トークンあたりのAPI料金 | 入力$0.15、出力$0.60、キャッシュ済み入力$0.015 | 推論とキャッシュミスも数える |
| Plotlyの分析 | 正答41/43、設問あたり中央値3分 | バックグラウンド分析のテスト候補になる |
| オープンウェイト | ローンチ記事では後日公開予定 | 導入前にファイルとライセンスを確認する |
仕様は呼び出しガイドと公式料金表に基づき、10月21日に確認しました。ローンチ記事では、ウェイトは後日公開とされています。将来の公開予告は、ダウンロード可能なチェックポイントではありません。
ベンチマーク表を見る前に知っておきたい実例
Plotlyの試験では、風力エネルギーの合成データウェアハウスと非公開の正答キーを使っています。リリース版は隠されたパターンを5つすべて見つけましたが、全体では2問を間違えました。特に示唆的な失敗が1つあります。説明では7日分の合計を7で割ると書かれていましたが、SQLにはその除算がありませんでした。説明がもっともらしくても、計算が正しいとは限りません。
この実務者による証拠が役立つのは、出力と具体的な失敗の両方が示されているからです。一方、これは短時間の分析テストです。大規模なリポジトリ、無人の業務プロセス、自社のデータベースでの性能を証明するものではありません。モデルの作業説明をそのまま受け入れず、該当するクエリを再実行して結果を確認してください。
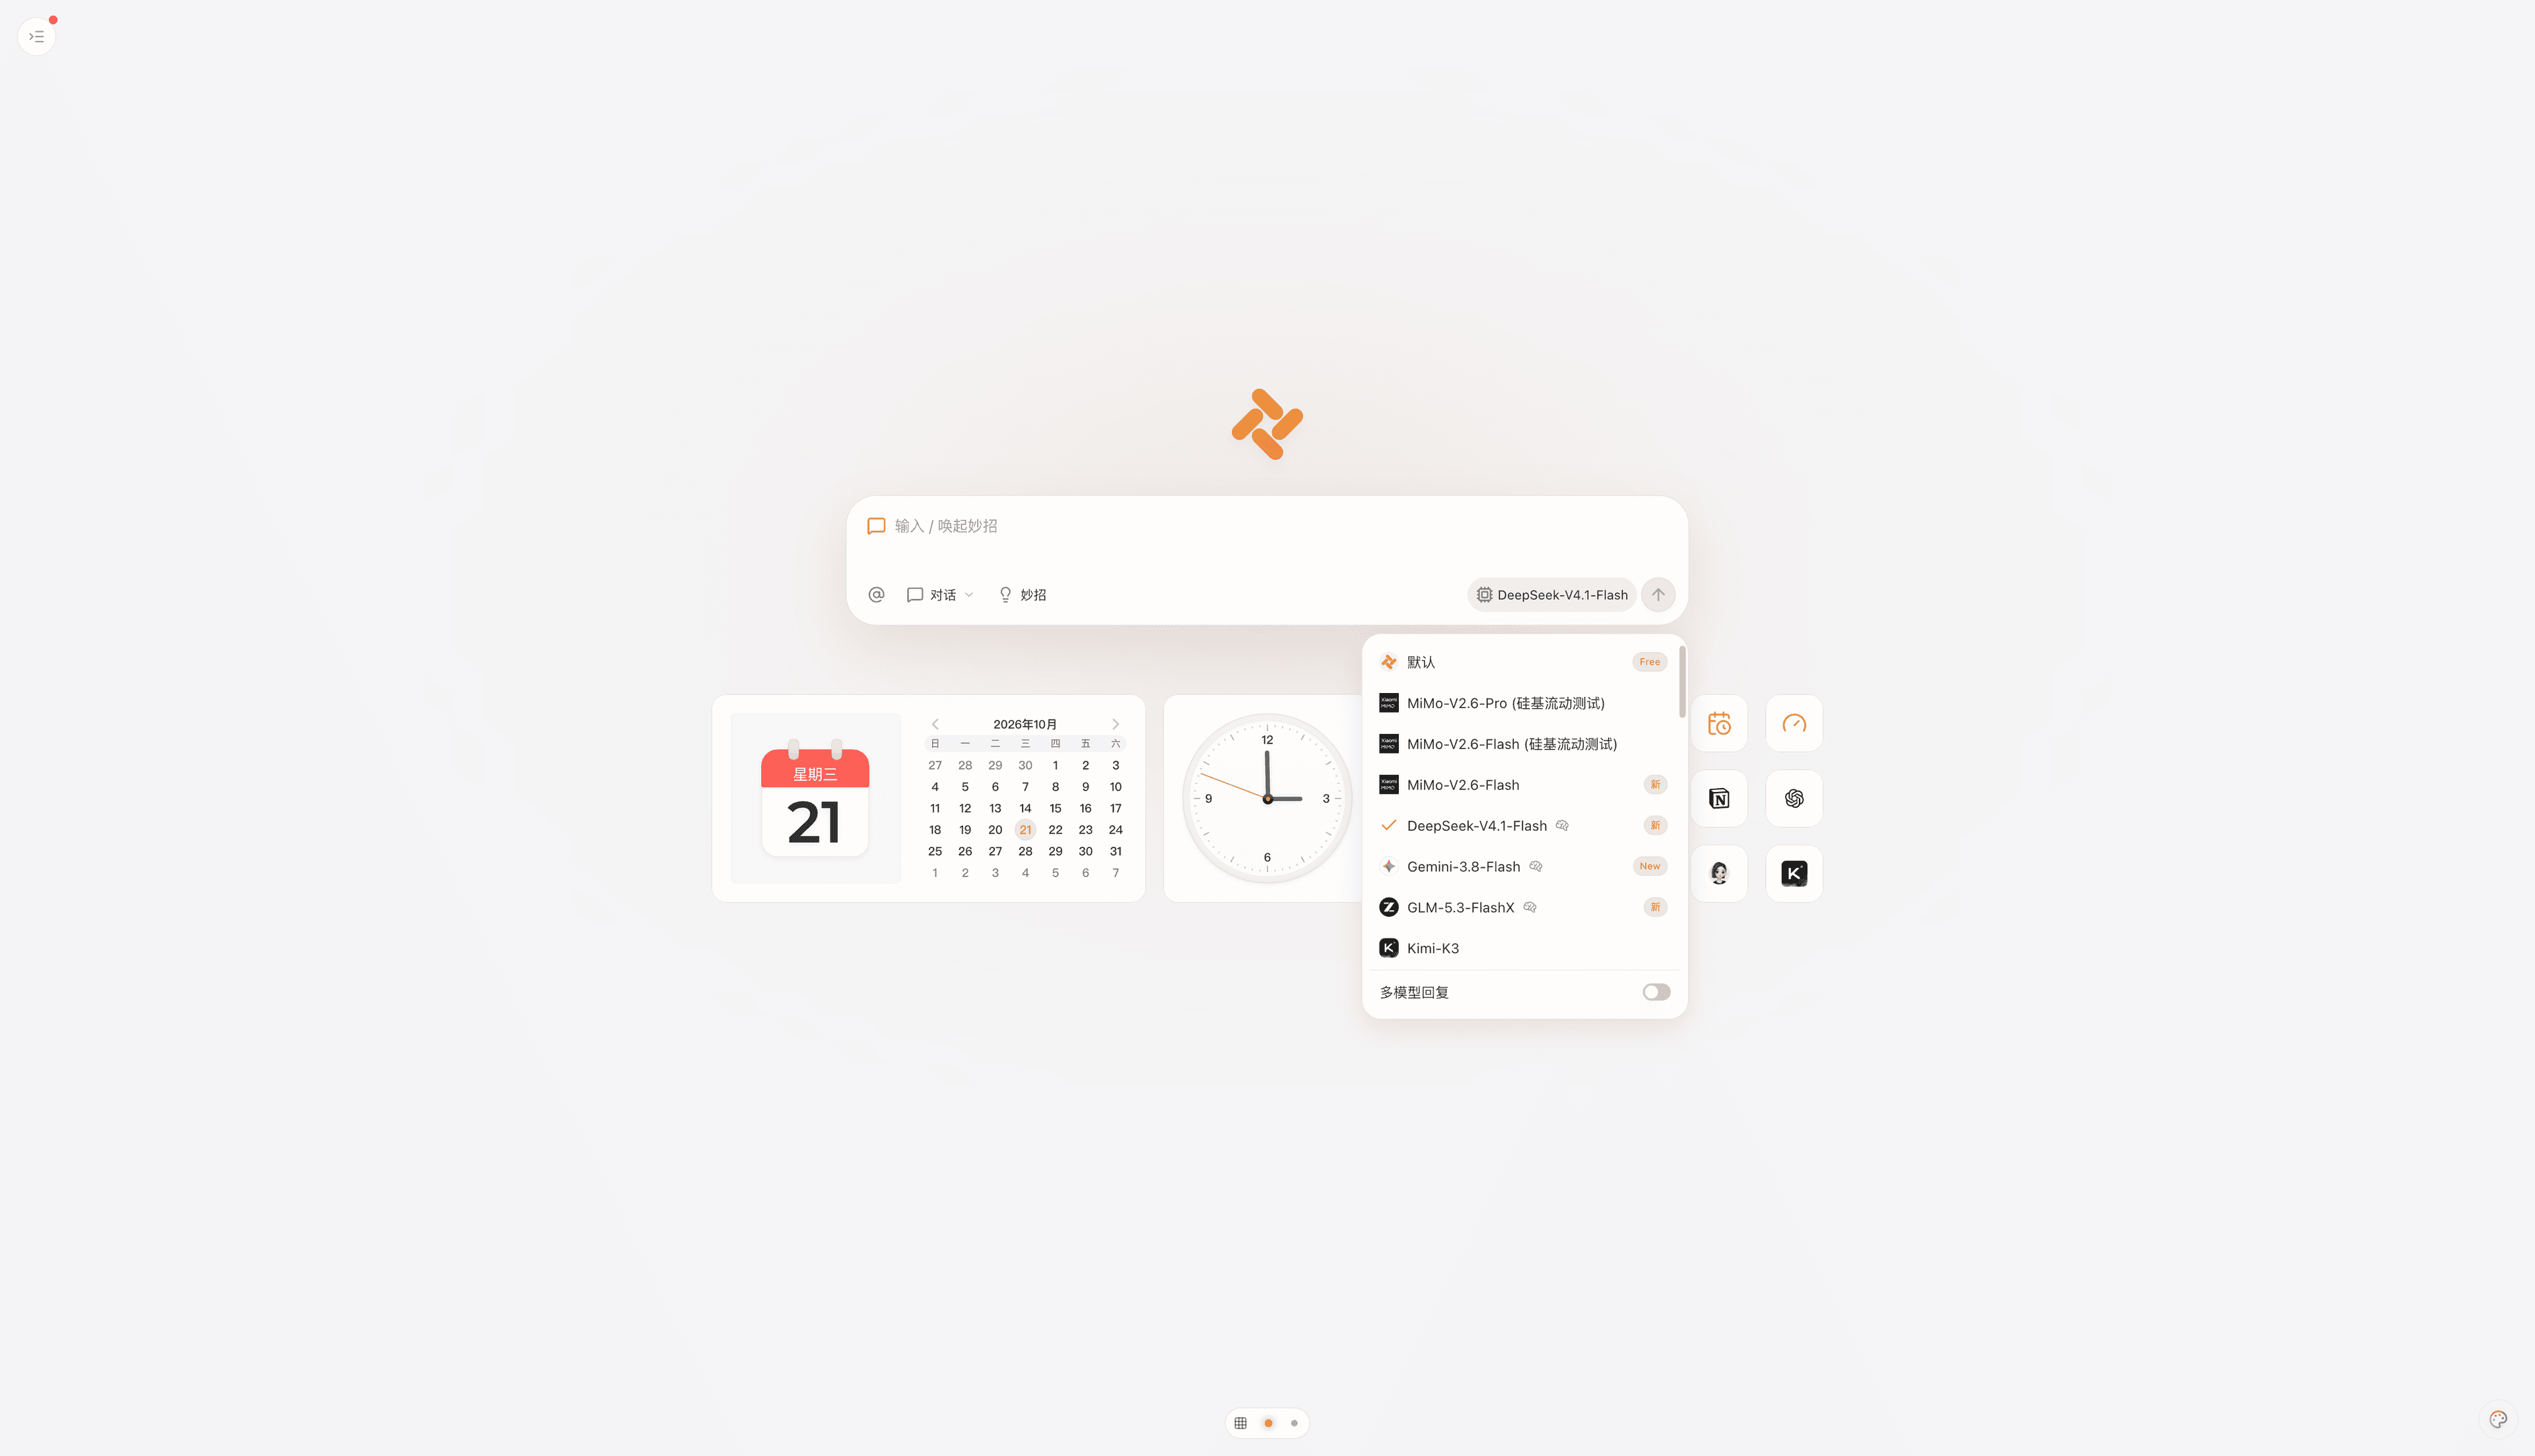
この記事のために行ったTabbitのローカル確認は、より限定的なものです。10月21日時点で、利用可能なテストアカウントのチャット選択画面にはMiniMax-M3とFriday-MiniMax-M3が表示されましたが、M3.1 Flashはありませんでした。M3.1 Flashでタスクは実行していません。スクリーンショットは利用可否の確認記録であり、モデルベンチマークの失敗記録ではありません。他のアカウントや地域での利用可否も示しません。
ベンダーのベンチマークをどこまで信頼するか
| ベンチマーク | MiniMaxが報告したM3.1 Flashの結果 | 評価に役立つ内容 |
|---|---|---|
| DeepSWE v1.1 | 73.7% | テストを伴うソフトウェアエンジニアリング |
| OSWorld V2 | 61.7 | 複数アプリをまたぐコンピューター操作 |
| Agents' Last Exam | 29.6 | 経済的価値のある専門業務 |
| BankerToolBench | 76.2 | 複数段階の金融ツール利用 |
| CyberGym | ローンチ記事の本文では82% | 脆弱性の発見と検証 |
これらはローンチ記事にあるベンダー報告値で、この場で再現したテストではありません。本文ではCyberGymを82%に丸めています。表示精度の違いを独立した証拠と見なさないでください。この表には、完全な再現用資料、信頼区間、あらゆるクライアントとeffortレベルを統制した比較がありません。これらのスコアは試用の根拠になりますが、一律の置き換えを判断する根拠にはなりません。
独立した分析比較として、PlotlyはM3.1 Flash、Claude Opus 5.5、Gemini 4 Argon、GPT-6 Solを41/43、GLM 5.3 FlashとQwen 3.8 27Bを38/43と報告しています。43問での同点だけでは、一般的な同等性は証明できません。他の候補モデル系列については、DeepSeek V4.1 Flashの概要とGLM Flashの解説を参照し、現在のエンドポイントを確認して同じタスクセットを実行してください。
試す価値のある3つの強み
計算を検証できるバックグラウンド分析
Plotlyが隠されたパターンを見つけた結果は、別の作業中に実行できる分析でリリース版を試す理由になります。有用な出力は、確認可能なクエリと結果テーブルです。計算を検証できる分析担当者なら、より広く調べるために長く待つ選択をするかもしれません。すぐ回答が必要な人は、同じ証拠から異なる結論に至る可能性があります。
ツールのコンテキストを繰り返す場合の低料金
公表料金に基づく仮定では、キャッシュされていない入力が200,000トークン、課金対象の出力が20,000トークンの実行は、ツールなどの追加料金を除いて$0.042です。これは計算上の数字で、タスク料金の実測値ではありません。同じ実行で出力が100,000トークンなら、トークン費用は$0.09になります。画面上の回答が短くても、推論の深さと再試行によって請求額は変わります。
キャッシュ済み入力は別料金です。繰り返したプロンプトすべてにキャッシュ料金を当てはめず、利用記録で実際のキャッシュヒットを確認してください。MiniMaxが主張するエージェントタスク全体での70%のコスト削減は、すべての作業やサブスクリプションに普遍的な割引があるという意味ではありません。
既存の連携環境でeffortを調整できる
呼び出しガイドには、Anthropic互換とOpenAI互換のリクエスト形式が記載されています。開発者は周辺アプリを作り直さずに、実用的な評価を進められます。まずクライアントが output_config.effort または reasoning_effort を正しく送信し、ターン間でツール結果を保持しているか確認してください。次に、同じ合格基準で低いeffort設定と max を比較します。低いeffortで品質が同じという保証はなく、検証すべき仮説です。
推奨を左右する3つの制約
推論を完全には無効化できない
短い情報抽出だけを求める場合でも、適応型thinkingモデルが使われます。effortを下げれば推論を減らせますが、非thinkingモードにはなりません。最終結果、総使用量、経過時間、ツール呼び出しを記録してください。トークン速度だけを見ると、役に立たないほど長い対話を見落とす可能性があります。Gemini 3.8 Flashのレビューは、このモデルの直接的な性能順位ではなく、ワークフローを基準に比較する枠組みを示しています。
説明が正しく見えても、作業を間違えることがある
出典のない「モデルは信頼できない」という主張より、PlotlyのSQLで除算が抜けた事実の方が対策に結びつきます。生成された数式やコードを直接確認してください。情報抽出では、固定したサンプルを原文と照合します。コードでは修正前に失敗するテストがあり、修正後に合格することを求めます。受け入れ可能なタスクの費用には、レビュアーの作業も含まれます。
バージョンとアクセスの違いで初期報告が複雑になる
Previewの購読者、匿名の無料エンドポイントを使ったユーザー、一般公開APIのユーザーでは、異なるビルドやツールが使われた可能性があります。ウェイトの公開状況も別途確認が必要です。APIの一覧から、導入可能なライセンスがあると推測しないでください。同様に、Webサイトのモデルページがあるだけでは、今日特定のTabbitアカウントでそのモデルを選べる証拠になりません。
コミュニティの声:バージョンに注意して活用する
Previewへの好意的な評価とベンチマークを擁護する意見
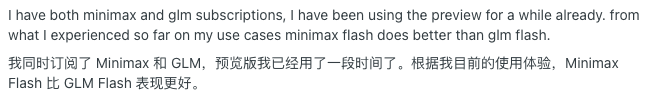
Sovairon、10月19日は、MiniMaxのサブスクリプション利用ではGLM FlashよりFlashを高く評価したと述べています。続くコメントで、MiniMax 3.1 Flash Previewだと明記しました。作業内容と採点方法は公開されていません。この報告が裏付けるのはPreviewに対する主観的な好みであり、一般公開版が実測で勝ったという結論ではありません。
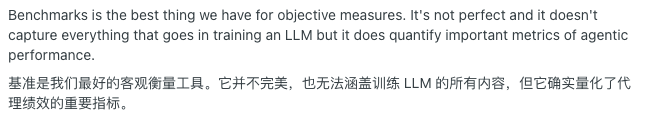
ApprehensiveDelay238、10月19日は、ベンチマークは不完全でもエージェント性能を測る有用な指標だと擁護しました。これは方法論に関する意見で、タスクを完了した報告ではありません。期待外れのセッションが一度あっただけですべての公表スコアを退ける考えへの、有用な反論です。
推論ループの報告と対立する好み
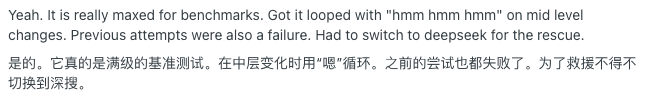
Pepek91、10月20日は、中程度の複雑さの変更で推論が繰り返され、DeepSeekに切り替えたと報告しました。正確なエンドポイント、effort設定、リポジトリは明らかにされていません。失敗率の推定ではなく、自分の試用に含める失敗パターンとして扱ってください。
RepulsiveRaisin7、10月19日はGLM Flashを好み、ベンチマークをめぐる説明に疑問を呈しました。コメントにはタスクの記録が添えられていません。Sovaironの好みとは異なるため、これらの報告をまとめて勝者数を出せない理由が分かります。
実務上は、推論ループを試し、バージョンを区別し、ベンチマークを複数ある証拠の1つとして残すのが妥当です。これらの投稿から、今後の成功率は分かりません。
結論は作業内容によって変わる
| 作業内容 | 推奨 | 合格確認 |
|---|---|---|
| レビュー付きのバックグラウンド分析 | M3.1 Flashを候補にする | SQLを再実行し、単位と集計値を確認する |
| 対話的な情報抽出や即答 | 切り替える前にeffortを比較する | 経過時間と正しい出力を測る |
| 難しいリポジトリの変更 | 現行モデルを対照にする | 同じ課題、テスト、ツール権限を使う |
| 人の監督なしで行う外部アクション | このスコアだけで承認しない | まず復旧手順とアクションの境界を検証する |
| 今すぐセルフホストが必要 | 実際のウェイトとライセンスを確認する | APIアクセスでは要件を満たさない |
| Tabbitでのブラウザー調査 | テスト前に選択画面を確認する | M3の選択肢はM3.1 Flashではない |
レビューを前提とするバックグラウンド作業では、精度向上が待ち時間に見合うかもしれません。素早いやり取りでは、報告された3分の中央値を踏まえ、移行前に慎重に測定してください。すべてのコーディングモデルを置き換えたり、人の確認をなくしたりする根拠はありません。
利用可否を確認してからTabbitにワークフローを組み込む
Tabbitは、ブラウザー作業を評価する際に使うソースページや会話を整理できます。製品の説明と使い方のポイントでワークフローを紹介しています。これだけでは、TabbitがMiniMaxのAPI effort設定を公開していることや、すべてのプランでこのモデルを提供していることは確認できません。
確認したテストアカウントではM3.1 Flashを選べなかったため、この記事にはTabbit上でのモデル実測がありません。M3.1 Flashのリソースページ (English)にある出典付き設定情報を使い、自分の選択画面で正確な表示名を確認してください。表示されない場合は、モデル試用にMiniMax公式対応クライアントを使います。M3を代わりに使って、出力をM3.1 Flashの結果として扱わないでください。
有用な試用タスクとして、ローンチ記事と呼び出しガイドを開き、料金とeffortの既定値を出典付きの表にまとめ、確認済みの事実と不明点を分ける方法があります。すべてのセルを原ページと照合してください。アカウントの地域、クライアントのバージョン、表示されたモデル、ツールの表示、プロンプト、スクリーンショットを記録します。これは提案するテストであり、このレビューで完了した実験ではありません。
まずは1つの統制されたタスクを行い、現行モデルを基準として比較してください。以下のCTAはブラウザーワークフロー用のTabbitをダウンロードするもので、M3.1 Flashの利用やAPIの無料使用を保証しません。
 Tabbit Browser

よくある質問
MiniMax M3.1 Flashとは何ですか?
MiniMaxが2026年10月19日に一般公開した、コーディングとエージェント向けモデルです。API識別子はMiniMax-M3.1-Flashで、公式資料のコンテキスト長は1,000,000トークンです。
推論を無効にできますか?
できません。公式ガイドでは5段階のeffortに対応し、省略時はmaxになります。無効化やnoneの指定は400エラーになります。
API料金はいくらですか?
10月21日に確認した100万トークンあたりの料金は、入力$0.15、出力$0.60、キャッシュ済み入力$0.015です。実際の費用は使用量、推論、キャッシュ、ツール、再試行に左右されます。
Space Bunnyより速く正確ですか?
Plotlyの分析テストでは正答数が38/43から41/43に増えました。一方、1問あたりの時間の中央値は36秒から3分に延びたため、作業が速く終わる証拠にはなりません。
セルフホスト用のウェイトは公開されていますか?
ローンチ記事では後日公開とされています。導入前に実ファイルとライセンスを確認してください。APIへの掲載はダウンロード可能なウェイトの存在を証明しません。
TabbitでM3.1 Flashを選べますか?
アカウント、地域、現在のモデル選択画面によって異なります。今回確認したテストアカウントには表示されず、Tabbit内での性能結果は示していません。