
Muse Spark Open es el primer modelo de pesos abiertos de la familia Muse de Meta: 816 mil millones de parámetros, 42 mil millones activos, una ventana de contexto de un millón de tokens y entrada nativa de texto, imagen, audio y video. Meta lo publicó el 15 de octubre de 2026 con los pesos en Hugging Face y APIs en siete plataformas, y lo llamó "el modelo de pesos abiertos estadounidense más capaz hasta la fecha". La primera pregunta práctica de la mayoría no fue sobre benchmarks. Como escribió un comentarista de Hacker News, Meta sugiere "un par de Mac Studio con chips M5 Ultra y 512GB de RAM. Una sola Mac Studio con M5 Ultra y la mitad de RAM (256GB) cuesta unos 11.000 dólares, y la opción de 512GB ni siquiera está disponible todavía. Así que... sí." (discusión en HN)
Este artículo hace la matemática del hardware, lee la Muse Model License línea por línea, verifica el precio de lanzamiento de la API y los benchmarks independientes, y lo compara con GLM 5.3 y Kimi K3 con la misma vara. Más adelante veremos la tercera vía: usar un modelo así a través de un producto en lugar de un cuarto de servidores.
Puntos clave
Muse Spark Open es la versión de pesos abiertos de Muse Spark de Meta: MoE disperso de 816B totales / 42B activos, contexto de 1.048.576 tokens, entrada multimodal y salida de texto, pensado para código y trabajo agéntico.
El número que importa: cada token toca 42B de parámetros, pero servirlo carga los 816B completos — unos 1,65TB en BF16 o 537GB en NVFP4, más la caché.
"Local" significa dos Mac Studio M5 Ultra de 512GB con MLX, o un nodo Blackwell de 4 GPUs para NVFP4. Los equipos de consumo quedan fuera; una sola Mac Studio de 256GB ronda los 11.000 dólares.
La Muse Model License permite uso comercial pero no es open source: la etiqueta "Built with Muse Spark Open" es obligatoria, y los servicios de modelo por encima de 20M de dólares en 12 meses necesitan un acuerdo aparte con Meta.
Lectura independiente (Artificial Analysis, 19 de octubre de 2026): Intelligence Index 39, 142 tokens de salida por segundo, unos 0,84 dólares por tarea del Index — rápido y bastante conciso, pero caro frente a modelos de pesos abiertos similares, y por detrás de GLM 5.3 (45) y Kimi K3 (44).
El precio de lanzamiento en proveedores ronda 1,25/M de entrada, 4,25/M de salida y unos 0,15/M en lecturas de caché, incluidos Together AI, Fireworks, Baseten, Modal y OpenRouter.
Muse Spark Open de un vistazo
| Elemento | Detalle | Fuente |
|---|---|---|
| Lanzamiento | 15 de octubre de 2026, Meta Superintelligence Labs | Blog de investigación de Meta |
| Parámetros | 816B totales, 42B activos por token; MoE disperso con 256 expertos y 8 seleccionados por token (cifras de la model card) | Documentación para desarrolladores |
| Contexto | 1.048.576 tokens | Documentación de Meta |
| Entrada / salida | Texto, imagen, audio y video de entrada; texto de salida | Documentación de Meta |
| Checkpoints | BF16 ≈ 1,65TB (8 GPUs, p. ej. 8×B300); NVFP4 ≈ 537GB (un nodo Blackwell de 4 GPUs) | Documentación de Meta |
| Ejecución local | Dos Mac Studio M5 Ultra (512GB de memoria unificada cada una) con MLX; unos 2TB de VRAM para BF16 con caché KV | Blog y documentación de Meta |
| API alojada | Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter, Together AI | Blog de Meta |
| Canales de pesos | Hugging Face, Amazon SageMaker AI, Google Cloud Model Garden, Microsoft Foundry Models | Blog de Meta |
| Licencia | Muse Model License (personalizada, comercial con condiciones) + Política de Uso Aceptable | Documentación de Meta |
| Posicionamiento | Código, tareas agénticas de largo horizonte, razonamiento multietapa | Blog de Meta |
El número clave: 42B activos, 816B en la factura
Todos los titulares abren con 816 mil millones de parámetros. El número que decide si puedes usarlo es el otro: 42 mil millones activos. Muse Spark Open es un modelo disperso de mezcla de expertos — cada token se enruta a 8 de 256 expertos por capa — así que el cómputo por token sigue a los 42B activos. Por eso la latencia y el coste por tarea lucen bien.
Pero la dispersión no reduce el modelo que debes alojar. La propia documentación de Meta lo dice sin ambages: servirlo "carga los 816B completos en VRAM, lo que fija la huella de hardware". El checkpoint BF16 son unos 1,65TB de pesos y, sumando la caché KV, activaciones y sobrecarga, Meta recomienda presupuestar unos 2TB de VRAM — ocho GPUs de datacenter como las B300. El checkpoint NVFP4, con la mayoría de pesos en 4 bits, baja a unos 537GB y cabe en un solo nodo Blackwell de 4 GPUs.
La historia de escritorio es la pieza central del lanzamiento. La memoria unificada de Apple permite a una Mac Studio M5 Ultra direccionar hasta 512GB, y dos unidades encadenadas por Thunderbolt se comportan, en palabras de Meta, "como un superordenador con un terabyte de memoria unificada", con 1,2TB/s de ancho de banda para alimentar la pequeña porción activa de cada token. Meta demostró flujos agénticos completamente en el dispositivo — enviando cambios reales al cliente de Mastodon Ice Cubes y conduciendo DaVinci Resolve fotograma a fotograma.
Dos matices mantienen esto honesto. Primero, el hardware aún no se vende por completo: a 19 de octubre de 2026, la Mac Studio M5 Ultra de 512GB no estaba a la venta y su precio no se había anunciado; un comentarista de HN calculó unos 11.000 dólares por una unidad de 256GB, y TechRepublic cifró un conjunto de cuatro máquinas de 256GB por encima de 38.000 dólares. Segundo, un comentarista que resumía el post de Apple Research sobre MLX reportó un clúster de cuatro Mac Studios generando "más de 36 tokens por segundo" — usable para trabajo agéntico, lejos de la velocidad de un datacenter. (HN: coste del hardware, HN: rendimiento de MLX)
El veredicto de la comunidad sobre las ejecuciones locales fue directo: "Me equivoqué al pensar que los modelos abiertos se pueden cuantizar para correr en hardware de consumo medio; creo que han superado ese concepto." (HN) Si tu equipo tiene 32 o 64GB de RAM, este modelo no está a un clic de distancia. Las APIs alojadas son la puerta realista.
Qué es y qué no es
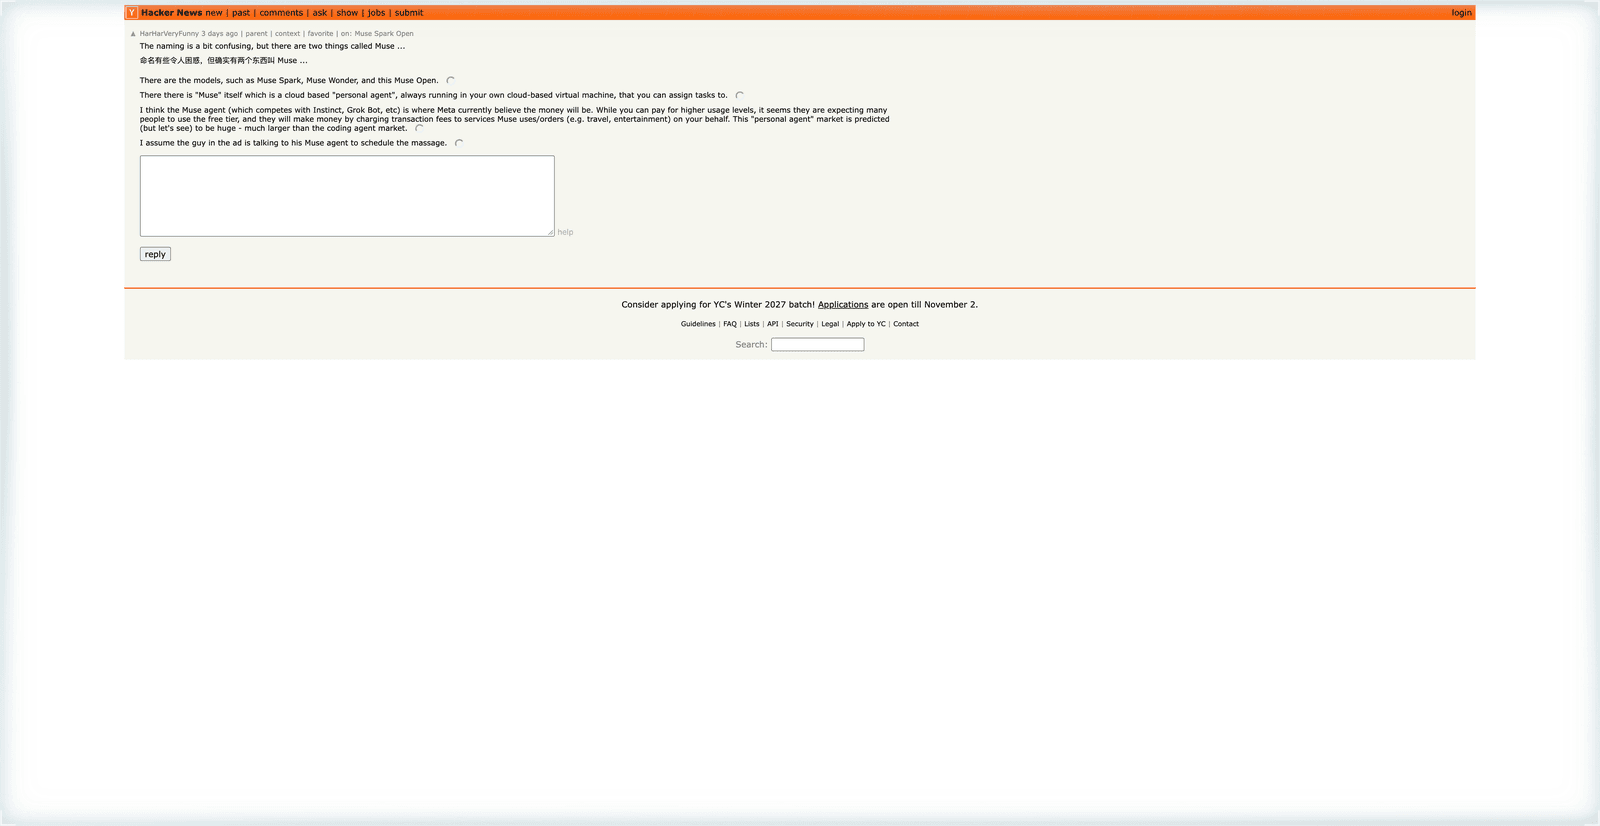
La nomenclatura de Muse confunde de verdad, y la comunidad lo dijo el primer día: "La nomenclatura es un poco confusa, pero hay dos cosas llamadas Muse... Están los modelos, como Muse Spark, Muse Wonder y este Muse Open. Y luego está 'Muse' en sí, que es un 'agente personal' en la nube." (HN)
La versión limpia:
Muse Spark es la línea de modelos alojados que debutó el 8 de abril de 2026 — la primera familia de modelos propietarios de Meta tras la era Llama. Las versiones 1.1 (julio), 1.2 y 1.3 (septiembre) permanecieron cerradas y se sirven a través de la API de Meta y Muse Code a 1,25/M de entrada y 4,25/M de salida.
Muse Wonder, lanzado el 12 de octubre de 2026, es el buque insignia cerrado por encima de Spark, listado a 4/M de entrada y 20/M de salida. La propia Meta no afirma que Spark Open supere a Wonder.
Muse Spark Open es de lo que trata este artículo: el hermano descargable de la línea Spark, con el mismo contexto de 1M y entrada multimodal, bajo licencia personalizada.
La app Muse es un producto de agente de consumo, sin relación con los pesos.
Benchmarks: rápido, conciso y caro para ser de pesos abiertos
La página independiente de Artificial Analysis para Muse Spark Open (ajuste de razonamiento xhigh), consultada el 19 de octubre de 2026:
| Métrica | Muse Spark Open | Lectura |
|---|---|---|
| Intelligence Index | 39 (~puesto 10 de 120 en su clase de pesos abiertos; mediana de clase 19) | Por encima de la mediana, por detrás de los líderes chinos |
| Velocidad de salida | 142,2 tokens/s (mediana entre proveedores) | Notablemente rápido para su clase (mediana ~78) |
| Tiempo al primer token | 0,81 s | Competitivo |
| Precio de lista | 1,25/M entrada, 4,25/M salida, 88% de descuento en caché | "En el extremo alto" para pesos abiertos |
| Coste por tarea del Index | ~0,84 dólares | Fuerte, gracias a la salida concisa |
| Verbosidad | 110M de tokens de salida en todo el Index | Bastante conciso (mediana de clase ~130M) |
El resumen de AA merece cita: "entre los líderes en inteligencia, pero particularmente caro comparado con otros modelos de pesos abiertos de tamaño similar. También es notablemente rápido y bastante conciso." Dos notas de calibración. Primero, el Index (v4.3.2) mezcla diez evaluaciones incluyendo agentic y contexto largo; 39 no es una nota de examen único. Segundo, los precios son medianas de proveedores, no precio oficial de Meta — la API propia de Meta no aloja la variante de pesos abiertos. Si eliges modelo para flujos agénticos de navegación y código, combina esto con nuestra guía de navegación agéntica en lugar de un único número de tabla.
La licencia no es open source
"Pesos abiertos" está haciendo mucho trabajo en los titulares. Puedes descargar Muse Spark Open, ajustarlo, destilarlo e integrarlo en productos comerciales. Pero la Muse Model License es una licencia personalizada, no aprobada por OSI, y sus condiciones son más estrictas que Apache 2.0 o MIT:
Atribución, siempre. Todo producto que use el modelo o un derivado debe mostrar "Built with Muse Spark Open" en la interfaz, documentación, sitio web o ajustes. Esta cláusula no tiene piso de ingresos.
Puerta de Modelo como Servicio. Si tú y tus afiliados superáis 20 millones de dólares de ingresos brutos agregados en cualquier período de 12 meses consecutivos y ofrecéis el modelo a terceros vía API, debéis notificarlo a Meta y firmar un acuerdo escrito aparte. El uso interno, la investigación y las funciones dentro de tu propio producto quedan expresamente fuera.
Política de Uso Aceptable. La licencia incluye una AUP que prohíbe desarrollo de armas, malware, operación de infraestructura crítica, fraude, desinformación e suplantación, y el modelo no está destinado a menores de 18 años.
Salidas. Meta no reclama derechos sobre lo que el modelo genera — la cláusula más limpia de todas.
Fricción de descarga. Descargar los pesos de Hugging Face exige aceptar campos de identidad — nombre legal, fecha de nacimiento y datos de empresa — una barrera de registro, no un clic.
Si quieres un modelo de pesos abiertos genuinamente permisivo en esta clase, la licencia estilo MIT de GLM 5.3 es el punto de comparación; lo desarrollamos en la sección comparativa.
Cómo conseguirlo
API alojada (sin hardware): Baseten, Fireworks AI, Groq, Modal, Nebius y Together AI lo sirven directamente; OpenRouter lo lista como ruta de pasarela. El precio de lanzamiento ronda 1,25/M de entrada, 4,25/M de salida y unos 0,15/M en lecturas de caché — igual que el Muse Spark 1.2 alojado, lo que sugiere que Meta fijó el ancla y los proveedores lo igualaron.
Autoalojamiento en GPU: descarga BF16 (~1,65TB) para nodos de ocho GPUs, o NVFP4 (~537GB) para un nodo Blackwell de 4 GPUs. Meta incluye kernels Helion autoajustables en SGLang con aceleraciones de 1,03–3,95× a nivel de kernel en NVIDIA y AMD, más un 3% de mejora de extremo a extremo en AMD MI350. vLLM, TensorRT-LLM, llama.cpp y Unsloth están soportados desde el día uno.
Autoalojamiento en Mac: dos Mac Studio M5 Ultra con 512GB cada una vía MLX, con los pesos directamente desde Hugging Face. Apple Research documentó aparte un clúster de cuatro Macs superando los 36 tok/s.
Catálogos en la nube: Amazon SageMaker AI, Google Cloud Model Garden y Microsoft Foundry Models ofrecen los pesos para equipos que quieren infraestructura gestionada.
La amplitud de despliegue es inusual para un lanzamiento de pesos abiertos, y la comunidad lo notó: "Hicieron el trabajo real de probar y documentar despliegues en varias plataformas. Es elevar un poco el listándar de los pesos abiertos en vez de soltar el binario y dejar que la comunidad se las arregle." (HN)
Comparación con GLM 5.3 y Kimi K3
El encuadre de "campeón estadounidense de pesos abiertos" solo significa algo frente a los modelos abiertos chinos que han dominado esta tabla todo el año. Cifras comparables (datos de Artificial Analysis compilados el 16 de octubre de 2026; verifica antes de presupuestar):
| Dimensión | Muse Spark Open | GLM 5.3 | Kimi K3 |
|---|---|---|---|
| Fabricante | Meta (EE. UU.) | Z.ai (China) | Moonshot AI (China) |
| Parámetros | 816B totales / 42B activos | 753B / 40B | 2,8T / 104B |
| Entrada | Texto, imagen, audio, video | Texto | Texto, imagen |
| Intelligence Index | 39 | 45 | 44 |
| Velocidad de salida | 142 tok/s | 67 tok/s | 43 tok/s |
| Coste por tarea del Index | 0,84$ | 2,01$ | 2,00$ |
| Precio API ($/M entrada/salida) | 1,25 / 4,25 | 1,40 / 4,40 | 3,00 / 15,00 |
| Licencia | Muse Model License (etiqueta + puerta MaaS de 20M$) | Estilo MIT (condiciones cerca de 10B$) | Personalizada (puerta MaaS similar de 20M$) |
| La principal pega | Memoria de clase terabyte para autoalojar; etiqueta obligatoria | Solo entrada de texto | Precio de lista más alto de los tres |
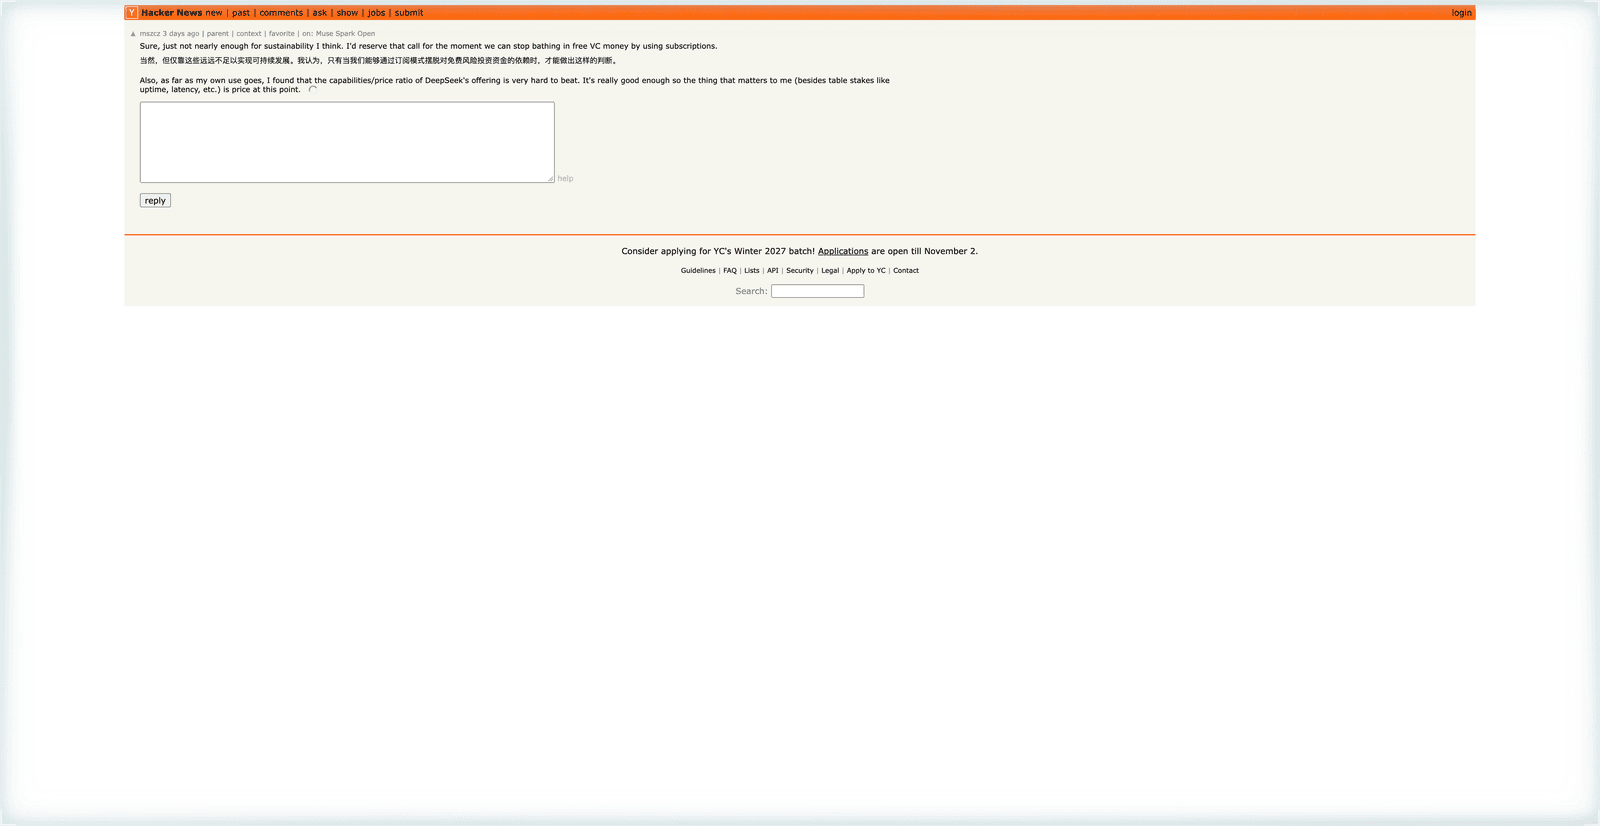
El compromiso es claro. Muse Spark Open queda por detrás de ambos rivales en el Intelligence Index, pero los desploma en coste por tarea terminada — escribe menos para llegar al resultado — y es el único con entrada nativa de audio y video. Un comentarista de HN lo formuló acorde con los datos: "la relación capacidad/precio de la oferta de DeepSeek es muy difícil de superar... lo que me importa (aparte de lo básico como disponibilidad y latencia) es el precio a estas alturas." (HN)
Si tu criterio es el rango absoluto del Index, no es el líder; si importa más el coste por tarea aceptada con entrada multimodal, compite.
Para contexto sobre cómo la elección de modelo interactúa con la capa de herramientas, ver nuestras tomas sobre Qwen3.8 Max, MiniMax M3 y LongCat 2.0 — cada una apostó diferente en la misma carrera de pesos abiertos.
Qué dice la gente
El hilo de lanzamiento en Hacker News (917 puntos, unos 478 comentarios a 19 de octubre) mezcló entusiasmo y escepticismo sobre el hardware:
"Me encanta ver a los grandes laboratorios de IA publicar modelos de pesos abiertos; espero ver más de esto de OpenAI y eventualmente de Anthropic." — shinokami (traducción propia)
"Me equivoqué al pensar que los modelos abiertos se pueden cuantizar para correr en hardware de consumo medio; creo que han superado ese concepto." — twitexplore (traducción propia)
"¿Alguien ha probado una versión menor/cuantizada localmente en Apple Silicon? Me encantaría saber tu experiencia, y tok/s con qué hardware." — nico (traducción propia). A fecha de escritura, el hilo tiene más preguntas que informes locales de primera mano — trata cualquier afirmación de rendimiento sin detalles de hardware como no verificada.
El r/LocalLLaMA de Reddit empezó a llenar ese hueco en cuestión de días. Un usuario que ejecuta el modelo en un único Mac Studio reportó alcanzar 18 t/s de decodificación: "This is text only. Output is coherent and toolcalls solid." (r/LocalLLaMA) Otro hilo transversal de la misma semana lo resumió sin anestesia: "'Runs locally' now officially means 'runs on a computer that costs more than a car.'" (r/LocalLLaMA)
Una tercera vía: usarlo a través de un producto, no de un cuarto de servidores
Esta es la decisión que la mayoría de lectores realmente enfrentan. No tienes 22.000–40.000 dólares en Mac Studios sobre tu escritorio, ni quieres operar ocho GPUs de datacenter. Pero tu trabajo —investigación, código, tareas de navegador— sí podría usar un modelo abierto de clase frontera con 1M de contexto. Ese hueco lo llenan las APIs alojadas y los clientes nativos de IA.
Aquí encaja un navegador como Tabbit Browser. El patrón práctico para un modelo como Muse Spark Open no es el autoalojamiento; es elegirlo (o a un modelo agéntico comparable) en un cliente que ya sostiene tu contexto —la página que tienes delante, un grupo de pestañas, un archivo— y ponerlo a trabajar mediante navegación agéntica o automatización de navegador en lugar de reconstruir cada tarea en un chat aparte.
Dos límites honestos. Primero, no hemos confirmado Muse Spark Open en el selector de modelos en vivo de Tabbit; el modelo tiene tres días, la disponibilidad cambia rápido, así que comprueba el selector antes de planificar en torno a él. Si quieres un modelo ya probado en este flujo, la ruta con GLM-5.2 y la historia multimodal de GLM-5.3-Flash son ejemplos funcionales del mismo patrón. Segundo, el autoalojamiento sigue ganando en control de datos y coste unitario a escala — la tercera vía cambia eso por cero hardware y cero operaciones. Para un panorama de clientes, ver nuestra comparación de navegadores IA.
 Tabbit Browser
Veredicto
Muse Spark Open es un lanzamiento de pesos abiertos creíble y bien ingenierizado cuyo titular esconde una decisión binaria. Si puedes permitirte el terabyte, obtienes un modelo agéntico rápido, conciso y multimodal con ejecuciones documentadas en MLX, SGLang y vLLM, bajo una licencia comercialmente amable para todos excepto los grandes revendedores de MaaS. Si no puedes —y casi ningún individuo puede todavía— la respuesta honesta es la ruta alojada de 1,25/4,25, donde compite con GLM 5.3 y Kimi K3 en coste por tarea y no en rango absoluto del Index.
| Tu situación | Primer paso |
|---|---|
| Desarrollador individual, sin hardware grande | Prueba la API alojada a 1,25/4,25 en una tarea fija de código o investigación; compara la salida aceptada con GLM 5.3 antes de migrar |
| Equipo que necesita control de datos | Precio un nodo NVFP4 de 4 GPUs Blackwell o un par de Mac Studio frente a un año de gasto de API con tu volumen real |
| Constructor de productos | Lanza con la etiqueta "Built with Muse Spark Open" prevista desde el día uno; si vas a superar la línea de 20M$ en MaaS, habla con Meta pronto |
| Usuario de flujos de navegador/agentes | Úsalo (o un modelo comparable) a través de un cliente que ya sostiene tu contexto de página — ver la tercera vía arriba |
| Cazador de benchmarks | Espera una replicación independiente más amplia; una instantánea de AA y un hilo de HN de semana de lanzamiento no son consenso |
Un número para recordar: 42 mil millones de parámetros activos es por lo que este modelo se siente rápido y asequible por tarea. 816 mil millones en total es por lo que no cabe en tu escritorio.
Fuentes
Blog de investigación de Meta: Introducing Muse Spark Open (15-10-2026)
Documentación de Meta: Muse Spark Open (consultado el 19-10-2026)
Artificial Analysis: Muse Spark Open (Xhigh) (consultado el 19-10-2026)
Hilo de lanzamiento en Hacker News y páginas de comentarios enlazadas (consultado el 19-10-2026)
TechRepublic: Meta unveils Muse Spark Open (16-10-2026)
TrendingTopics: Meta's Muse Spark Open comes with strings attached (16-10-2026)
Flavio Copes: what you can run, and what it takes (16-10-2026)
Comparación Muse Spark Open vs GLM 5.3 vs Kimi K3 (16-10-2026, compilación de datos de AA)

Preguntas frecuentes
¿Qué es Muse Spark Open?
Muse Spark Open es la versión de pesos abiertos de Muse Spark de Meta, lanzada el 15 de octubre de 2026 por Meta Superintelligence Labs. Es un modelo disperso de mezcla de expertos con 816B de parámetros totales y 42B activos por token, una ventana de contexto de 1.048.576 tokens y entrada nativa de texto, imagen, audio y video con salida de texto. Meta lo posiciona para trabajo de código y agentes y lo llama el modelo de pesos abiertos estadounidense más capaz hasta la fecha.
¿Muse Spark Open es open source?
No. Los pesos se pueden descargar, pero se publican bajo la Muse Model License de Meta, una licencia personalizada no aprobada por OSI. Permite uso comercial, fine-tuning y redistribución, pero exige mostrar el aviso 'Built with Muse Spark Open' en el producto, y quien ofrezca el modelo como servicio con más de 20 millones de dólares de ingresos en 12 meses consecutivos debe notificar a Meta y firmar un acuerdo aparte.
¿Qué hardware necesito para ejecutar Muse Spark Open localmente?
El modelo completo requiere cerca de un terabyte de memoria. Meta y Apple lo optimizaron para dos Mac Studio M5 Ultra con 512GB de memoria unificada cada uno ejecutando MLX; el checkpoint BF16 pesa unos 1,65TB y se sirve en ocho GPUs de datacenter, mientras que el NVFP4 de 537GB cabe en un nodo Blackwell de 4 GPUs. Con la caché KV incluida, presupuesta unos 2TB de VRAM para BF16.
¿Cuánto cuesta la API de Muse Spark Open?
El precio de lanzamiento en proveedores como Together AI, Fireworks, Baseten, Modal y OpenRouter ronda 1,25 dólares por millón de tokens de entrada y 4,25 de salida, con unos 0,15 por millón en lecturas de caché. Artificial Analysis midió una mediana de 142 tokens de salida por segundo y unos 0,84 dólares por tarea del Intelligence Index el 19 de octubre de 2026.
¿Cómo se compara Muse Spark Open con GLM 5.3 y Kimi K3?
Según Artificial Analysis, Muse Spark Open obtiene 39 en el Intelligence Index frente a 45 de GLM 5.3 y 44 de Kimi K3, pero genera más rápido y completó el Index a unos 0,84 dólares por tarea frente a unos 2,00 de ambos rivales. Sus contras son una licencia más estricta con etiqueta obligatoria, una descarga con registro y la mayor huella de memoria para autoalojamiento de los tres.
¿Muse Spark Open es lo mismo que Muse Wonder o la app Muse?
No. Muse Wonder es el modelo cerrado más capaz de Meta, lanzado el 12 de octubre de 2026 y listado a 4 dólares de entrada y 20 de salida por millón de tokens. La app Muse es un producto separado de agente personal en la nube. Muse Spark Open es el hermano descargable de la línea Muse Spark alojada que debutó en abril de 2026.