
Muse Spark Open est le premier modèle à poids ouverts de la famille Muse de Meta : 816 milliards de paramètres, 42 milliards actifs, une fenêtre de contexte d'un million de tokens et une entrée native texte, image, audio et vidéo. Meta l'a publié le 15 octobre 2026 avec les poids sur Hugging Face et des API sur sept plateformes, le qualifiant de « modèle à poids ouverts américain le plus capable à ce jour ». La première question pratique de la plupart des gens ne portait pas sur les benchmarks. Comme l'a écrit un commentateur de Hacker News, Meta suggère « une paire de Mac Studio avec puces M5 Ultra et 512 Go de RAM. Un seul Mac Studio M5 Ultra avec la moitié de cette RAM (256 Go) coûte environ 11 000 dollars, et l'option 512 Go n'est même pas encore disponible. Alors... ouais. » (discussion HN)
Cet article fait le calcul matériel, lit la Muse Model License ligne par ligne, vérifie le prix de lancement de l'API et les benchmarks indépendants, et compare le modèle à GLM 5.3 et Kimi K3 à la même échelle. Plus loin, nous verrons la troisième voie : utiliser un tel modèle à travers un produit plutôt qu'une salle de serveurs.
Points clés
Muse Spark Open est la version à poids ouverts de Muse Spark : MoE sparse à 816B total / 42B actifs, contexte de 1 048 576 tokens, entrée multimodale et sortie texte, conçu pour le codage et le travail agentique.
Le nombre qui compte : chaque token touche 42 milliards de paramètres, mais le service charge les 816 milliards complets — environ 1,65 To en BF16 ou 537 Go en NVFP4, plus le cache.
« Local » signifie deux Mac Studio M5 Ultra de 512 Go sous MLX, ou un nœud Blackwell à 4 GPU pour le NVFP4. Les machines grand public sont exclues ; un seul Mac Studio de 256 Go coûte environ 11 000 dollars.
La Muse Model License autorise l'usage commercial mais n'est pas open source : la mention « Built with Muse Spark Open » est obligatoire, et les offres de modèle en service au-delà de 20 millions de dollars sur 12 mois exigent un accord séparé avec Meta.
Lecture indépendante (Artificial Analysis, 19 octobre 2026) : Intelligence Index 39, 142 tokens de sortie par seconde, environ 0,84 dollar par tâche de l'Index — rapide et assez concis, mais cher comparé aux modèles à poids ouverts de taille similaire, et derrière GLM 5.3 (45) et Kimi K3 (44).
Le prix de lancement chez les fournisseurs avoisine 1,25/M d'entrée, 4,25/M de sortie et environ 0,15/M en lectures de cache, notamment chez Together AI, Fireworks, Baseten, Modal et OpenRouter.
Muse Spark Open en bref
| Élément | Détail | Source |
|---|---|---|
| Lancement | 15 octobre 2026, Meta Superintelligence Labs | Blog recherche de Meta |
| Paramètres | 816B au total, 42B actifs par token ; MoE sparse avec 256 experts et 8 sélectionnés par token (chiffres de la model card) | Documentation développeur |
| Contexte | 1 048 576 tokens | Documentation Meta |
| Entrée / sortie | Texte, image, audio et vidéo en entrée ; texte en sortie | Documentation Meta |
| Checkpoints | BF16 ≈ 1,65 To (8 GPU, p. ex. 8×B300) ; NVFP4 ≈ 537 Go (un nœud Blackwell à 4 GPU) | Documentation Meta |
| Exécution locale | Deux Mac Studio M5 Ultra (512 Go de mémoire unifiée chacun) avec MLX ; environ 2 To de VRAM pour le BF16 avec cache KV | Blog recherche et documentation Meta |
| API hébergée | Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter, Together AI | Blog de Meta |
| Canaux de poids | Hugging Face, Amazon SageMaker AI, Google Cloud Model Garden, Microsoft Foundry Models | Blog de Meta |
| Licence | Muse Model License (personnalisée, commerciale avec conditions) + Acceptable Use Policy | Documentation Meta |
| Positionnement | Codage, tâches agentiques de long terme, raisonnement multi-étapes | Blog de Meta |
Le nombre clé : 42B actifs, 816B sur la facture
Tous les titres mènent avec 816 milliards de paramètres. Le nombre qui décide de votre usage est l'autre : 42 milliards actifs. Muse Spark Open est un modèle sparse de mixture d'experts — chaque token est routé vers 8 des 256 experts par couche — donc le calcul par token suit les 42B actifs. C'est pourquoi la latence et le coût par tâche ont l'air bons.
Mais la sparsité ne réduit pas le modèle à héberger. La documentation de Meta le dit sans détour : le service « charge toujours les 816B complets en VRAM, ce qui fixe l'empreinte matérielle ». Le checkpoint BF16 représente environ 1,65 To de poids ; en ajoutant le cache KV, les activations et la surcharge d'exécution, Meta recommande de prévoir environ 2 To de VRAM — huit GPU de datacenter comme les B300. Le checkpoint NVFP4, qui stocke la plupart des poids en 4 bits, descend à environ 537 Go et tient sur un seul nœud Blackwell à 4 GPU.
L'histoire du bureau est la pièce maîtresse du lancement. La mémoire unifiée d'Apple permet à un Mac Studio M5 Ultra d'adresser jusqu'à 512 Go, et deux machines chaînées par Thunderbolt se comportent, selon les mots de Meta, « comme un superordinateur avec un téraoctet de mémoire unifiée », avec 1,2 To/s de bande passante pour nourrir la petite tranche active de chaque token. Meta a démontré des flux agentiques entièrement sur l'appareil — livrant de vraies modifications au client Mastodon open source Ice Cubes et pilotant DaVinci Resolve image par image.
Deux réserves gardent cela honnête. Premièrement, le matériel n'est pas encore vendu : au 19 octobre 2026, la Mac Studio M5 Ultra de 512 Go n'était pas commercialisée et son prix non annoncé ; un commentateur de HN a chiffré une unité de 256 Go à environ 11 000 dollars, et TechRepublic a estimé un ensemble de quatre machines de 256 Go à plus de 38 000 dollars. Deuxièmement, un commentateur résumant le billet d'Apple Research sur MLX a rapporté un cluster de quatre Mac Studios générant « plus de 36 tokens par seconde » — utilisable pour du travail agentique, loin de la vitesse d'un datacenter. (HN : coût du matériel, HN : débit MLX)
Le verdict de la communauté sur les exécutions locales était direct : « Je me trompais en pensant que les modèles ouverts pouvaient être quantifiés pour tourner sur du matériel de consommateur moyen ; je crois qu'ils ont dépassé ce concept. » (HN) Si votre machine a 32 ou 64 Go de RAM, ce modèle n'est pas à un téléchargement près. Les API hébergées sont la porte réaliste.
Ce que c'est, ce que ce n'est pas
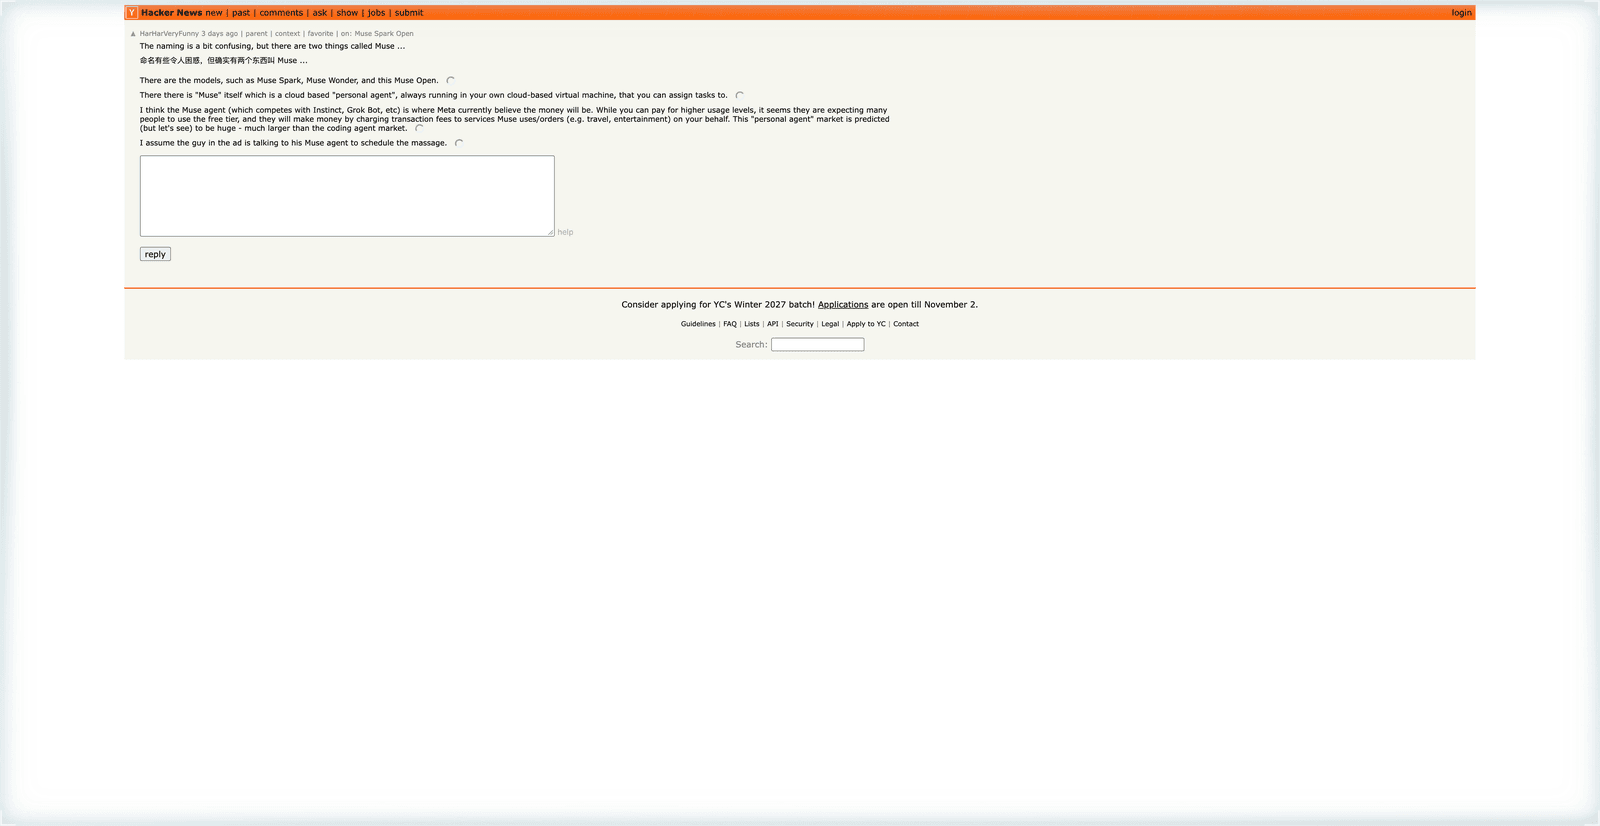
La nomenclature Muse est réellement confuse, et la communauté l'a dit dès le premier jour : « La nomenclature est un peu confuse, mais il y a deux choses appelées Muse... Il y a les modèles, comme Muse Spark, Muse Wonder et ce Muse Open. Et puis il y a « Muse » lui-même, un « agent personnel » dans le cloud. » (HN)
La version propre :
Muse Spark est la ligne de modèles hébergés apparue le 8 avril 2026 — la première famille de modèles propriétaires de Meta après l'ère Llama. Les versions 1.1 (juillet), 1.2 et 1.3 (septembre) sont restées fermées et se servent via l'API de Meta et Muse Code à 1,25/M d'entrée et 4,25/M de sortie.
Muse Wonder, lancé le 12 octobre 2026, est le fleuron fermé au-dessus de Spark, listé à 4/M d'entrée et 20/M de sortie. Meta elle-même ne prétend pas que Spark Open bat Wonder.
Muse Spark Open est le sujet de cet article : le frère téléchargeable de la ligne Spark, avec le même contexte de 1M et la même entrée multimodale, sous licence personnalisée.
L'application Muse est un produit d'agent grand public, sans rapport avec les poids.
Benchmarks : rapide, concis et cher pour du poids ouvert
La page indépendante d'Artificial Analysis pour Muse Spark Open (réglage de raisonnement xhigh), consultée le 19 octobre 2026 :
| Métrique | Muse Spark Open | Lecture |
|---|---|---|
| Intelligence Index | 39 (~rang 10 sur 120 dans sa classe à poids ouverts ; médiane de classe 19) | Au-dessus de la médiane, derrière les leaders chinois |
| Vitesse de sortie | 142,2 tokens/s (médiane entre fournisseurs) | Nettement rapide pour sa classe (médiane ~78) |
| Temps au premier token | 0,81 s | Compétitif |
| Prix de liste | 1,25/M entrée, 4,25/M sortie, remise cache 88 % | « Dans le haut du panier » pour du poids ouvert |
| Coût par tâche de l'Index | ~0,84 dollar | Solide, grâce à une sortie concise |
| Verbosité | 110M de tokens de sortie sur tout l'Index | Assez concis (médiane de classe ~130M) |
Le résumé de AA mérite d'être cité : « parmi les modèles leaders en intelligence, mais particulièrement cher comparé à d'autres modèles à poids ouverts de taille similaire. Il est aussi nettement rapide et assez concis. » Deux notes de calibration. Premièrement, l'Index (v4.3.2) mélange dix évaluations incluant des suites agentiques et de long contexte ; 39 n'est pas une note d'examen unique. Deuxièmement, les prix sont des médianes de fournisseurs, pas le prix officiel de Meta — l'API propre de Meta n'héberge pas cette variante à poids ouverts. Si vous choisissez un modèle pour des flux agentiques de navigation et de codage, croisez ce chiffre avec notre guide de la navigation agentique plutôt qu'un seul nombre de classement.
La licence n'est pas open source
« Poids ouverts » travaille dur dans les titres. Vous pouvez télécharger Muse Spark Open, le fine-tuner, le distiller et l'intégrer dans des produits commerciaux. Mais la Muse Model License est une licence personnalisée, non approuvée par l'OSI, et ses conditions sont plus strictes qu'Apache 2.0 ou MIT :
Attribution, toujours. Tout produit qui utilise le modèle ou un dérivé doit afficher « Built with Muse Spark Open » dans l'interface, la documentation, le site web ou les réglages. Cette clause n'a pas de seuil de revenus.
Porte du modèle en service. Si vous et vos affiliés dépassez 20 millions de dollars de revenus bruts agrégés sur 12 mois consécutifs et offrez le modèle à des tiers via une API, vous devez en informer Meta au préalable et signer un accord écrit séparé. L'usage interne, la recherche et les fonctionnalités dans votre propre produit en sont expressément exclus.
Politique d'usage acceptable. La licence inclut une AUP qui interdit le développement d'armes, les logiciels malveillants, l'exploitation d'infrastructures critiques, la fraude, la désinformation et l'usurpation d'identité ; le modèle ne vise pas les moins de 18 ans.
Sorties. Meta ne revendique aucun droit sur ce que le modèle génère — la clause la plus propre du lot.
Friction de téléchargement. Télécharger les poids depuis Hugging Face exige d'accepter des champs d'identité — nom légal, date de naissance, données d'entreprise — une barrière d'inscription, pas un simple clic.
Si vous voulez un modèle à poids ouverts réellement permissif dans cette classe, la licence de type MIT de GLM 5.3 est le point de comparaison ; nous le développons dans la section comparative.
Comment l'obtenir
API hébergée (sans matériel) : Baseten, Fireworks AI, Groq, Modal, Nebius et Together AI le servent directement ; OpenRouter le liste comme route passerelle. Le prix de lancement avoisine 1,25/M d'entrée, 4,25/M de sortie et environ 0,15/M en lectures de cache — le même tarif que le Muse Spark 1.2 hébergé, ce qui suggère que Meta a fixé l'ancre et que les fournisseurs l'ont suivie.
Auto-hébergement sur GPU : téléchargez le BF16 (~1,65 To) pour des nœuds à huit GPU, ou le NVFP4 (~537 Go) pour un nœud Blackwell à 4 GPU. Meta fournit des kernels Helion auto-ajustables dans SGLang annonçant des accélérations de 1,03 à 3,95× au niveau kernel sur NVIDIA et AMD, plus 3 % de bout en bout sur AMD MI350. vLLM, TensorRT-LLM, llama.cpp et Unsloth sont pris en charge dès le premier jour.
Auto-hébergement sur Mac : deux Mac Studio M5 Ultra de 512 Go via MLX, les poids tirés directement de Hugging Face. Apple Research a documenté séparément un cluster de quatre Macs dépassant 36 tok/s.
Catalogues cloud : Amazon SageMaker AI, Google Cloud Model Garden et Microsoft Foundry Models portent les poids pour les équipes qui veulent une infrastructure gérée.
Cette ampleur de déploiement est inhabituelle pour un lancement à poids ouverts, et la communauté l'a remarqué : « Ils ont fait le vrai travail de tester et documenter des déploiements sur plusieurs plateformes. C'est un peu élever le standard des poids ouverts au lieu de balancer le blob et de laisser la communauté se débrouiller. » (HN)
Comparaison avec GLM 5.3 et Kimi K3
Le cadrage de « champion américain des poids ouverts » ne veut dire quelque chose que face aux modèles ouverts chinois qui ont dominé ce classement toute l'année. Chiffres à la même échelle (données d'Artificial Analysis compilées le 16 octobre 2026 ; à revérifier avant tout budget) :
| Dimension | Muse Spark Open | GLM 5.3 | Kimi K3 |
|---|---|---|---|
| Fabricant | Meta (É.-U.) | Z.ai (Chine) | Moonshot AI (Chine) |
| Paramètres | 816B total / 42B actifs | 753B / 40B | 2,8T / 104B |
| Entrée | Texte, image, audio, vidéo | Texte | Texte, image |
| Intelligence Index | 39 | 45 | 44 |
| Vitesse de sortie | 142 tok/s | 67 tok/s | 43 tok/s |
| Coût par tâche de l'Index | 0,84 $ | 2,01 $ | 2,00 $ |
| Prix API ($/M entrée/sortie) | 1,25 / 4,25 | 1,40 / 4,40 | 3,00 / 15,00 |
| Licence | Muse Model License (mention + porte MaaS à 20M$) | Type MIT (conditions vers 10G$) | Personnalisée (porte MaaS similaire à 20M$) |
| Le principal hic | Mémoire de classe téraoctet pour auto-héberger ; mention obligatoire | Entrée texte uniquement | Prix de liste le plus élevé des trois |
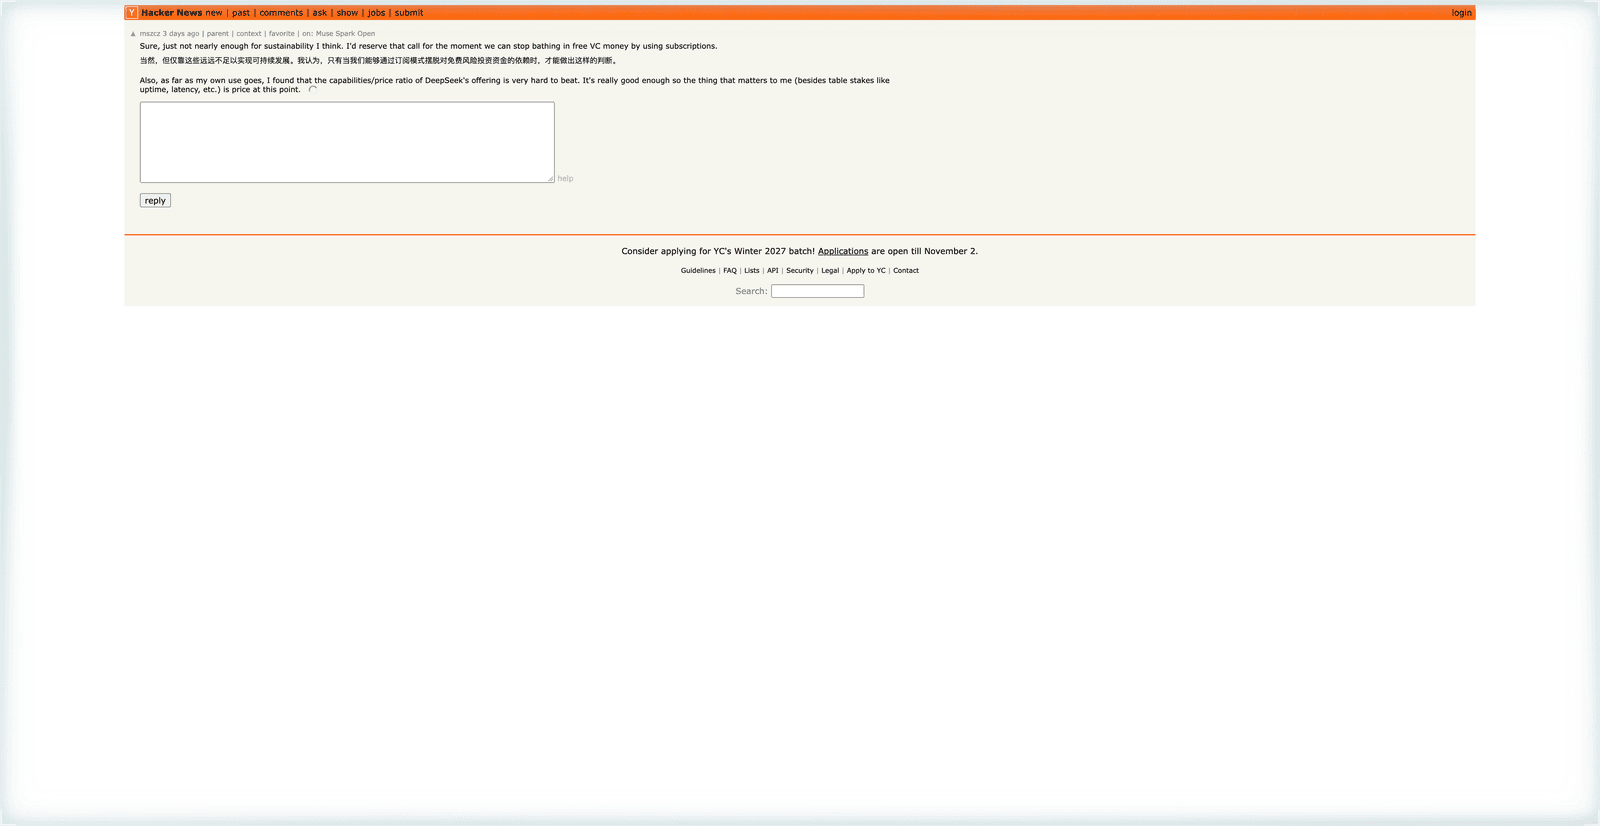
Le compromis est clair. Muse Spark Open suit ses deux rivaux sur l'Intelligence Index mais les écrase sur le coût par tâche terminée — il écrit moins pour arriver au résultat — et c'est le seul des trois avec entrée native audio et vidéo. Un commentateur de HN a formulé ce qui correspond aux données : « le rapport capacité/prix de l'offre de DeepSeek est très dur à battre... ce qui compte pour moi (outre l'évident comme la disponibilité et la latence), c'est le prix à ce stade. » (HN)
Si votre critère est le rang absolu de l'Index, ce n'est pas le leader ; si c'est le coût par tâche acceptée avec entrée multimodale, il est compétitif.
Pour le contexte sur la façon dont le choix du modèle interagit avec la couche d'outils, voyez nos analyses de Qwen3.8 Max, MiniMax M3 et LongCat 2.0 — chacun a parié différemment dans la même course des poids ouverts.
Ce que disent les utilisateurs
Le fil de lancement sur Hacker News (917 points, environ 478 commentaires au 19 octobre) mélange enthousiasme et scepticisme matériel :
« J'adore voir les grands labos d'IA publier des modèles à poids ouverts ; j'espère en voir plus de la part d'OpenAI et éventuellement d'Anthropic. » — shinokami (traduction libre)
« Je me trompais en pensant que les modèles ouverts pouvaient être quantifiés pour tourner sur du matériel de consommateur moyen. » — twitexplore (traduction libre)
« Quelqu'un a essayé une version plus petite/quantifiée localement sur Apple Silicon ? J'aimerais connaître votre expérience, et les tok/s selon la config. » — nico (traduction libre). À l'heure où nous écrivons, le fil compte plus de questions que de retours locaux de première main — toute affirmation de performance sans détails matériels est à traiter comme non vérifiée.
Le r/LocalLLaMA de Reddit a commencé à combler ce manque en quelques jours. Un utilisateur faisant tourner le modèle sur un seul Mac Studio a rapporté atteindre 18 t/s en décodage : « This is text only. Output is coherent and toolcalls solid. » (r/LocalLLaMA) Un autre fil transversal de la même semaine l'a formulé sans détour : « 'Runs locally' now officially means 'runs on a computer that costs more than a car.' » (r/LocalLLaMA)
Une troisième voie : l'utiliser à travers un produit, pas une salle de serveurs
Voici la décision que la plupart des lecteurs affrontent vraiment. Vous n'avez pas 22 000 à 40 000 dollars de Mac Studio sur votre bureau, et vous ne voulez pas opérer huit GPU de datacenter. Mais votre travail — recherche, code, tâches de navigateur — pourrait utiliser un modèle ouvert de classe frontière avec 1M de contexte. C'est ce vide que comblent les API hébergées et les clients natifs IA.
C'est ici qu'un navigateur comme Tabbit Browser trouve sa place. Le motif pratique pour un modèle comme Muse Spark Open n'est pas l'auto-hébergement ; c'est de le choisir (ou un modèle agentique comparable) dans un client qui détient déjà votre contexte — la page sous vos yeux, un groupe d'onglets, un fichier — et de le mettre au travail via la navigation agentique ou l'automatisation de navigateur au lieu de reconstruire chaque tâche dans un chat séparé.
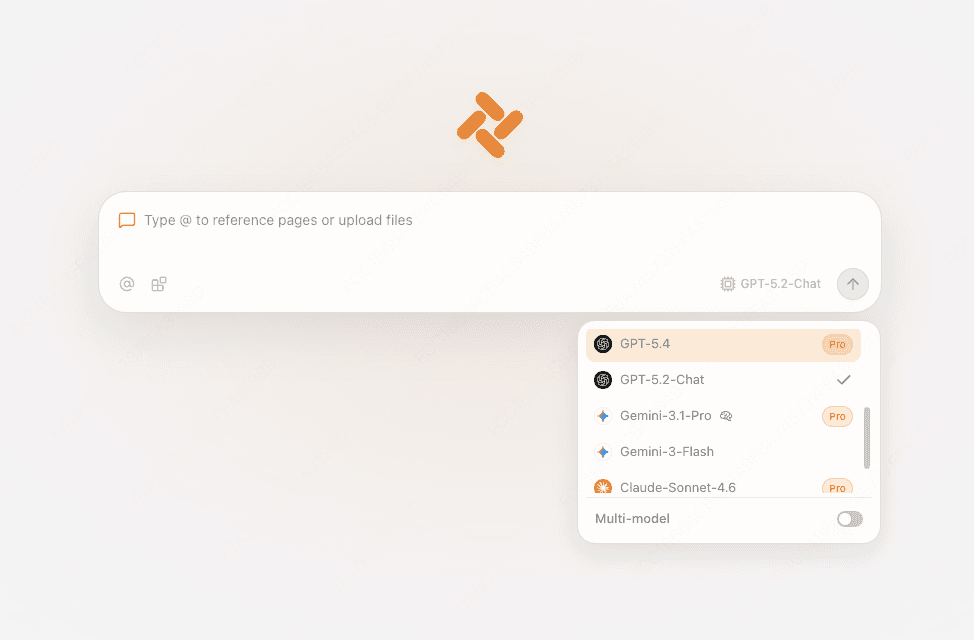
Deux limites honnêtes. Premièrement, nous n'avons pas confirmé la présence de Muse Spark Open dans le sélecteur de modèles en direct de Tabbit ; le modèle a trois jours, la disponibilité change vite, alors vérifiez le sélecteur avant de planifier autour. Si vous voulez un modèle déjà éprouvé dans ce flux, la route avec GLM-5.2 et l'histoire multimodale du GLM-5.3-Flash en sont des exemples fonctionnels du même motif. Deuxièmement, l'auto-hébergement reste supérieur sur le contrôle des données et le coût unitaire à l'échelle — la troisième voie troque cela contre zéro matériel et zéro opérations. Pour un panorama des clients, voir notre comparatif de navigateurs IA.
 Tabbit Browser
Verdict
Muse Spark Open est une publication à poids ouverts crédible et bien conçue dont le titre cache une décision binaire. Si vous pouvez vous offrir le téraoctet, vous obtenez un modèle agentique rapide, concis et multimodal avec des exécutions documentées sur MLX, SGLang et vLLM, sous une licence commercialement amiable pour tous sauf les grands revendeurs de MaaS. Si vous ne le pouvez pas — et presque aucun individu ne le peut encore — la réponse honnête est la route hébergée à 1,25/4,25 dollars, où il rivalise avec GLM 5.3 et Kimi K3 sur le coût par tâche plutôt que sur le rang absolu de l'Index.
| Votre situation | Premier pas |
|---|---|
| Développeur individuel, sans gros matériel | Essayez l'API hébergée à 1,25/4,25 sur une tâche fixe de code ou de recherche ; comparez la sortie acceptée avec GLM 5.3 avant de migrer |
| Équipe ayant besoin du contrôle des données | Chiffrez un nœud NVFP4 Blackwell à 4 GPU ou une paire de Mac Studio face à un an de dépense API à votre volume réel |
| Bâtisseur de produits | Lancez-vous avec la mention « Built with Muse Spark Open » planifiée dès le premier jour ; si vous dépasserez la ligne MaaS à 20M$, parlez tôt à Meta |
| Utilisateur de flux navigateur/agents | Utilisez-le (ou un modèle comparable) via un client qui détient déjà votre contexte de page — voir la troisième voie ci-dessus |
| Chasseur de benchmarks | Attendez une réplication indépendante plus large ; un instantané de AA et un fil HN de semaine de lancement ne font pas un consensus |
Un nombre à retenir : 42 milliards de paramètres actifs expliquent pourquoi ce modèle paraît rapide et abordable par tâche. 816 milliards au total expliquent pourquoi il ne rentrera pas sur votre bureau.
Sources
Blog recherche de Meta : Introducing Muse Spark Open (15-10-2026)
Documentation Meta : Muse Spark Open (consulté le 19-10-2026)
Artificial Analysis : Muse Spark Open (Xhigh) (consulté le 19-10-2026)
Fil de lancement sur Hacker News et pages de commentaires liées (consultés le 19-10-2026)
TechRepublic : Meta unveils Muse Spark Open (16-10-2026)
TrendingTopics : Meta's Muse Spark Open comes with strings attached (16-10-2026)
Flavio Copes : what you can run, and what it takes (16-10-2026)
Comparaison Muse Spark Open vs GLM 5.3 vs Kimi K3 (16-10-2026, compilation de données AA)

Questions fréquentes
Qu'est-ce que Muse Spark Open ?
Muse Spark Open est la version à poids ouverts de Muse Spark de Meta, lancée le 15 octobre 2026 par Meta Superintelligence Labs. C'est un modèle sparse de mixture d'experts avec 816 milliards de paramètres au total et 42 milliards actifs par token, une fenêtre de contexte de 1 048 576 tokens, et une entrée native texte, image, audio et vidéo avec sortie texte. Meta le positionne pour le codage et le travail agentique et le qualifie de modèle à poids ouverts américain le plus capable à ce jour.
Muse Spark Open est-il open source ?
Non. Les poids sont téléchargeables, mais ils sont publiés sous la Muse Model License de Meta, une licence personnalisée non approuvée par l'OSI. L'usage commercial, le fine-tuning et la redistribution sont autorisés, mais le produit doit afficher la mention « Built with Muse Spark Open », et toute offre du modèle en service avec plus de 20 millions de dollars de revenus sur 12 mois consécutifs exige de notifier Meta et de signer un accord séparé.
Quel matériel faut-il pour exécuter Muse Spark Open localement ?
Le modèle complet demande environ un téraoctet de mémoire. Meta et Apple l'ont optimisé pour deux Mac Studio M5 Ultra avec 512 Go de mémoire unifiée chacun sous MLX ; le checkpoint BF16 pèse environ 1,65 To et se sert sur huit GPU de datacenter, tandis que le NVFP4 de 537 Go tient sur un seul nœud Blackwell à 4 GPU. Avec le cache KV inclus, prévoyez environ 2 To de VRAM pour le BF16.
Combien coûte l'API de Muse Spark Open ?
Le prix de lancement chez les fournisseurs comme Together AI, Fireworks, Baseten, Modal et OpenRouter est d'environ 1,25 dollar par million de tokens d'entrée et 4,25 de sortie, avec environ 0,15 par million en lectures de cache. Artificial Analysis a mesuré une médiane de 142 tokens de sortie par seconde et environ 0,84 dollar par tâche de l'Intelligence Index le 19 octobre 2026.
Comment Muse Spark Open se compare-t-il à GLM 5.3 et Kimi K3 ?
Selon Artificial Analysis, Muse Spark Open obtient 39 sur l'Intelligence Index contre 45 pour GLM 5.3 et 44 pour Kimi K3, mais il génère plus vite et a terminé l'Index à environ 0,84 dollar par tâche contre environ 2,00 pour ses deux rivaux. Ses concessions : une licence plus stricte avec mention obligatoire, un téléchargement soumis à inscription, et la plus grande empreinte mémoire pour l'auto-hébergement des trois.
Muse Spark Open est-il la même chose que Muse Wonder ou l'application Muse ?
Non. Muse Wonder est le modèle fermé plus capable de Meta, lancé le 12 octobre 2026 et listé à 4 dollars d'entrée et 20 de sortie par million de tokens. L'application Muse est un produit d'agent personnel dans le cloud. Muse Spark Open est le frère téléchargeable de la ligne Muse Spark hébergée, apparue en avril 2026.