
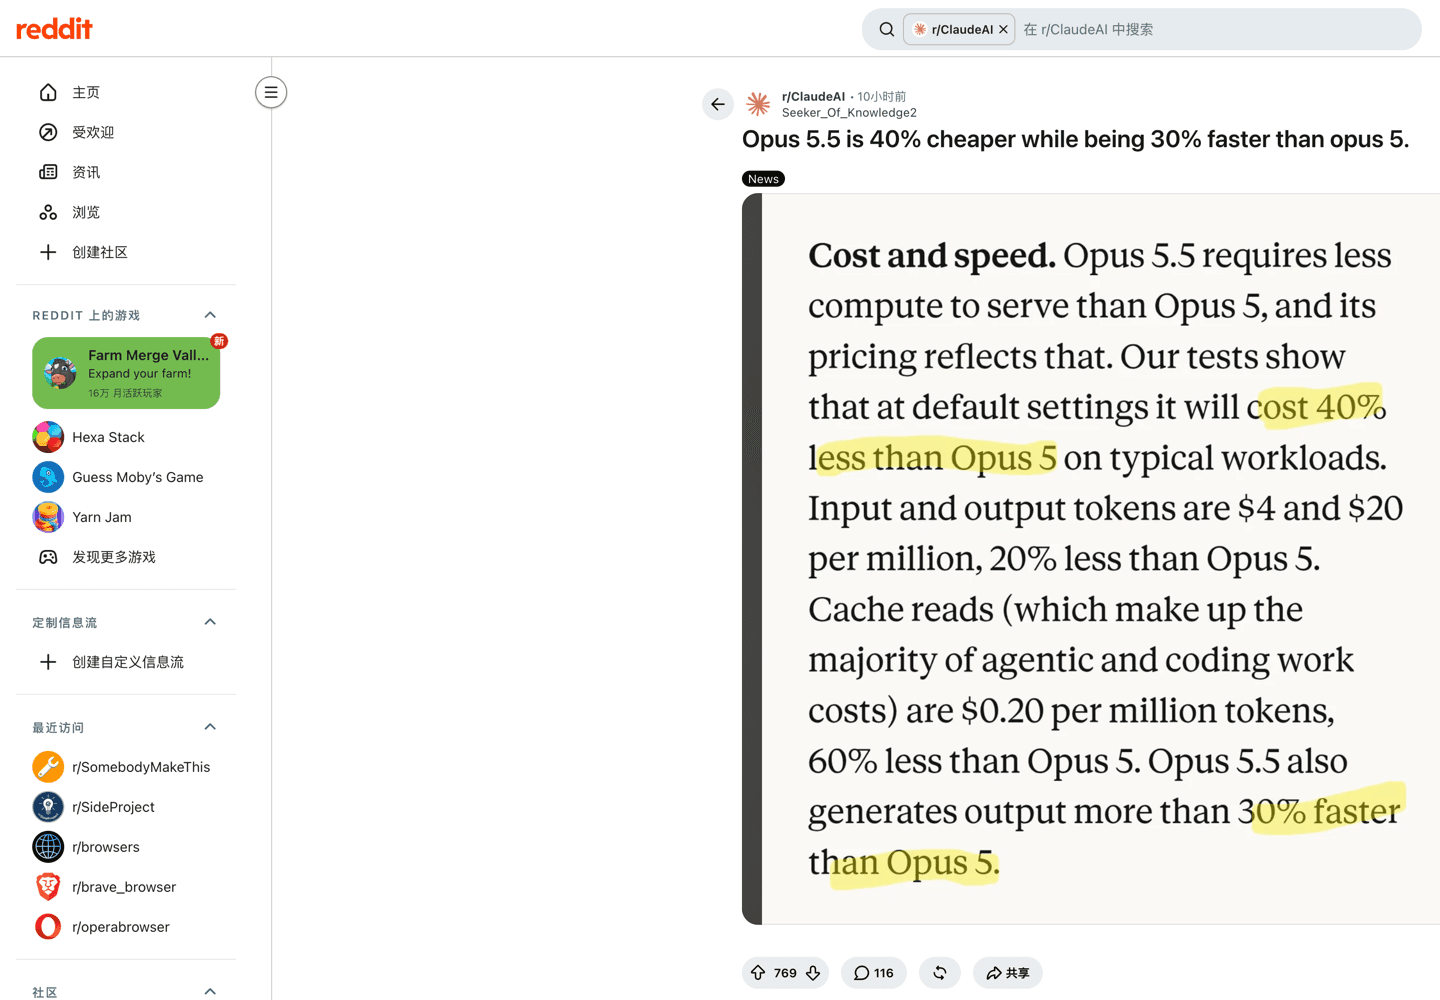
Claude Opus 5.5 cuesta $4 por millón de tokens de entrada y $20 por millón de tokens de salida en la API de Anthropic, con lecturas de caché a $0,20 por millón — todas las tarifas verificadas en la propia documentación de precios de Anthropic el 23 de septiembre de 2026, un día después del lanzamiento. Esta vez la tarifa es la noticia: las cinco líneas de facturación bajaron respecto a Opus 5, la primera generación de Opus que se abarata frente a su predecesora. Cinco generaciones de Opus — de la 4.5 a la 5 — cotizan a $5/$25, y la más nueva de repente es la más barata. La estimación de Anthropic: "en la configuración predeterminada costará un 40% menos que Opus 5 en cargas de trabajo típicas".
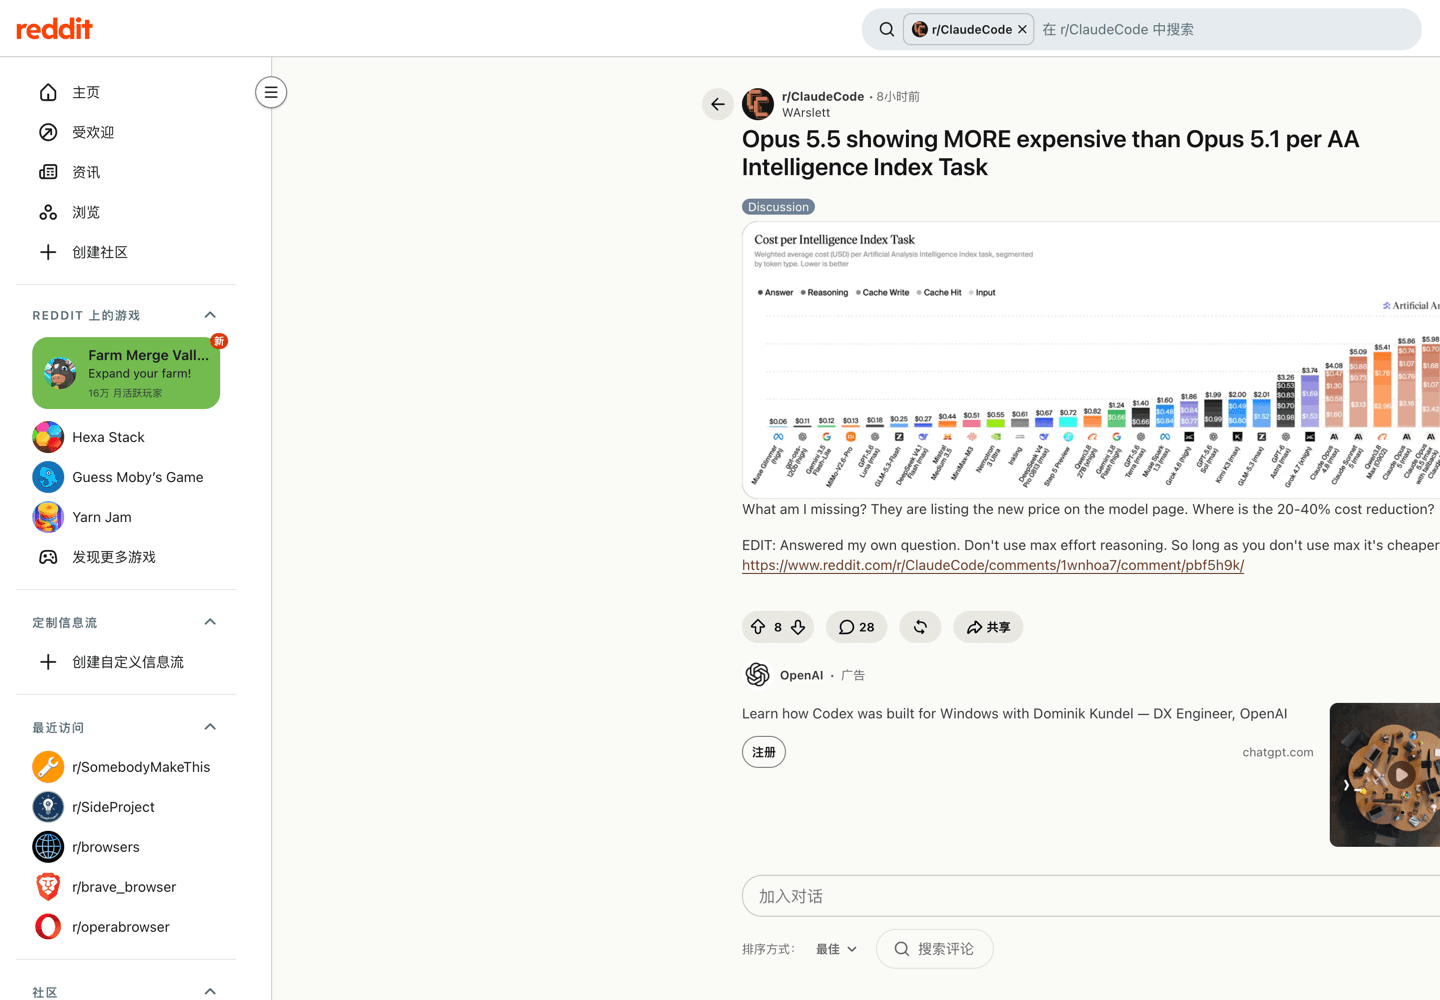
Ambas mitades de esa frase son ciertas, y la distancia entre ellas es la razón de existir de este artículo. En la tarifa oficial, una línea hizo la mayor parte del trabajo — las lecturas de caché cayeron un 60%, hasta los mismos $0,20 que cobra Sonnet 5. Fuera de la tarifa, un desarrollador de r/ClaudeCode abrió Artificial Analysis el día del lanzamiento y vio a Opus 5.5 "mostrándose MÁS caro que Opus 5.1 por tarea del AA Intelligence Index", y luego respondió a su propia pregunta: "No uses el razonamiento de esfuerzo máximo. Mientras no uses max, es más barato" (r/ClaudeCode). Esta página es el lado del dinero de la historia de Opus 5.5 — la visión general de la familia y el estado legado del Opus 4.8 cubren el fondo de capacidades; más adelante en la guía, Tabbit Browser aparece como un lugar práctico para ejecutar estas comparaciones cuando el presupuesto esté claro. Primero, los números.
Key takeaways
La tarifa: $4 de entrada, $0,20 de lectura de caché (0,05x — una tarifa que solo tiene Opus 5.5), $5/$8 de escritura de caché (5m/1h), $20 de salida por millón de tokens. Batch reduce todo a $2/$10; el modo Fast lo duplica a $8/$40; la inferencia solo-EE. UU. añade 1,1x a cada línea.
Un número hizo la mayor parte del recorte. Las lecturas de caché cayeron un 60% ($0,50 → $0,20) — la línea que, según el propio Anthropic, "constituye la mayoría de los costes de trabajo agéntico y de código". La lectura de caché de Opus 5.5 ahora iguala la de Sonnet 5, con el doble de modelo.
El esfuerzo es la mayor palanca controlable. Artificial Analysis mide $0,55 por tarea en esfuerzo bajo y $5,98 en máximo — una oscilación de 11x por 16 puntos de inteligencia. El predeterminado es medium, y el modelo piensa más por turno que Opus 5 con el mismo ajuste.
Sin acantilado de contexto largo. Toda la ventana de 1M de tokens se factura a tarifas estándar, y un header beta de Batch permite 300K tokens de salida. Pero el tokenizador más nuevo produce ~30% más de tokens para el mismo texto que los modelos previos a 4.7.
Las suscripciones recibieron una actualización paralela. Opus 5.5 cuenta como asignación estándar en Pro/Max (Fable quema créditos de uso al 50% de los límites semanales), se subieron los límites de cinco horas en los planes de pago, y los reinicios de límite ya se pueden guardar para después.
Precios de Claude Opus 5.5 de un vistazo
La tarifa estándar completa, tomada de la documentación de precios de Anthropic el 23 de septiembre de 2026:
| Modelo | Entrada / 1M | Escritura 5m / 1M | Escritura 1h / 1M | Lectura caché / 1M | Salida / 1M |
|---|---|---|---|---|---|
| Claude Opus 5.5 | $4,00 | $5,00 | $8,00 | $0,20 | $20,00 |
| Claude Fable 5.1 | $10,00 | $12,50 | $20,00 | $0,25 | $50,00 |
| Claude Opus 5 | $5,00 | $6,25 | $10,00 | $0,50 | $25,00 |
| Claude Sonnet 5 | $2,00 | $2,50 | $4,00 | $0,20 | $10,00 |
| Claude Haiku 4.5 | $1,00 | $1,25 | $2,00 | $0,10 | $5,00 |
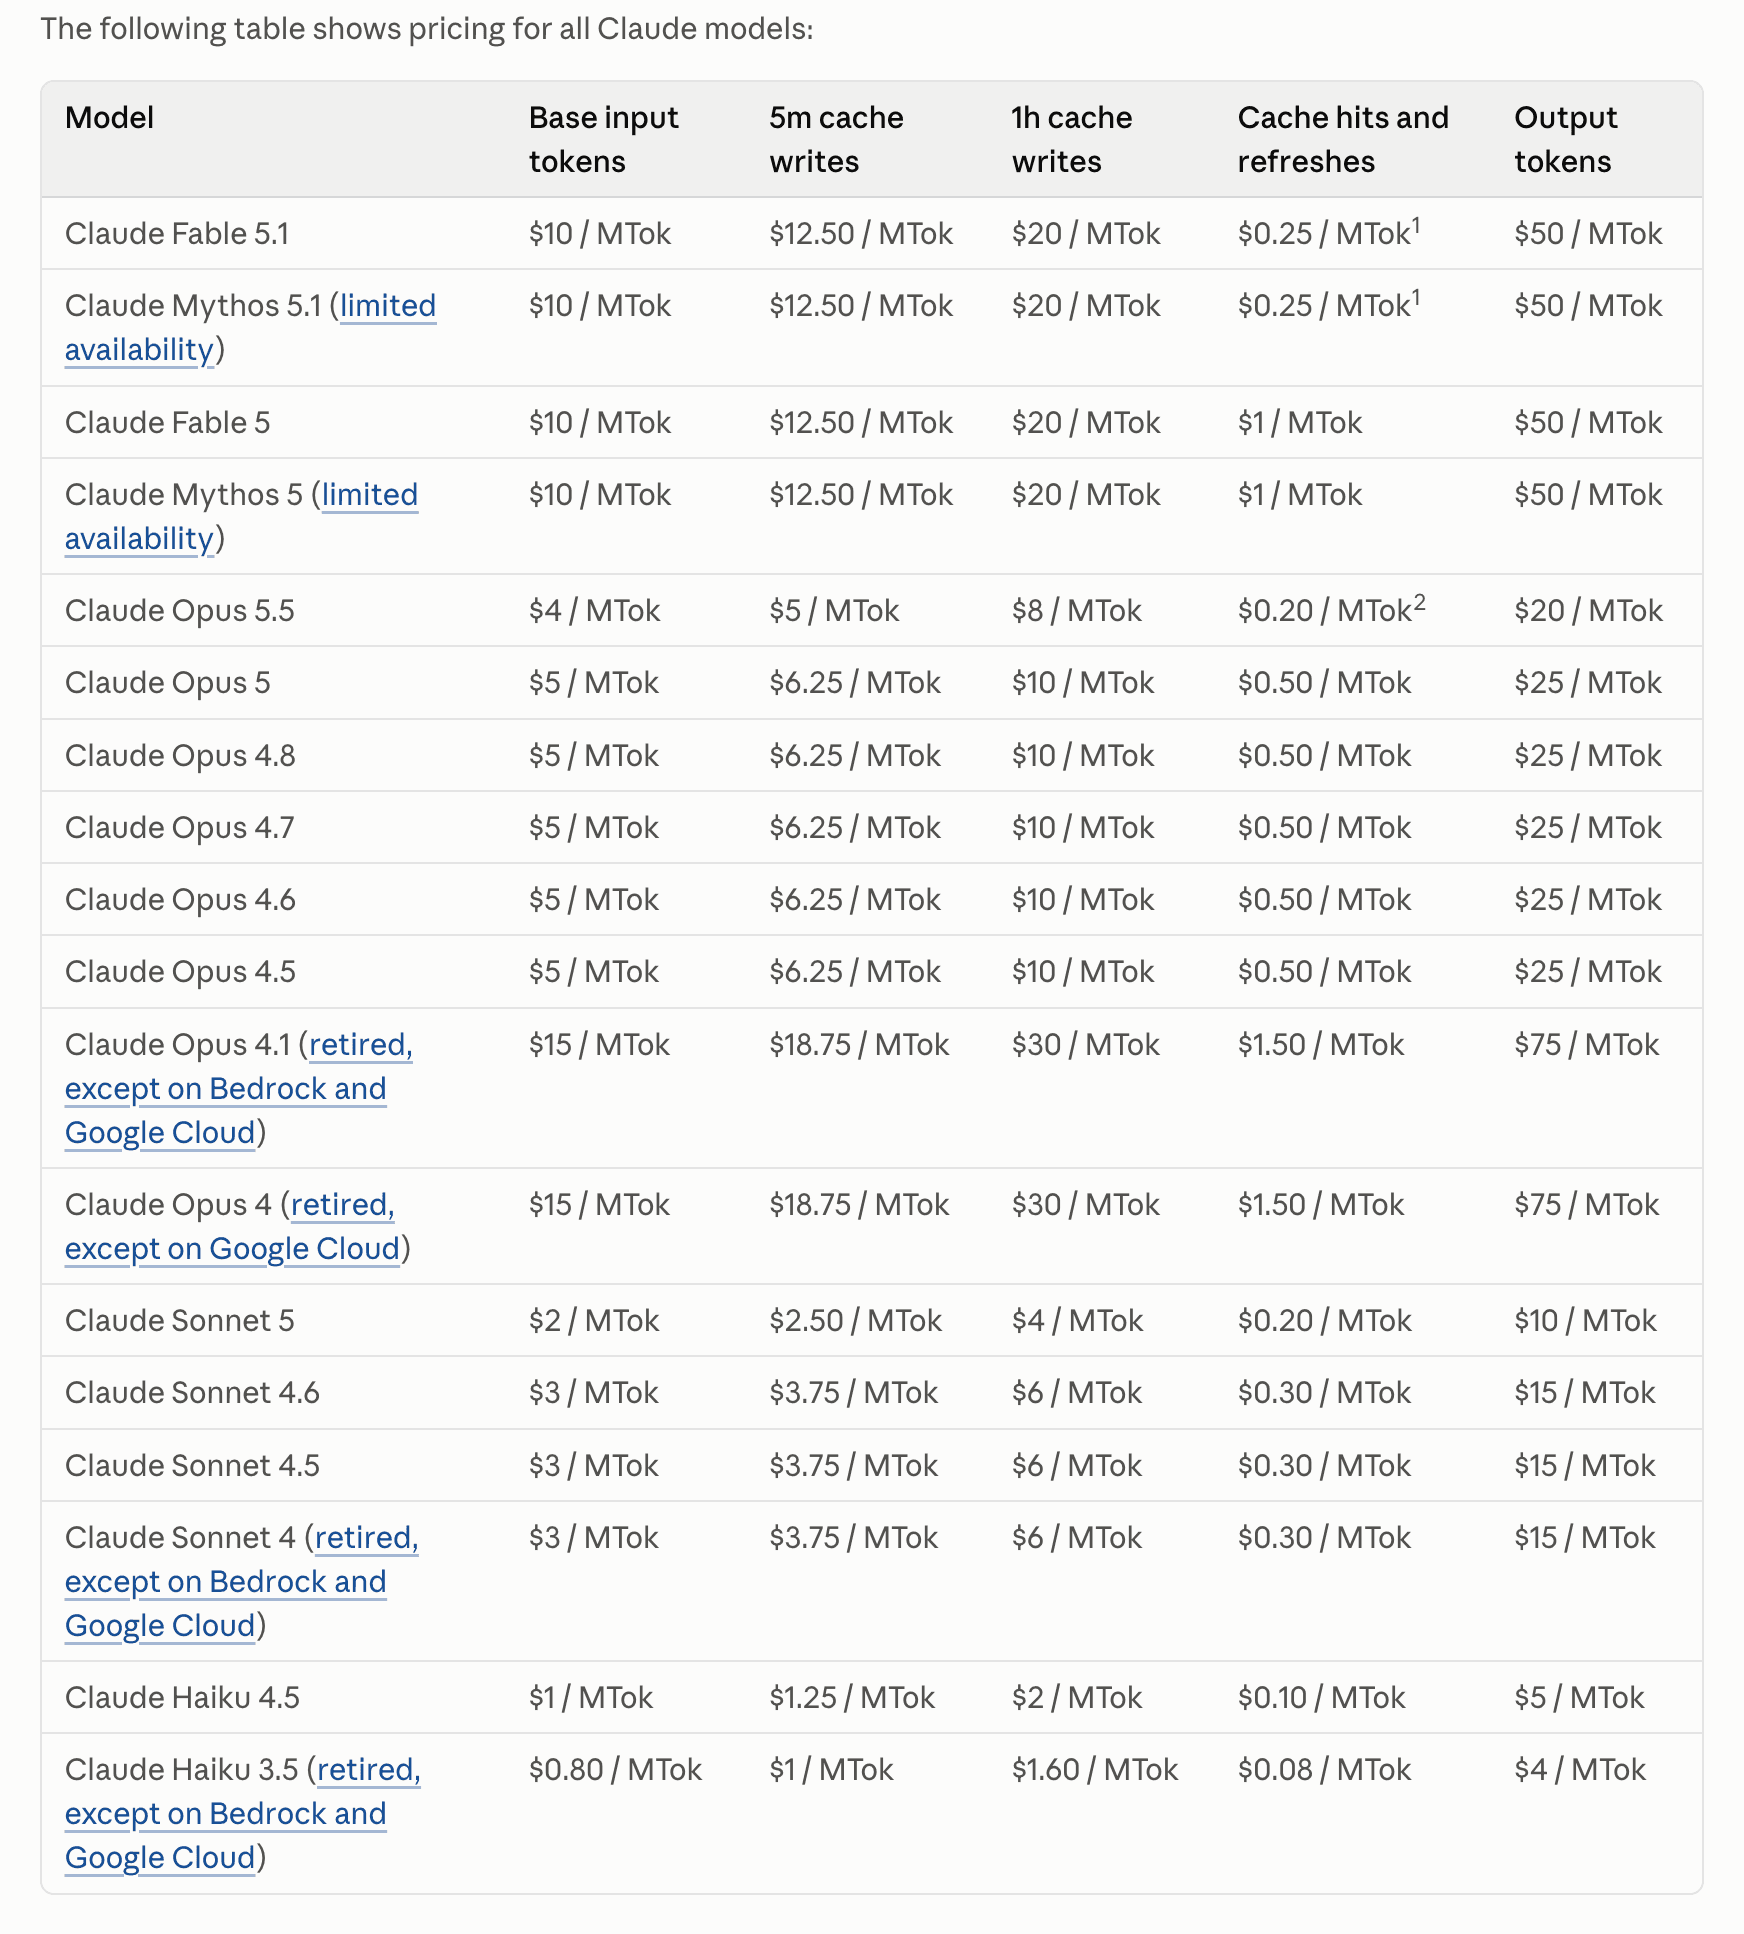
Tres cosas de esta tabla merecen atención, y ninguna es el $4 del titular:
Las lecturas de caché ahora tienen su propio multiplicador. Las lecturas del resto de modelos estándar cuestan 0,1x la entrada base; Fable 5.1 y Mythos 5.1 pagan 0,025x; Opus 5.5 queda entre ambos, en 0,05x, según la nota al pie de Anthropic. El resultado: $0,20 — idéntico a la lectura de caché de Sonnet 5.
La salida sigue siendo 5x la entrada. El razonamiento adaptativo no se puede desactivar en este modelo, y los tokens de pensamiento son salida facturable. Un prompt modesto con una cadena larga de razonamiento es una factura de salida disfrazada de entrada.
El tokenizador cambió bajo tus pies hace dos generaciones. Los modelos Claude 4.7 y posteriores producen aproximadamente 30% más de tokens para el mismo texto, según la propia nota de Anthropic. Comparar precios por token contra las tarifas de la era Opus 4.6 sobrestima en un tercio el coste del modelo antiguo.
También vale fijar: toda la ventana de 1M de tokens se factura a tarifas estándar — no existe nivel de contexto largo. A diferencia del acantilado de 272K de GPT-6 Astra, donde cruzar un umbral reprecia la solicitud entera, en Opus 5.5 "una solicitud de 900k tokens se factura a la misma tarifa por token que una de 9k", en palabras de Anthropic.
El número que cambió: las lecturas de caché cayeron un 60%
Cinco líneas de facturación se movieron entre Opus 5 y Opus 5.5, pero el recorte que importa para el trabajo agéntico es la línea de lectura: $0,50 → $0,20 por millón, un recorte del 60% y un nuevo multiplicador de 0,05x.
La mecánica: cuando una solicitud repite un prefijo ya procesado — prompt del sistema, contexto del repositorio, historial de conversación, definiciones de herramientas — la API lee ese prefijo de la caché en lugar de reprocesarlo. Las escrituras cuestan 1,25x la entrada base para una entrada de 5 minutos ($5/M aquí) y 2x para una de 1 hora ($8/M). Las lecturas cuestan 0,05x de la base — $0,20/M — solo en este modelo. La caché se amortiza tras una relectura de 5 minutos o dos de 1 hora, los multiplicadores se apilan con Batch y la residencia de datos, y el prompt mínimo cacheable es de 512 tokens.
Por qué esto domina las facturas de agentes: un agente que hace 40 llamadas a herramientas sobre un contexto de 200.000 tokens relee ese prefijo 40 veces. Con las lecturas de $0,50/M de Opus 5, esas relecturas cuestan $4,00; con los $0,20/M de Opus 5.5, cuestan $1,60 — antes de generar un solo token nuevo. La propia página de lanzamiento de Anthropic apunta exactamente a esta línea: las lecturas de caché "constituyen la mayoría de los costes de trabajo agéntico y de código", y el recorte del 60% es el mayor trozo individual del 40% oficial.
El lado de suscripción de la misma historia, desde el terreno:
"Usage drains so slowly with opus 5.5. Have multiple threads going on xhigh and max and the usage bar is hardly budging", lee una respuesta; otro usuario reporta dos tareas sustanciales sin que se mueva la asignación semanal. Son experiencias de plan autoinformadas, no benchmarks — pero apuntan en la misma dirección que la aritmética de la API: la línea de lectura es donde viven los presupuestos agénticos.
La trampa, como siempre: los ahorros de caché exigen un prefijo estable. Si tu contexto cambia cada turno — salidas de herramientas dinámicas, documentos rotativos — pagas la penalización de escritura de 1,25x–2x repetidamente en lugar de montarte en las lecturas de 0,05x. Y los bloques de pensamiento están atados al modelo y a la conversación en Opus 5.5; editar el prefijo los invalida, que es la historia de la siguiente sección en miniatura.
Qué significa realmente el "40% menos"
La afirmación de lanzamiento de Anthropic tiene tres condiciones precisas, y analizarlas es la diferencia entre un presupuesto y un deseo. "Nuestras pruebas muestran que en la configuración predeterminada costará un 40% menos que Opus 5 en cargas de trabajo típicas."
Condición uno: la línea base es Opus 5, no los competidores ni Fable. La afirmación combina dos efectos — el recorte de tarifa de ~20% más menos tokens por tarea ("cuesta menos por token que Opus 5 y usa menos tokens por tarea, lo que netea una caída del 40% en costes"). Los propios ejemplos de Anthropic caen en la misma banda y por encima: una reescritura de HAProxy de C a Rust terminó en 9,5 horas frente a 12 de Fable 5.1 con un 51% menos de coste; una auditoría de un código de 200.000 líneas tardó menos de 3 horas donde Opus 5 usó más de 20 y 2,5x los tokens. Los testers tempranos citados reportaron recortes de coste del 40–50% (Spotify), la mitad de tokens (Kiro), un tercio de tokens (Box) y "el primer modelo al que damos medium por defecto" (Factory). Un comentarista de HN resumió la tendencia: "lanzar un modelo con ~3-6x la relación rendimiento/coste de tu lanzamiento de hace solo 3 semanas" (Hacker News).
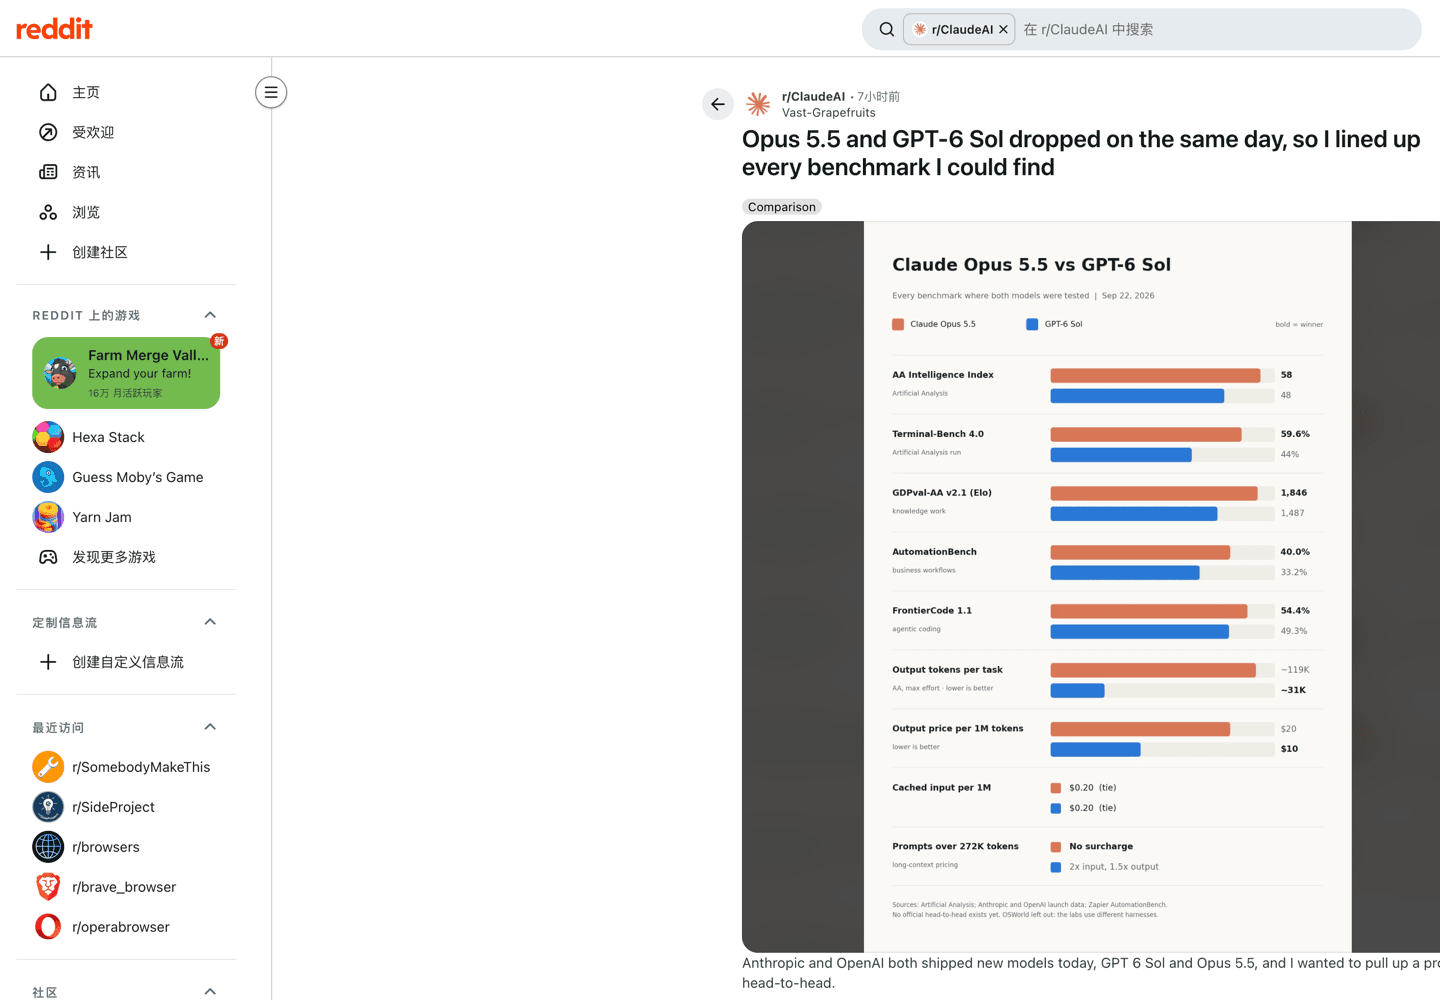
Condición dos: "configuración predeterminada" significa esfuerzo medium. En esfuerzo máximo la matemática se invierte — el modelo "tiende a pensar más por turno que Claude Opus 5, sobre todo en xhigh y max", según las notas oficiales de comportamiento, y el pensamiento facturable es donde mueren los presupuestos. El hilo comparativo de r/ClaudeAI cuantificó la forma: "En esfuerzo máximo, AA midió Opus 5.5 en torno a 119K tokens de salida por tarea, mientras que [GPT-6] Sol usó unos 31K y costó $1,06 por tarea para todo el índice":
Condición tres: "cargas de trabajo típicas" significa que las tuyas puede que no lo sean. La comunidad carga cicatrices aquí, y tienen precio. El comentario más votado (226 puntos) bajo el hilo de la noticia:
"cuando lanzaron Opus 5, no dejaban de proclamar lo puntero que era el modelo… la gente descubrió que Opus 5 ni siquiera se comunicaba bien… desperdiciando aún más tiempo y tokens." Los escépticos de la misma red leen las gráficas de AA al revés — "opus 5.5 vence a astra… pero usó 4,5x los tokens para la misma tarea" — mientras los defensores leen "mismo rendimiento, opus 5.5 medium vs Astra max, 2,5x más barato". Ambos leen el mismo lanzamiento. A cuál se parece tu factura depende de qué token la domina, que es lo que mide la siguiente sección. Para el lado de capacidades de ese intercambio, véase el análisis de Fable 5.1 y nuestra guía de razonamiento agéntico.
La palanca de esfuerzo: de $0,55 a $5,98 por tarea
Nada en la tarifa te dice que este dial mueve el coste más que cualquier línea de precio. Artificial Analysis sigue a Opus 5.5 como cinco entradas separadas; instantánea del 23 de septiembre de 2026:
| Esfuerzo | Intelligence Index | Coste por tarea II | Velocidad de salida |
|---|---|---|---|
| low | 42 | $0,55 | 83 t/s |
| medium (predeterminado) | 51 | $1,34 | 76 t/s |
| high | 54 | $1,82 | 90 t/s |
| xhigh | 56 | $3,46 | 76 t/s |
| max | 58 | $5,98 | — |
Lee las columnas exteriores juntas: el esfuerzo máximo cuesta 10,9x lo que el bajo por tarea, por 16 puntos de inteligencia medida. Medium — el predeterminado — entrega el mismo índice de inteligencia que Opus 5 en esfuerzo máximo ($1,34 contra la tarifa del nivel máximo de Opus 5). "max es casi el doble de coste que xhigh y es un valor atípico respecto a los demás niveles. Si usas medium o high deberías ver ahorros reales", como resumió la respuesta más votada del hilo de r/ClaudeCode. Un desarrollador allí ya reconstruyó un flujo alrededor de la escalera: "Opus 5.5 High es tremendo. Se siente como fable 5.1 medium, pero mucho más barato… cambié mi flujo para usar Opus 5.5 high en casi todo."
Dos precauciones antes de subir o bajar el dial. Primera, migración: el predeterminado pasó de high (Opus 5) a medium, y con el mismo ajuste el nuevo modelo piensa más por turno — la documentación de Anthropic pide repetir tu barrido de esfuerzo en lugar de arrastrar un ajuste, y dejar hueco en max_tokens para el pensamiento. Segunda, más esfuerzo no compra calidad de forma fiable. La evaluación de CodeRabbit del día del lanzamiento encontró que "un mayor esfuerzo de razonamiento no entregó de forma consistente una mejor tasa de compleción" — y más comentarios que el desarrollador debe evaluar es en sí mismo un coste:
Las citas de clientes de la página de lanzamiento van en la misma dirección — Rogo superó a Opus 5 en high "con su ajuste de esfuerzo más bajo… con un 60% menos de tokens de salida"; Walleye Capital "resolvió en gran parte" su suite en el ajuste más bajo. Cuando las propias pruebas del proveedor apuntan una y otra vez a los ajustes baratos, tómalo como la respuesta por defecto y reserva max para las tareas que demostrablemente lo necesiten.
Las líneas de facturación fuera del titular
Cinco líneas deciden la mayoría de las facturas reales, y solo la primera aparece en la cobertura de lanzamiento.
Modo Fast: 2x en cada línea, por hasta 2,5x de velocidad. Fast (vista previa de investigación, solo API de Claude) factura $8 de entrada / $40 de salida — el doble de la tarifa estándar, líneas de caché incluidas ($0,40 de lectura). Se apila con caché y residencia de datos, no puede combinarse con Batch, y entrega una salida "hasta 2,5x" más rápida; la tabla de proveedores de OpenRouter mide 143 tok/s en Fast frente a 71–83 estándar. Nótese que Fast Opus 5.5 a $40/M de salida aún queda por debajo de los $50 estándar de Fable 5.1.
Batch: la palanca del 50%. Las solicitudes asíncronas de Batch se facturan a $2/$10 — el mayor descuento de la tarjeta, apilable con la caché de prompts en toda la ventana de contexto, con un header beta que permite hasta 300K tokens de salida. Las sesiones de agente gestionado no califican; con estado e interactivas.
Inferencia solo-EE. UU.: 1,1x en todo. Fijar inference_geo: "us" multiplica cada categoría — entrada, salida, escrituras y lecturas de caché — por 1,1x. El mismo 10% aparece como precio de endpoint regional en las nubes socias: OpenRouter lista rutas regionales de Bedrock/Azure/Vertex a $4,40/$22,00/$0,22. Las regiones por cumplimiento pagan una prima silenciosa por línea; el enrutamiento global es el predeterminado y el camino barato.
Los overheads de herramientas son facturas de tokens. El prompt de sistema de uso de herramientas añade 286 tokens por solicitud (frente a los 675 de Opus 4.7); declarar el toolset de navegador añade unos 6.600 tokens de entrada, computer use unos 4.500. La búsqueda web del lado servidor factura $10 por 1.000 búsquedas además de los tokens; la ejecución de código es gratis junto a search/fetch, con 1.550 horas gratis de contenedor al mes antes de los $0,05/hora. Un "agente" es una estructura de precios, no un chat — presupuesta la línea de herramientas explícitamente. Para el extremo económico de esa comparación, véase el desglose de precios de Kimi K3.
Runtime de Managed Agents: $0,08 por hora de sesión, medido solo en ejecución, con todas las líneas de tokens a tarifas del modelo. Batch no aplica a sesiones.
La escalera familiar: Opus 5.5 vs Fable 5.1 vs Opus 5 vs Sonnet 5
| Línea (por 1M de tokens) | Opus 5.5 | Fable 5.1 | Opus 5 | Sonnet 5 |
|---|---|---|---|---|
| Entrada | $4,00 | $10,00 | $5,00 | $2,00 |
| Lectura de caché | $0,20 (0,05x) | $0,25 (0,025x) | $0,50 (0,1x) | $0,20 (0,1x) |
| Salida | $20,00 | $50,00 | $25,00 | $10,00 |
| Batch entrada / salida | $2,00 / $10,00 | $5,00 / $25,00 | $2,50 / $12,50 | $1,00 / $5,00 |
| AA Intelligence Index (máx.) | 58 | 53 | 51 | 38 |
| Coste AA por tarea II (máx.) | $5,98 | $7,63¹ | — | — |
¹ Cifra de Fable 5.1 de la instantánea del 22 de septiembre de AA, vía nuestro desglose de precios de Fable; ambas páginas de AA cambian a diario.
La fila contraintuitiva es la última: en el índice de Artificial Analysis, el modelo más barato es ahora también el más fuerte. Opus 5.5 en esfuerzo máximo puntúa 58 contra el 53 de Fable 5.1, a $5,98 versus $7,63 por tarea — mientras el posicionamiento del propio Anthropic sigue reservando Fable para "trabajo ambicioso, de larga duración y asíncrono" y describe el hueco Opus-Fable como "más estrecho de lo que sugieren estas puntuaciones". Léase así: las puntuaciones exageran el hueco, pero el hueco de precio es real e invertido. Los bucles con contexto cacheado están más cerca aún — Fable conserva el descuento de lectura más profundo (0,025x), pero sus lecturas parten de una base de $10: $0,25/M. Los $0,20 de Opus 5.5 lo baten en términos absolutos.
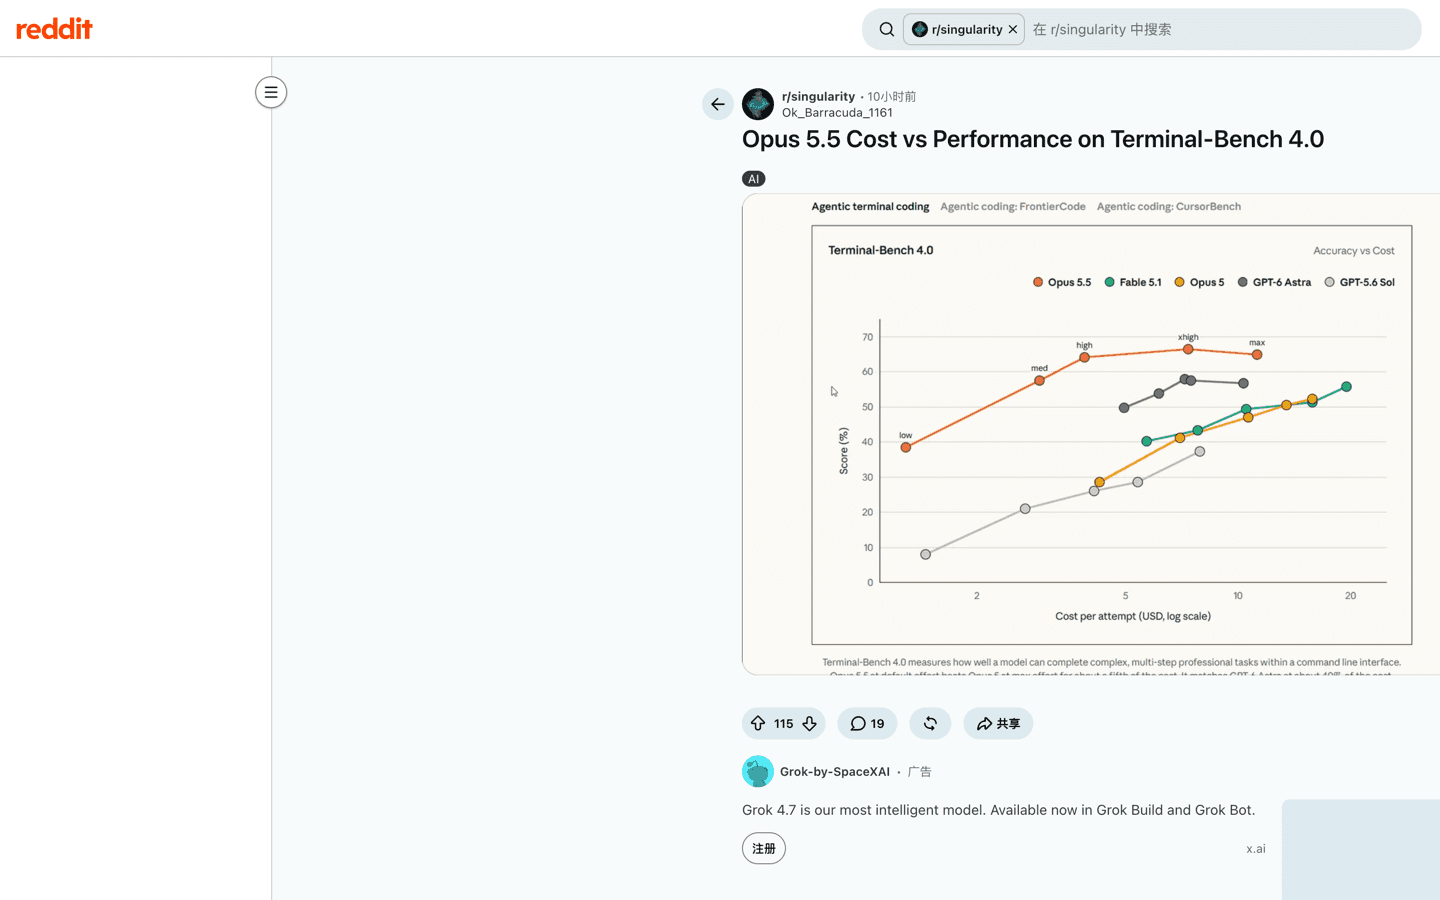
Las dos lecturas comunitarias de la misma gráfica de AA, lado a lado:
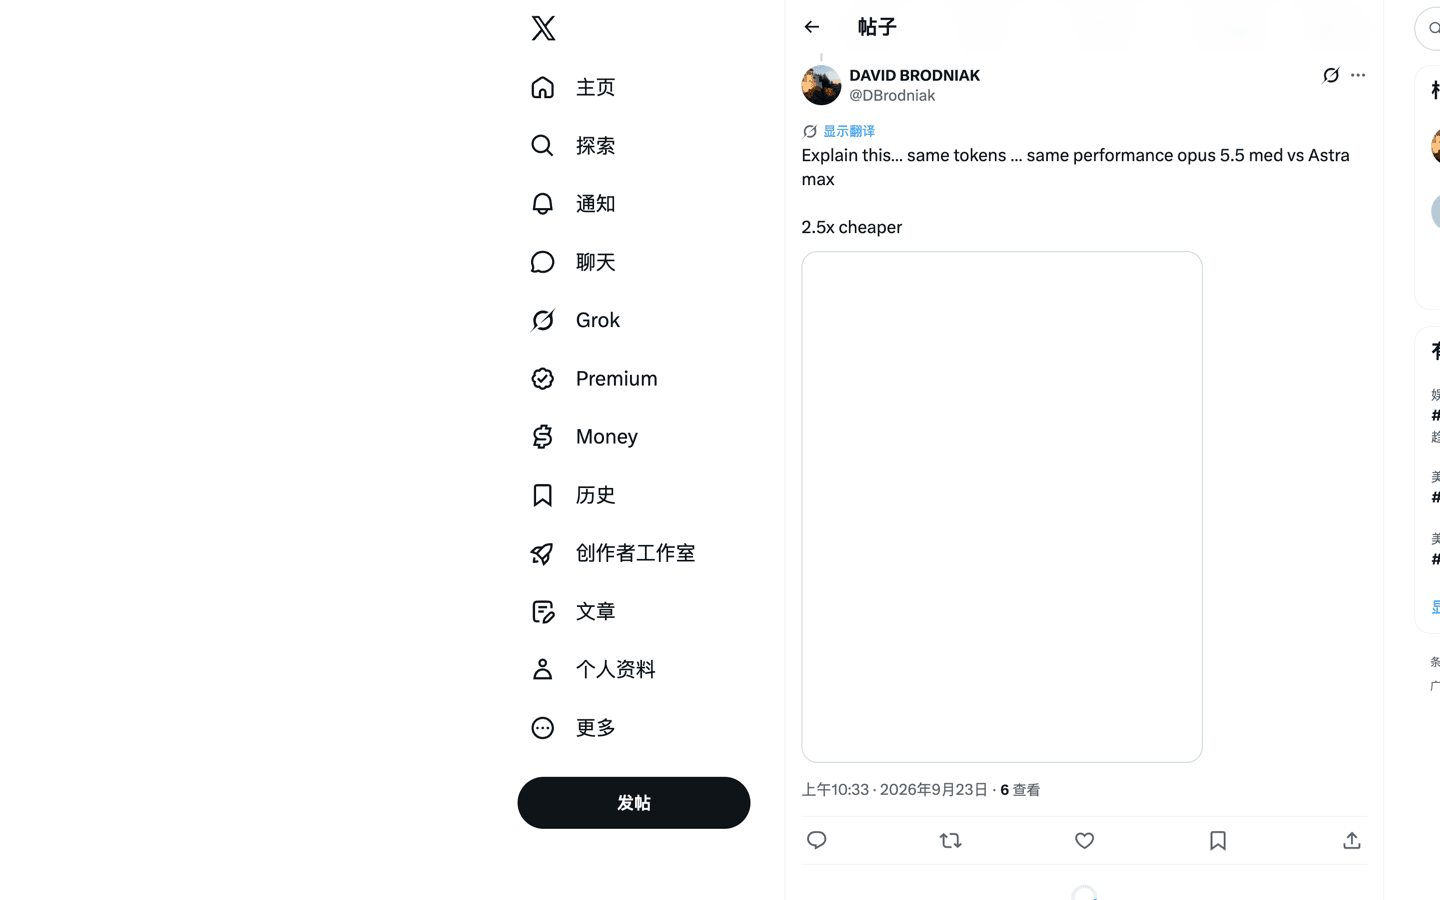
"same tokens … same performance opus 5.5 med vs Astra max — 2.5x cheaper" contra "opus 5.5 venció a astra… pero usó 4,5x los tokens para la misma tarea". Ambos describen la misma forma: Opus 5.5 gana en coste por tarea completada y pierde en tokens por tarea. Si tus cargas son sensibles a la forma de los tokens — presupuestos estrictos por token, enrutadores externos, topes de rendimiento — mide antes de migrar; si son sensibles a la tarea, la escalera favorece a Opus 5.5 en casi todos los peldaños.
Bajo los peldaños insignia, Sonnet 5 conserva el asiento económico a $2/$10 con su lectura de $0,20 — el mismo precio de lectura que Opus 5.5 ahora — y Haiku 4.5 aguanta a $1/$5. La nueva lógica de la escalera: la columna de lectura de caché se ha comprimido hasta que el modelo listo y el modelo barato cobran lo mismo por la línea que los agentes golpean más fuerte.
Por lo que no pagas
La documentación traza límites que leen como política de reembolsos, y a escala agéntica importan:
Los bloques de pensamiento descartados no se facturan. Cuando una solicitud lleva un bloque que el modelo no puede leer, la API lo descarta antes de la inferencia: "la solicitud tiene éxito, y los bloques descartados no se facturan". Para un modelo cuyos bloques están atados a la conversación, esa es la línea de degradación elegante.
Las redirecciones de salvaguarda se completan en otros modelos. Las solicitudes marcadas por ciberseguridad las completa Opus 4.8, según la nota de benchmarks de la página de lanzamiento; el traspaso es transparente (las negativas devuelven
stop_reason: "refusal"con el área de política, y el fallback del lado del servidor reintenta en un modelo recomendado). Anthropic no detalla la facturación de la redirección para Opus 5.5 como hizo con Fable — hasta que se documente, asumir la tarifa del modelo que completa es lo prudente.Las búsquedas web fallidas no se facturan. Las exitosas cobran $10 por 1.000; las erróneas no. Web fetch no añade cargo más allá de los tokens en que se convierte el contenido obtenido.
La ejecución de código es gratis junto a search o fetch, y cada organización recibe 1.550 horas gratis de contenedor al mes antes de que empiece la tarifa de $0,05/hora.
Disponibilidad en planes: API, nubes y planes de consumo
La tarifa de API es solo una de tres economías. Verificado en claude.com/pricing y la documentación el 23 de septiembre de 2026:
| Superficie | Precio (valor verificado) | Acceso a Opus 5.5 |
|---|---|---|
| API de Anthropic | Tarifas por token de arriba | Sí — claude-opus-5-5 |
| Plan Free | $0 | No (solo Sonnet/Haiku) |
| Pro | $17/mes anual ($200 por adelantado) o $20 mensual | Sí — asignación estándar |
| Max 5x / 20x | Desde $100/mes | Sí — asignación estándar |
| Team | Asientos Standard por encima de Pro; Premium = 5x Standard | Sí |
| Enterprise | $20/asiento/mes anual + uso a tarifas API | Sí, con controles de gasto |
| Nubes | AWS Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS | Sí; endpoints regionales +10%, Foundry mide en CCU |
La fila de suscripción que merece subrayado: en la comparación de planes, Opus consume asignaciones de uso estándar en Pro y Max — el asterisco de "créditos de uso, 50% de los límites semanales" lo lleva Fable. Una hora de Fable cuesta contra tu asignación lo que dos horas de un modelo estándar; una de Opus 5.5 no. Anthropic apiló dos cambios más en el lanzamiento: límites de cinco horas aumentados en Pro, Max, Team y Enterprise por asiento, y un reinicio de límite que "ya puedes guardar y usar cuando elijas".
La comunidad está dividida sobre qué significa en la práctica, ambas direcciones visibles en los mismos hilos de la semana de lanzamiento:
"I am using Fable 5.1 rn, and this is 5x cheaper for same intelligence? I am never going to hit my weekly limits at this rate" — contra — "estos recortes no se traducen necesariamente en suscripciones… usan los costes de API como material de marketing." El aumento de límites está documentado; lo generosa que resulte es un ver-y-ver que solo tus propias ventanas de cinco horas pueden responder. Mecánicamente: el uso se reinicia en ventanas de sesión rodantes de cinco horas con límites semanales adicionales en los planes de pago; web, escritorio, móvil y Claude Code beben de un mismo pool; y los créditos de uso en planes de pago te dejan seguir a tarifas estándar de API pasada la cuenta.
Dos presupuestos trabajados, con todos los supuestos a la vista
Tarifas estándar, sin reintentos, sin herramientas, sin impuestos. Aritmética trabajada, no predicciones.
Una pregunta corta con mucho pensamiento. 10.000 tokens de entrada, 2.000 de salida:
(10.000 × $4 + 2.000 × $20) / 1.000.000 = $0,08Un bucle de agente en frío sobre un repo grande. 300.000 tokens de entrada (tarifa estándar — sin nivel de contexto largo), 8.000 de salida:
(300.000 × $4 + 8.000 × $20) / 1.000.000 = $1,36La versión en caliente del mismo bucle. Mismo contexto de 300.000 tokens, 90% cacheado, una escritura de 1 hora por sesión, 8.000 de salida por pasada:
por pasada: (270.000 × $0,20 + 30.000 × $4 + 8.000 × $20) / 1.000.000 = $0,334
único: 300.000 × $8 / 1.000.000 = $2,40 de escritura por sesión
La pasada en caliente cae a un cuarto del coste en frío, y la escritura de $2,40 se amortiza en cada pasada que la reutiliza — una escritura de 5 minutos ($1,50) se paga con una relectura, la de una hora con dos. El mismo bucle arranca en frío a $1,36 en cada pasada cuando el prefijo cambia. El recurso del modelo (English) y su colección de prompts (English) siguen tareas repetibles con las que medir tu propia tasa de acierto.
Cálculo local
Estima el coste de tokens de la API Claude Opus 5.5
Usa las tarifas oficiales en USD verificadas el 23-09-2026. Los valores permanecen en este navegador.
Las lecturas de caché se facturan a 0,20 USD por millón de tokens: la tarifa 0,05x de Opus 5.5. La estimación excluye reintentos, sobrecostes de herramientas, redirecciones de salvaguardia y márgenes de proveedores. El modo Fast duplica cada línea y no puede combinarse con Batch. Ver tarifas actuales
La calculadora corre por completo en esta página — nada se envía a ninguna parte. Precia ambas duraciones de escritura de caché y los modos Estándar, Batch, solo-EE. UU. y Fast, y valida las entradas localmente. Lo que deliberadamente no modela: reintentos, fan-out de subagentes, overheads de herramientas y redirecciones de salvaguarda — eso va en tu margen. Revisa la tarifa oficial antes de comprometer un presupuesto; estas son las cifras del 23 de septiembre de 2026.
Una opción práctica: ejecuta la comparación en Tabbit
Tras el presupuesto viene la parte aburrida: ejecutar trabajo con forma de Opus necesita un lugar donde páginas, archivos y llamadas a modelos convivan, y donde "probar Opus 5.5 en medium, caer a Sonnet" sea una selección y no un proyecto de orquestación. Ese es el hueco que ocupa Tabbit Browser — un navegador agéntico con IA cuyo selector de modelos, pestañas vivas y archivos locales comparten una misma superficie.
Los límites, dichos sin rodeos: Tabbit es un cliente, no una capa de facturación de Anthropic. La disponibilidad de modelos depende de tu cuenta y edición, y nada en el navegador cambia lo que cobra Anthropic — la tarifa de arriba se aplica donde sea que corra Opus 5.5. Este artículo no ejecutó una tarea de Opus 5.5 dentro de Tabbit, así que no se hace ninguna afirmación de disponibilidad o rendimiento. Lo que cambia el navegador es el coste de montaje: medir tu propia tasa de acierto de caché y tu umbral de esfuerzo en trabajo real — los dos números que esta página entera dice que deciden tu factura — antes de escribir una línea de orquestación es lo más barato en un espacio construido justo para eso. La guía de hábitos de trabajo de Tabbit cubre el método.
 Tabbit Browser
Tabla de decisión de precios de Claude Opus 5.5
| Tu carga de trabajo | Motor de coste | Mejor punto de partida | Cuidado con |
|---|---|---|---|
| Bucles largos de agente, contexto estable de repo/docs | Lecturas de caché | Nivel estándar, prefijos estables, escrituras 1h | Editar el prefijo invalida los bloques de pensamiento atados; el churn convierte lecturas en escrituras de 1,25–2x |
| Chat corto, ediciones rápidas | Tokens de salida | Menos esfuerzo — o Sonnet 5 | El pensamiento no se puede desactivar; medium por defecto suele bastar |
| Evaluaciones nocturnas, refactors por lotes | Volumen | API Batch a $2/$10, beta de 300K de salida | Las sesiones interactivas y de agente gestionado no califican |
| Trabajo interactivo con latencia crítica | Velocidad de salida | Modo Fast a 2x ($8/$40), con caché | Fast no se combina con Batch; duplica cada línea |
| Procesamiento en EE. UU. por cumplimiento | Cada línea | Solo-EE. UU. a 1,1x, o endpoints regionales de nube (+10%) | La prima también aplica a lecturas de caché |
| Presupuestos sensibles a la forma de tokens (routers, topes) | Tokens por tarea | Mide antes de migrar | Opus 5.5 gana coste-por-tarea, pierde tokens-por-tarea frente a rivales |
| Uso diario por suscripción | Ventanas de 5 horas | Pro/Max — Opus es asignación estándar, límites subidos | Fable en los mismos planes quema créditos al 50% de los límites semanales |
Veredicto final
Claude Opus 5.5 es el primer Opus que salió más barato que su predecesor, y el recorte es real en cada línea — 20% en entrada y salida, 60% en las lecturas de caché que dominan las facturas agénticas, ahora al precio de Sonnet 5. Cómpralo para código agéntico de largo alcance y trabajo del conocimiento en medium, con prefijos estables y Batch cargando todo lo que pueda esperar; en el índice de AA ya superó a Fable 5.1 costando menos por tarea, lo que reordena la escalera familiar. Las dos facturas que no arregla: el pensamiento en esfuerzo máximo (una palanca de 11x que la tarifa jamás muestra) y los presupuestos sensibles a la forma de tokens, donde sigue gastando más tokens por tarea que rivales más frugales. En suscripción es el flagship amigo de la asignación — uso estándar, límites subidos — pero verifica tu propia quema de cinco horas antes de comprometer a un equipo. Revisa la página oficial de precios cada mes: la estandarización de Sonnet 5 y este lanzamiento demuestran que la escalera se mueve rápido. La historia de capacidades vive en la visión general de Fable 5.1 y el análisis; los registros comunitarios enlazados arriba llevan la evidencia de cargas de trabajo; y la comparación de precios entre familias muestra qué cuesta la misma tarifa en otra parte.
Sources
Documentación de precios de Anthropic — tarifa, nota al pie de caché 0,05x, modo Fast, Batch, residencia, precios de herramientas; verificado el 23 de septiembre de 2026
Página del modelo Claude Opus 5.5 y novedades — especificaciones, esfuerzo por defecto, cambios de ruptura, "piensa más por turno", facturación de bloques descartados; verificado el 23 de septiembre de 2026
Página de lanzamiento de Anthropic — afirmación del 40% y condiciones, ejemplo HAProxy, citas de coste de clientes, subida de límites, redirecciones; verificado el 23 de septiembre de 2026
claude.com/pricing — comparación Free/Pro/Max y reglas de asignación Opus vs Fable; verificado el 23 de septiembre de 2026
Página de lanzamiento en Artificial Analysis — inteligencia por esfuerzo, velocidad, instantánea de coste por tarea; verificado el 23 de septiembre de 2026
OpenRouter Opus 5.5 — tarifas de proveedores, endpoints regionales, throughput Fast; verificado el 23 de septiembre de 2026
Registros comunitarios con capturas y condiciones en línea: pregunta de max en r/ClaudeCode, comparación con Sol en r/ClaudeAI, hilo de lanzamiento en r/ClaudeAI, división de suscripción en r/singularity, lecturas de gráficas en X, vídeo de evaluación de CodeRabbit, hilo de lanzamiento en HN

Preguntas frecuentes
¿Cuánto cuesta Claude Opus 5.5?
En la API de Anthropic, Claude Opus 5.5 cuesta $4 por millón de tokens de entrada y $20 por millón de tokens de salida, verificado en la documentación de precios de Anthropic el 23 de septiembre de 2026. Las escrituras de caché cuestan $5 por millón (5 minutos) o $8 por millón (1 hora), y las lecturas de caché cuestan $0,20 por millón — una tarifa de 0,05x exclusiva de este modelo. La API Batch reduce todo a la mitad, a $2/$10, y el modo Fast lo duplica todo, a $8/$40.
¿Es Claude Opus 5.5 más barato que Opus 5?
Todas las líneas de la tarifa bajaron: la entrada y la salida son un 20% menos que los $5/$25 de Opus 5, las escrituras de caché pasaron de $6,25/$10 a $5/$8, y las lecturas de caché cayeron un 60%, de $0,50 a $0,20. Anthropic estima que las cargas de trabajo típicas en la configuración predeterminada cuestan alrededor de un 40% menos en total. La excepción es el esfuerzo: en el nivel máximo el modelo piensa más por turno, y las mediciones independientes por tarea van de $0,55 en bajo a $5,98 en máximo — una horquilla de 11x que ninguna tarifa publicada muestra.
¿Está Claude Opus 5.5 disponible en el plan gratuito?
No. La comparación de planes de Anthropic marca Opus como no disponible en Free, que solo incluye los modelos Sonnet y Haiku. Opus 5.5 está incluido en las asignaciones estándar de Pro, Max, Team y Enterprise — notablemente como uso estándar, no con el esquema de créditos de uso que tiene Fable 5.1 en Pro y Max. Anthropic también subió los límites de uso de cinco horas en Pro, Max, Team y Enterprise por asiento en el lanzamiento, y añadió un reinicio de límite que puedes guardar para después.
¿Cuál es la forma más barata de ejecutar Claude Opus 5.5?
Trabaja las palancas en orden: mantén prefijos estables para que las relecturas se facturen a $0,20 en lugar de $4 por millón, ejecuta en el esfuerzo más bajo que pase tu control de calidad (medium es el predeterminado y suele bastar), envía por la API Batch el trabajo no urgente a $2/$10, y evita la inferencia solo-EE. UU. y el modo Fast salvo que el cumplimiento o la latencia lo exijan. Al migrar, repite tu barrido de esfuerzo: con el mismo nivel, Opus 5.5 tiende a pensar más por turno que Opus 5.
¿Cobra extra Claude Opus 5.5 por el contexto largo?
No. Toda la ventana de 1M de tokens se factura a tarifas estándar por token, sin nivel de contexto largo, y los descuentos de caché y Batch se aplican a toda la ventana. En la API Batch, un header beta eleva la salida máxima a 300K tokens. Ten en cuenta que los modelos Claude 4.7 y posteriores usan un tokenizador más nuevo que produce aproximadamente un 30% más de tokens para el mismo texto.
¿Las redirecciones de seguridad o las llamadas fallidas se facturan a precios de Opus 5.5?
Las solicitudes redirigidas por salvaguardas las completan otros modelos — Anthropic indica que el trabajo marcado por ciberseguridad lo atiende Opus 4.8 — y el traspaso se informa de forma transparente en lugar de facturarse en silencio. Las búsquedas web fallidas no se facturan, web fetch no añade cargo más allá de los tokens del contenido obtenido, y los bloques de pensamiento que el modelo no puede leer se descartan antes de la inferencia sin coste. La ejecución de código es gratis junto a la búsqueda web o fetch, con 1.550 horas de contenedor gratis al mes en caso contrario.