
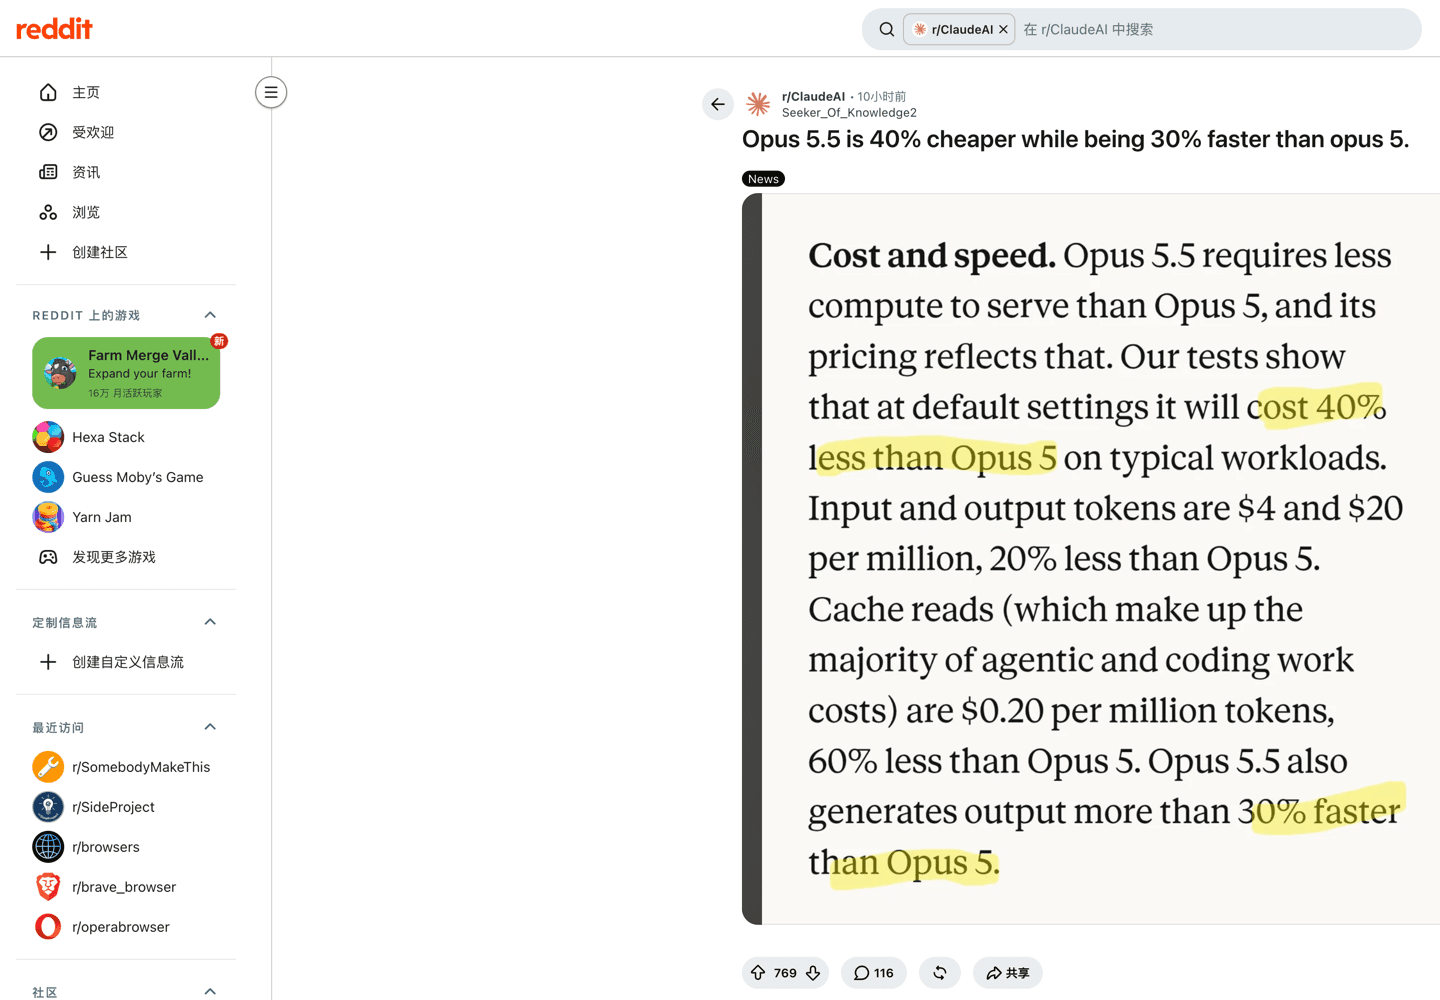
Claude Opus 5.5 在 Anthropic API 上的价格是每百万输入 token $4、每百万输出 token $20,缓存读取每百万 $0.20——所有费率均于 2026 年 9 月 23 日(发布次日)在 Anthropic 官方定价文档核对。这一次费率卡本身就是新闻:五个计费行相对 Opus 5 全部下调,这是第一代比前任便宜的 Opus。从 4.5 到 5 的五代 Opus 牌价全部是 $5/$25,而最新的一代突然成了最便宜的。Anthropic 的官方估算是:"在默认设置下,典型工作负载的成本比 Opus 5 低 40%。"
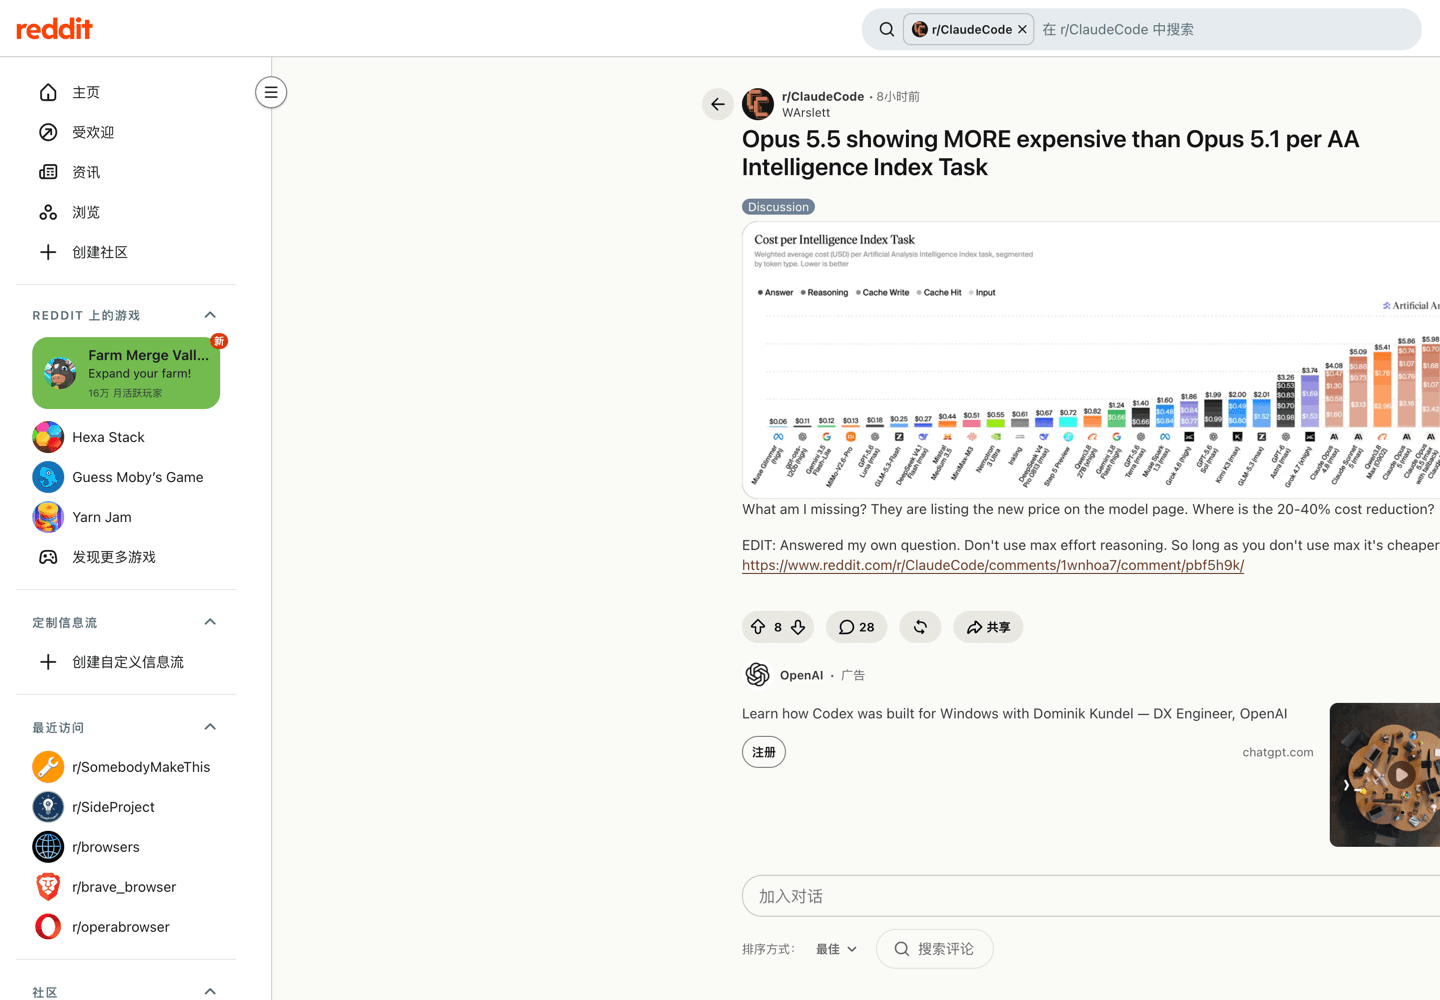
这句话的两半都成立,而两半之间的落差正是本文存在的原因。牌价表上,贡献最大的那一行是缓存读——降了 60%,降到与 Sonnet 5 持平的 $0.20。牌价表之外,r/ClaudeCode 有开发者在发布当天打开 Artificial Analysis,看到 Opus 5.5"按 AA 智能指数每任务成本显示比 Opus 5 更贵",随后自问自答:"别用 max 档推理。只要不用 max 它就更便宜"(r/ClaudeCode)。本页是 Opus 5.5 故事里管钱的那一半——能力背景见家族总览与Opus 4.8 的现状;后文预算理清之后,Tabbit Browser 会作为运行对比的实践选项出现。先看数字。
Key takeaways
费率卡: 每百万 token 输入 $4、缓存读 $0.20(0.05x——仅此模型的费率)、缓存写 $5/$8(5 分钟/1 小时)、输出 $20。Batch 全线五折至 $2/$10;Fast 模式全线翻倍至 $8/$40;US-only 推理对每一行加 1.1x。
降价主要来自一个数字。 缓存读从 $0.50 降到 $0.20(-60%)——Anthropic 自己说这一行"占 agentic 与编码工作成本的大头"。Opus 5.5 的缓存读现在与 Sonnet 5 持平,而模型强了一档。
effort 是最大的可控杠杆。 Artificial Analysis 测得 low 档每任务 $0.55、max 档 $5.98——16 个智能点数换来 11 倍成本摆动。默认档是 medium,且同一档位下它比 Opus 5 每轮思考更多。
没有长上下文断崖。 完整 100 万 token 窗口按标准价计费,Batch beta header 还允许 30 万输出 token。但 4.7 之后的新 tokenizer 同样文本产生的 token 比旧模型多约 30%。
订阅侧同步更新。 Opus 5.5 在 Pro/Max 按标准额度计(Fable 走周限 50% 的 usage credits),付费档 5 小时限额上调,限额重置可存起来随时用。
Claude Opus 5.5 费率速览
标准费率全表,来自 2026 年 9 月 23 日的 Anthropic 定价文档:
| 模型 | 输入 / 百万 | 5m 缓存写 / 百万 | 1h 缓存写 / 百万 | 缓存读 / 百万 | 输出 / 百万 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | $4.00 | $5.00 | $8.00 | $0.20 | $20.00 |
| Claude Fable 5.1 | $10.00 | $12.50 | $20.00 | $0.25 | $50.00 |
| Claude Opus 5 | $5.00 | $6.25 | $10.00 | $0.50 | $25.00 |
| Claude Sonnet 5 | $2.00 | $2.50 | $4.00 | $0.20 | $10.00 |
| Claude Haiku 4.5 | $1.00 | $1.25 | $2.00 | $0.10 | $5.00 |
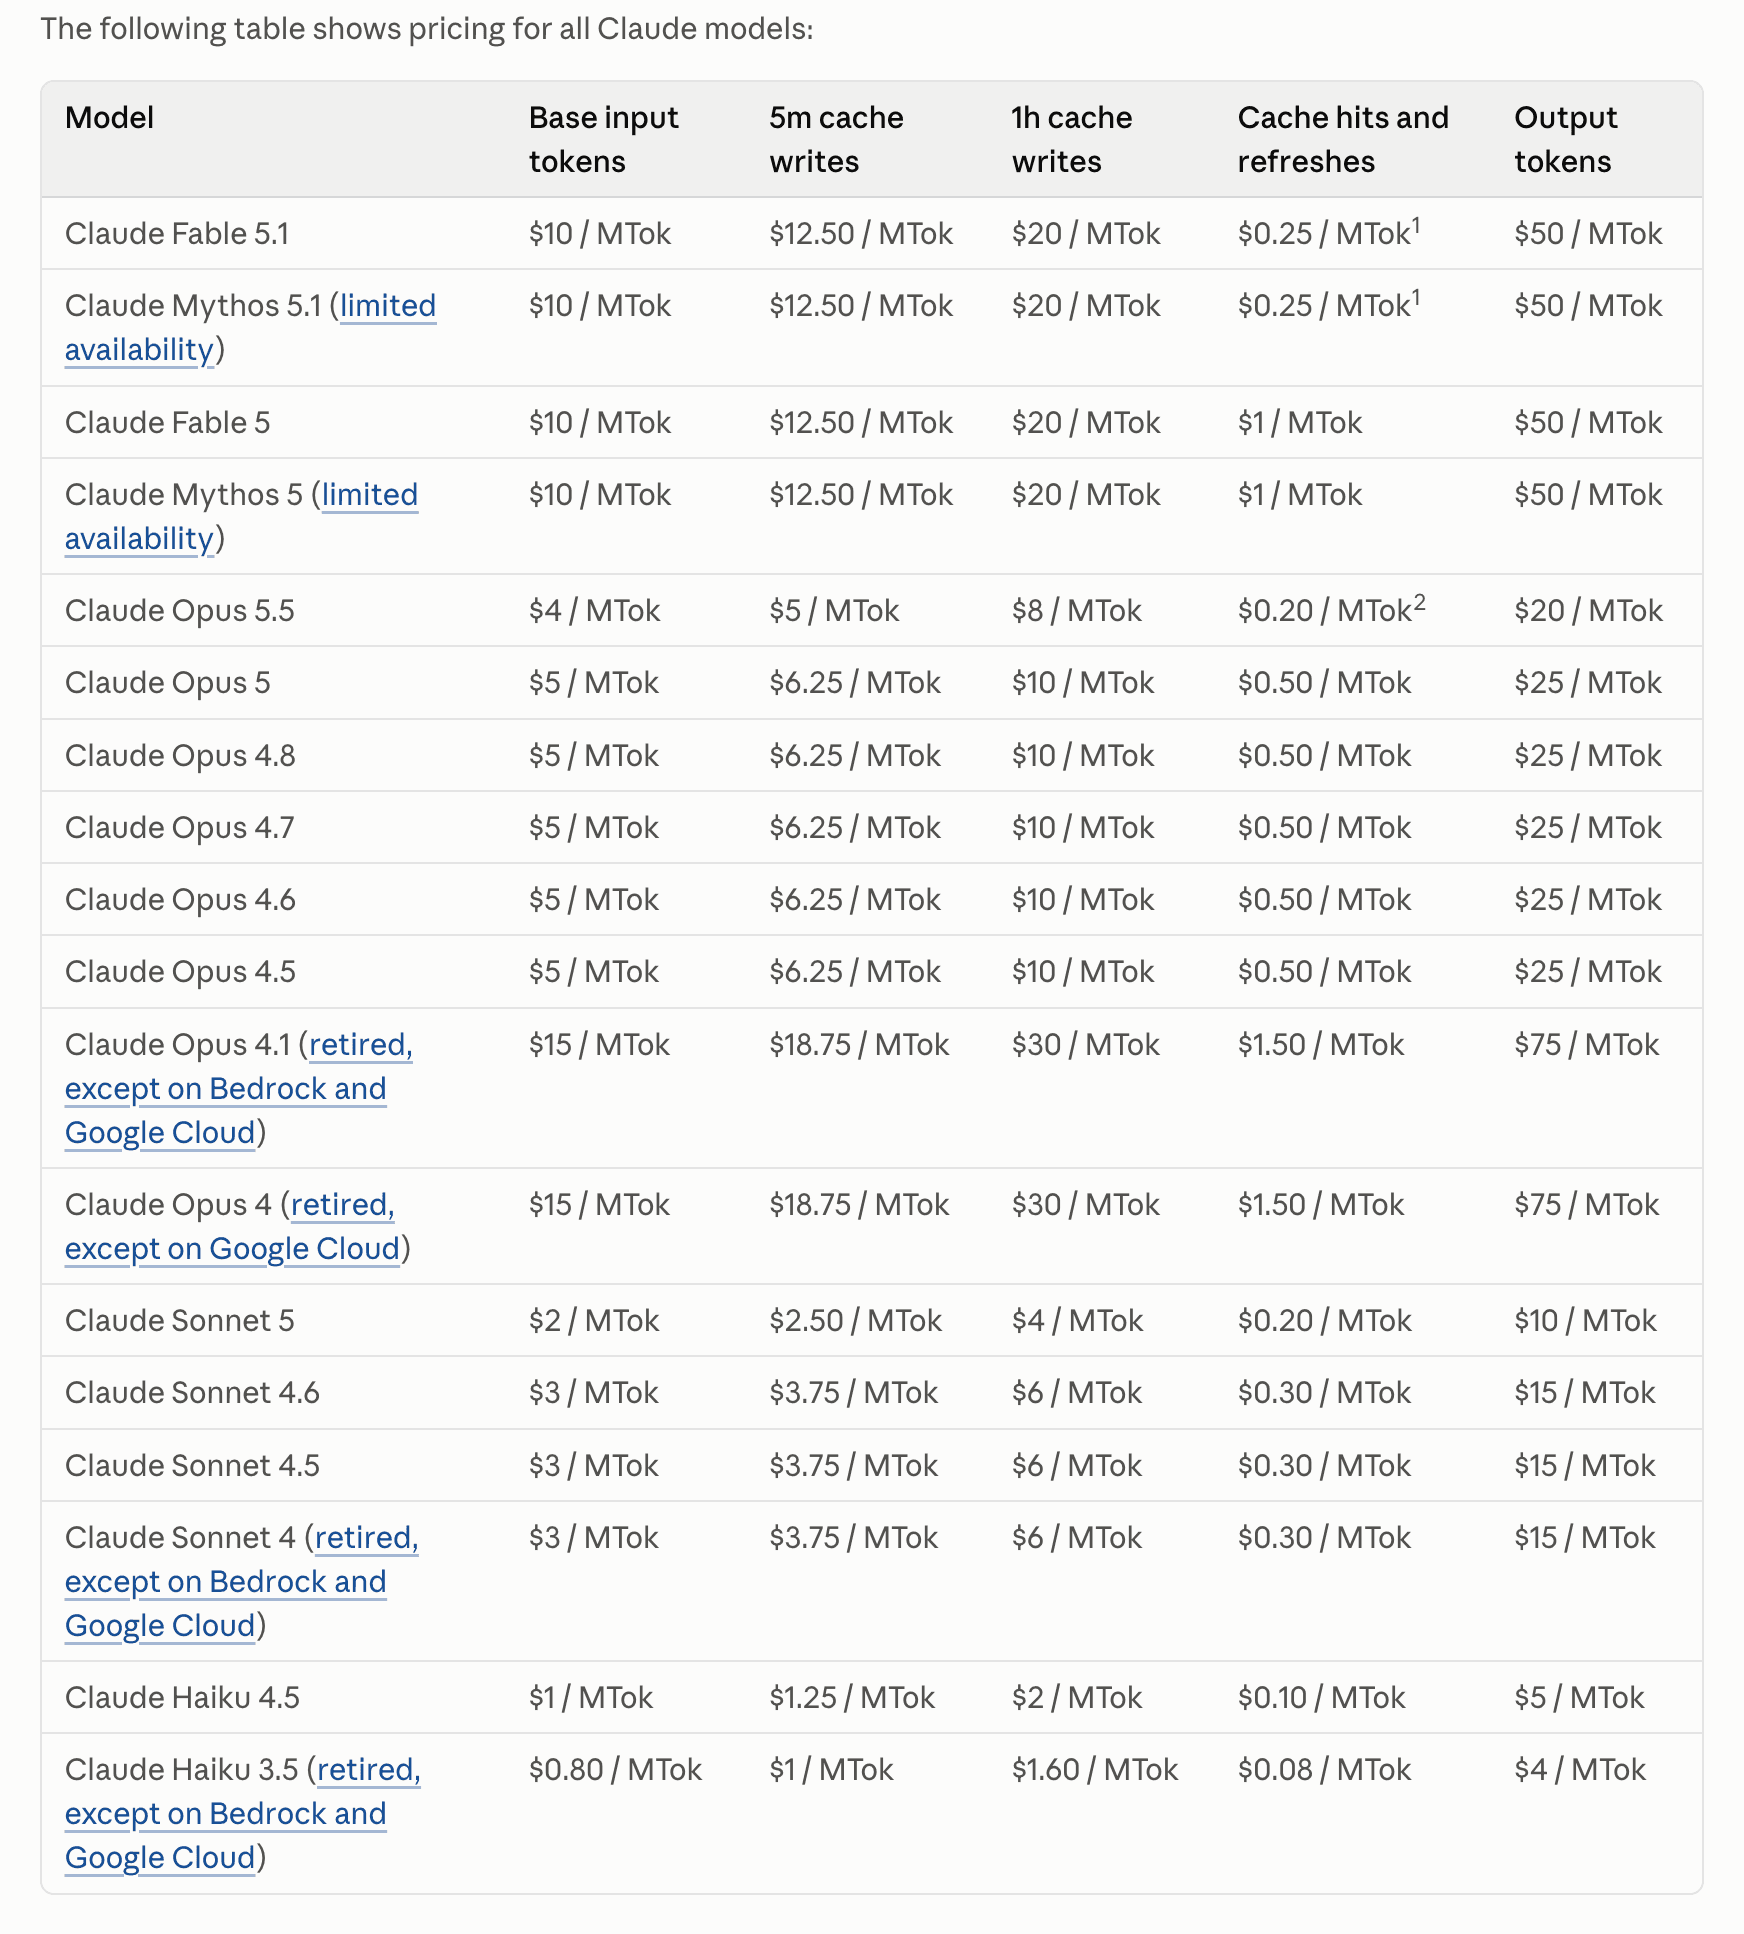
这张表里有三件事值得盯住,而且都不是头条的 $4:
缓存读有了自己的乘数。 其他标准模型的读取是基准输入价的 0.1x;Fable 5.1 和 Mythos 5.1 是 0.025x;Opus 5.5 按官方脚注介于两者之间,为 0.05x。结果是 $0.20——与 Sonnet 5 的缓存读完全一致。
输出仍是输入的 5 倍。 这个模型的自适应思考无法关闭,而思考 token 是计费输出。一个短提示带一条长推理链,本质是一张穿着输入外衣的输出账单。
tokenizer 早在两代前就换了。 Claude 4.7 及之后的模型同样文本产生约 30% 更多的 token,出自 Anthropic 自己的脚注。与 Opus 4.6 时代的单价直接对比,会把旧模型成本高估三分之一。
还有一点值得钉住:完整 100 万 token 窗口按标准价计费——不存在长上下文档位。与GPT-6 Astra 的 272K 断崖(跨过阈值后整个请求重新定价)不同,Anthropic 的原话是 Opus 5.5 上"一个 90 万 token 的请求与一个 9 千 token 的请求按同样的单价计费"。
变化最大的数字:缓存读降价 60%
Opus 5 到 Opus 5.5 之间五个计费行都动了,但对 agentic 工作真正重要的是读取那一行:每百万 $0.50 → $0.20,降 60%,并启用新的 0.05x 乘数。
机制:当请求重复使用此前处理过的提示前缀——系统提示、仓库上下文、对话历史、工具定义——API 从缓存读取该前缀而不是重新处理。写入按基准输入的 1.25x 计费(5 分钟条目,本模型 $5/百万)、2x 计费(1 小时条目,$8/百万)。读取按 0.05x 计费——$0.20/百万——仅此模型。缓存在 1 次 5 分钟重读或 2 次 1 小时重读后回本,乘数可与 Batch 和数据驻留定价叠加,最小可缓存提示为 512 token。
为什么它主导 agent 账单:一个在 20 万 token 上下文上做 40 次工具调用的 agent,会把该前缀重读 40 次。按 Opus 5 的 $0.50/百万,这些重读花 $4.00;按 Opus 5.5 的 $0.20/百万,花 $1.60——一个新 token 都还没生成。Anthropic 自己的发布页也指向这一行:缓存读"占 agentic 与编码工作成本的大头",60% 的降幅是官方 40% 说法里最大的一块。
同一故事的订阅侧现场:
"Usage drains so slowly with opus 5.5. Have multiple threads going on xhigh and max and the usage bar is hardly budging",一条回复这样写;另一位用户报告两个大任务后周额度几乎没动。这些是自述的套餐体验,不是基准测试——但方向与 API 数学一致:agentic 预算就住在读取那一行上。
和以往一样的陷阱:缓存省钱要求前缀稳定。如果你的上下文每轮都在变——动态工具输出、轮换文档——你会反复支付 1.25x–2x 的写入惩罚,而不是搭 0.05x 读取的顺风车。另外 Opus 5.5 的 thinking blocks 与模型和会话绑定;前缀一改就失效,这正是下一节的缩影。
"便宜 40%"到底指什么
Anthropic 的发布口径有三个精确条件,拆开读才不会把预算写成愿望。"我们的测试显示,在默认设置下,典型工作负载的成本将比 Opus 5 低 40%。"
条件一:基线是 Opus 5,不是竞品,也不是 Fable。这个说法由两个效果合成——约 20% 的牌价下调加上每任务更少的 token("它每 token 比 Opus 5 便宜,且每任务用的 token 更少,合计成本下降 40%")。Anthropic 自己的算例落在同一区间甚至更高:HAProxy 的 C 到 Rust 重写 9.5 小时完成,Fable 5.1 用了 12 小时,成本低 51%;20 万行代码库审计 3 小时内完成,Opus 5 用了 20 多个小时且耗 2.5 倍 token。具名早期用户报告 40–50% 的成本下降(Spotify)、一半的 token(Kiro)、三分之一的 token(Box),以及"第一个我们默认用 medium 档的模型"(Factory)。HN 上有评论者一句话画出了趋势线:"三周前发布的上一代还号称前沿,这次直接把性能/成本比提高了约 3–6 倍"(Hacker News)。
条件二:"默认设置"指 medium 档。 拉到 max 档时数学会反转——按官方行为说明,"同一 effort 档位下,该模型往往比 Claude Opus 5 每轮思考更多,在 xhigh 和 max 尤其明显",而计费的思考正是预算杀手。r/ClaudeAI 的对拍帖把形状量化了:"max 档下,AA 测得 Opus 5.5 每任务约 11.9 万输出 token,而 [GPT-6] Sol 只用了约 3.1 万,跑完整个指数每任务 $1.06":
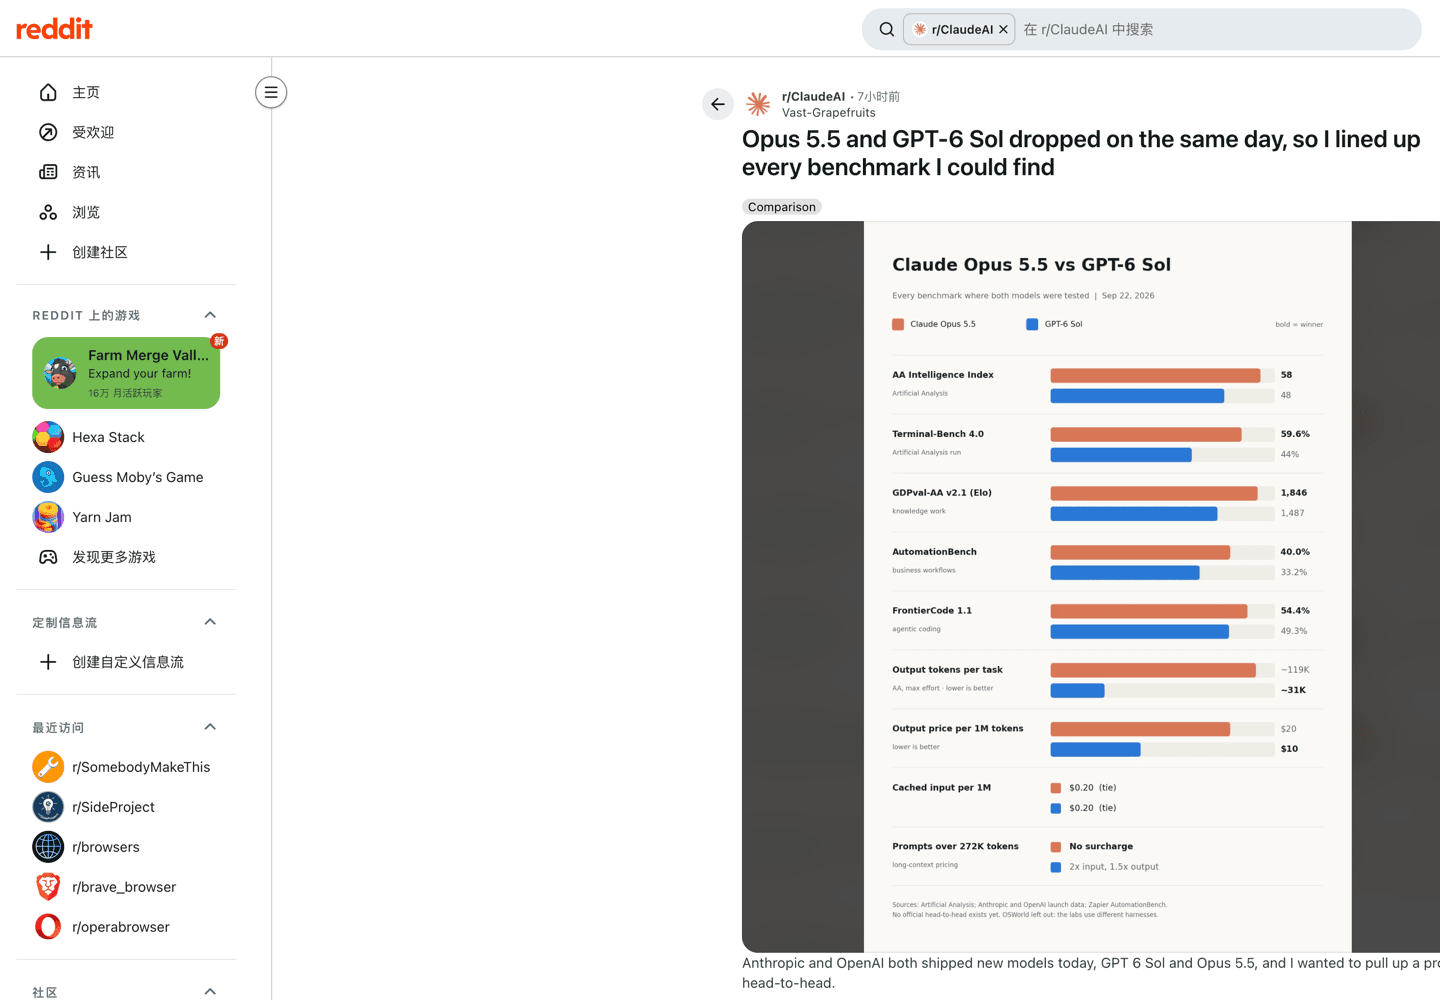
条件三:"典型工作负载"意味着你的未必典型。 社区在这里带着伤疤,而且这伤疤是有价格的。发布新闻帖下的最高赞评论(226 赞):
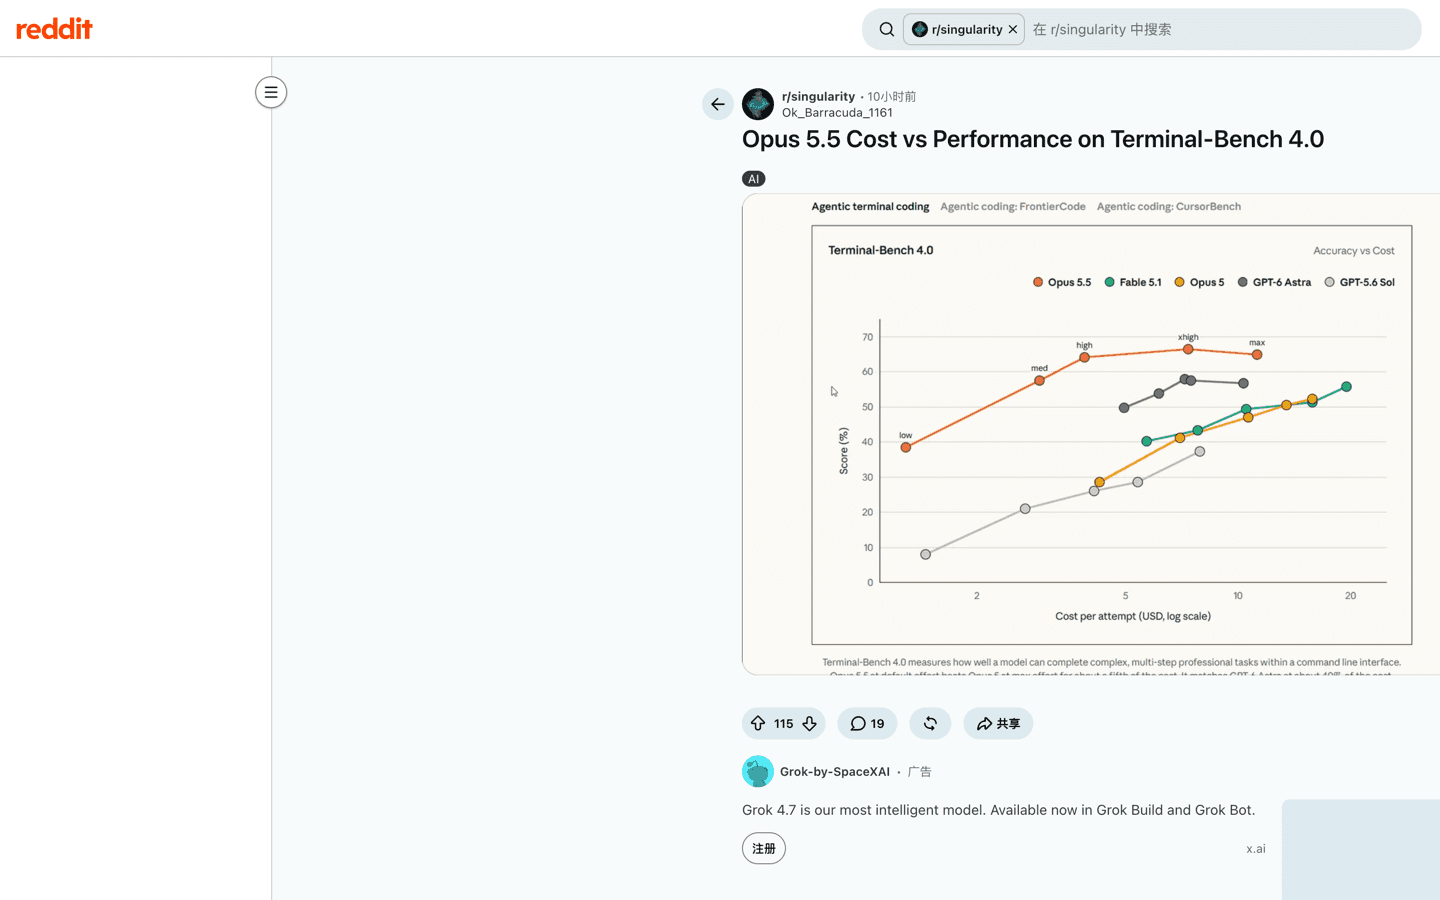
"当 Opus 5 刚发布时,他们一直宣称模型多么前沿……用了一段时间后大家发现 Opus 5 连正常沟通都做不到……来回拉扯让很多人自我怀疑,浪费了更多时间和 token。"同一网络上的怀疑者把 AA 图表往另一个方向读——"opus 5.5 击败了 astra……但完成相同任务用了 4.5 倍的 token"——而辩护者读出的是"opus 5.5 medium 对 Astra max 同等性能,便宜 2.5 倍"。两边读的是同一场发布。你的账单更像哪一边,取决于哪种 token 占主导——这正是下一节要量的东西。这轮取舍的能力面见Fable 5.1 测评与我们的 agentic 推理指南。
effort 杠杆:每任务 $0.55 到 $5.98
费率卡上没有任何一行告诉你:这个旋钮对成本的拉动超过所有牌价。Artificial Analysis 把 Opus 5.5 作为五个条目跟踪;2026 年 9 月 23 日快照:
| effort | 智能指数 | 每任务成本 | 输出速度 |
|---|---|---|---|
| low | 42 | $0.55 | 83 t/s |
| medium(默认) | 51 | $1.34 | 76 t/s |
| high | 54 | $1.82 | 90 t/s |
| xhigh | 56 | $3.46 | 76 t/s |
| max | 58 | $5.98 | — |
把两端放在一起读:max 档每任务成本是 low 档的 10.9 倍,换来 16 个测量智能点。 medium——默认档——的智能指数与 Opus 5 的 max 档持平($1.34 对 Opus 5 的 max 档定价)。r/ClaudeCode 帖子里最高赞的回复正是这个意思:"max 的成本几乎是 xhigh 的两倍,而且它和其他档位完全不成比例。用 medium 或 high 你会看到实打实的成本节省。"那里有位开发者已经围绕这个阶梯重构了工作流:"Opus 5.5 High 非常棒。感觉像 fable 5.1 medium,但便宜得多……我把工作流改成大部分事情用 Opus 5.5 high。"
调低或调高档位前有两个注意事项。第一,迁移:默认档从 high(Opus 5)变成了 medium,而同一档位下新模型每轮思考更多——Anthropic 文档明确要求重跑 effort 扫描而不是照搬设置,并给思考 token 在 max_tokens 里留出空间。第二,更高的 effort 不保证更高的质量。CodeRabbit 发布当天的评测发现"更高的推理 effort 并没有稳定带来更好的完成率"——而且更多需要人审读的评论本身就是成本:
发布页的客户引语方向一致——Rogo 用"最低 effort 档"胜过 Opus 5 的 high 档、"输出 token 少约 60%";Walleye Capital 在最低档"基本解决"了他们的评测套件。当厂商自己的证据不断指向便宜档位时,把它当默认答案,把 max 留给确实需要它的任务。
头条之外的计费线
五条线决定大多数真实账单,而只有第一条出现在发布报道里。
Fast 模式:全线 2 倍,换最高 2.5 倍速度。 Fast 模式(research preview,仅 Claude API)按 $8 输入 / $40 输出计费——标准卡的两倍,缓存线也一样(读取 $0.40)。它可与缓存和数据驻留叠加,不能与 Batch 组合,输出"快至 2.5 倍";OpenRouter 的供应商表测得 Fast 143 tok/s,标准为 71–83。值得注意的是,Fast Opus 5.5 的 $40/百万输出仍低于 Fable 5.1 标准价的 $50。
Batch:五折杠杆。 异步 Batch 请求按 $2/$10 计费——全卡最大折扣,与提示缓存叠加覆盖整个上下文窗口,beta header 允许最高 30 万输出 token。托管 agent 会话不符合条件;它们有状态且交互式。
US-only 推理:全类目 1.1x。 设置 inference_geo: "us" 会把每一类——输入、输出、缓存写、缓存读——乘以 1.1x。同样的 10% 也出现在合作云的区域端点上:OpenRouter 列出的 Bedrock/Azure/Vertex 区域路由为 $4.40/$22.00/$0.22。合规驱动的区域为每一行安静地多付一成;全球路由是默认也是更便宜的路径。
工具开销就是 token 账单。 工具使用系统提示每请求加 286 token(低于 Opus 4.7 的 675);声明浏览器工具集约加 6,600 输入 token,computer use 约 4,500。服务端网页搜索在 token 之外每千次收 $10;代码执行与搜索/fetch 搭配免费,每月 1,550 小时免费容器时长后按 $0.05/小时计。"agent"是一种定价结构,不是一次聊天——工具那一行要单独编预算。预算端的对照见 Kimi K3 定价拆解。
Managed Agents 运行时:每会话小时 $0.08,只在 running 状态计费,所有 token 线按模型价。Batch 不适用于会话。
家族阶梯:Opus 5.5 vs Fable 5.1 vs Opus 5 vs Sonnet 5
| 线项(每百万 token) | Opus 5.5 | Fable 5.1 | Opus 5 | Sonnet 5 |
|---|---|---|---|---|
| 输入 | $4.00 | $10.00 | $5.00 | $2.00 |
| 缓存读 | $0.20(0.05x) | $0.25(0.025x) | $0.50(0.1x) | $0.20(0.1x) |
| 输出 | $20.00 | $50.00 | $25.00 | $10.00 |
| Batch 输入 / 输出 | $2.00 / $10.00 | $5.00 / $25.00 | $2.50 / $12.50 | $1.00 / $5.00 |
| AA 智能指数(max 档) | 58 | 53 | 51 | 38 |
| AA 每任务成本(max 档) | $5.98 | $7.63¹ | — | — |
¹ Fable 5.1 为 AA 9 月 22 日快照,经我们的 Fable 定价拆解;两个 AA 页面每天都在变。
反直觉的一行是最后一行:在 Artificial Analysis 的指数上,更便宜的模型现在也是更强的模型。 Opus 5.5 max 档得分 58 对 Fable 5.1 的 53,每任务成本 $5.98 对 $7.63——而 Anthropic 自己的定位仍把 Fable 留给"有雄心的、长时运行的异步工作",并承认 Opus 与 Fable 的差距"比这些分数显示的更小"。这对组合的正确读法是:分数夸大了差距,但价格差距是真实的且方向反了。缓存上下文循环两者更接近——Fable 保有最深的读取折扣(0.025x),但它的读取从 $10 基准起算:$0.25/百万。Opus 5.5 的 $0.20 读取在绝对值上更低。
同一张 AA 图的两种社区读法,并排放着:
"same tokens … same performance opus 5.5 med vs Astra max — 2.5x cheaper"对"opus 5.5 击败了 astra……但用了 4.5 倍的 token"。两者描述的是同一个形状:Opus 5.5 赢在每完成任务成本,输在每任务 token。如果你的工作负载对 token 形状敏感——严格的按 token 预算、第三方路由、吞吐上限——迁移前先实测;如果是任务形状敏感,阶梯几乎每一级都偏向 Opus 5.5。
旗舰之下,Sonnet 5 以 $2/$10 保持预算席位,$0.20 的读取——现在与 Opus 5.5 同价——以及 Haiku 4.5 的 $1/$5。阶梯的新逻辑是:缓存读这一列已经压缩到聪明的模型和便宜的模型对 agent 打得最狠的那一行收一样的钱。
不收钱的部分
文档里的几条边界写得像退款政策,在 agentic 规模下很要紧:
被丢弃的 thinking blocks 不计费。 请求携带模型无法读取的 thinking block 时,API 会在推理前丢弃它:"请求成功,被丢弃的 blocks 不计费"。对一个思考块与会话绑定的模型来说,这是优雅降级线。
护栏转写由其他模型完成。 按发布页基准脚注,网络安全类请求由 Opus 4.8 完成;转写透明(拒答返回带政策域的
stop_reason: "refusal",服务端 fallback 会换推荐模型重试)。Anthropic 没有像对 Fable 那样明写 Opus 5.5 的转写计费模型——在文档明确前,按完成模型自身的费率假设是稳妥的。失败的网页搜索不计费。 成功的每千次 $10;出错的不收。web fetch 除抓取内容变成的 token 外不另收费。
代码执行与搜索或 fetch 搭配免费,每个组织每月 1,550 小时免费容器时长,超出后 $0.05/小时。
套餐可得性:API、云与消费订阅
API 费率卡只是三套经济体系之一。2026 年 9 月 23 日在 claude.com/pricing 与平台文档核对:
| 渠道 | 价格(页面核验值) | Opus 5.5 可用性 |
|---|---|---|
| Anthropic API | 上文 token 费率 | 可用 — claude-opus-5-5 |
| Free 层 | $0 | 不可用(仅 Sonnet/Haiku) |
| Pro | 年付 $17/月(预付 $200)或月付 $20 | 可用 — 标准额度 |
| Max 5x / 20x | $100 起/月 | 可用 — 标准额度 |
| Team | Standard 席位高于 Pro;Premium = 5x Standard | 可用 |
| Enterprise | 年付 $20/席位/月 + 按 API 费率的用量 | 可用,带支出管控 |
| 云平台 | AWS Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWS | 可用;区域端点 +10%,Foundry 按 CCU 计量 |
值得划线的订阅行:套餐对比页上,Opus 在 Pro/Max 按标准用量额度计——带"usage credits,周限 50%"星标的是 Fable。一个 Fable 小时对额度来说值两个标准模型小时;Opus 5.5 不这样。发布时 Anthropic 还叠加了两项变化:Pro、Max、Team 和按席位计费 Enterprise 的 5 小时使用限额上调,以及"现在可以保存、随时使用"的限额重置。
社区对实际意义的看法分裂,两个方向都在发布周的同一批帖子里:
"I am using Fable 5.1 rn, and this is 5x cheaper for same intelligence? I am never going to hit my weekly limits at this rate"——对上——"这些降价不必然传导到订阅……他们拿 API 成本当营销材料,同时把尺度向 API 用户倾斜。"限额上调有文档;它到底多慷慨,只有你自己的 5 小时窗口能回答。机制上:用量按 5 小时滚动会话窗口重置,付费档再叠加周限;网页/桌面/移动/Claude Code 共用一个池;付费档的 usage credits 可在超限后按标准 API 价继续使用。
两个算例,所有假设摊开
标准费率,不含重试、工具、税费。是算术,不是预测。
一个带长思考的短问题。 输入 10,000 token,输出 2,000:
(10,000 × $4 + 2,000 × $20) / 1,000,000 = $0.08大型仓库上的冷启动 agent 循环。 输入 300,000 token(标准价——没有长上下文档位),输出 8,000:
(300,000 × $4 + 8,000 × $20) / 1,000,000 = $1.36同一循环的暖启动版。 同样的 300,000 token 上下文,90% 缓存命中,每会话一次 1 小时写入,每轮输出 8,000:
每轮: (270,000 × $0.20 + 30,000 × $4 + 8,000 × $20) / 1,000,000 = $0.334
一次性: 300,000 × $8 / 1,000,000 = 每会话写入 $2.40
暖启动每轮成本降到冷启动的四分之一,$2.40 的写入由每次复用摊薄——5 分钟写入($1.50)一次重读回本,1 小时写入两次回本。前缀一翻新,同一个循环每轮都按 $1.36 冷启动。模型资源页和它的提示词合集整理了可复用任务,方便你测自己的命中率。
本地计算
估算 Claude Opus 5.5 API token 成本
使用 2026-09-23 核对的官方美元费率。输入值仅在浏览器本地处理。
缓存命中按每百万 token $0.20 计费——Opus 5.5 的 0.05x 费率。该估算不含重试、工具开销、护栏转写和代理商加价。Fast 模式对全部线项翻倍,且不能与 Batch 叠加。 核对最新费率
计算器完全在本页运行——不向任何地方发送数据。它计算两种缓存写入时长以及标准、Batch、US-only、Fast 四种模式,并在本地校验输入。它有意不建模的部分:重试、子 agent 扇出、工具开销和护栏转写——这些放进你的余量。提交预算前请重查官方费率卡;本文是 2026 年 9 月 23 日的数字。
一个实践选项:在 Tabbit 里跑对比
预算理清之后是枯燥的部分:真正运行 Opus 形态的工作,需要一个页面、文件和模型调用共处一处的环境,需要"用 medium 试 Opus 5.5、不行退回 Sonnet"是一次选择而不是一个编排项目。这正是 Tabbit Browser 占据的位置——一款agentic AI 浏览器,模型选择器、实时标签页和本地文件共享同一个界面。
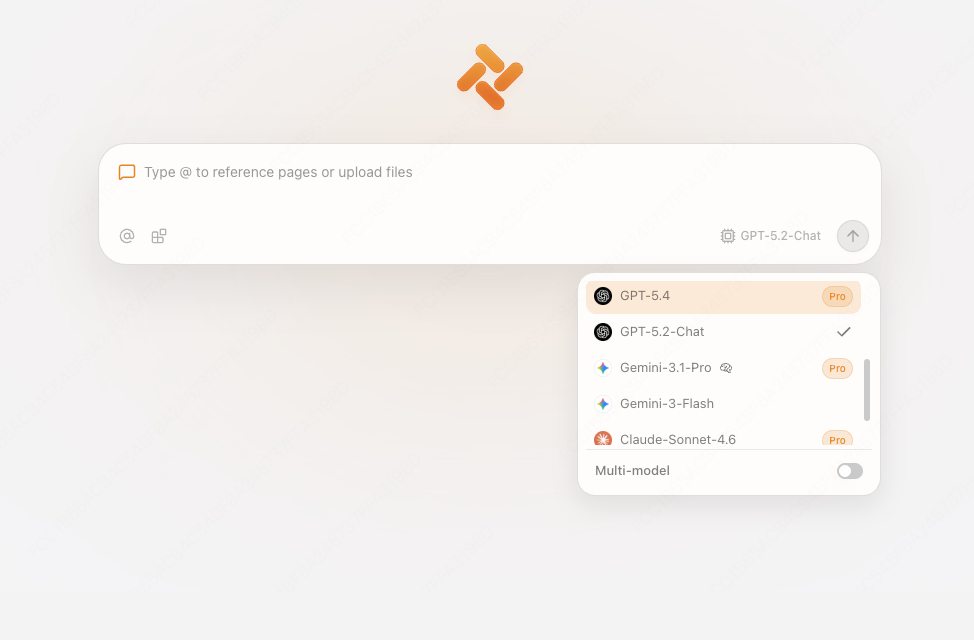
边界说明白:Tabbit 是客户端,不是 Anthropic 的计费层。模型可用性取决于你的账户和版本,浏览器里的任何东西都不改变 Anthropic 收什么费——上面的费率卡在 Opus 5.5 运行的任何地方都适用。本文没有在 Tabbit 内运行 Opus 5.5 任务,因此不做任何可用性或性能声明。浏览器改变的是搭建成本:在真实工作上测你自己的缓存命中率和 effort 阈值——本文通篇说这两个数字决定你的账单——在为这件事而生的工作台里做最便宜。方法见 Tabbit 使用习惯指南。
 Tabbit Browser
Claude Opus 5.5 定价决策表
| 你的工作负载 | 成本驱动 | 最佳起点 | 注意 |
|---|---|---|---|
| 长 agent 循环、稳定的仓库/文档上下文 | 缓存读 | 标准层 + 前缀稳定 + 1 小时写入 | 前缀改动使绑定的 thinking blocks 失效;上下文翻新会把读变成 1.25–2x 写 |
| 短对话、快速修改 | 输出 token | 更低 effort——或 Sonnet 5 | 思考不可关闭;默认 medium 通常够用 |
| 过夜评测、批量重构 | 体量 | Batch API $2/$10、30 万输出 beta | 交互式和托管 agent 会话不符合条件 |
| 延迟敏感的交互工作 | 输出速度 | Fast 模式 2x($8/$40),配缓存 | Fast 不能与 Batch 组合;它让每一行翻倍 |
| 合规要求的美国内处理 | 每一行 | US-only 1.1x,或区域云端点(+10%) | 加价同样作用于缓存读 |
| 对 token 形状敏感的预算(路由、上限) | 每任务 token | 迁移前先实测 | Opus 5.5 赢每任务成本、输每任务 token |
| 基于订阅的日常使用 | 5 小时窗口 | Pro/Max——Opus 按标准额度计且限额上调 | 同套餐的 Fable 走周限 50% 的 usage credits |
最终裁决
Claude Opus 5.5 是第一代比前任便宜的 Opus,而且每一行都是真的——输入输出降 20%,主导 agentic 账单的缓存读降 60%,现在与 Sonnet 5 同价。为长时程 agentic 编码和知识工作买它,用 medium 档,前缀保持稳定,能等的工作全部交给 Batch;在 AA 指数上它已经以更低的每任务成本超过 Fable 5.1,家族阶梯因此重排。它修不好的两笔账:max 档思考(费率卡上永远看不到的 11 倍杠杆)和对 token 形状敏感的预算(每任务 token 仍多于更精瘦的对手)。订阅上它是额度友好的旗舰——标准用量、限额上调——但给团队切换前先核对自己 5 小时窗口的消耗。每月重查官方定价页:Sonnet 5 转正和这次发布都说明阶梯变得很快。能力故事见 Fable 5.1 总览与测评;上文链接的社区记录承载工作负载证据;跨家族价格对比展示同样的牌价在别处值多少钱。
Sources
Anthropic 定价文档——费率卡、0.05x 缓存脚注、Fast 模式、Batch、驻留、工具计费;2026-09-23 核对
Claude Opus 5.5 模型页与更新说明——规格、默认 effort、破坏性变更、"每轮思考更多"、丢弃 blocks 的计费;2026-09-23 核对
Anthropic 发布页——40% 口径与条件、HAProxy 算例、客户成本引语、限额上调、护栏转写;2026-09-23 核对
claude.com/pricing——Free/Pro/Max 套餐对比与 Opus/Fable 额度规则;2026-09-23 核对
Artificial Analysis 发布页——effort 档智能、速度、每任务成本快照;2026-09-23 核对
OpenRouter Opus 5.5——供应商费率、区域端点、Fast 吞吐;2026-09-23 核对
社区记录(截图与条件见正文):r/ClaudeCode max 档疑问、r/ClaudeAI Sol 对拍、r/ClaudeAI 发布帖、r/singularity 订阅分歧、X 图表两种读法、CodeRabbit 评测视频、HN 发布帖

常见问题
Claude Opus 5.5 多少钱?
在 Anthropic API 上,Claude Opus 5.5 每百万输入 token 收 $4、每百万输出 token 收 $20,2026 年 9 月 23 日在 Anthropic 官方定价文档核对。提示缓存写入为每百万 $5(5 分钟)或 $8(1 小时),缓存读取为每百万 $0.20——这一 0.05x 费率仅此模型适用。Batch API 全线五折至 $2/$10,Fast 模式全线翻倍至 $8/$40。
Claude Opus 5.5 比 Opus 5 便宜吗?
费率卡上每一行都降了:输入输出比 Opus 5 的 $5/$25 低 20%,缓存写入从 $6.25/$10 降到 $5/$8,缓存读从 $0.50 直降 60% 到 $0.20。Anthropic 估算典型工作负载在默认设置下总成本约低 40%。例外是 effort 档位:max 档每轮思考更多,独立测得的每任务成本从 low 的 $0.55 到 max 的 $5.98,相差 11 倍——这在牌价表上看不到。
Claude Opus 5.5 在免费层可用吗?
不可用。Anthropic 的套餐对比页标注 Opus 在 Free 层不可用,Free 层只有 Sonnet 和 Haiku。Opus 5.5 包含在 Pro、Max、Team、Enterprise 的标准额度内——值得注意的是按标准额度计,而不是 Fable 5.1 在 Pro/Max 上的 usage credits 机制。发布同时 Anthropic 还上调了 Pro、Max、Team 和按席位计费的 Enterprise 的 5 小时使用限额,并新增可保存备用的限额重置。
运行 Claude Opus 5.5 最省钱的方式是什么?
按顺序用杠杆:保持提示前缀稳定,让重读按每百万 $0.20 而不是 $4 计费;在能通过验收的最低 effort 档运行(默认 medium 通常够用);不紧急的工作走 Batch API 的 $2/$10;没有合规或延迟需求就不用 US-only 和 Fast 模式。迁移时还要重跑 effort 扫描:同一档位下 Opus 5.5 比 Opus 5 每轮思考更多。
Claude Opus 5.5 长上下文额外收费吗?
不收。完整的 100 万 token 上下文窗口按标准单价计费,没有长上下文档位,提示缓存和 Batch 折扣覆盖整个窗口。Batch API 上有 beta header 可把最大输出提到 30 万 token。注意 Claude 4.7 及之后的模型使用新 tokenizer,同样文本产生的 token 比旧模型多约 30%。
护栏转写或失败的工具调用会按 Opus 5.5 价格计费吗?
被护栏转写的请求由其他模型完成——Anthropic 表示网络安全类工作由 Opus 4.8 处理——且转写透明上报,而不是默默按本模型计费。失败的网页搜索完全不计费;web fetch 除内容本身 token 外不另收费;模型无法读取的 thinking blocks 会在推理前被丢弃且不收费。代码执行与网页搜索或 fetch 搭配时免费,单独使用每月有 1,550 小时免费容器时长。