
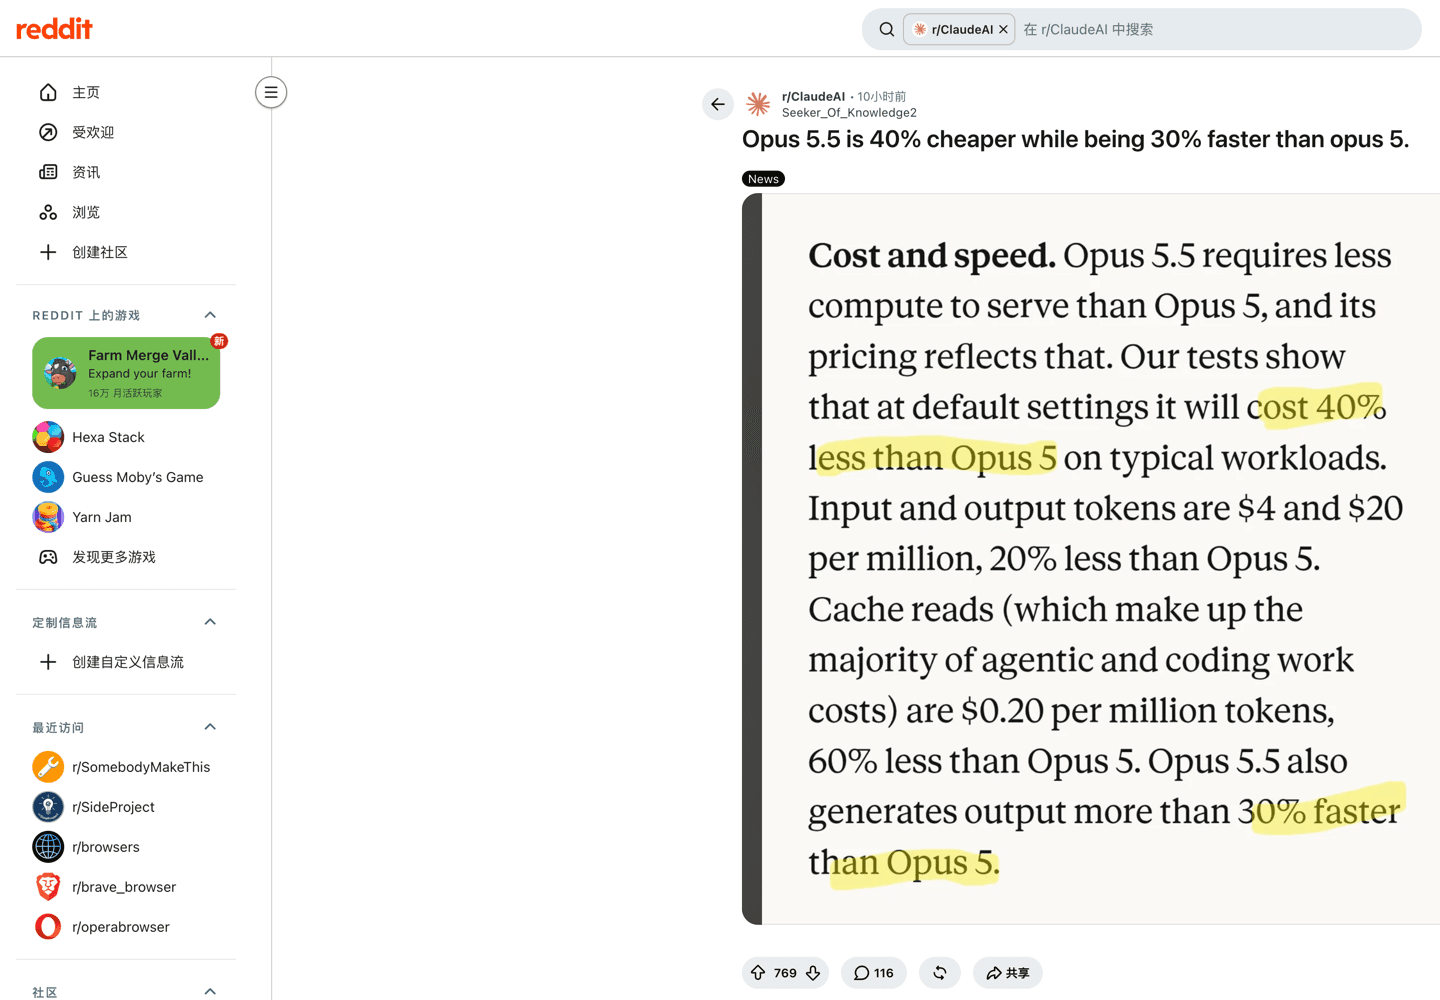
Claude Opus 5.5 coûte $4 par million de tokens d'entrée et $20 par million de tokens de sortie sur l'API Anthropic, avec des lectures de cache à $0,20 par million — chaque tarif vérifié sur la documentation tarifaire d'Anthropic elle-même le 23 septembre 2026, au lendemain de la sortie. Cette fois, la grille tarifaire est la nouvelle : les cinq lignes de facturation ont baissé par rapport à Opus 5, première génération d'Opus à se placer sous son prédécesseur. Cinq générations d'Opus — de la 4.5 à la 5 — s'affichaient toutes à $5/$25, et la plus récente devient soudain la moins chère. L'estimation d'Anthropic : « aux réglages par défaut, elle coûtera 40% de moins qu'Opus 5 sur des charges de travail typiques ».
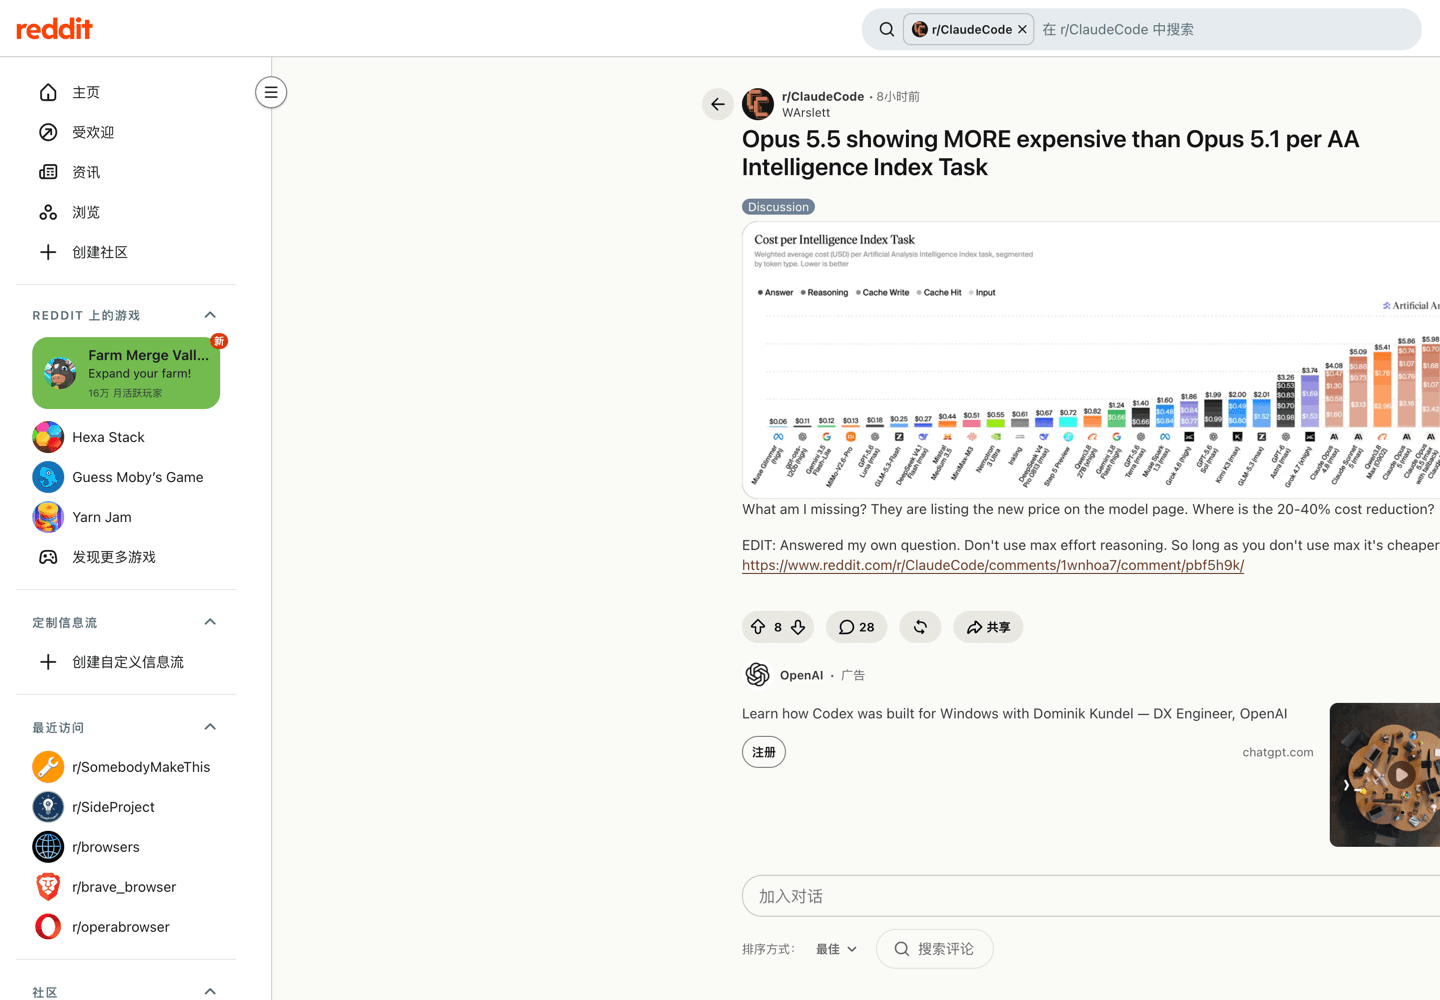
Les deux moitiés de cette phrase sont vraies, et l'écart entre elles est la raison d'être de cet article. Sur la grille officielle, une ligne a fait l'essentiel du travail — les lectures de cache ont chuté de 60%, jusqu'aux $0,20 que facture Sonnet 5. Hors grille, un développeur de r/ClaudeCode a ouvert Artificial Analysis le jour du lancement et a vu Opus 5.5 « s'afficher PLUS cher qu'Opus 5.1 par tâche de l'AA Intelligence Index », puis a répondu à sa propre question : « N'utilisez pas le raisonnement à effort max. Tant que vous n'utilisez pas max, c'est moins cher » (r/ClaudeCode). Cette page est le versant argent de l'histoire d'Opus 5.5 — la présentation de la famille et le statut hérité d'Opus 4.8 portent le fond de capacités ; plus loin dans le guide, Tabbit Browser apparaît comme un endroit pratique pour exécuter ces comparaisons une fois le budget posé. D'abord, les chiffres.
Key takeaways
La grille : $4 en entrée, $0,20 en lecture de cache (0,05x — un tarif qu'Opus 5.5 est seul à avoir), $5/$8 en écriture de cache (5m/1h), $20 en sortie par million de tokens. Batch divise tout par deux ($2/$10) ; le mode Fast double tout ($8/$40) ; l'inférence US-only ajoute 1,1x à chaque ligne.
Un seul chiffre a fait l'essentiel de la baisse. Les lectures de cache ont chuté de 60% ($0,50 → $0,20) — la ligne qu'Anthropic lui-même dit représenter « la majorité des coûts des travaux agentiques et de code ». La lecture de cache d'Opus 5.5 égale désormais celle de Sonnet 5, pour un modèle deux crans au-dessus.
L'effort est le plus grand levier contrôlable. Artificial Analysis mesure $0,55 par tâche en effort low et $5,98 en max — une amplitude de 11x pour 16 points d'intelligence. Le défaut est medium, et le modèle pense plus par tour qu'Opus 5 à réglage égal.
Pas de falaise de contexte long. Toute la fenêtre d'1M de tokens est facturée au tarif standard, et un header bêta de Batch autorise 300K tokens de sortie. Mais le tokeniseur récent produit ~30% de tokens en plus pour le même texte que les modèles pré-4.7.
Les abonnements ont reçu une mise à jour parallèle. Opus 5.5 entre dans l'allocation standard en Pro/Max (Fable brûle des crédits d'usage à 50% des limites hebdomadaires), les limites de cinq heures ont été relevées sur les offres payantes, et les réinitialisations de limite peuvent désormais être gardées pour plus tard.
Les prix de Claude Opus 5.5 en un coup d'œil
La grille standard complète, rendue depuis la documentation tarifaire d'Anthropic le 23 septembre 2026 :
| Modèle | Entrée / 1M | Écriture 5m / 1M | Écriture 1h / 1M | Lecture cache / 1M | Sortie / 1M |
|---|---|---|---|---|---|
| Claude Opus 5.5 | $4,00 | $5,00 | $8,00 | $0,20 | $20,00 |
| Claude Fable 5.1 | $10,00 | $12,50 | $20,00 | $0,25 | $50,00 |
| Claude Opus 5 | $5,00 | $6,25 | $10,00 | $0,50 | $25,00 |
| Claude Sonnet 5 | $2,00 | $2,50 | $4,00 | $0,20 | $10,00 |
| Claude Haiku 4.5 | $1,00 | $1,25 | $2,00 | $0,10 | $5,00 |
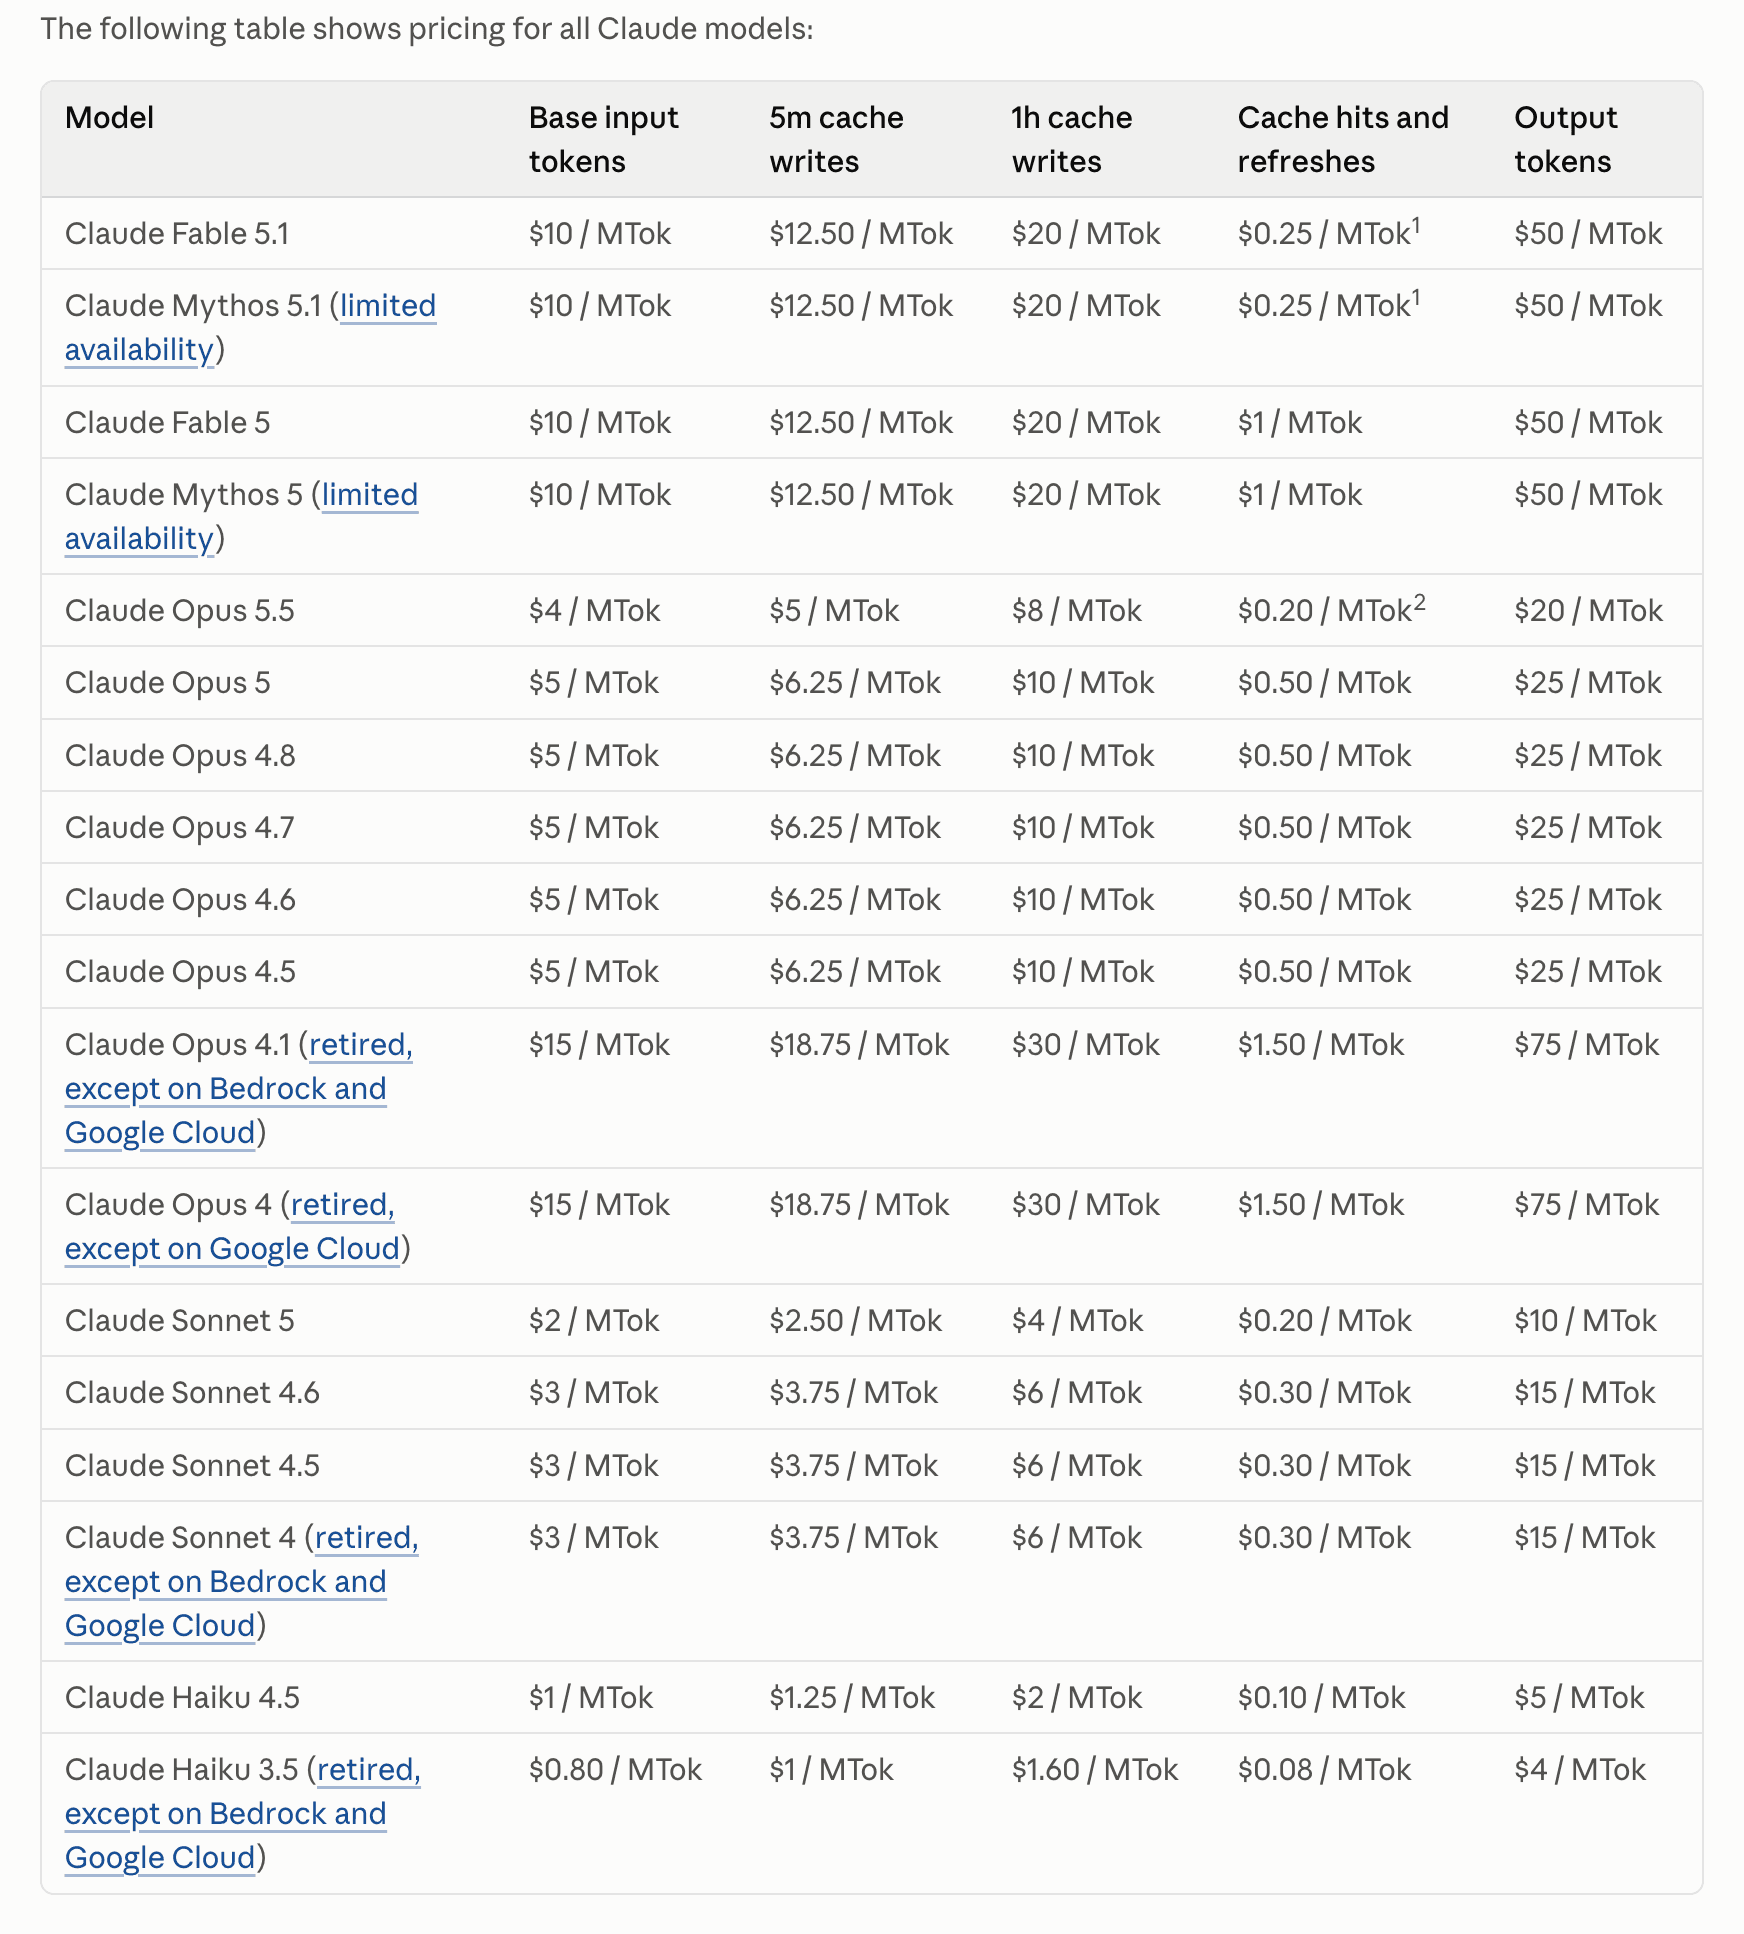
Trois choses dans ce tableau méritent l'attention, et aucune n'est le $4 du titre :
Les lectures de cache ont maintenant leur propre multiplicateur. Les lectures des autres modèles standards coûtent 0,1x l'entrée de base ; Fable 5.1 et Mythos 5.1 paient 0,025x ; Opus 5.5 se situe entre les deux à 0,05x, selon la note de bas de page d'Anthropic. Résultat : $0,20 — identique à la lecture de cache de Sonnet 5.
La sortie reste 5x l'entrée. Le raisonnement adaptatif ne peut pas être désactivé sur ce modèle, et les tokens de pensée sont une sortie facturable. Un prompt modeste avec une longue chaîne de raisonnement, c'est une facture de sortie déguisée en entrée.
Le tokeniseur a changé sous vos pieds il y a deux générations. Les modèles Claude 4.7 et ultérieurs produisent environ 30% de tokens en plus pour le même texte, selon la propre note d'Anthropic. Comparer les prix par token aux tarifs de l'ère Opus 4.6 surestime d'un tiers le coût de l'ancien modèle.
À épingler aussi : toute la fenêtre d'1M de tokens est facturée aux tarifs standards — aucun palier de contexte long n'existe. Contrairement à la falaise à 272K de GPT-6 Astra, où franchir un seuil reprécise la requête entière, sur Opus 5.5 « une requête de 900k tokens est facturée au même tarif par token qu'une requête de 9k », selon les mots d'Anthropic.
Le chiffre qui a changé : les lectures de cache ont chuté de 60%
Cinq lignes de facturation ont bougé entre Opus 5 et Opus 5.5, mais la baisse qui compte pour le travail agentique est la ligne de lecture : $0,50 → $0,20 par million, une baisse de 60% et un nouveau multiplicateur de 0,05x.
La mécanique : quand une requête répète un préfixe déjà traité — prompt système, contexte de dépôt, historique de conversation, définitions d'outils — l'API lit ce préfixe depuis le cache au lieu de le retraiter. Les écritures coûtent 1,25x l'entrée de base pour une entrée de 5 minutes ($5/M ici), 2x pour une entrée d'une heure ($8/M). Les lectures coûtent 0,05x de la base — $0,20/M — sur ce modèle seulement. Le cache s'amortit après une relecture de 5 minutes ou deux d'une heure, les multiplicateurs se cumulent avec Batch et la résidence des données, et le prompt minimal cacheable est de 512 tokens.
Pourquoi cela domine les factures d'agents : un agent qui fait 40 appels d'outils sur un contexte de 200 000 tokens relit ce préfixe 40 fois. Aux lectures de $0,50/M d'Opus 5, ces relectures coûtent $4,00 ; aux $0,20/M d'Opus 5.5, elles coûtent $1,60 — avant même de générer un seul token nouveau. La page de lancement d'Anthropic pointe exactement cette ligne : les lectures de cache « constituent la majorité des coûts des travaux agentiques et de code », et la baisse de 60% est le plus gros morceau des 40% officiels.
Le versant abonnement de la même histoire, depuis le terrain :
« Usage drains so slowly with opus 5.5. Have multiple threads going on xhigh and max and the usage bar is hardly budging », lit-on dans une réponse ; un autre utilisateur rapporte deux tâches substantielles sans que l'allocation hebdomadaire ne bouge. Ce sont des expériences d'offre déclarées, pas des benchmarks — mais elles pointent dans la même direction que l'arithmétique API : la ligne de lecture est l'endroit où vivent les budgets agentiques.
Le piège, comme toujours : les économies de cache exigent un préfixe stable. Si votre contexte change à chaque tour — sorties d'outils dynamiques, documents tournants — vous payez la pénalité d'écriture de 1,25x–2x à répétition au lieu de surfer sur les lectures à 0,05x. Et les blocs de pensée sont liés au modèle et à la conversation sur Opus 5.5 ; éditer le préfixe les invalide, ce qui est l'histoire de la section suivante en miniature.
Ce que « 40% de moins » veut vraiment dire
L'affirmation de lancement d'Anthropic a trois conditions précises, et les décortiquer fait la différence entre un budget et un vœu. « Nos tests montrent qu'aux réglages par défaut, elle coûtera 40% de moins qu'Opus 5 sur des charges de travail typiques. »
Condition une : la base de comparaison est Opus 5, pas les concurrents ni Fable. L'affirmation combine deux effets — la baisse de grille d'environ 20% plus moins de tokens par tâche (« elle coûte moins par token qu'Opus 5 et utilise moins de tokens par tâche, ce qui nette une baisse de 40% des coûts »). Les propres exemples chiffrés d'Anthropic tombent dans la même bande, et au-dessus : une réécriture de HAProxy du C vers Rust terminée en 9,5 heures contre 12 pour Fable 5.1 à 51% de moins en coût ; un audit de base de code de 200 000 lignes bouclé en moins de 3 heures là où Opus 5 a mis plus de 20 heures et 2,5x les tokens. Les testeurs nommés ont rapporté des baisses de coût de 40–50% (Spotify), deux fois moins de tokens (Kiro), trois fois moins (Box), et « le premier modèle que nous mettons par défaut en medium » (Factory). Un commentateur de HN a résumé la tendance : « sortir un modèle avec ~3-6x le rapport performance/coût de votre sortie d'il y a trois semaines » (Hacker News).
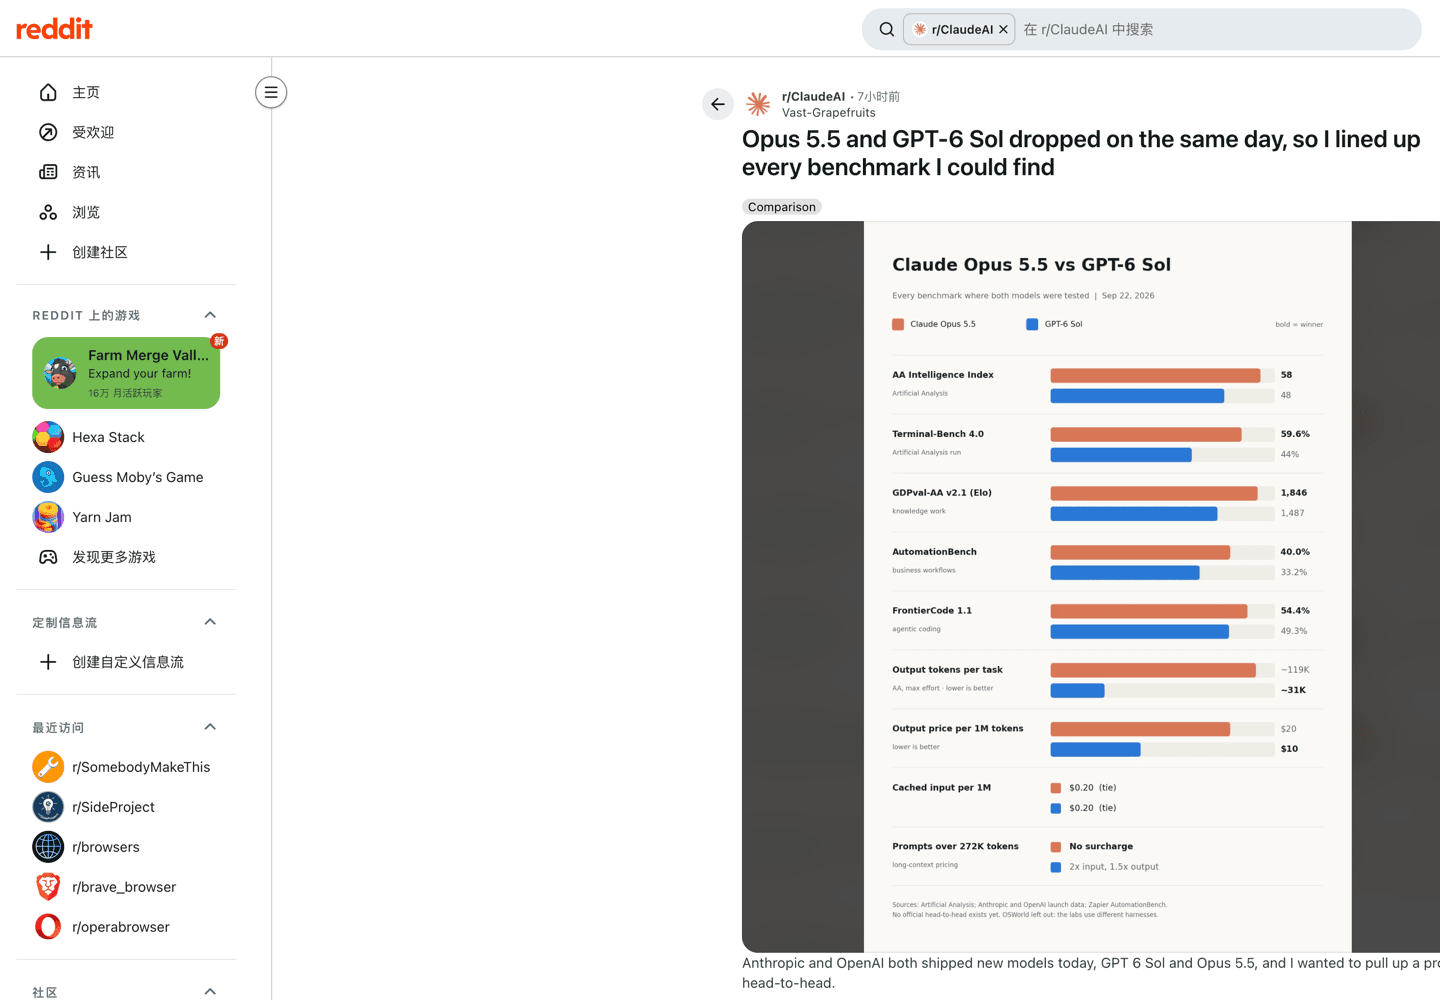
Condition deux : « réglages par défaut » veut dire effort medium. À l'effort max, les maths s'inversent — le modèle « tend à penser plus par tour que Claude Opus 5, surtout en xhigh et max », selon les notes officielles de comportement, et la pensée facturable est là où les budgets meurent. Le fil comparatif de r/ClaudeAI a quantifié la forme : « À l'effort max, AA a mesuré Opus 5.5 à environ 119K tokens de sortie par tâche, tandis que [GPT-6] Sol en a utilisé environ 31K et coûté $1,06 par tâche pour tout l'indice » :
Condition trois : « charges de travail typiques » veut dire que les vôtres ne le sont peut-être pas. La communauté porte des cicatrices ici, et elles ont un prix. Le commentaire le mieux noté (226 points) sous le fil d'annonce :
« quand ils ont sorti Opus 5, ils n'arrêtaient pas de proclamer le caractère de pointe du modèle… les gens ont découvert qu'Opus 5 ne communiquait même pas correctement… les allers-retours ont poussé beaucoup à douter d'eux-mêmes, gaspillant encore plus de temps et de tokens. » Les sceptiques du même réseau lisent les graphiques AA dans l'autre sens — « opus 5.5 bat astra… mais a utilisé 4,5x les tokens pour la même tâche » — quand les défenseurs lisent « même performance, opus 5.5 medium vs Astra max, 2,5x moins cher ». Les deux lisent le même lancement. Lequel ressemble à votre facture dépend du token qui la domine — c'est ce que mesure la section suivante. Pour le versant capacités de cet arbitrage, voir le test de Fable 5.1 et notre guide du raisonnement agentique.
Le levier d'effort : de $0,55 à $5,98 par tâche
Rien sur la grille ne vous dit que ce cadran déplace le coût plus que n'importe quelle ligne de prix. Artificial Analysis suit Opus 5.5 comme cinq entrées séparées ; instantané du 23 septembre 2026 :
| Effort | Intelligence Index | Coût par tâche II | Vitesse de sortie |
|---|---|---|---|
| low | 42 | $0,55 | 83 t/s |
| medium (défaut) | 51 | $1,34 | 76 t/s |
| high | 54 | $1,82 | 90 t/s |
| xhigh | 56 | $3,46 | 76 t/s |
| max | 58 | $5,98 | — |
Lisez les colonnes extrêmes ensemble : l'effort max coûte 10,9x l'effort low par tâche, pour 16 points d'intelligence mesurée. Medium — le défaut — délivre le même indice d'intelligence qu'Opus 5 à l'effort max ($1,34 contre le tarif du niveau max d'Opus 5). « max coûte presque le double de xhigh et c'est un point aberrant par rapport aux autres niveaux. En medium ou high, vous devriez voir de vraies économies », comme l'a résumé la réponse la mieux notée du fil r/ClaudeCode. Un développeur y a déjà reconstruit un flux autour de l'échelle : « Opus 5.5 High est énorme. Ça fait fable 5.1 medium, mais bien moins cher… j'ai changé mon flux pour utiliser Opus 5.5 high pour presque tout. »
Deux mises en garde avant de tourner le cadran. D'abord, la migration : le défaut est passé de high (Opus 5) à medium, et à réglage identique le nouveau modèle pense plus par tour — la documentation d'Anthropic demande de refaire votre balayage d'effort plutôt que de traîner un réglage, et de laisser de la place dans max_tokens pour la pensée. Ensuite, plus d'effort n'achète pas fiabilité de qualité. L'évaluation de CodeRabbit au jour du lancement a trouvé que « un effort de raisonnement plus élevé n'a pas constamment apporté un meilleur taux de complétion » — et plus de commentaires à évaluer pour les développeurs est un coût en soi :
Les citations clients de la page de lancement vont dans le même sens — Rogo a battu Opus 5 en high « à son réglage d'effort le plus bas… avec environ 60% de tokens de sortie en moins » ; Walleye Capital a « largement résolu » leur suite au réglage le plus bas. Quand les propres preuves du fournisseur pointent sans cesse vers les réglages bon marché, prenez-le comme réponse par défaut et gardez max pour les tâches qui en ont démontrablement besoin.
Les lignes de facturation hors du titre
Cinq lignes décident de la plupart des vraies factures, et seule la première apparaît dans la couverture de lancement.
Mode Fast : 2x sur chaque ligne, pour jusqu'à 2,5x de vitesse. Fast (aperçu de recherche, API Claude uniquement) facture $8 en entrée / $40 en sortie — le double de la grille standard, lignes de cache comprises ($0,40 de lecture). Il se cumule avec le cache et la résidence des données, ne peut pas se combiner avec Batch, et délivre une sortie « jusqu'à 2,5x » plus rapide ; la table de fournisseurs d'OpenRouter mesure 143 tok/s en Fast contre 71–83 en standard. À noter : Fast Opus 5.5 à $40/M de sortie reste sous les $50 standard de Fable 5.1.
Batch : le levier des 50%. Les requêtes asynchrones de Batch sont facturées $2/$10 — la plus grosse remise de la grille, cumulable avec le cache de prompts sur toute la fenêtre de contexte, avec un header bêta autorisant jusqu'à 300K tokens de sortie. Les sessions d'agents gérés n'y sont pas éligibles ; elles sont avec état et interactives.
Inférence US-only : 1,1x sur tout. Régler inference_geo: "us" multiplie chaque catégorie — entrée, sortie, écritures et lectures de cache — par 1,1x. Les mêmes 10% apparaissent en tarification d'endpoint régional chez les clouds partenaires : OpenRouter liste les routes régionales Bedrock/Azure/Vertex à $4,40/$22,00/$0,22. Les régions motivées par la conformité paient une prime silencieuse sur chaque ligne ; le routage global est le défaut et le chemin le moins cher.
Les surcoûts d'outils sont des factures de tokens. Le prompt système d'usage d'outils ajoute 286 tokens par requête (contre 675 pour Opus 4.7) ; déclarer le jeu d'outils navigateur ajoute environ 6 600 tokens d'entrée, computer use environ 4 500. La recherche web côté serveur facture $10 par 1 000 recherches en plus des tokens ; l'exécution de code est gratuite avec search/fetch, avec 1 550 heures de conteneur gratuites par mois avant le tarif de $0,05/heure. Un « agent » est une structure tarifaire, pas une conversation — budgétez la ligne d'outils explicitement. Pour l'extrême économique de cette comparaison, voir la décryptage des prix de Kimi K3.
Runtime des Managed Agents : $0,08 par heure de session, mesuré seulement en cours d'exécution, toutes les lignes de tokens au tarif du modèle. Batch ne s'applique pas aux sessions.
L'échelle familiale : Opus 5.5 vs Fable 5.1 vs Opus 5 vs Sonnet 5
| Ligne (par 1M de tokens) | Opus 5.5 | Fable 5.1 | Opus 5 | Sonnet 5 |
|---|---|---|---|---|
| Entrée | $4,00 | $10,00 | $5,00 | $2,00 |
| Lecture de cache | $0,20 (0,05x) | $0,25 (0,025x) | $0,50 (0,1x) | $0,20 (0,1x) |
| Sortie | $20,00 | $50,00 | $25,00 | $10,00 |
| Batch entrée / sortie | $2,00 / $10,00 | $5,00 / $25,00 | $2,50 / $12,50 | $1,00 / $5,00 |
| AA Intelligence Index (max) | 58 | 53 | 51 | 38 |
| Coût AA par tâche II (max) | $5,98 | $7,63¹ | — | — |
¹ Chiffre Fable 5.1 depuis l'instantané AA du 22 septembre, via notre décryptage des prix de Fable ; les deux pages AA bougent chaque jour.
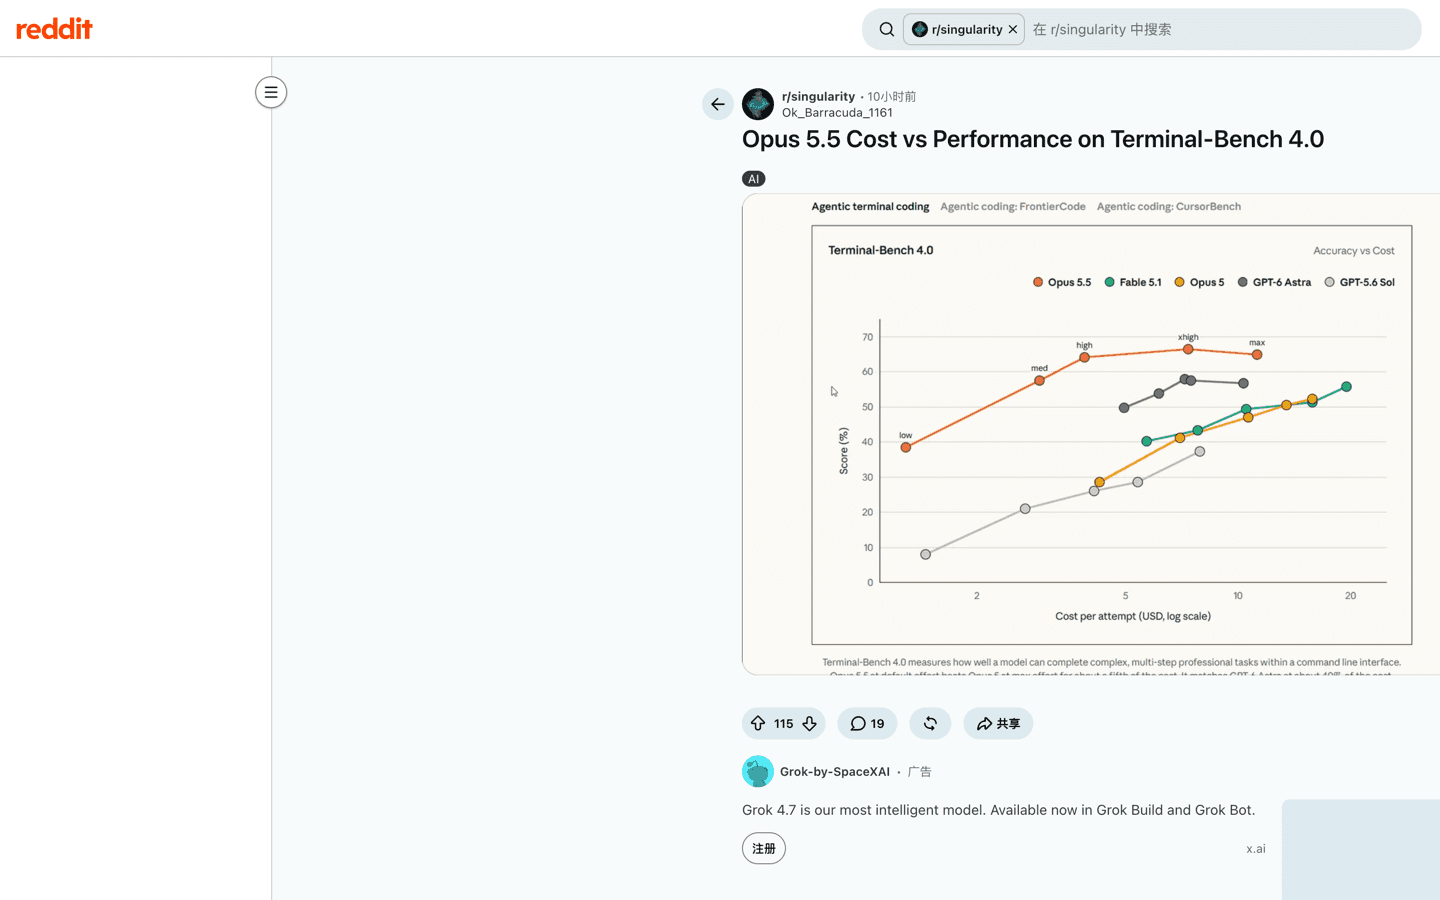
La ligne contre-intuitive est la dernière : sur l'indice d'Artificial Analysis, le modèle le moins cher est désormais aussi le plus fort. Opus 5.5 à l'effort max marque 58 contre 53 à Fable 5.1, à $5,98 contre $7,63 par tâche — alors que le positionnement d'Anthropic réserve encore Fable au « travail ambitieux, de longue durée et asynchrone » et décrit l'écart Opus-Fable comme « plus étroit que ces scores ne le suggèrent ». À lire ainsi : les scores exagèrent l'écart, mais l'écart de prix est réel et inversé. Les boucles à contexte caché sont plus serrées encore — Fable garde la remise de lecture la plus profonde (0,025x), mais ses lectures partent d'une base de $10 : $0,25/M. Les $0,20 d'Opus 5.5 passent devant en valeur absolue.
Les deux lectures communautaires du même graphique AA, côte à côte :
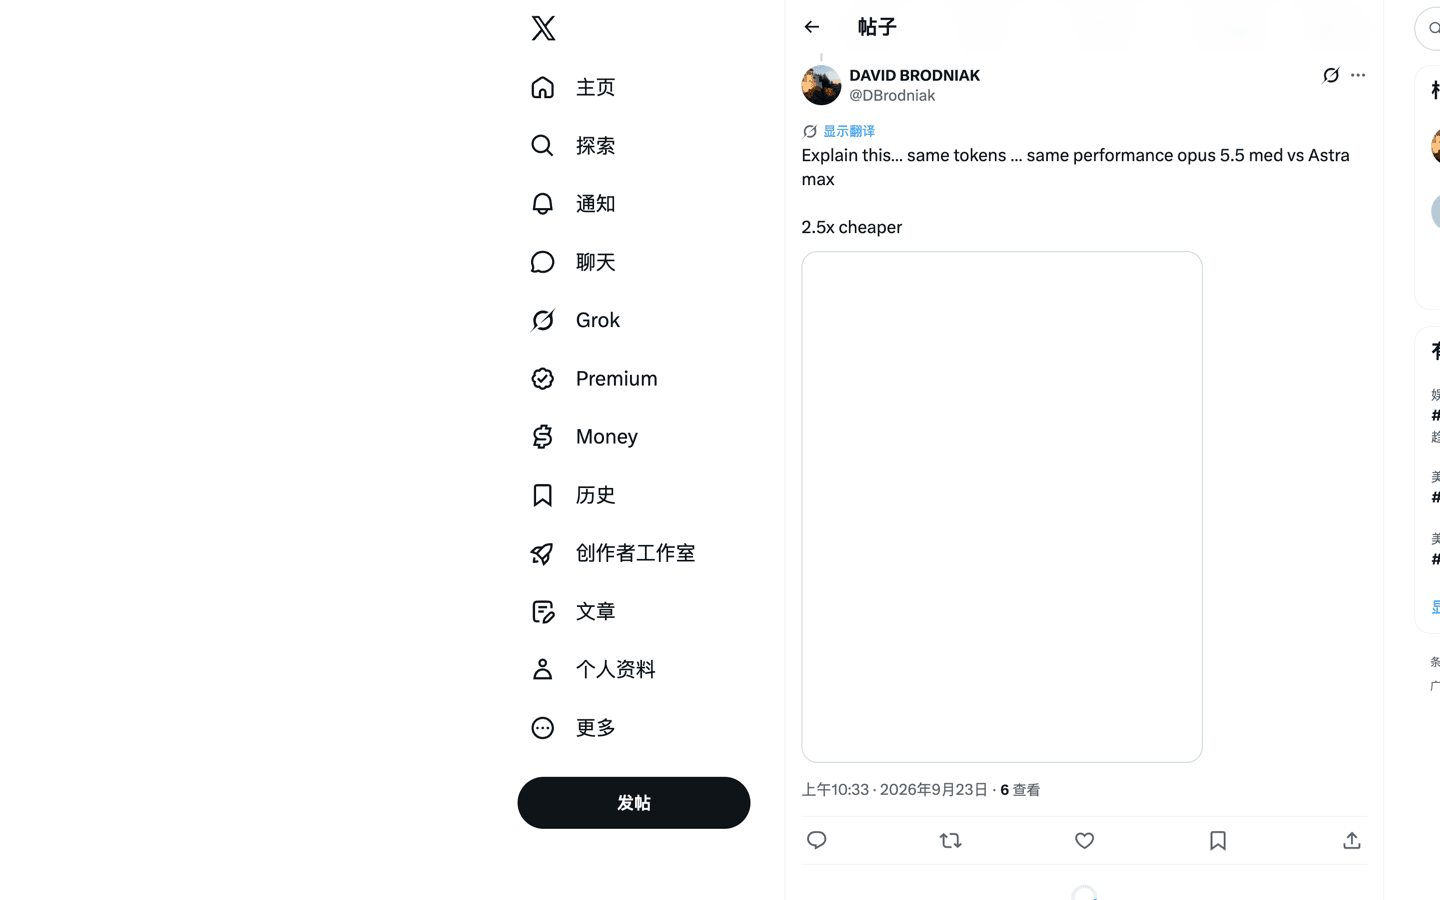
« same tokens … same performance opus 5.5 med vs Astra max — 2.5x cheaper » contre « opus 5.5 a battu astra… mais a utilisé 4,5x les tokens pour la même tâche ». Les deux décrivent la même forme : Opus 5.5 gagne en coût par tâche accomplie et perd en tokens par tâche. Si vos charges sont sensibles à la forme des tokens — budgets stricts par token, routeurs tiers, plafonds de débit — mesurez avant de migrer ; si elles sont sensibles à la tâche, l'échelle favorise Opus 5.5 à presque tous les barreaux.
Sous les barreaux flagship, Sonnet 5 garde le siège économique à $2/$10 avec sa lecture à $0,20 — le même prix de lecture qu'Opus 5.5 désormais — et Haiku 4.5 tient $1/$5. La nouvelle logique de l'échelle : la colonne de lecture de cache s'est comprimée au point que le modèle intelligent et le modèle bon marché facturent pareil la ligne que les agents martèlent le plus.
Ce pour quoi vous ne payez pas
La documentation trace des limites qui se lisent comme une politique de remboursement, et elles comptent à l'échelle agentique :
Les blocs de pensée abandonnés ne sont pas facturés. Quand une requête porte un bloc que le modèle ne peut pas lire, l'API l'abandonne avant l'inférence : « la requête réussit, et les blocs abandonnés ne sont pas facturés ». Pour un modèle dont les blocs sont liés à la conversation, c'est la ligne de dégradation gracieuse.
Les réacheminements de garde-fou s'accomplissent sur d'autres modèles. Les requêtes signalées en cybersécurité sont accomplies par Opus 4.8, selon la note de benchmarks de la page de lancement ; la bascule est transparente (les refus renvoient
stop_reason: "refusal"avec le domaine de politique, et le fallback côté serveur réessaie sur un modèle recommandé). Anthropic ne précise pas la facturation du réacheminement pour Opus 5.5 comme elle l'a fait pour Fable — en attendant la documentation, supposer le tarif du modèle qui complète est la prudence même.Les recherches web échouées ne sont pas facturées. Les réussies coûtent $10 par 1 000 ; les erreuses, rien. Web fetch n'ajoute aucun frais au-delà des tokens que devient le contenu récupéré.
L'exécution de code est gratuite avec search ou fetch, et chaque organisation reçoit 1 550 heures de conteneur gratuites par mois avant le tarif de $0,05/heure.
Disponibilité des offres : API, clouds et offres grand public
La grille API n'est qu'une économie sur trois. Vérifié sur claude.com/pricing et la documentation le 23 septembre 2026 :
| Surface | Prix (valeur vérifiée) | Accès Opus 5.5 |
|---|---|---|
| API Anthropic | Tarifs par token ci-dessus | Oui — claude-opus-5-5 |
| Offre Free | $0 | Non (Sonnet/Haiku seulement) |
| Pro | $17/mois annuel ($200 d'avance) ou $20 mensuel | Oui — allocation standard |
| Max 5x / 20x | À partir de $100/mois | Oui — allocation standard |
| Team | Sièges Standard au-dessus de Pro ; Premium = 5x Standard | Oui |
| Enterprise | $20/siège/mois annuel + usage aux tarifs API | Oui, avec contrôles de dépense |
| Clouds | AWS Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS | Oui ; endpoints régionaux +10%, Foundry facture en CCU |
La ligne d'abonnement à souligner : dans le comparateur, Opus puise dans les allocations d'usage standard en Pro et Max — l'astérisque « crédits d'usage, 50% des limites hebdomadaires », c'est Fable qui le porte. Une heure de Fable coûte à votre allocation ce que deux heures d'un modèle standard ; une heure d'Opus 5.5, non. Anthropic a empilé deux changements de plus au lancement : des limites de cinq heures relevées sur Pro, Max, Team et Enterprise au siège, et une réinitialisation de limite que « vous pouvez désormais garder et utiliser quand vous le choisissez ».
La communauté est partagée sur ce que cela donne en pratique, les deux directions visibles dans les mêmes fils de la semaine de lancement :
« I am using Fable 5.1 rn, and this is 5x cheaper for same intelligence? I am never going to hit my weekly limits at this rate » — contre — « ces baisses ne se traduisent pas nécessairement dans les abonnements… ils utilisent les coûts API comme matériau marketing. » La hausse des limites est documentée ; son ampleur réelle est un attendez-de-voir que seules vos propres fenêtres de cinq heures peuvent trancher. Mécaniquement : l'usage se réinitialise sur des fenêtres de session glissantes de cinq heures avec des limites hebdomadaires en plus sur les offres payantes ; web, bureau, mobile et Claude Code puisent dans le même bassin ; et les crédits d'usage des offres payantes permettent de continuer aux tarifs API standard au-delà des limites.
Deux budgets chiffrés, toutes les hypothèses visibles
Tarifs standard, ni reprise, ni outils, ni taxes. De l'arithmétique, pas des prédictions.
Une question courte avec une longue réflexion. 10 000 tokens d'entrée, 2 000 de sortie :
(10 000 × $4 + 2 000 × $20) / 1 000 000 = $0,08Une boucle d'agent à froid sur un gros dépôt. 300 000 tokens d'entrée (tarif standard — pas de palier de contexte long), 8 000 de sortie :
(300 000 × $4 + 8 000 × $20) / 1 000 000 = $1,36La même boucle à chaud. Même contexte de 300 000 tokens, 90% en cache, une écriture d'une heure par session, 8 000 de sortie par passe :
par passe : (270 000 × $0,20 + 30 000 × $4 + 8 000 × $20) / 1 000 000 = $0,334
unique : 300 000 × $8 / 1 000 000 = $2,40 d'écriture par session
La passe à chaud tombe au quart du coût à froid, et l'écriture de $2,40 s'amortit sur chaque passe qui la réutilise — une écriture de 5 minutes ($1,50) se rembourse après une relecture, celle d'une heure après deux. Le même préfixe qui change ramène chaque passe de la même boucle au froid de $1,36. La ressource du modèle (English) et sa collection de prompts (English) suivent des tâches répétables pour mesurer votre propre taux de succès.
Calcul local
Estimez le coût en tokens de l’API Claude Opus 5.5
Utilise les tarifs officiels en USD vérifiés le 23-09-2026. Les valeurs restent dans ce navigateur.
Les lectures de cache sont facturées à 0,20 USD par million de tokens — le tarif 0,05x d’Opus 5.5. L’estimation exclut les nouvelles tentatives, les surcoûts d’outils, les réacheminements de garde-fou et les marges des fournisseurs. Le mode Fast double chaque ligne et ne se combine pas avec Batch. Vérifier les tarifs actuels
Le calculateur tourne entièrement dans cette page — rien n'est envoyé nulle part. Il chiffre les deux durées d'écriture de cache et les modes Standard, Batch, US-only et Fast, et valide les entrées localement. Ce qu'il ne modélise délibérément pas : les reprises, la dispersion en sous-agents, les surcoûts d'outils et les réacheminements de garde-fou — cela va dans votre marge. Revérifiez la grille officielle avant d'engager un budget ; ce sont les chiffres du 23 septembre 2026.
Une option pratique : exécuter la comparaison dans Tabbit
Après le budget vient la partie ennuyeuse : faire tourner du travail en forme d'Opus exige un endroit où pages, fichiers et appels de modèles vivent ensemble, et où « essayer Opus 5.5 en medium, replier sur Sonnet » est une sélection et non un projet d'orchestration. C'est la place que tient Tabbit Browser — un navigateur IA agentique dont le sélecteur de modèles, les onglets vivants et les fichiers locaux partagent une seule surface.
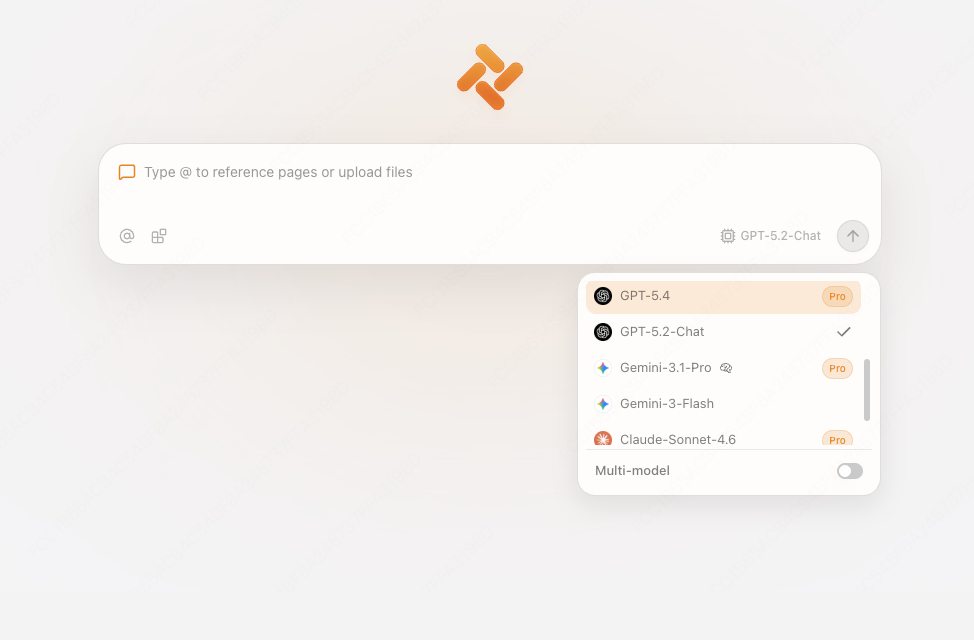
Les limites, dites sans détour : Tabbit est un client, pas une couche de facturation Anthropic. La disponibilité des modèles dépend de votre compte et de votre édition, et rien dans le navigateur ne change ce qu'Anthropic facture — la grille ci-dessus s'applique partout où Opus 5.5 tourne. Cet article n'a pas exécuté de tâche Opus 5.5 dans Tabbit, donc aucune affirmation de disponibilité ou de performance n'est faite ici. Ce que le navigateur change, c'est le coût de mise en place : mesurer votre propre taux de succès de cache et votre seuil d'effort sur du vrai travail — les deux chiffres que cette page dit décideurs de votre facture — avant d'écrire la moindre orchestration, c'est le moins cher dans un espace de travail construit exactement pour ça. Le guide des habitudes de travail Tabbit couvre la méthode.
 Tabbit Browser
Table de décision sur les prix de Claude Opus 5.5
| Votre charge de travail | Levier de coût | Meilleur point de départ | À surveiller |
|---|---|---|---|
| Longues boucles d'agent, contexte de dépôts/docs stable | Lectures de cache | Niveau standard, préfixes stables, écritures 1h | Éditer le préfixe invalide les blocs de pensée liés ; le churn change les lectures en écritures 1,25–2x |
| Chat court, éditions rapides | Tokens de sortie | Effort plus bas — ou Sonnet 5 | La pensée ne se coupe pas ; medium par défaut suffit souvent |
| Évaluations nocturnes, refactors par lots | Volume | API Batch à $2/$10, bêta 300K de sortie | Les sessions interactives et agents gérés n'y sont pas éligibles |
| Travail interactif contraint par la latence | Vitesse de sortie | Mode Fast à 2x ($8/$40), avec cache | Fast ne se combine pas avec Batch ; il double chaque ligne |
| Traitement US imposé par la conformité | Chaque ligne | US-only à 1,1x, ou endpoints régionaux cloud (+10%) | La prime s'applique aussi aux lectures de cache |
| Budgets sensibles à la forme des tokens (routeurs, plafonds) | Tokens par tâche | Mesurez avant de migrer | Opus 5.5 gagne en coût par tâche, perd en tokens par tâche face aux rivaux |
| Usage quotidien par abonnement | Fenêtres de 5 heures | Pro/Max — Opus en allocation standard, limites relevées | Fable sur les mêmes offres brûle des crédits à 50% des limites hebdomadaires |
Verdict final
Claude Opus 5.5 est le premier Opus sorti moins cher que son prédécesseur, et la baisse est réelle sur chaque ligne — 20% sur l'entrée et la sortie, 60% sur les lectures de cache qui dominent les factures agentiques, désormais au prix de Sonnet 5. Prenez-le pour le code agentique de longue haleine et le travail de connaissance à l'effort medium, préfixes stabilisés et Batch pour tout ce qui peut attendre ; sur l'indice AA il a déjà dépassé Fable 5.1 en coûtant moins par tâche, ce qui réordonne l'échelle familiale. Les deux factures qu'il ne règle pas : la pensée à l'effort max (un levier 11x que la grille ne montrera jamais) et les budgets sensibles à la forme des tokens, où il dépense encore plus de tokens par tâche que des rivaux plus économes. En abonnement, c'est le flagship ami des allocations — usage standard, limites relevées — mais vérifiez votre propre consommation de cinq heures avant d'engager une équipe. Revérifiez la page officielle des prix chaque mois : la standardisation de Sonnet 5 et cette sortie prouvent que l'échelle bouge vite. L'histoire des capacités vit dans la présentation de Fable 5.1 et le test ; les enregistrements communautaires liés ci-dessus portent la preuve des charges de travail ; et la comparaison de prix entre familles montre ce que la même grille coûte ailleurs.
Sources
Documentation tarifaire d'Anthropic — grille, note 0,05x sur le cache, mode Fast, Batch, résidence, tarifs d'outils ; vérifié le 23 septembre 2026
Page du modèle Claude Opus 5.5 et nouveautés — spécifications, effort par défaut, changements cassants, « pense plus par tour », facturation des blocs abandonnés ; vérifié le 23 septembre 2026
Page de lancement d'Anthropic — affirmation des 40% et conditions, exemple HAProxy, citations de coûts clients, hausse des limites, réacheminements ; vérifié le 23 septembre 2026
claude.com/pricing — comparatif Free/Pro/Max et règles d'allocation Opus vs Fable ; vérifié le 23 septembre 2026
Page de lancement Artificial Analysis — intelligence par effort, vitesse, instantané de coût par tâche ; vérifié le 23 septembre 2026
OpenRouter Opus 5.5 — tarifs des fournisseurs, endpoints régionaux, débit Fast ; vérifié le 23 septembre 2026
Enregistrements communautaires avec captures et conditions en ligne : question max sur r/ClaudeCode, comparaison Sol sur r/ClaudeAI, fil de lancement r/ClaudeAI, division abonnement sur r/singularity, lectures de graphiques sur X, vidéo d'évaluation CodeRabbit, fil de lancement HN

Questions fréquentes
Combien coûte Claude Opus 5.5 ?
Sur l'API Anthropic, Claude Opus 5.5 est à $4 par million de tokens d'entrée et $20 par million de tokens de sortie, vérifié sur la documentation tarifaire d'Anthropic le 23 septembre 2026. Les écritures de cache coûtent $5 par million (5 minutes) ou $8 par million (1 heure), et les lectures de cache coûtent $0,20 par million — un tarif 0,05x propre à ce modèle. L'API Batch divise tout par deux ($2/$10) et le mode Fast double tout ($8/$40).
Claude Opus 5.5 est-il moins cher qu'Opus 5 ?
Chaque ligne de la grille a baissé : l'entrée et la sortie sont 20% sous les $5/$25 d'Opus 5, les écritures de cache passent de $6,25/$10 à $5/$8, et les lectures de cache chutent de 60%, de $0,50 à $0,20. Anthropic estime que les charges de travail typiques, aux réglages par défaut, coûtent environ 40% de moins au total. L'exception, c'est l'effort : au niveau max le modèle pense davantage par tour, et les mesures indépendantes par tâche vont de $0,55 en low à $5,98 en max — un écart de 11x qu'aucun tarif affiché ne montre.
Claude Opus 5.5 est-il disponible sur l'offre gratuite ?
Non. Le comparateur de plans d'Anthropic marque Opus comme indisponible sur Free, qui ne donne accès qu'aux modèles Sonnet et Haiku. Opus 5.5 est inclus dans les allocations standard de Pro, Max, Team et Enterprise — en usage standard, donc, et non selon le régime de crédits d'usage qui s'applique à Fable 5.1 sur Pro et Max. Au lancement, Anthropic a aussi relevé les limites d'usage de cinq heures sur Pro, Max, Team et Enterprise au siège, et ajouté une réinitialisation de limite que vous pouvez garder pour plus tard.
Quel est le moyen le moins cher d'utiliser Claude Opus 5.5 ?
Actionnez les leviers dans l'ordre : gardez des préfixes de prompts stables pour que les relectures soient facturées $0,20 au lieu de $4 par million, exécutez à l'effort le plus bas qui passe votre contrôle qualité (medium par défaut suffit souvent), envoyez vers l'API Batch à $2/$10 tout ce qui n'est pas urgent, et évitez l'inférence US-only et le mode Fast sauf exigence de conformité ou de latence. Refaites aussi votre balayage d'effort à la migration : à réglage égal, Opus 5.5 tend à penser plus par tour qu'Opus 5.
Claude Opus 5.5 facture-t-il un supplément pour le contexte long ?
Non. Toute la fenêtre de contexte de 1M de tokens est facturée aux tarifs standards par token, sans palier de contexte long, et les remises de cache et de Batch s'appliquent à toute la fenêtre. Sur l'API Batch, un header bêta porte la sortie maximale à 300K tokens. À noter : les modèles Claude 4.7 et ultérieurs utilisent un tokeniseur plus récent qui produit environ 30% de tokens en plus pour le même texte.
Les réacheminements de sécurité ou les appels d'outils échoués sont-ils facturés au prix d'Opus 5.5 ?
Les requêtes réacheminées par les garde-fous sont accomplies par d'autres modèles — Anthropic indique que le travail signalé en cybersécurité est traité par Opus 4.8 — et la bascule est signalée de façon transparente plutôt que facturée en silence. Les recherches web échouées ne sont pas facturées, web fetch n'ajoute aucun frais au-delà des tokens du contenu récupéré, et les blocs de pensée que le modèle ne peut pas lire sont abandonnés avant l'inférence, sans frais. L'exécution de code est gratuite avec la recherche web ou fetch, avec 1 550 heures de conteneur gratuites par mois sinon.