
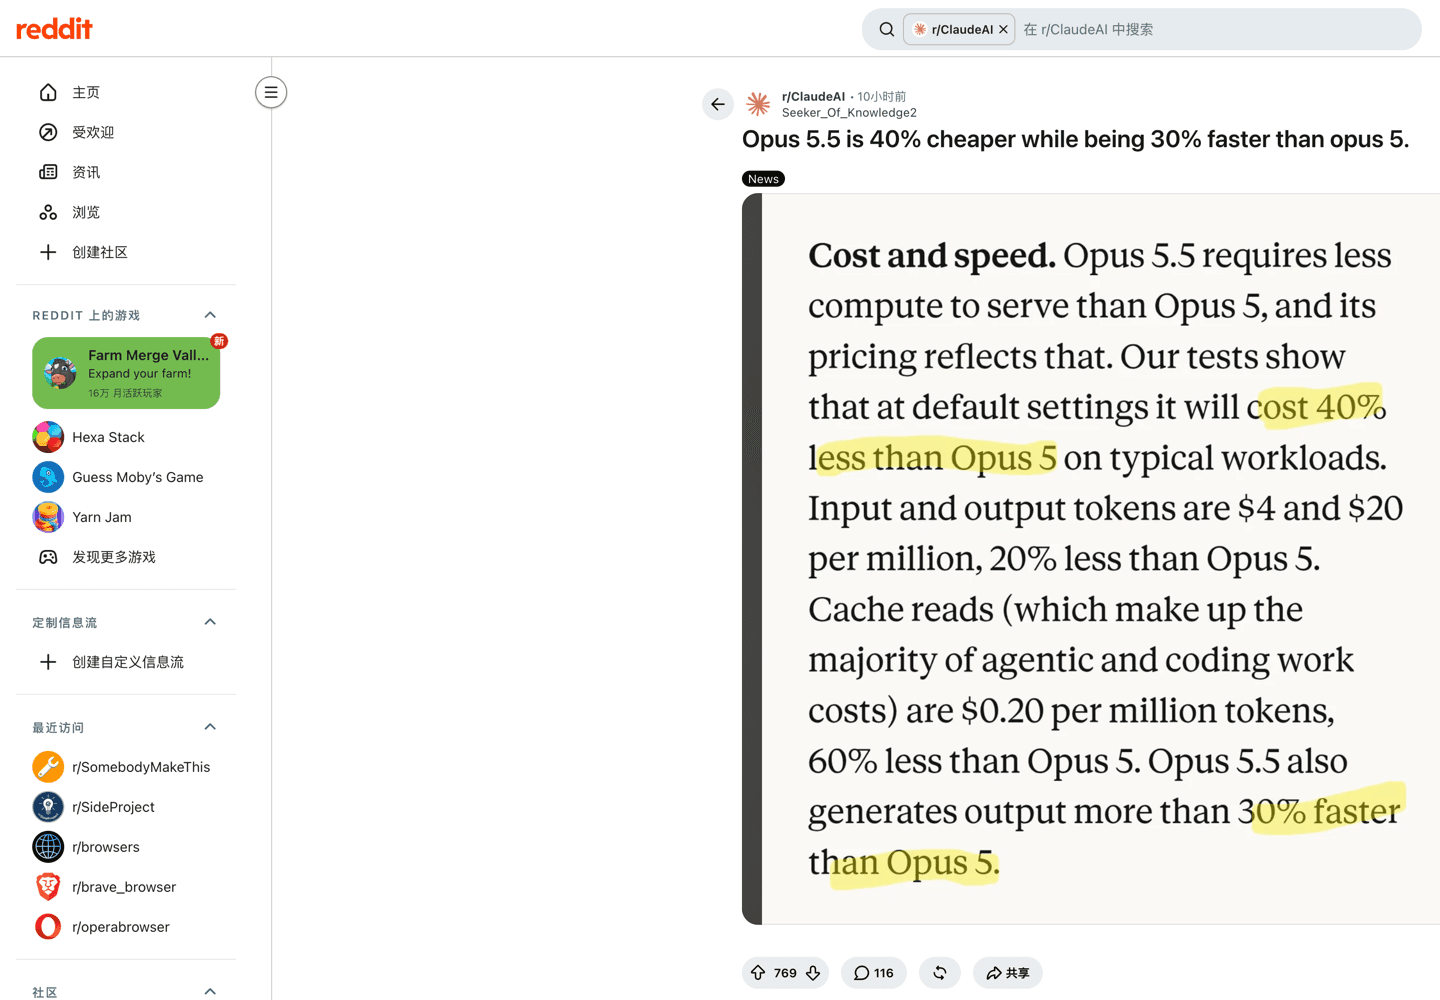
Claude Opus 5.5 は Anthropic API で100万入力トークンあたり $4、100万出力トークンあたり $20、キャッシュ読み取りは100万あたり $0.20 — すべての料率を2026年9月23日(発表翌日)、Anthropic 自身の価格ドキュメントで確認しました。今回は料率表そのものがニュースです。Opus 5 から5つの課金行すべてが下がり、前任より安くなった初めての Opus 世代です。4.5 から 5 までの5世代の Opus はすべて $5/$25 を掲示してきましたが、最新世代が突然いちばん安くなりました。Anthropic の公式推計は「デフォルト設定では、典型的なワークロードで Opus 5 より 40% 安くなる」です。
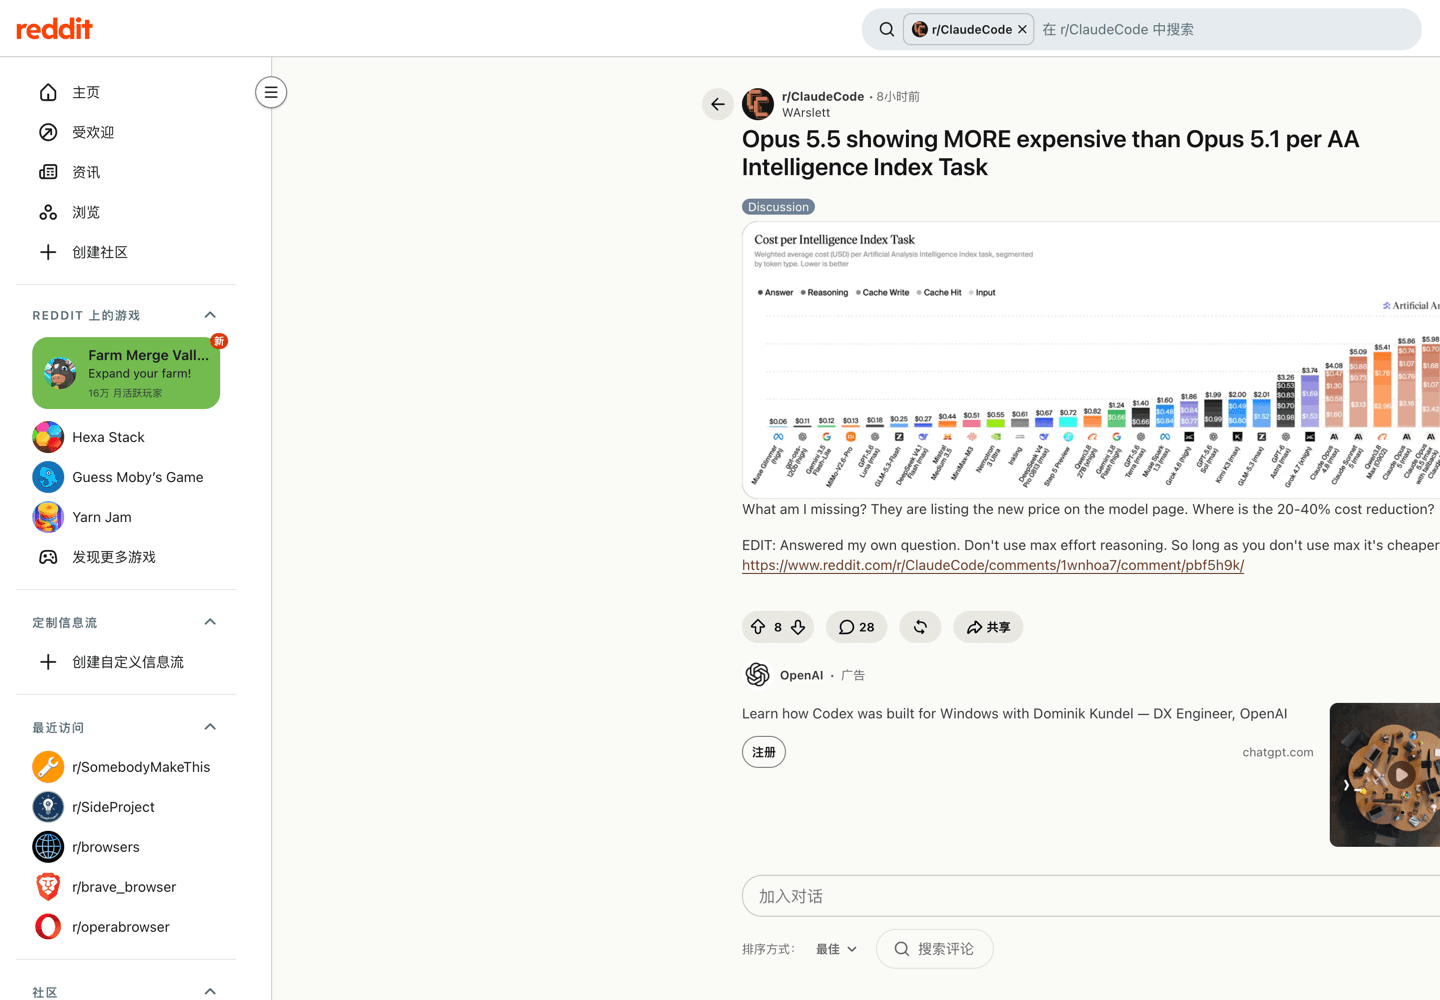
この文の両翼はどちらも真実で、その間の溝こそこの記事が存在する理由です。公式の料率表では、削減の大半を担ったのは1行 — キャッシュ読み取りが 60% 下がり、Sonnet 5 と同じ $0.20 になりました。料率表の外では、r/ClaudeCode の開発者が発表当日に Artificial Analysis を開き、Opus 5.5 が「AA Intelligence Index の1タスクあたりコストで Opus 5 より高く出ている」のを見て、自分で答えを見つけました。「max エフォートの推論を使わないこと。max を使わなければ安い」(r/ClaudeCode)。このページは Opus 5.5 の物語のお金の側面です — 能力の背景はファミリー概要とOpus 4.8 の現状に譲り、ガイド後半では予算が固まったあとの比較を実行する場所のひとつとして Tabbit Browser が登場します。まず数字から。
Key takeaways
料率表: 100万トークンあたり入力 $4、キャッシュ読み取り $0.20(0.05x — Opus 5.5 のみのレート)、キャッシュ書き込み $5/$8(5分/1時間)、出力 $20。Batch はすべて半額の $2/$10、Fast モードはすべて2倍の $8/$40、US-only 推論は全行に 1.1x。
削減の大部分は1つの数字から。 キャッシュ読み取りは 60% 減($0.50 → $0.20)— Anthropic 自身が「エージェント的・コーディング作業のコストの大半を占める」と言う行です。Opus 5.5 のキャッシュ読み取りは Sonnet 5 と同価格になり、モデルは2格上のままです。
エフォートが最大の制御可能なレバー。 Artificial Analysis は low で1タスク $0.55、max で $5.98 を計測 — 知性16ポイントのために 11 倍の振れ幅。デフォルトは medium で、同じ設定でも Opus 5 より1ターンあたり多く考えます。
長期コンテキストの崖なし。 100万トークン全体が標準レートで課金され、Batch のベータヘッダーで30万出力トークンまで可能。ただし 4.7 以降の新しいトークナイザーは、同じテキストで約 30% 多くのトークンを生成します。
サブスクリプションも同時更新。 Opus 5.5 は Pro/Max で標準枠として計上され(Fable は週上限の 50% の usage credits を消化)、有料プランの5時間上限は引き上げ、上限リセットは貯めて使えるようになりました。
Claude Opus 5.5 の価格早見表
2026年9月23日の Anthropic 価格ドキュメントからの標準料率の全表です:
| モデル | 入力 / 100万 | 5m 書き込み / 100万 | 1h 書き込み / 100万 | キャッシュ読み / 100万 | 出力 / 100万 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | $4.00 | $5.00 | $8.00 | $0.20 | $20.00 |
| Claude Fable 5.1 | $10.00 | $12.50 | $20.00 | $0.25 | $50.00 |
| Claude Opus 5 | $5.00 | $6.25 | $10.00 | $0.50 | $25.00 |
| Claude Sonnet 5 | $2.00 | $2.50 | $4.00 | $0.20 | $10.00 |
| Claude Haiku 4.5 | $1.00 | $1.25 | $2.00 | $0.10 | $5.00 |
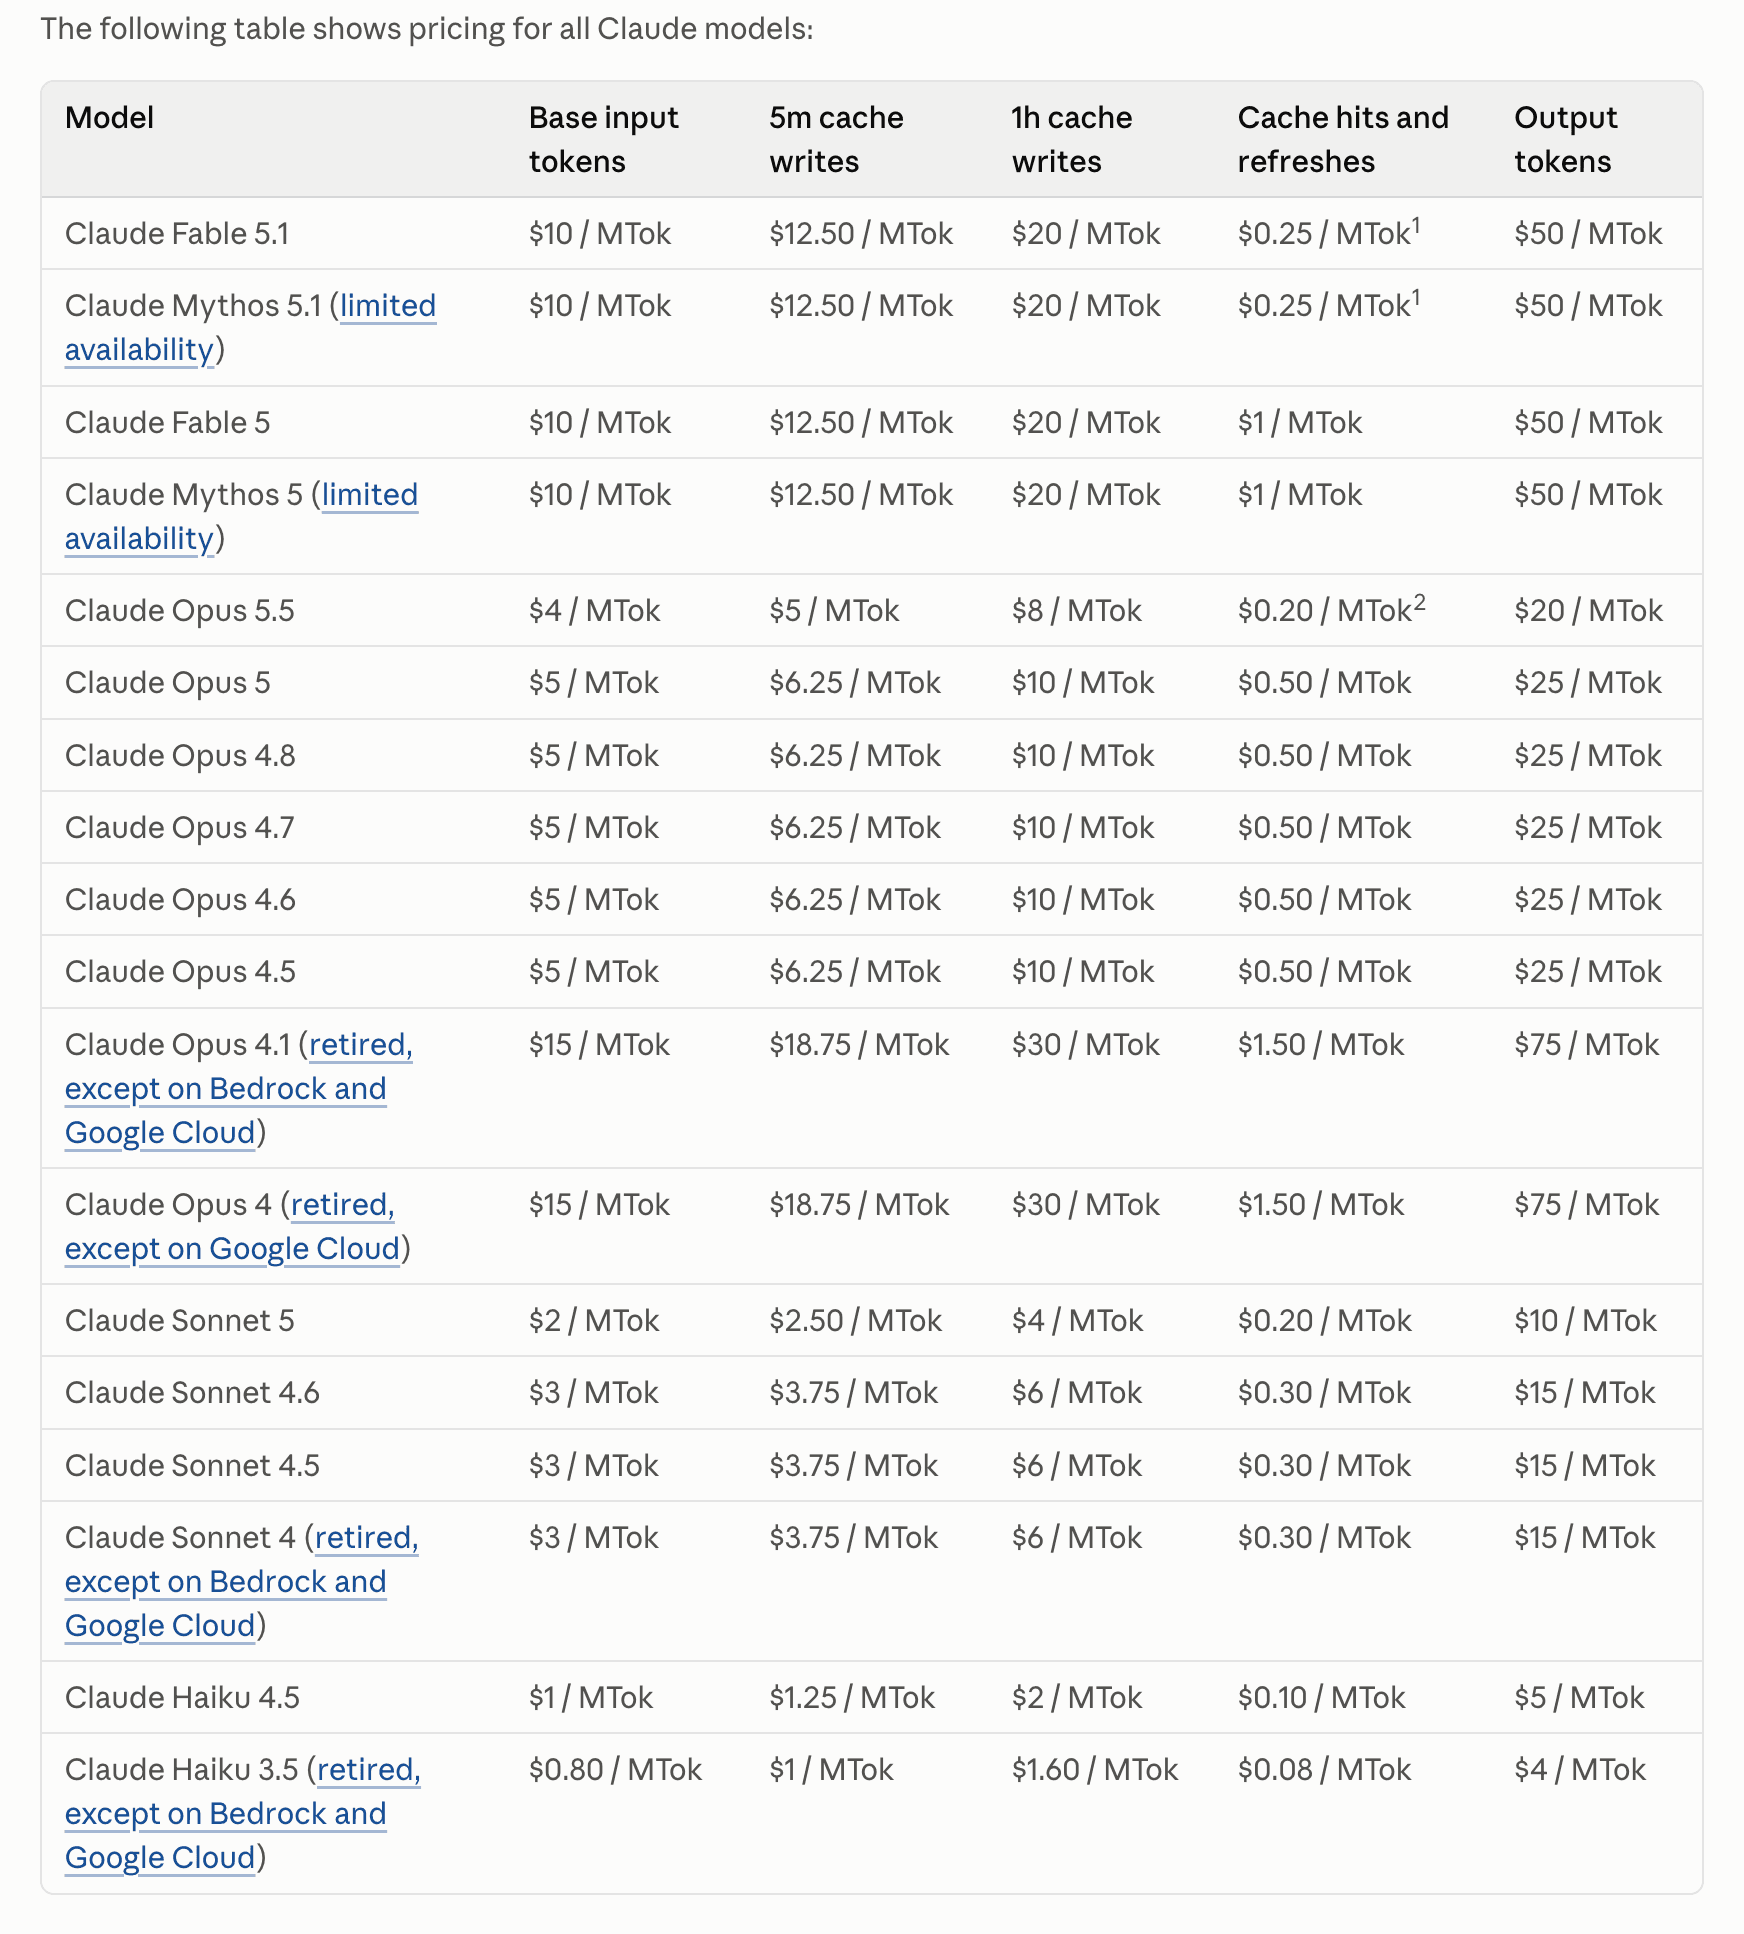
この表で注目すべき点は3つあり、どれも見出しの $4 ではありません:
キャッシュ読み取りに専用の乗数がついた。 他の標準モデルの読み取りは基本入力の 0.1x、Fable 5.1 と Mythos 5.1 は 0.025x、Opus 5.5 は Anthropic の脚注のとおり中間の 0.05x です。結果は $0.20 — Sonnet 5 のキャッシュ読み取りと同一です。
出力は依然として入力の5倍。 このモデルは適応的思考をオフにできず、思考トークンは課金対象の出力です。短いプロンプトと長い推論チェーンは、入力の姿をした出力の請求書です。
トークナイザーは2世代前に変わっていた。 Claude 4.7 以降のモデルは同じテキストで約 30% 多くのトークンを生成します(Anthropic 自身の脚注)。Opus 4.6 世代の単価とのトークン単価比較は、旧モデルのコストを3分の1過大評価します。
もう一点:100万トークン全体が標準レートで課金され、長期コンテキスト枠は存在しません。GPT-6 Astra の 272K の崖(しきい値を超えるとリクエスト全体が再価格化)と違い、Opus 5.5 では Anthropic の言葉を借りれば「90万トークンのリクエストは9千トークンのリクエストと同じトークン単価で課金される」のです。
変わった数字:キャッシュ読み取りが 60% 下がった
Opus 5 から Opus 5.5 への間で5つの課金行が動きましたが、エージェント的作業に効くのは読み取り行です。100万あたり $0.50 → $0.20、60% の値下げと新しい 0.05x 乗数。
仕組み:リクエストが以前処理したプロンプトのプレフィックス — システムプロンプト、リポジトリのコンテキスト、会話履歴、ツール定義 — を繰り返すとき、API は再処理せずキャッシュから読み取ります。書き込みは5分エントリで基本入力の 1.25x(このモデルでは $5/100万)、1時間エントリで 2x($8/100万)。読み取りは基本の 0.05x — $0.20/100万 — このモデルだけです。キャッシュは5分の再読1回または1時間の再読2回で元が取れ、乗数は Batch とデータレジデンシーに重ねられ、キャッシュ可能な最小プロンプトは512トークンです。
これがエージェントの請求を支配する理由:20万トークンのコンテキストで40回ツールを呼ぶエージェントは、そのプレフィックスを40回読み直します。Opus 5 の $0.50/100万では再読に $4.00、Opus 5.5 の $0.20/100万では $1.60 — 新しいトークンを1つも生成する前に。Anthropic の発表ページ自体がこの行を指しています。キャッシュ読み取りは「エージェント的・コーディング作業のコストの大半を占め」、60% の値下げが公式の 40% 主張の最大の一角です。
同じ話のサブスクリプション側、現場から:
「Usage drains so slowly with opus 5.5. Have multiple threads going on xhigh and max and the usage bar is hardly budging」という返信があり、別のユーザーは大きなタスク2件で週次枠がほとんど動かなかったと報告しています。自己申告のプラン体験でありベンチマークではありませんが、API の計算と同じ方向を指しています。エージェントの予算は読み取り行に宿るのです。
いつもの罠も同じ:キャッシュの節約には安定したプレフィックスが要ります。コンテキストが毎ターン変わる — 動的なツール出力、入れ替わるドキュメント — 場合、0.05x の読み取りに乗る代わりに 1.25x〜2x の書き込みペナルティを繰り返し払います。さらに Opus 5.5 の thinking ブロックはモデルと会話に紐づき、プレフィックスを編集すると無効化されます。次の節の縮図です。
「40% 安い」の本当の意味
Anthropic の発表には3つの精密な条件があり、読み解くかどうかで予算と願望の差がつきます。「私たちのテストでは、デフォルト設定で典型的なワークロードにおいて Opus 5 より 40% 安くなる」。
条件1:ベースラインは Opus 5 で、競合でも Fable でもありません。この主張は2つの効果の合成です — 約 20% の料率値下げに加えてタスクあたりトークンの削減(「Opus 5 よりトークン単価が安く、タスクあたりのトークンも少なく、合わせてコストが 40% 低下する」)。Anthropic 自身の試算は同じ帯かそれ以上に落ちます。HAProxy の C から Rust への書き換えは9.5時間で完了、Fable 5.1 は12時間でコスト 51% 減。20万行のコードベース監査は3時間未満、Opus 5 は20時間超とトークン2.5倍。名指しの早期テスターは 40〜50% のコスト減(Spotify)、トークン半減(Kiro)、3分の1(Box)、「初めてデフォルトを medium にするモデル」(Factory)と報告しました。HN のコメントは傾向を一言で表しています。「わずか3週間前の自社リリースの性能/コスト比を約3〜6倍更新するリリース」(Hacker News)。
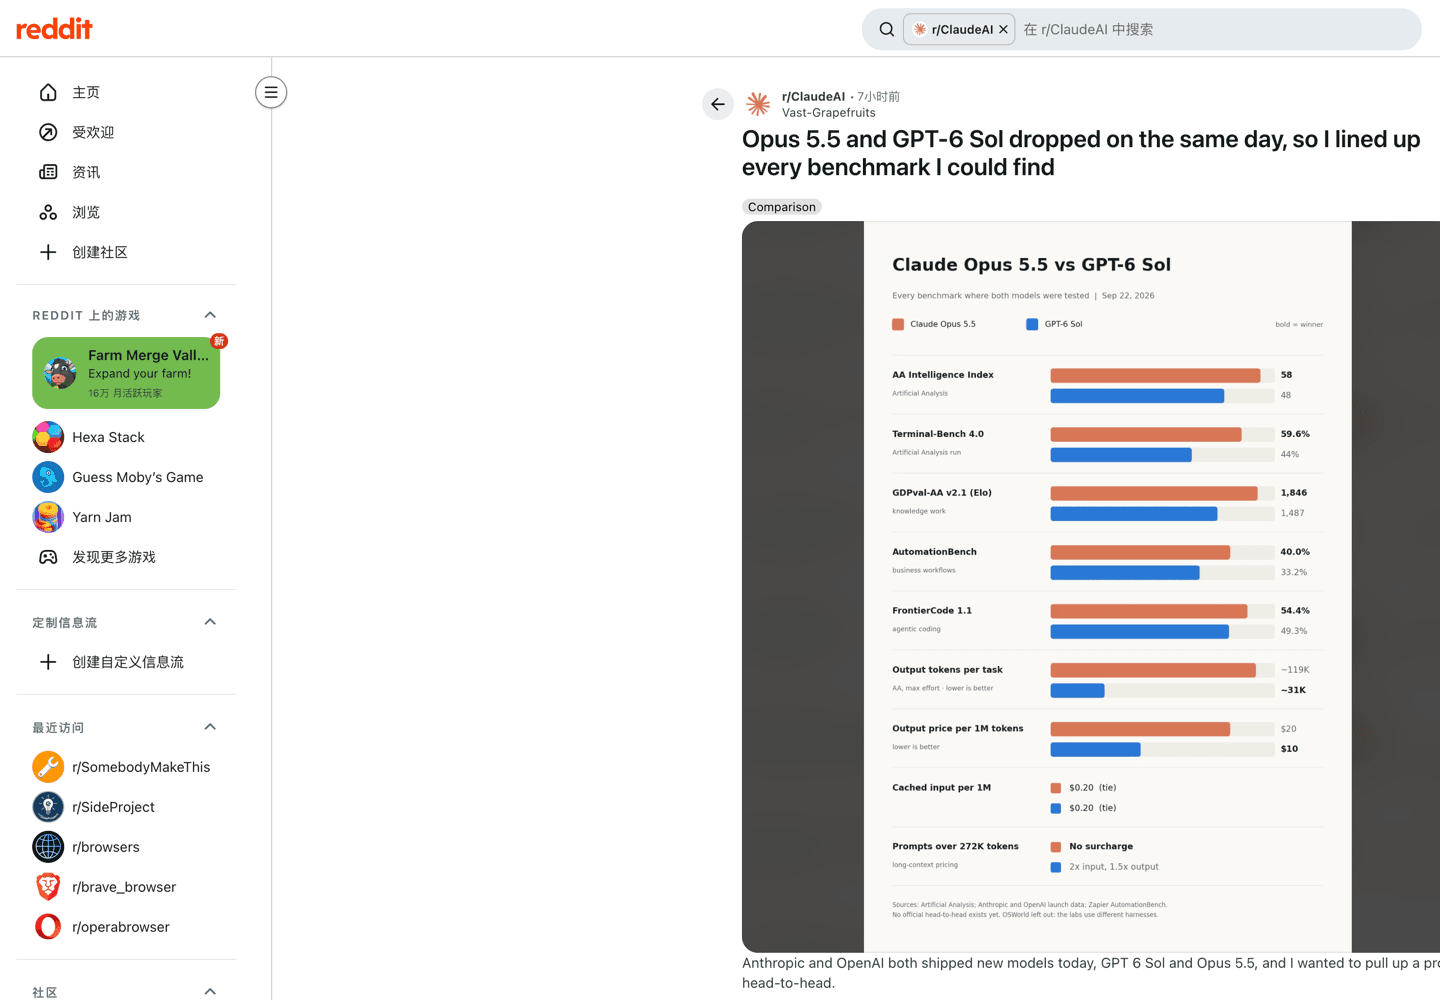
条件2:「デフォルト設定」は medium エフォート。 max では数理が反転します。公式の動作メモによれば「同じエフォート設定でも、このモデルは Claude Opus 5 より1ターンあたり多く考える傾向があり、特に xhigh と max で顕著」で、課金される思考こそが予算の刺客です。r/ClaudeAI の比較スレッドはその形を定量化しました。「max エフォートでは、AA は Opus 5.5 の1タスクあたり約11.9万出力トークンを計測。[GPT-6] Sol は約3.1万で、指数全体を回して1タスク $1.06」:
条件3:「典型的なワークロード」は、あなたのが典型的とは限らないこと。 コミュニティはここに傷を抱えており、その傷には値段がついています。発表ニュースのスレッドで最高得票(226票)のコメント:
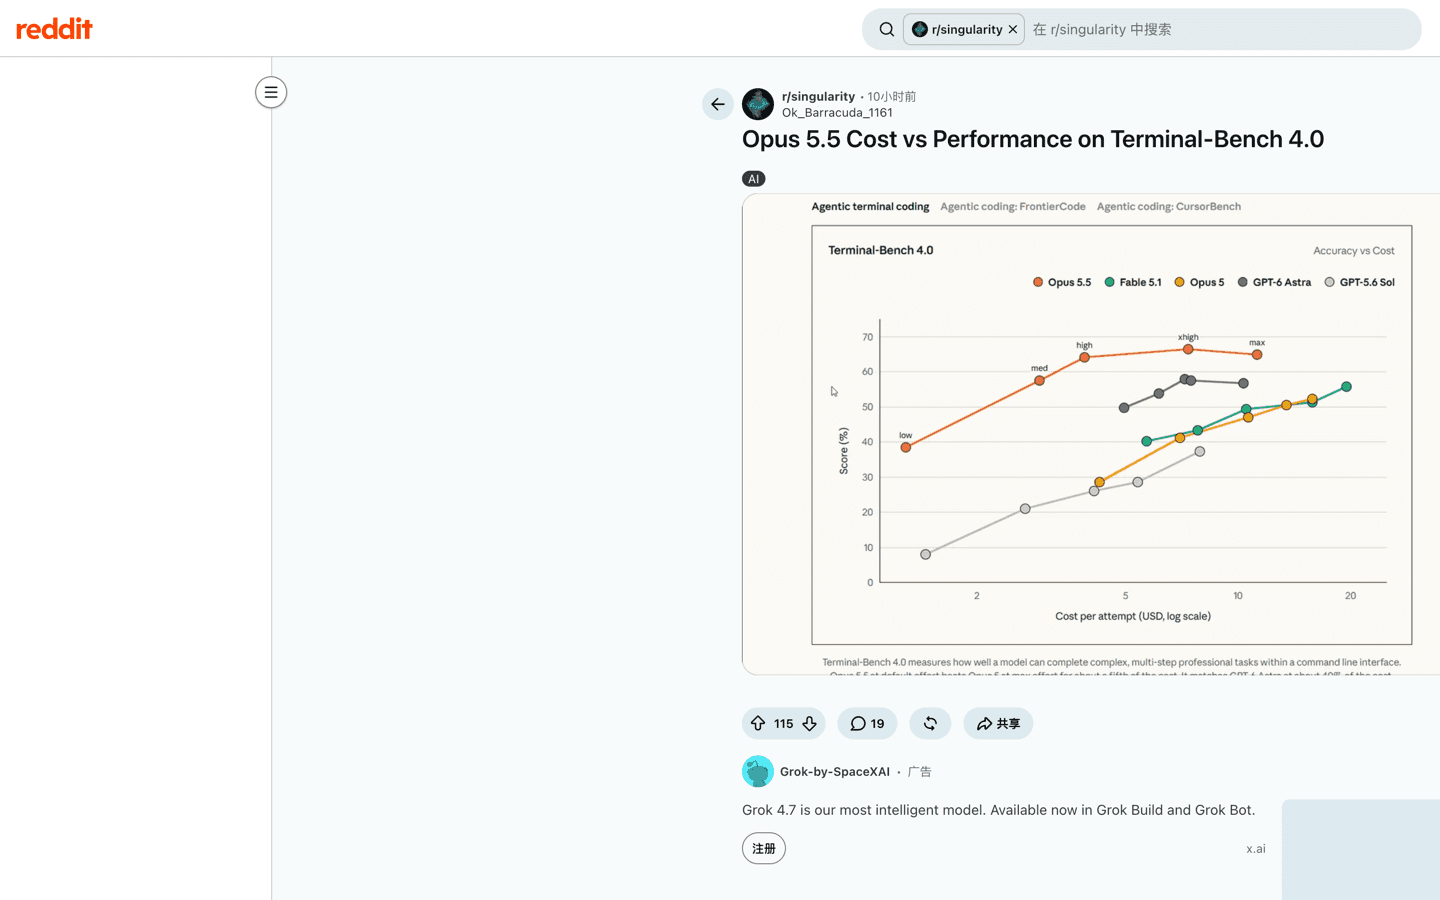
「Opus 5 が出たばかりの頃、彼らは最先端だと主張し続けた……しばらく使うと、Opus 5 はまともにコミュニケーションすらできないことが分かった……往復の苦労で多くの人は自分を疑い、さらに時間とトークンを無駄にした」。同じネットワークの懐疑派は AA のグラフを逆に読みます — 「opus 5.5 は astra に勝った……が、同じタスクに4.5倍のトークンを使った」— 擁護派は「opus 5.5 medium は Astra max と同じ性能で2.5倍安い」と読みます。どちらも同じ発表を読んでいます。あなたの請求書がどちらに似るかは、どのトークンが支配するかで決まり、それを測るのが次の節です。このトレードオフの能力面は Fable 5.1 レビューとエージェント的推論ガイドにあります。
エフォートのレバー:1タスク $0.55 から $5.98
料率表のどこにも、このダイヤルがどの価格行よりも大きくコストを動かすとは書かれていません。Artificial Analysis は Opus 5.5 を5つの独立エントリとして追跡しています。2026年9月23日のスナップショット:
| エフォート | Intelligence Index | 1タスクあたりコスト | 出力速度 |
|---|---|---|---|
| low | 42 | $0.55 | 83 t/s |
| medium(デフォルト) | 51 | $1.34 | 76 t/s |
| high | 54 | $1.82 | 90 t/s |
| xhigh | 56 | $3.46 | 76 t/s |
| max | 58 | $5.98 | — |
両端の列を一緒に読んでください。max は1タスクあたり low の 10.9 倍のコストで、測定知性は16ポイントしか変わりません。 medium — デフォルト — は Opus 5 の max と同じ知性指数です($1.34 対 Opus 5 の最上位価格)。r/ClaudeCode のスレッドで最高得票の返信はまさにこれです。「max は xhigh のほぼ2倍のコストで、他のレベルから外れた外れ値。medium か high を使えば実際の節約になるはず」。そこのある開発者はすでに階梯を軸にワークフローを組み直しました。「Opus 5.5 High は最高。fable 5.1 medium みたいだがずっと安い……大半の作業を Opus 5.5 high に切り替えた」。
ダイヤルを回す前の2つの注意。第一に移行:デフォルトは high(Opus 5)から medium に変わり、同じ設定でも新モデルは1ターンあたり多く考えます。Anthropic のドキュメントは設定を持ち越さずエフォートのスイープをやり直し、max_tokens に思考の余地を残すよう明示しています。第二に、高いエフォートは品質を安定して買うわけではありません。CodeRabbit の発表当日評価では「より高い推論エフォートは一貫してより良い完了率をもたらさなかった」— 評価すべきコメントが増えること自体がコストです:
発表ページの顧客の声も同じ方向です。Rogo は「最も低いエフォート設定で Opus 5 の high を上回り……出力トークンは約 60% 減」、Walleye Capital は最低設定で評価スイートを「概ね解決」。ベンダー自身の証拠が安い設定を指し続けるとき、それをデフォルトの答えとし、max は明らかに必要なタスクにだけ残してください。
見出しの外にある課金行
5つの行が実際の請求の大半を決め、最初の行だけが発表報道に載ります。
Fast モード:全行2倍、最大2.5倍の速度。 Fast(リサーチプレビュー、Claude API のみ)は入力 $8 / 出力 $40 で課金 — 標準カードの2倍で、キャッシュ行も含まれます(読み取り $0.40)。キャッシュとデータレジデンシーと重ねられ、Batch とは併用不可、出力は「最大2.5倍」高速。OpenRouter のプロバイダ表は Fast で143 tok/s(標準は71〜83)を計測しています。注目すべきは、Fast Opus 5.5 の出力 $40/100万 は Fable 5.1 の標準 $50 をまだ下回ることです。
Batch:50% のレバー。 非同期 Batch リクエストは $2/$10 — カード最大の割引で、コンテキストウィンドウ全体でプロンプトキャッシュと重なり、ベータヘッダーで最大30万出力トークンが可能です。管理エージェントのセッションは対象外。ステートフルで対話的だからです。
US-only 推論:全カテゴリ 1.1x。 inference_geo: "us" を設定すると、入力・出力・キャッシュ書き込み・キャッシュ読み取りのすべてが 1.1x になります。同じ10% はパートナークラウドのリージョナルエンドポイントにも現れ、OpenRouter は Bedrock/Azure/Vertex のリージョナルルートを $4.40/$22.00/$0.22 で掲載しています。コンプライアンス駆動のリージョンは毎行静かに1割余分に払い、グローバルルーティングがデフォルトで安い道です。
ツールのオーバーヘッドはトークンの請求書。 ツール使用のシステムプロンプトはリクエストごとに286トークン(Opus 4.7 の675から減)。ブラウザツールセットの宣言は約6,600入力トークン、computer use は約4,500を追加します。サーバー側ウェブ検索はトークンとは別に1,000回 $10。コード実行は検索/フェッチと併用なら無料で、月1,550コンテナ時間を超えると $0.05/時間。「エージェント」とは価格構造であってチャットではありません。ツール行は明示的に予算化してください。予算側の対比は Kimi K3 の価格分解にあります。
Managed Agents のランタイム:セッション時間あたり $0.08。running 中のみ計上され、トークン行はすべてモデル価格。Batch はセッションに適用されません。
ファミリーの階梯:Opus 5.5 vs Fable 5.1 vs Opus 5 vs Sonnet 5
| 項目(100万トークンあたり) | Opus 5.5 | Fable 5.1 | Opus 5 | Sonnet 5 |
|---|---|---|---|---|
| 入力 | $4.00 | $10.00 | $5.00 | $2.00 |
| キャッシュ読み取り | $0.20(0.05x) | $0.25(0.025x) | $0.50(0.1x) | $0.20(0.1x) |
| 出力 | $20.00 | $50.00 | $25.00 | $10.00 |
| Batch 入力 / 出力 | $2.00 / $10.00 | $5.00 / $25.00 | $2.50 / $12.50 | $1.00 / $5.00 |
| AA Intelligence Index(max) | 58 | 53 | 51 | 38 |
| AA の1タスクコスト(max) | $5.98 | $7.63¹ | — | — |
¹ Fable 5.1 は AA の9月22日スナップショットで、当社の Fable 価格分解経由。AA の両ページは日々動きます。
直感に反する行は最後の行です。Artificial Analysis の指数では、安いモデルが今や強いモデルでもある。 Opus 5.5 の max は Fable 5.1 の53に対し58を獲得し、1タスク $5.98 対 $7.63 — 一方 Anthropic 自身の位置づけは Fable を「野心ある長時間の非同期仕事」に留め、Opus と Fable の差は「このスコアが示すより狭い」と述べています。こう読みます:スコアは差を誇張するが、価格差は現実で、そして逆転している。キャッシュ付きのループはさらに接近します。Fable は最も深い読み取り割引(0.025x)を保持しますが、読み取りは $10 の基本から始まる $0.25/100万。Opus 5.5 の $0.20 は絶対値で下回ります。
同じ AA グラフに対する2つのコミュニティ読解を並べて:
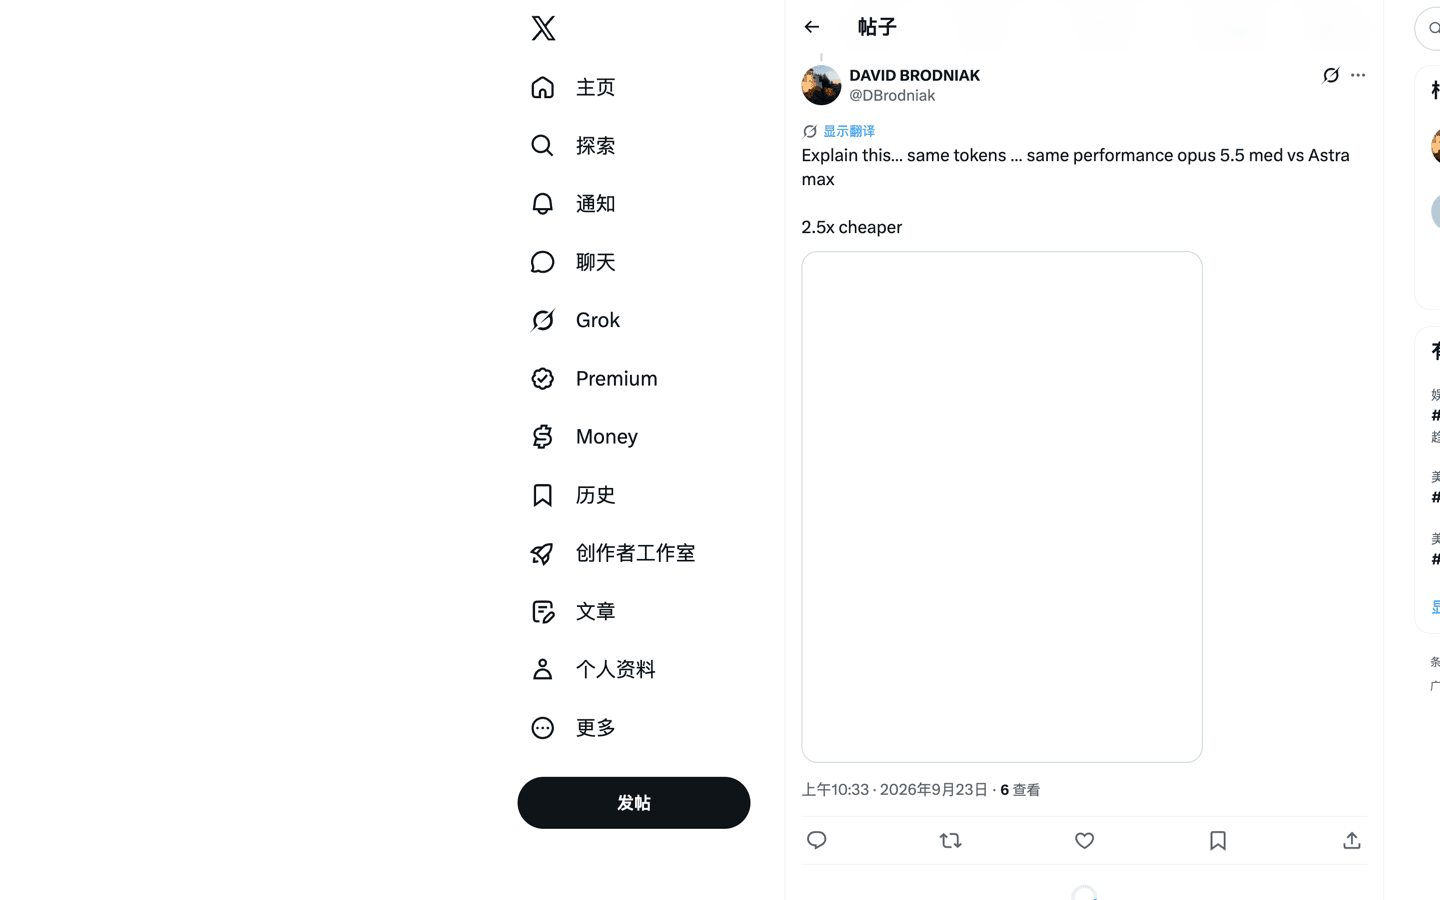
「same tokens … same performance opus 5.5 med vs Astra max — 2.5x cheaper」対「opus 5.5 は astra に勝った……が4.5倍のトークンを使った」。どちらも同じ形を説明しています。Opus 5.5 は完了タスクあたりコストで勝ち、タスクあたりトークンで負ける。厳格なトークン予算、サードパーティルーター、スループット上限のようなトークン形状に敏感なワークロードなら、移行前に計測を。タスク形状なら、階梯はほぼ全段で Opus 5.5 に傾きます。
旗艦の下では、Sonnet 5 が $2/$10 で予算の座を守り、読み取り $0.20 — 今や Opus 5.5 と同価 — Haiku 4.5 は $1/$5。階梯の新しい論理は、キャッシュ読み取り列がここまで圧縮され、賢いモデルと安いモデルが、エージェントが最も叩く行に同じ金額を請求するようになったことです。
課金されないもの
ドキュメントの境界は返金ポリシーのようで、エージェント規模では重要です:
破棄された thinking ブロックは課金されない。 モデルが読めない thinking ブロックを含むリクエストでは、API は推論前にそれを破棄します。「リクエストは成功し、破棄されたブロックは課金されない」。思考ブロックが会話に紐づくモデルにとって、これが優雅な劣化ラインです。
セーフガードのリルートは他モデルで完了する。 発表ページのベンチマーク脚注によれば、サイバーセキュリティ判定のリクエストは Opus 4.8 が完了し、切り替えは透明です(拒否は政策領域付きの
stop_reason: "refusal"を返し、サーバー側フォールバックが推奨モデルで再試行する)。Anthropic は Fable のように Opus 5.5 のリルート課金を明記していません。文書化されるまで、完了モデルのレートを仮定するのが無難です。失敗したウェブ検索は課金されない。 成功は1,000回 $10。エラーは無料。ウェブフェッチは取得コンテンツのトークン以外に追加料金なし。
コード実行は検索やフェッチと併用なら無料で、毎月1,550コンテナ時間が無料、超過後は $0.05/時間。
プランでの可用性:API、クラウド、コンシューマー
API の料率表は3つの経済圏のひとつにすぎません。2026年9月23日に claude.com/pricing とドキュメントで確認:
| 提供面 | 価格(確認表示値) | Opus 5.5 の可用性 |
|---|---|---|
| Anthropic API | 上記トークンレート | 可 — claude-opus-5-5 |
| Free プラン | $0 | 不可(Sonnet/Haiku のみ) |
| Pro | 年払い $17/月(前払い $200)または月払い $20 | 可 — 標準枠 |
| Max 5x / 20x | $100〜/月 | 可 — 標準枠 |
| Team | Standard は Pro 超、Premium = 5x Standard | 可 |
| Enterprise | 年払い $20/シート/月 + API レートの使用量 | 可、支出管理付き |
| クラウド | AWS Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWS | 可。リージョナル +10%、Foundry は CCU 課金 |
下線を引くべき行:プラン比較ではOpus は Pro/Max で標準使用枠から消費され、「usage credits、週上限の50%」の注釈がつくのは Fable です。Fable の1時間は枠に対して標準モデル2時間分。Opus 5.5 は違います。発表時にさらに2つの変更が上乗せされました。Pro、Max、Team、シート課金 Enterprise の5時間上限の引き上げと、「好きなときに保存して使える」上限リセットです。
これが実務で何を意味するか、コミュニティは割れており、同じスレッドに両方向が見えます:
「I am using Fable 5.1 rn, and this is 5x cheaper for same intelligence? I am never going to hit my weekly limits at this rate」— 対 — 「この値下げは必ずしもサブスクに反映されるわけではない……API コストをマーケティングに使い、尺度を API ユーザーに有利にしている」。上限引き上げは文書化されています。それがどれほど寛大かは、自分の5時間ウィンドウでしか答えられない待ち伏せです。仕組みとしては、使用量は5時間のローリングセッションでリセットされ、有料プランは週上限を上積み。ウェブ、デスクトップ、モバイル、Claude Code は同じプールから消費し、有料プランの usage credits で上限超過後も標準 API レートで継続できます。
試算2例、前提をすべて見せる
標準レート、再試行なし、ツールなし、税なし。算数であって予測ではありません。
長い思考を伴う短い質問。 入力10,000トークン、出力2,000:
(10,000 × $4 + 2,000 × $20) / 1,000,000 = $0.08大きなリポジトリでのコールドエージェントループ。 入力300,000トークン(標準レート — 長期コンテキスト枠なし)、出力8,000:
(300,000 × $4 + 8,000 × $20) / 1,000,000 = $1.36同じループのウォーム版。 同じ300,000トークンのコンテキスト、90% キャッシュ、セッションごとに1回の1時間書き込み、1パス出力8,000:
1パス: (270,000 × $0.20 + 30,000 × $4 + 8,000 × $20) / 1,000,000 = $0.334
一回限り: 300,000 × $8 / 1,000,000 = セッション書き込み $2.40
ウォームパスはコールドの4分の1に下がり、$2.40 の書き込みは再利用のたびに償却されます — 5分の書き込み($1.50)は再読1回、1時間の書き込みは2回で元が取れる。プレフィックスが変われば、同じループは毎パス $1.36 のコールド起動に戻ります。モデルリソース (English)とそのプロンプト集 (English)に、自分のヒット率を測れる繰り返し可能なタスクがあります。
ローカル計算
Claude Opus 5.5 APIのトークン費用を見積もる
2026-09-23に確認した公式USD料金を使用します。入力値はブラウザー内だけで処理されます。
キャッシュヒットは100万トークンあたり0.20ドル——Opus 5.5の0.05倍レートです。この見積もりは再試行、ツールオーバーヘッド、安全ガードによる再ルーティング、業者上乗せを除外します。Fastモードは全ラインを2倍にし、Batchとは併用できません。 最新料金を確認
計算機は完全にこのページ内で動きます — 何もどこにも送信されません。両方のキャッシュ書き込み期間と、標準、Batch、US-only、Fast の各モードを計算し、入力をローカルで検証します。意図的にモデル化しないもの:再試行、サブエージェントのファンアウト、ツールのオーバーヘッド、セーフガードのリルート — それらはマージンに織り込んでください。予算を確定する前に公式の料率表を再確認してください。本文は2026年9月23日時点の数字です。
実践的な選択肢:Tabbit で比較を実行する
予算の次に来るのは地味な部分です。Opus 型の仕事を実際に走らせるには、ページとファイルとモデル呼び出しが同じ場所にあり、「Opus 5.5 を medium で試し、ダメなら Sonnet に落とす」がオーケストレーション案件ではなく選択である環境が必要です。それが Tabbit Browser の占める位置です — モデルピッカー、ライブタブ、ローカルファイルがひとつの画面を共有する エージェント的 AI ブラウザー です。
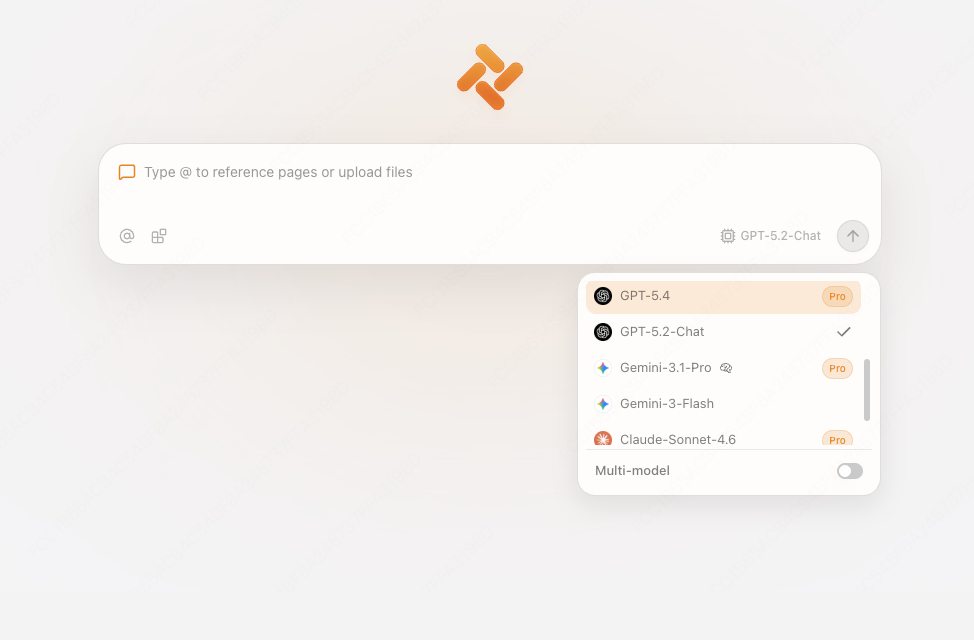
境界を明示します:Tabbit はクライアントであって、Anthropic の課金レイヤーではありません。モデルの可用性はアカウントとエディション次第で、ブラウザーの何も Anthropic の請求を変えません — 上の料率表は Opus 5.5 がどこで動いても適用されます。本記事は Tabbit 内で Opus 5.5 タスクを実行していないため、可用性や性能の主張はしません。ブラウザーが変えるのはセットアップコストです — このページ全体が「請求額を決める」と言う2つの数字、自分のキャッシュヒット率とエフォート閾値を実仕事で測るのは、そのために作られたワークスペースが最も安上がりです。方法は Tabbit 作業習慣ガイドにあります。
 Tabbit Browser
Claude Opus 5.5 価格の意思決定表
| あなたのワークロード | コストの駆動要因 | 最適な出発点 | 注意点 |
|---|---|---|---|
| 長いエージェントループ、安定したリポジトリ/ドキュメント | キャッシュ読み取り | 標準枠、プレフィックス固定、1時間書き込み | プレフィックス編集で紐づく thinking ブロックが無効化。チャーンは読み取りを1.25〜2xの書き込みに変える |
| 短い対話、軽微な編集 | 出力トークン | より低いエフォート — または Sonnet 5 | 思考はオフ不可。デフォルト medium で通常十分 |
| 夜間評価、バッチリファクタ | 量 | Batch API の $2/$10、30万出力ベータ | 対話的・管理エージェントセッションは対象外 |
| レイテンシ制約の対話作業 | 出力速度 | Fast モードの2x($8/$40)、キャッシュ併用 | Fast は Batch と併用不可。全行を2倍にする |
| コンプライアンス必須の米国内処理 | 全行 | US-only の1.1x、またはクラウドのリージョナル(+10%) | プレミアムはキャッシュ読み取りにも適用 |
| トークン形状に敏感な予算(ルーター、上限) | 1タスクのトークン | 移行前に計測 | Opus 5.5 は1タスクコストで勝ち、1タスクトークンで負ける |
| サブスクの日々の利用 | 5時間ウィンドウ | Pro/Max — Opus は標準枠で上限も引き上げ | 同じプランの Fable は週上限50%の usage credits を消化 |
最終評価
Claude Opus 5.5 は前任より安くなった初めての Opus で、値下げは全行で本物です — 入出力 20% 減、エージェント請求を支配するキャッシュ読み取り 60% 減、今や Sonnet 5 と同価。長時間のエージェント的コーディングと知識作業のために、medium エフォートで、プレフィックスを安定させ、待てる仕事はすべて Batch に任せて買うべきモデルです。AA 指数では Fable 5.1 をより低い1タスクコストで上回り、ファミリーの階梯は組み替わりました。それでも直らない2つの請求書:max エフォートの思考(料率表には決して映らない11倍のレバー)と、トークン形状に敏感な予算(より無駄のない競合より1タスクのトークンが多い)。サブスクでは枠に優しい旗艦です — 標準使用、上限引き上げ — ただしチームを commit する前に自分の5時間の燃焼を確認してください。毎月公式価格ページを再確認してください。Sonnet 5 の標準化も今回の発表も、階梯が速く動くことの証明です。能力の物語は Fable 5.1 概要とレビューに、上記のコミュニティ記録がワークロードの証拠を担い、ファミリー横断の価格比較は同じ表示価格が他でいくらかを示します。
Sources
Anthropic 価格ドキュメント — 料率表、0.05x キャッシュ脚注、Fast モード、Batch、レジデンシー、ツール価格。2026-09-23 確認
Claude Opus 5.5 モデルページと新機能 — 仕様、デフォルトエフォート、破壊的変更、「1ターンの思考増」、破棄ブロックの課金。2026-09-23 確認
Anthropic 発表ページ — 40% 主張と条件、HAProxy の例、顧客のコスト引用、上限引き上げ、リルート。2026-09-23 確認
claude.com/pricing — Free/Pro/Max の比較と Opus/Fable の枠規則。2026-09-23 確認
Artificial Analysis のリリースページ — エフォート別の知性、速度、1タスクコストのスナップショット。2026-09-23 確認
OpenRouter Opus 5.5 — プロバイダーレート、リージョナル、Fast のスループット。2026-09-23 確認
スクリーンショットと条件を本文内に併記したコミュニティ記録:r/ClaudeCode の max 疑問、r/ClaudeAI の Sol 比較、r/ClaudeAI の発表スレッド、r/singularity のサブスク割れ、X のグラフ2読解、CodeRabbit の評価動画、HN の発表スレッド

よくある質問
Claude Opus 5.5 はいくらですか?
Anthropic API では、Claude Opus 5.5 は100万入力トークンあたり $4、100万出力トークンあたり $20 です(2026年9月23日に Anthropic の価格ドキュメントで確認)。プロンプトキャッシュの書き込みは100万あたり $5(5分)または $8(1時間)、キャッシュ読み取りは100万あたり $0.20 — この 0.05x レートはこのモデルのみに適用されます。Batch API はすべて半額の $2/$10、Fast モードはすべて2倍の $8/$40 です。
Claude Opus 5.5 は Opus 5 より安いですか?
料率表のすべての行が下がりました。入出力は Opus 5 の $5/$25 より 20% 安く、キャッシュ書き込みは $6.25/$10 から $5/$8 へ、キャッシュ読み取りは $0.50 から $0.20 へと 60% 下がりました。Anthropic はデフォルト設定での典型的なワークロードで全体として約 40% 低コストと推定しています。例外はエフォートです。max では1ターンあたりの思考量が増え、独立系の1タスクあたり測定値は low の $0.55 から max の $5.98 まで — 表示価格には映らない 11 倍の幅があります。
Claude Opus 5.5 は無料プランで使えますか?
使えません。Anthropic のプラン比較では Opus は Free では利用不可で、Free で使えるのは Sonnet と Haiku のみです。Opus 5.5 は Pro、Max、Team、Enterprise の標準枠に含まれます — 特に Fable 5.1 が Pro/Max で採用している usage credits 方式ではなく、標準使用として扱われます。発表時には Pro、Max、Team、シート課金の Enterprise の5時間利用上限が引き上げられ、好きなときに使える上限リセットも追加されました。
Claude Opus 5.5 を最も安く使う方法は?
レバーを順番に使います。プロンプトのプレフィックスを安定させて読み取り直しが100万あたり $4 ではなく $0.20 で計上されるようにする。合格判定を通る最低のエフォートで動かす(デフォルトの medium で十分なことが多い)。緊急でない仕事は Batch API の $2/$10 に回す。コンプライアンスやレイテンシの要件がなければ US-only と Fast モードは避ける。移行時はエフォートの再スイープも必要です。同じ設定でも Opus 5.5 は Opus 5 より1ターンあたり考えやすくなります。
Claude Opus 5.5 は長いコンテキストに追加課金がありますか?
ありません。100万トークン全体のコンテキストウィンドウが標準のトークン単価で課金され、長期コンテキスト枠は存在しません。プロンプトキャッシュと Batch 割引はウィンドウ全体に適用されます。Batch API ではベータヘッダーで最大出力を30万トークンまで引き上げられます。なお Claude 4.7 以降のモデルは新しいトークナイザーを使い、同じテキストで約 30% 多くのトークンを生成します。
セーフガードのリルートや失敗したツール呼び出しは Opus 5.5 価格で課金されますか?
セーフガードでリルートされたリクエストは別のモデルで完了します。Anthropic によればサイバーセキュリティ判定の仕事は Opus 4.8 が処理し、切り替えは黙って課金されるのではなく透明に報告されます。失敗したウェブ検索は一切課金されず、ウェブフェッチは取得コンテンツがトークン化される分以外に追加料金なし。モデルが読めない thinking ブロックは推論前に破棄され、課金されません。コード実行は検索やフェッチと併用なら無料で、単独使用時は毎月1,550コンテナ時間まで無料です。