
Gemini 4 Argon은 장시간 코딩과 지식 작업에 유용할 수 있지만, 공개 증거만으로 “항상 최고”라고 단정할 수는 없습니다. Google은 특정 엔지니어링 작업에서의 내부 성과를 공개했고, 독립 평가 결과는 추론 수준과 벤치마크에 따라 달라집니다. 실제 사용자는 API 비용이나 구독 한도만큼 결과 품질이 나오는지 따져야 합니다. Google 사례에 따르면 Argon은 Python Agent Development Kit의 장시간 세션 메모리 준비 시간을 40% 줄이고 콜드 임포트를 21% 단축했습니다. 이 리뷰의 핵심 수치지만, Google이 한 코드베이스에서 보고한 결과이며 다른 프로젝트의 예상치가 아닙니다.
핵심 요약
Argon은 복잡한 코딩, 연구, 여러 단계의 작업을 겨냥합니다. Gemini API 모델 카드는 입력과 출력을 합쳐 100만 토큰의 컨텍스트를 명시합니다.
Google ADK 사례는 장시간 세션 준비 40% 단축과 콜드 임포트 21% 개선을 보고합니다. 독립 재현 결과는 제시하지 않습니다.
Artificial Analysis Index v5.0.1에서 Argon High는 50, Carbon High는 60입니다. 아홉 개 평가를 합친 지표이지 모든 업무를 대변하지 않습니다.
Reddit 사용자는 코딩 품질, 할당량 사용, 후속 작업에 대해 엇갈린 경험을 말합니다. 통제된 시험이 아닙니다.
깊은 추론이 필요하고 결과를 검토할 수 있을 때 시험해 보세요. 순위만 보고 선택하지 마세요.
Gemini 4 Argon 리뷰 한눈에 보기
| 증거 | 공개 내용 | 증명하지 않는 것 |
|---|---|---|
| Google ADK 엔지니어링 사례 | 장시간 세션 준비 40% 단축, 콜드 임포트 21% 개선 | 다른 코드베이스에서도 같은 향상 |
| Artificial Analysis Index v5.0.1 | Argon High 50점, 아홉 평가 종합 | 고정 순위나 완전히 같은 조건의 비교 |
| Gemini 4 Argon 모델 카드 | API 입력·출력 합산 컨텍스트 100만 토큰 | 모든 제품의 동일한 한도와 할당량 |
| Reddit 사용자 의견 | 성능과 사용 한도에 상반된 평가 | 공식 이용 규칙이나 보편적인 성공률 |
공개된 강점
Google은 Argon을 복잡한 코딩, 금융, 법률, 사이버 보안과 과학 작업용으로 소개합니다. 10월 ADK Python 사례에서 팀은 저장소 규칙과 짧은 목표를 제공했습니다. Google은 그 결과 장시간 세션의 메모리 준비 시간이 40% 줄고 콜드 임포트가 21% 빨라졌다고 설명합니다. 글은 코드 변경 링크를 제공해 사례를 확인할 수 있습니다.
다만 Google이 선정한 프로젝트이며, 무작위 비교 시험은 설명되지 않았습니다. 개선은 해당 코드 경로에 해당합니다. 다른 프로젝트도 40% 빨라진다는 뜻은 아닙니다. 모델 카드에는 환각, 타임아웃, 높은 추론 수준에서의 토큰 사용 증가도 언급되어 있습니다.
벤치마크가 답하는 범위
Artificial Analysis 비교 페이지는 Index v5.0.1에서 Argon High 50점, Carbon High 60점을 표시합니다. 아홉 평가를 종합하며 정기적으로 갱신되므로 비교할 때 버전과 날짜를 기록해야 합니다. 영구 순위가 아닙니다. 출력 단가가 같더라도 입력·캐시·추론·답변 토큰 양이 달라지면 작업 비용은 달라질 수 있습니다.
Reddit 사용자는 Codex, Claude Code, Antigravity, OpenCode를 사용한 작은 역공학 비교도 공개했습니다. Argon Medium은 세 작업에서 평균 56.33점이었지만 모델별 실행 도구가 달랐습니다. 평가 설계의 중요성을 보여 주는 자료이지, 조건을 맞춘 정면 비교는 아닙니다.
결론: 내 작업으로 검증하기
복잡한 코딩·분석·연구 작업에서 결과를 검토할 수 있고 중단 조건이 명확하다면 Argon을 제한적으로 시험할 만합니다. 간단한 질문, 검토 없는 고위험 업무, 소비자용 이용 한도에 묶인 흐름에는 맞지 않을 수 있습니다. 대표 작업 하나로 시작해 프롬프트와 결과를 저장하고 원본 파일과 대조한 뒤 사용량을 확인하세요. 한 번의 성공이나 실패로 일반적인 성공률을 추정하지 마세요.
코딩 조사에 브라우저 작업도 포함된다면 별도 워크플로를 다루는 Gemini 4 Carbon 브라우저 가이드와 Gemini CLI 브라우저 MCP 가이드를 참고하세요.
MammothResult8482는 Gemini 앱에서 “consumes a lot of tokens”라고 했고, Lost-Willow386은 프롬프트 하나가 “way too much quota for a single prompt”를 쓸 수 있다고 말했습니다. 서로 다른 사용자의 경험담이지 할당량 측정은 아닙니다.
관련 글
Reddit 원문 캡처
원본 토론을 브라우저에서 연 화면입니다. 개인 경험이며 제품 보증이 아닙니다.
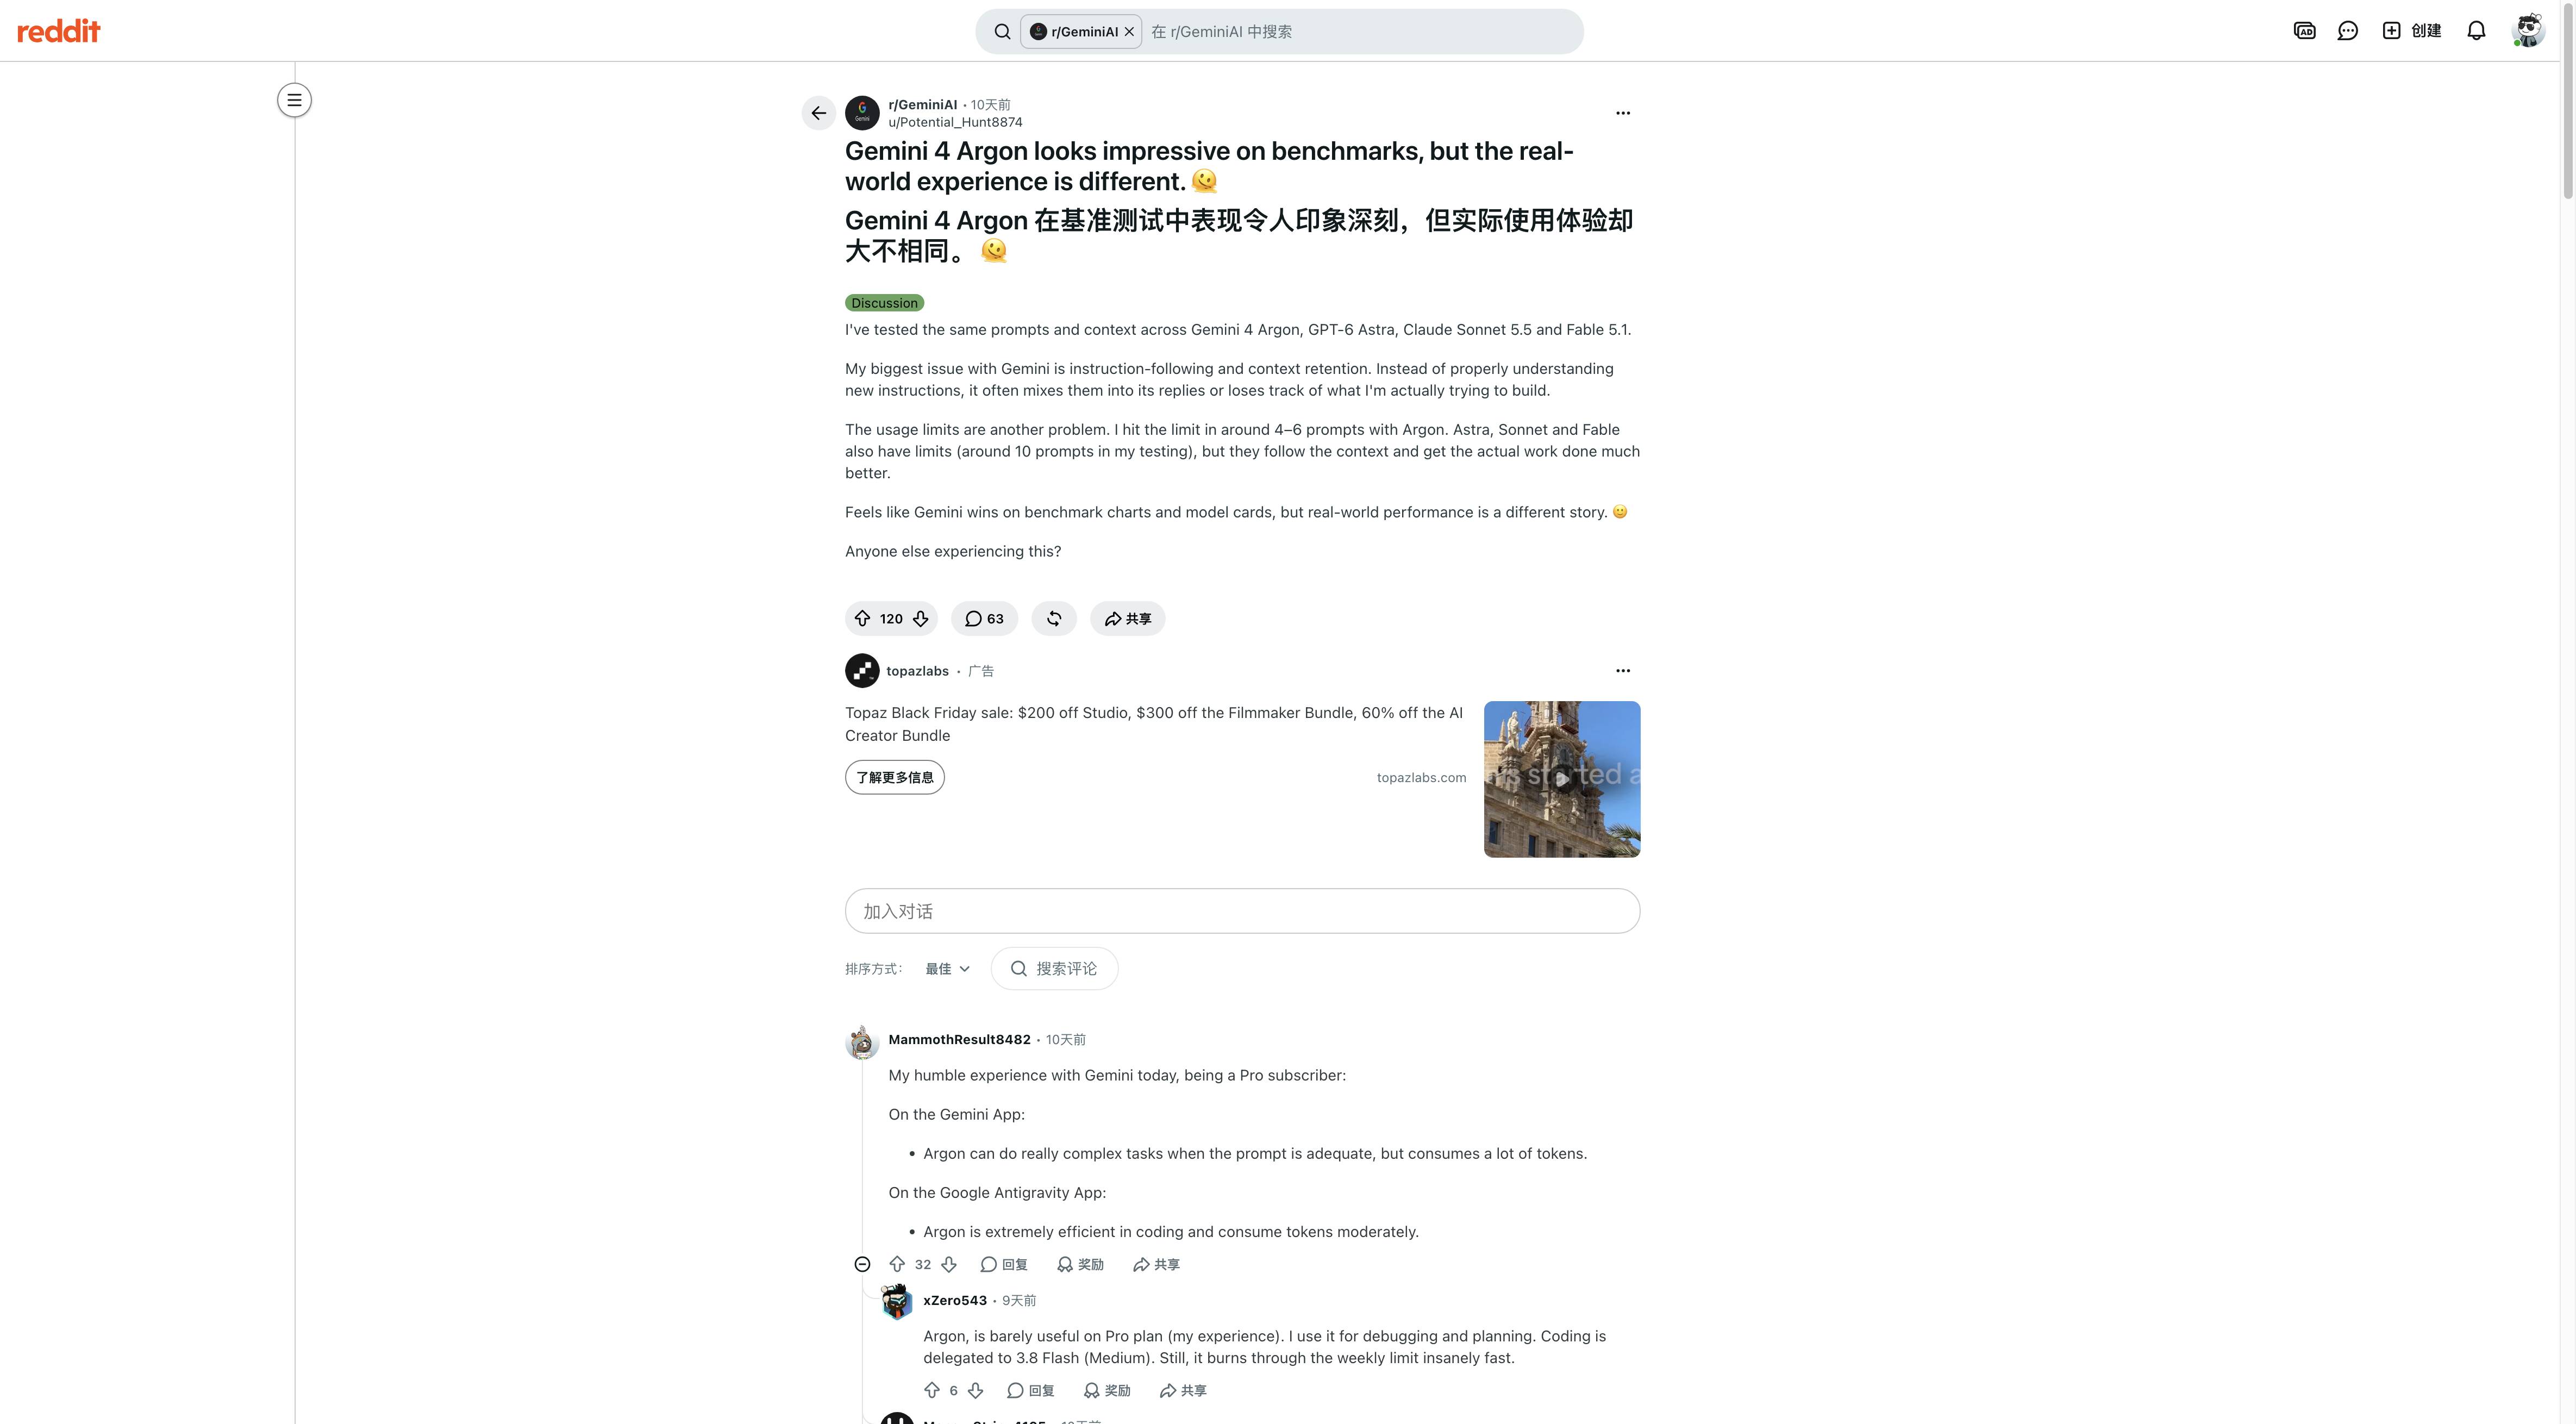
MammothResult8482의 Gemini 앱과 Antigravity 사용 경험 비교. 수집 당시 약 10일 전 게시. Reddit 원문 스레드
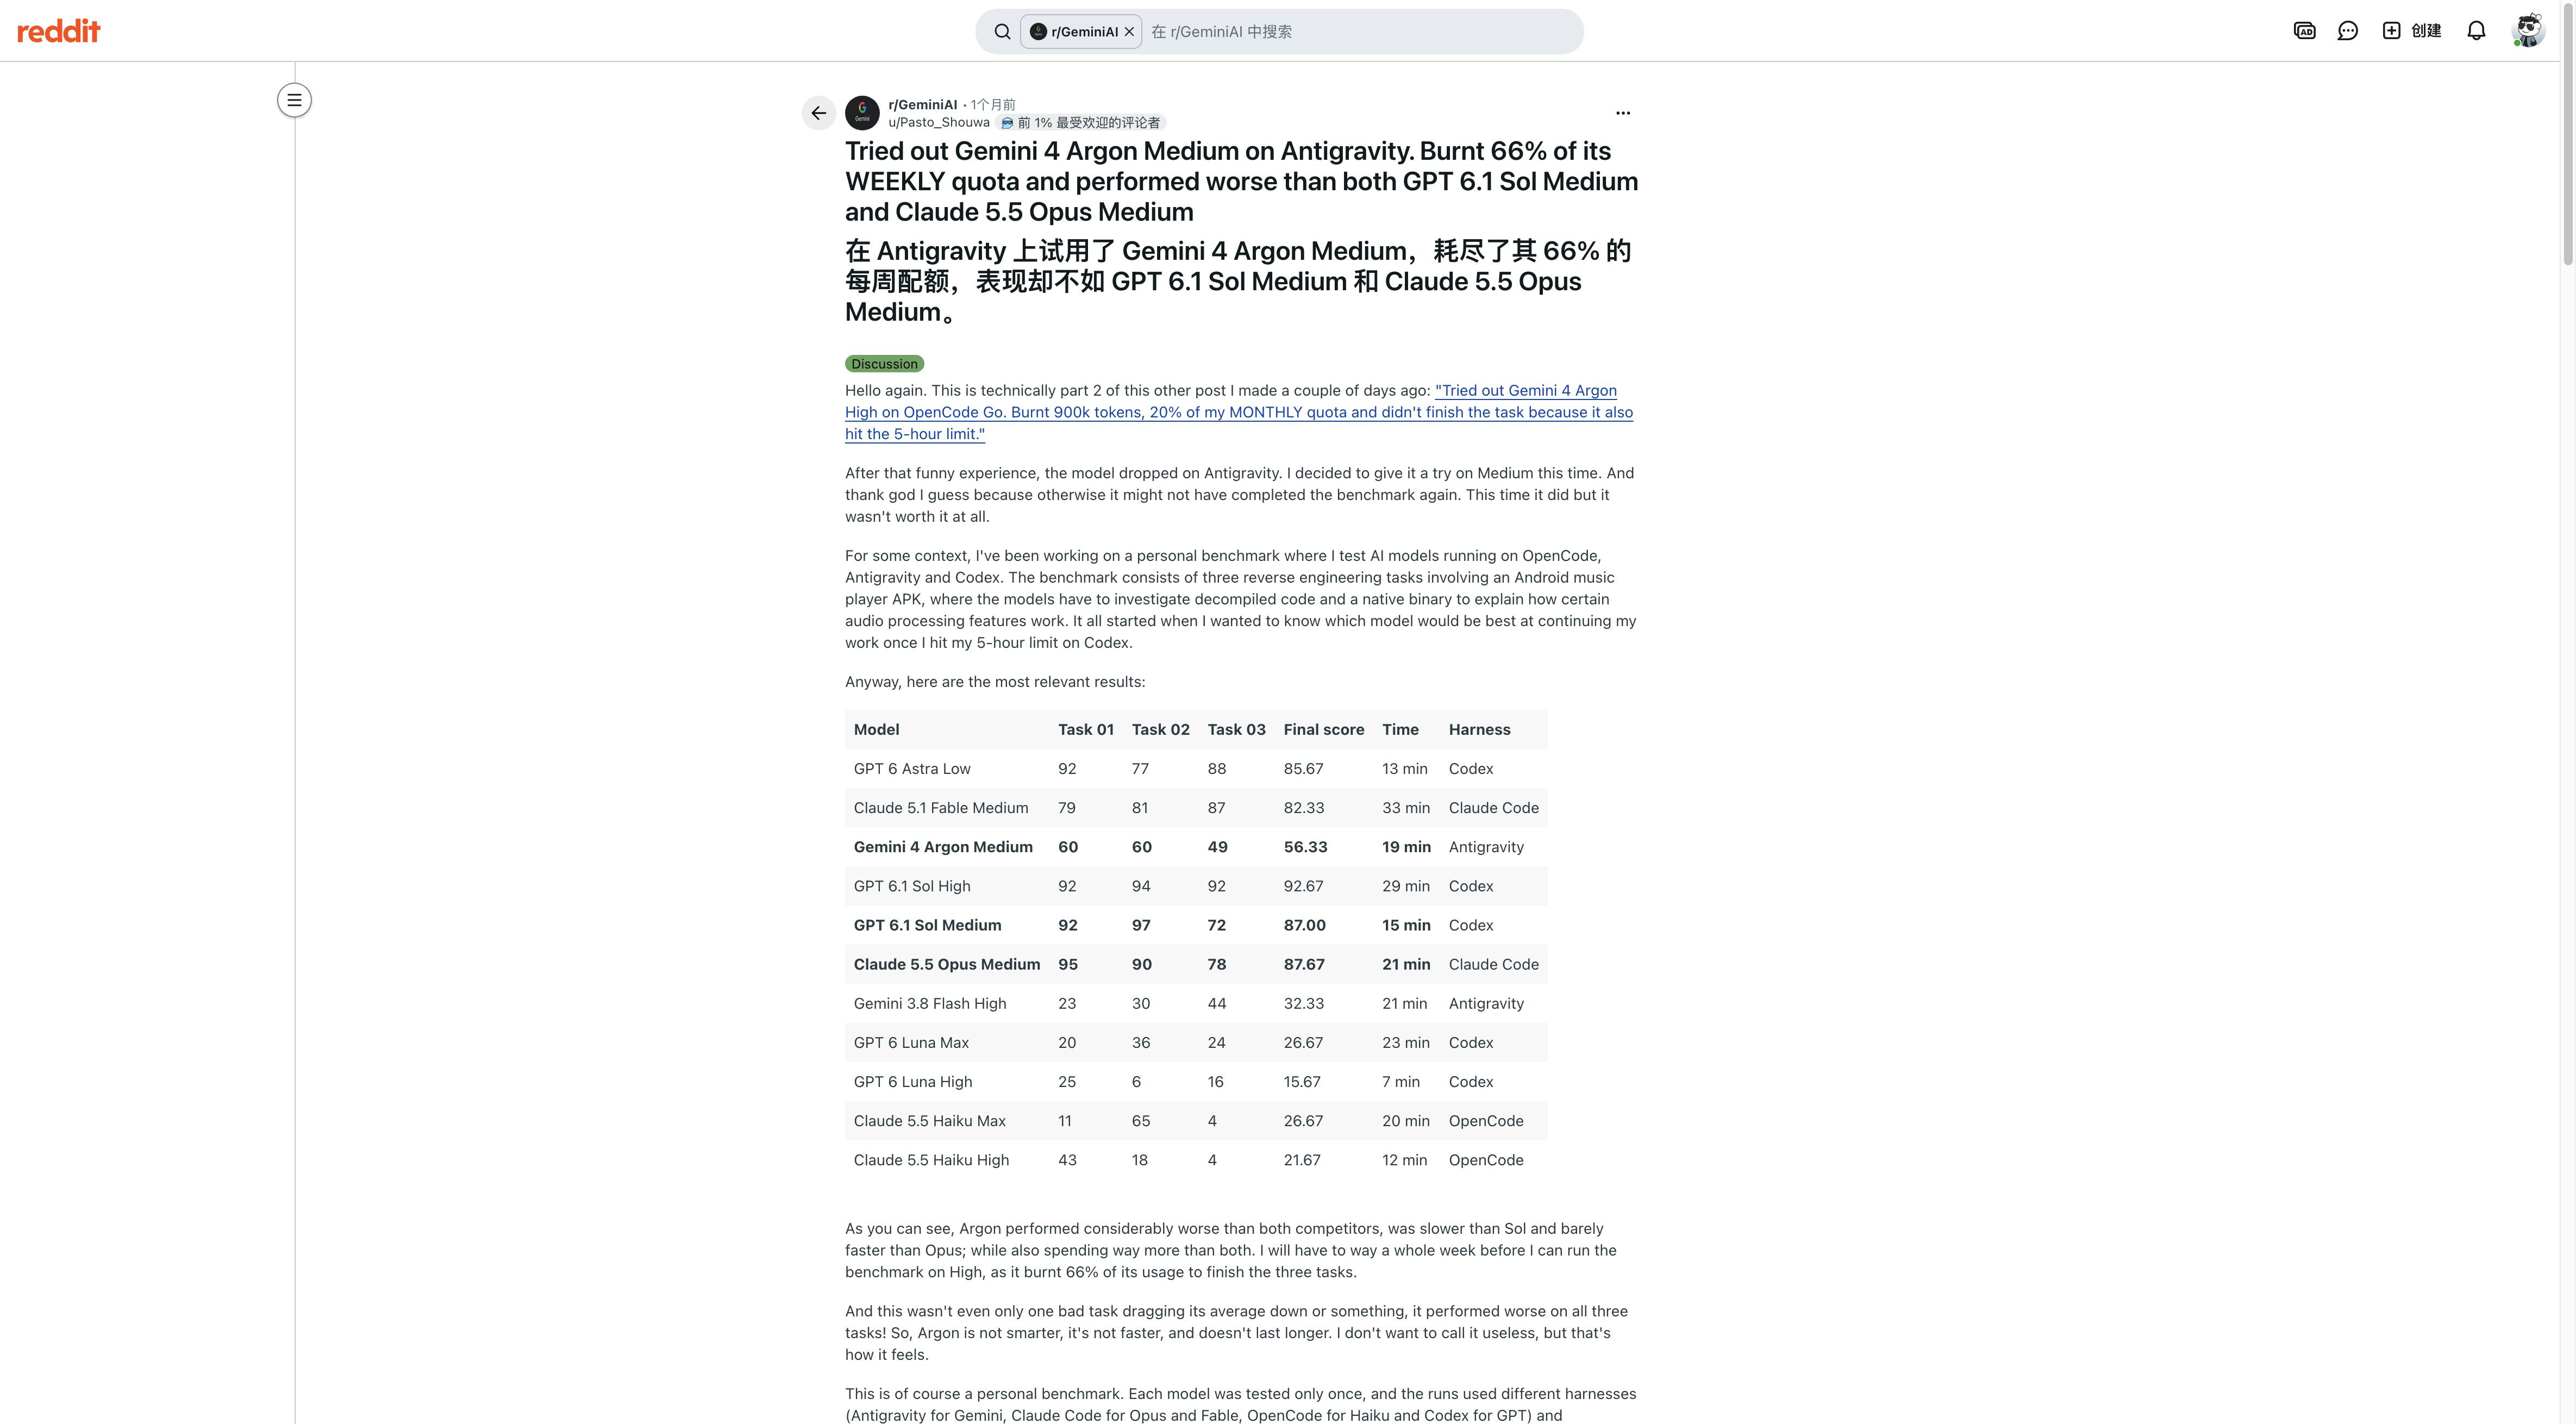
Pasto_Shouwa가 세 가지 개인 평가와 서로 다른 실행 도구를 설명합니다. Reddit 원문 스레드
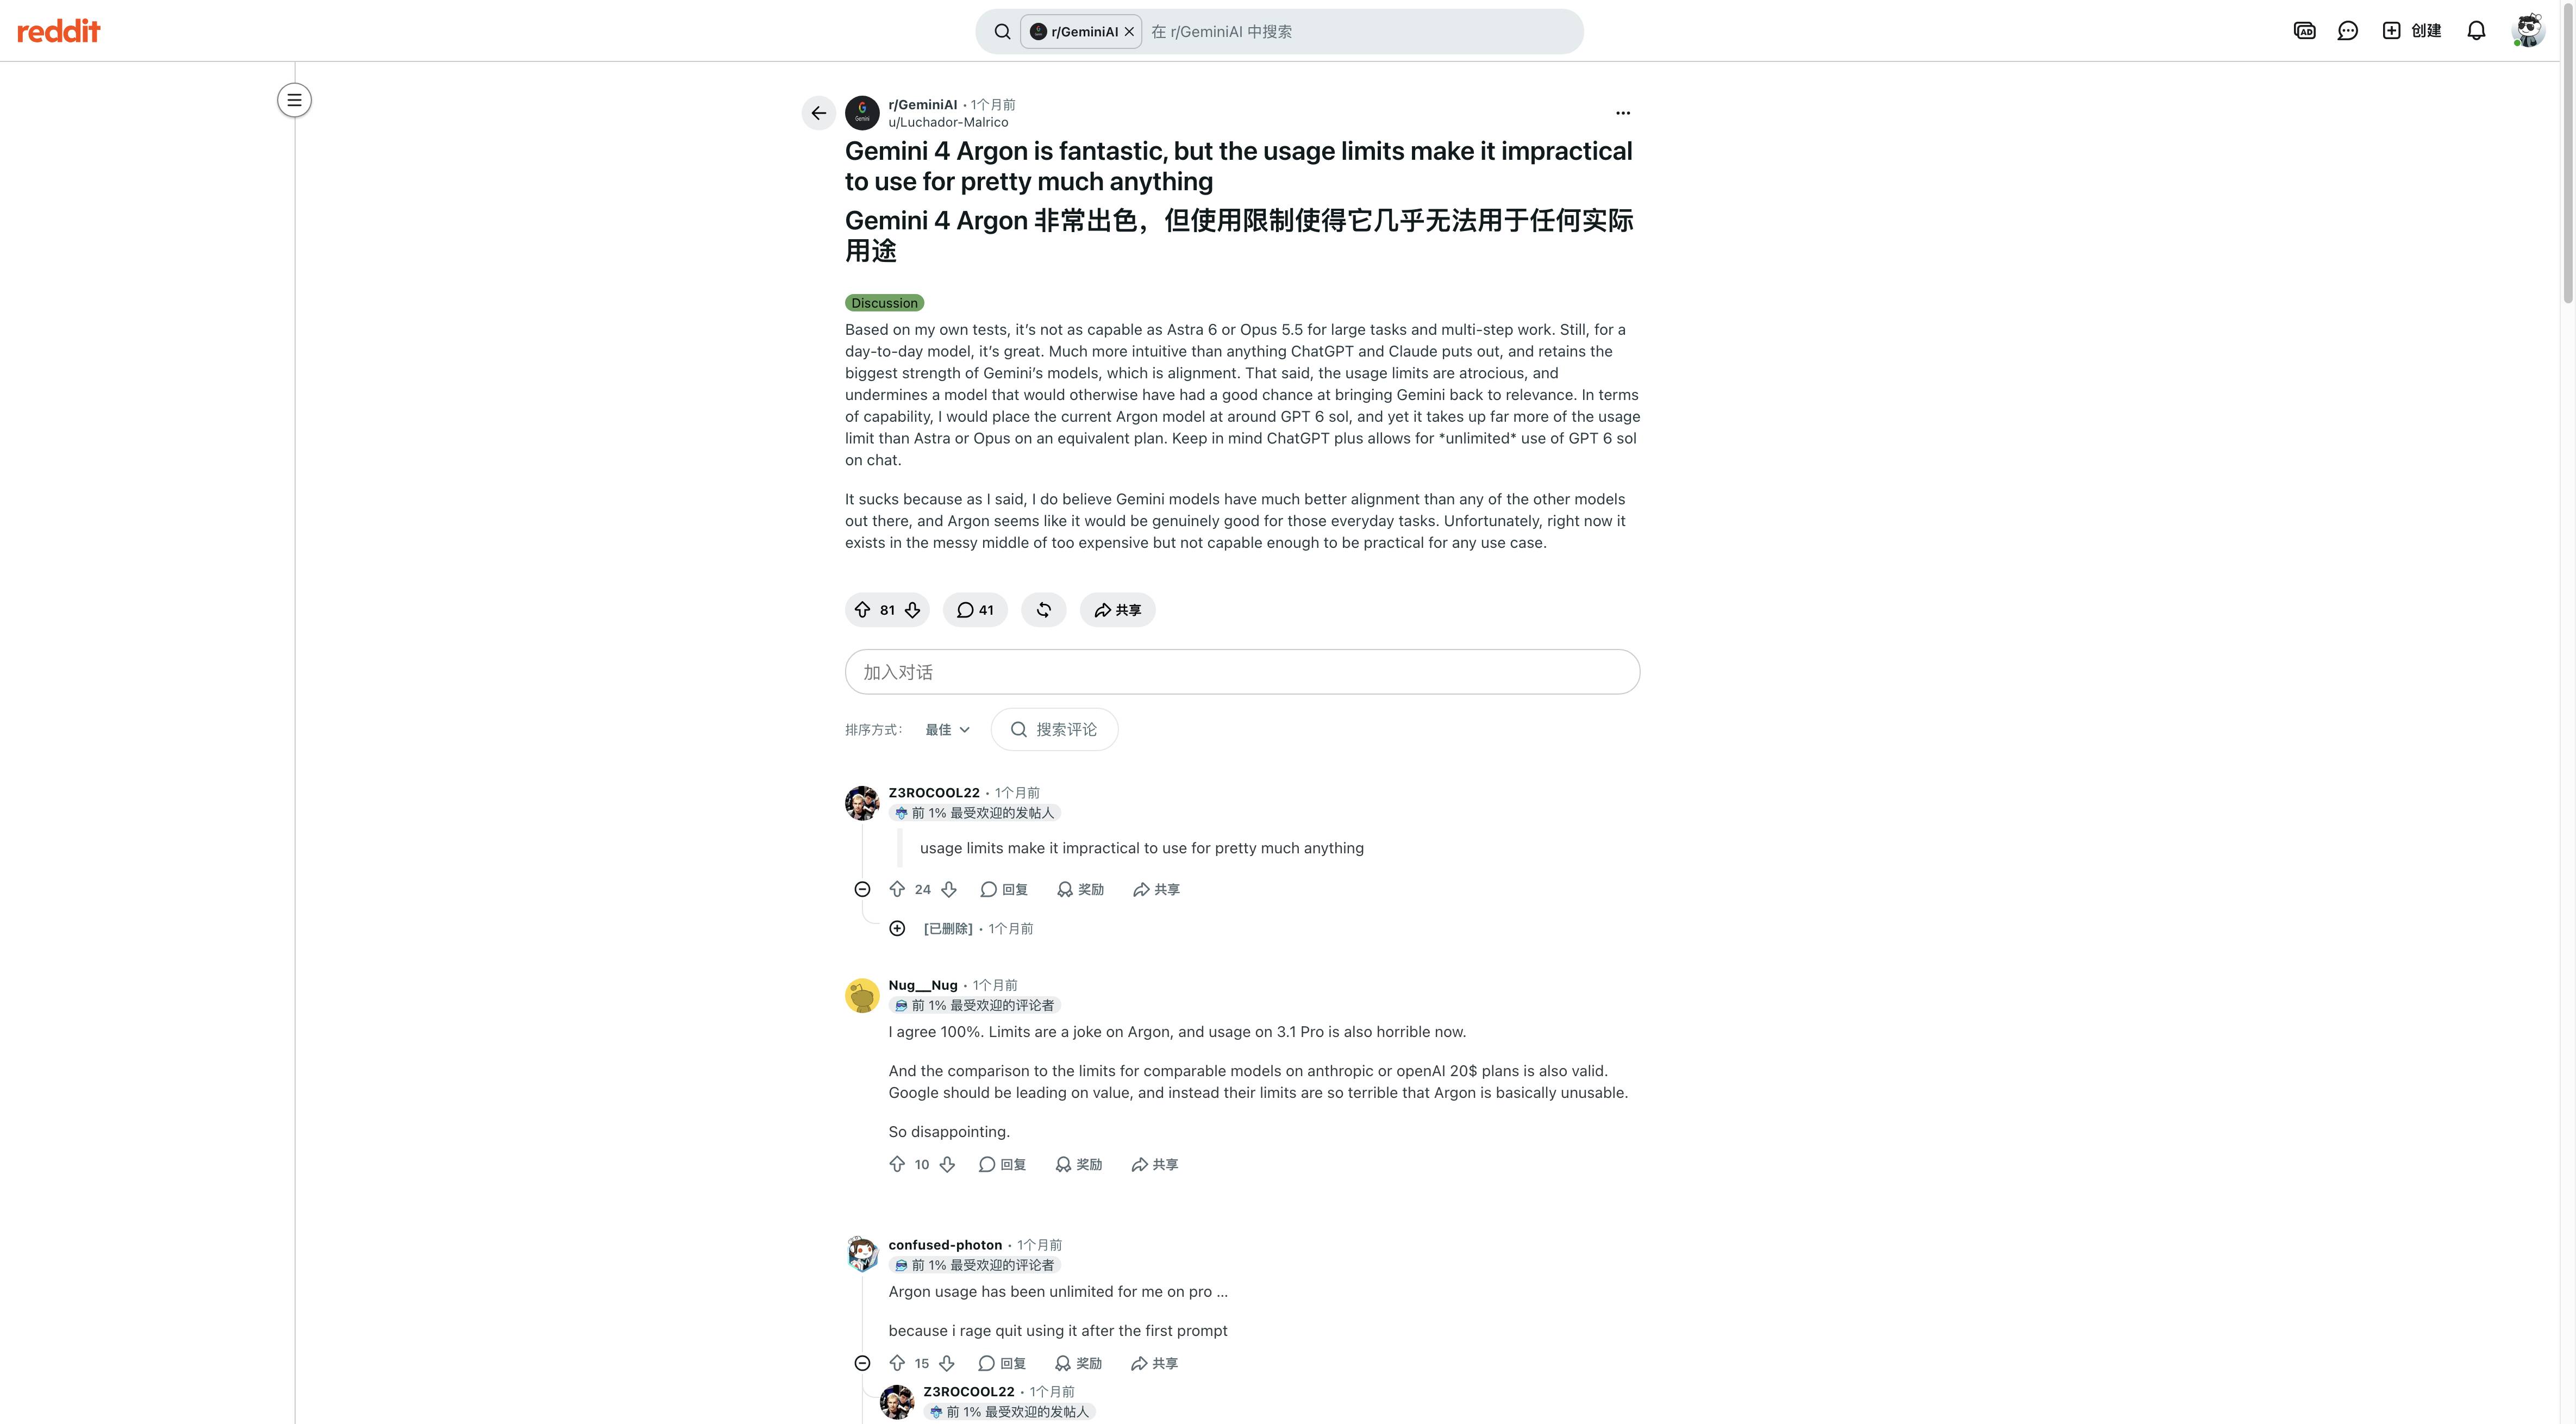
Reddit 사용자가 Argon 사용 한도에 대해 공유합니다. 플랜별 개인 경험입니다. Reddit 원문 스레드
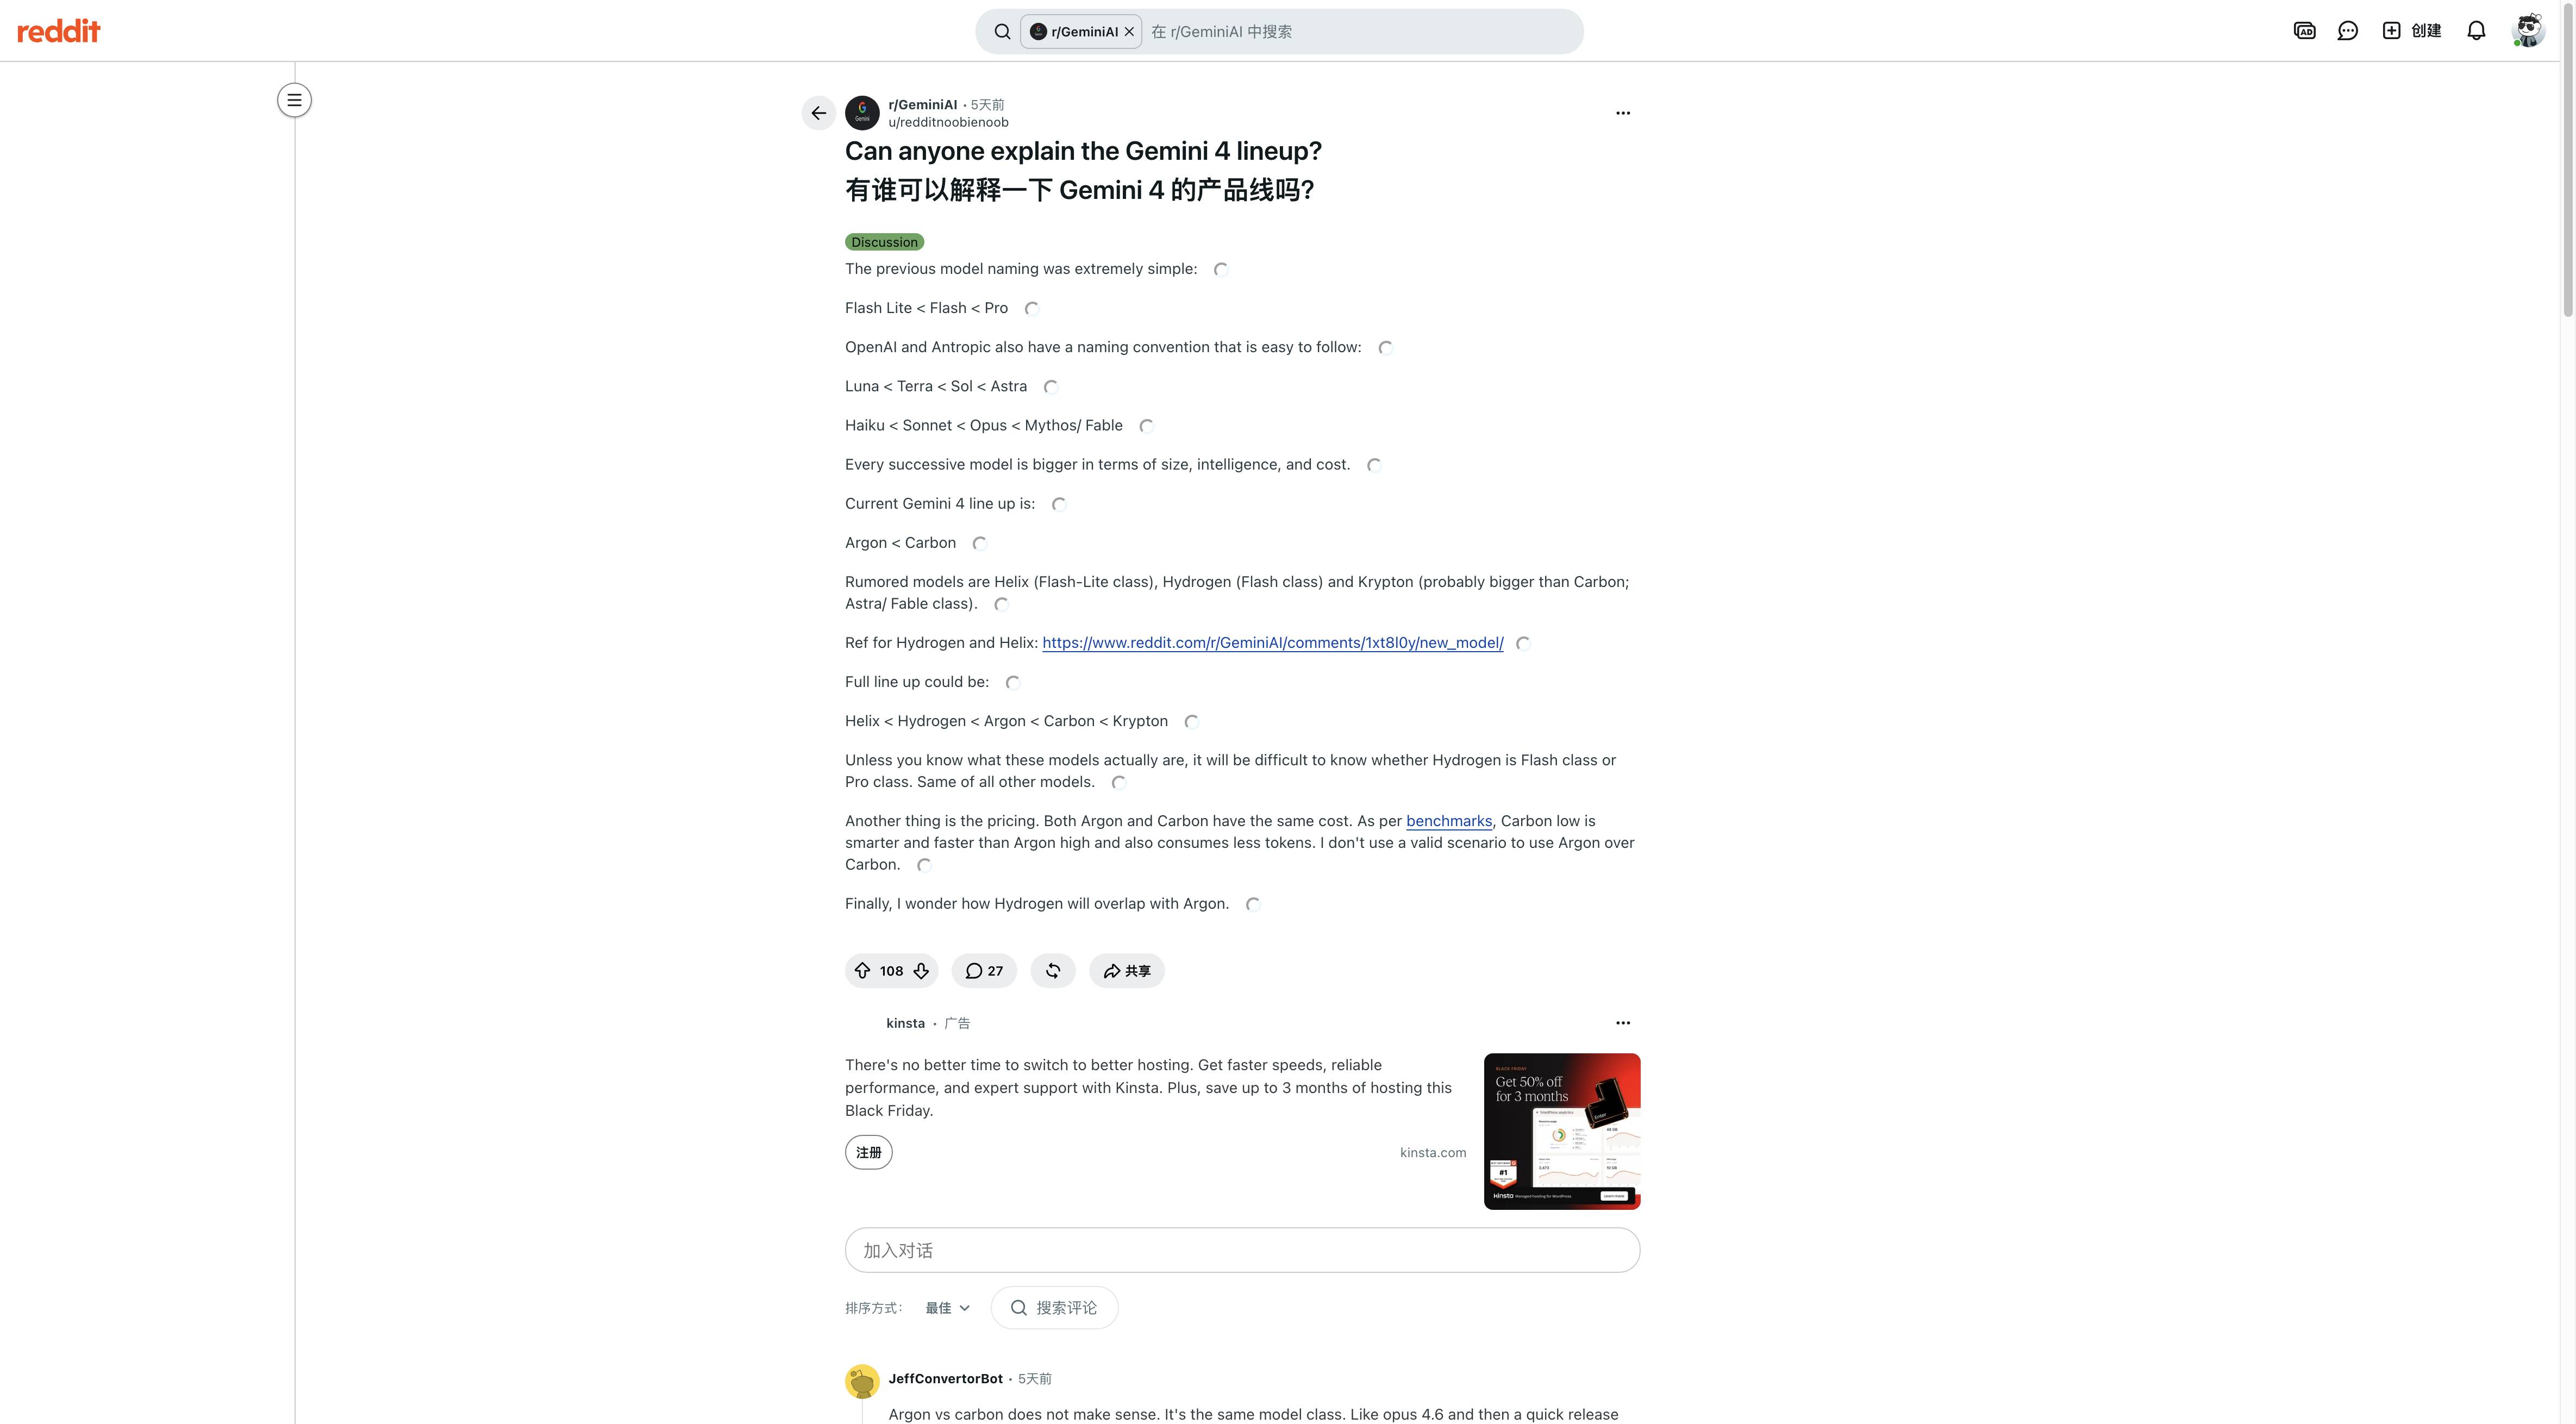
Argon과 Carbon 명칭의 의미를 묻는 Gemini 라인업 토론입니다. Reddit 원문 스레드

자주 묻는 질문
Gemini 4 Argon은 좋은 모델인가요?
복잡하고 결과를 검토할 수 있는 코딩과 지식 작업에 적합한 후보입니다. 공개 증거는 특정 작업에 한정되므로 기본 모델로 쓰기 전에 직접 시험하세요.
Gemini 4 Argon의 컨텍스트 창은 얼마인가요?
Google은 Gemini API에서 입력과 출력을 합쳐 최대 100만 토큰을 명시합니다. 제품별로 다른 한도가 있을 수 있습니다.
Argon이 Gemini 4 Carbon보다 항상 뛰어난가요?
아닙니다. Artificial Analysis Index v5.0.1은 Argon High 50점, Carbon High 60점을 보여 줍니다. 작업 비용과 지연도 설정에 따라 달라집니다.
왜 Argon이 할당량을 많이 쓴다는 말이 있나요?
Reddit 사용자는 Gemini, Antigravity, API에서 서로 다른 경험을 공유합니다. 개인 경험이며 공식 한도는 아닙니다.
내 작업에 Argon이 맞는지 어떻게 평가하나요?
대표 작업을 정하고 모델마다 프롬프트, 도구, 성공 기준을 동일하게 유지하세요. 완료 여부, 재시도, 시간, 토큰 비용을 기록하세요.
Argon 벤치마크는 독립 검증되었나요?
Artificial Analysis Index v5.0.1 같은 독립 평가가 있습니다. Google 엔지니어링 사례는 공급자 보고서이며 어느 쪽도 모든 워크플로 성능을 예측하지 않습니다.