
Gemini 4 Argon pode ser útil para programação contínua e trabalho de conhecimento, mas as evidências públicas não justificam chamá-lo de “o melhor” em todos os casos. O Google publica ganhos internos em tarefas específicas; resultados independentes variam conforme o nível de raciocínio e o benchmark. Para quem paga, a pergunta é se a qualidade compensa o custo da API ou a cota da assinatura. O caso do Google afirma que Argon reduziu em 40% o tempo de preparação de sessões longas no Python Agent Development Kit e em 21% o tempo de importação a frio. Esse é o dado central desta análise: um resultado do Google em uma base de código, não uma previsão para qualquer projeto.
Principais pontos
Argon mira programação complexa, pesquisa e tarefas em várias etapas. O cartão do Gemini API descreve contexto combinado de entrada e saída de 1 milhão de tokens.
O caso do ADK informa 40% menos preparação em memória em sessões longas e importações a frio 21% mais rápidas. A página não apresenta reprodução independente.
O Artificial Analysis Index v5.0.1 mostra 50 para Argon High e 60 para Carbon High, agregando nove avaliações.
No Reddit há opiniões divergentes sobre programação, cota e continuidade. São relatos pessoais, não testes controlados.
Vale testar Argon quando o raciocínio adicional ajuda e você pode revisar a saída. Não escolha apenas pelo ranking.
Gemini 4 Argon: resumo da análise
| Evidência | O que informa | O que não comprova |
|---|---|---|
| Caso de engenharia ADK do Google | Preparação de sessão longa 40% menor; importação a frio 21% mais rápida | O mesmo ganho em outro projeto |
| Artificial Analysis Index v5.0.1 | Argon High marca 50; nove avaliações agregadas | Ranking permanente ou condições iguais |
| Cartão do Gemini 4 Argon | Contexto API combinado de 1 milhão de tokens | Mesmo limite ou cota em todas as interfaces |
| Relatos no Reddit | Opiniões variadas sobre qualidade e uso de cota | Regra oficial, taxa geral de sucesso ou teste controlado |
O que Argon parece fazer bem
O Google posiciona Argon para programação complexa, finanças, direito, segurança cibernética e ciência. O caso de outubro descreve uma otimização do ADK em Python: a equipe forneceu as regras do repositório e um objetivo curto. Segundo o Google, o trabalho reduziu em 40% a preparação de sessão em memória durante sessões longas e acelerou em 21% as importações a frio. A publicação liga as alterações de código para permitir inspeção.
Há limites. O Google escolheu o projeto e não descreve uma comparação aleatória. O ganho pertence a um caminho de código específico. Isso demonstra ajuda naquela tarefa, não uma promessa de deixar qualquer repositório 40% mais rápido. O cartão do modelo também alerta para alucinações, timeouts e maior uso de tokens nos níveis altos de raciocínio.
O que os benchmarks respondem
A comparação do Artificial Analysis mostra Argon High com 50 e Carbon High com 60 no Index v5.0.1, que reúne nove avaliações. A página é atualizada regularmente; registre versão e data. Não é um ranking permanente. Mesmo com o mesmo preço de saída, o custo por tarefa pode mudar porque cada execução usa quantidades diferentes de entrada, cache, raciocínio e resposta.
Um usuário do Reddit publicou uma pequena comparação de engenharia reversa com Codex, Claude Code, Antigravity e OpenCode. Ele relata média 56,33 para Argon Medium em três tarefas, mas os modelos usaram ferramentas diferentes. O post ajuda a discutir metodologia, mas não é um confronto controlado: ferramentas, prompts, planos e critérios de nota divergem.
Veredito: teste na sua própria tarefa
Argon merece um teste limitado para programação, análise ou pesquisa complexas se você puder revisar a saída e definir uma condição de parada. É menos óbvio para perguntas simples, tarefas de alto risco sem revisão ou fluxos presos a uma cota de consumidor. Comece por um caso representativo, salve instrução e resultado, confira os arquivos de origem e então verifique o uso. Uma execução não determina uma taxa geral de sucesso.
Para pesquisa de programação no navegador, consulte o guia do Gemini 4 Carbon no navegador e o guia do Gemini CLI com browser MCP, que tratam de fluxos distintos.
MammothResult8482 descreveu o Gemini como “consumes a lot of tokens”; Lost-Willow386 disse que um prompt pode usar “way too much quota for a single prompt”. São relatos de pessoas diferentes, não uma medição da cota.
Leia também
Capturas do Reddit
Capturas das discussões originais abertas no navegador. São experiências individuais, não garantias do produto.
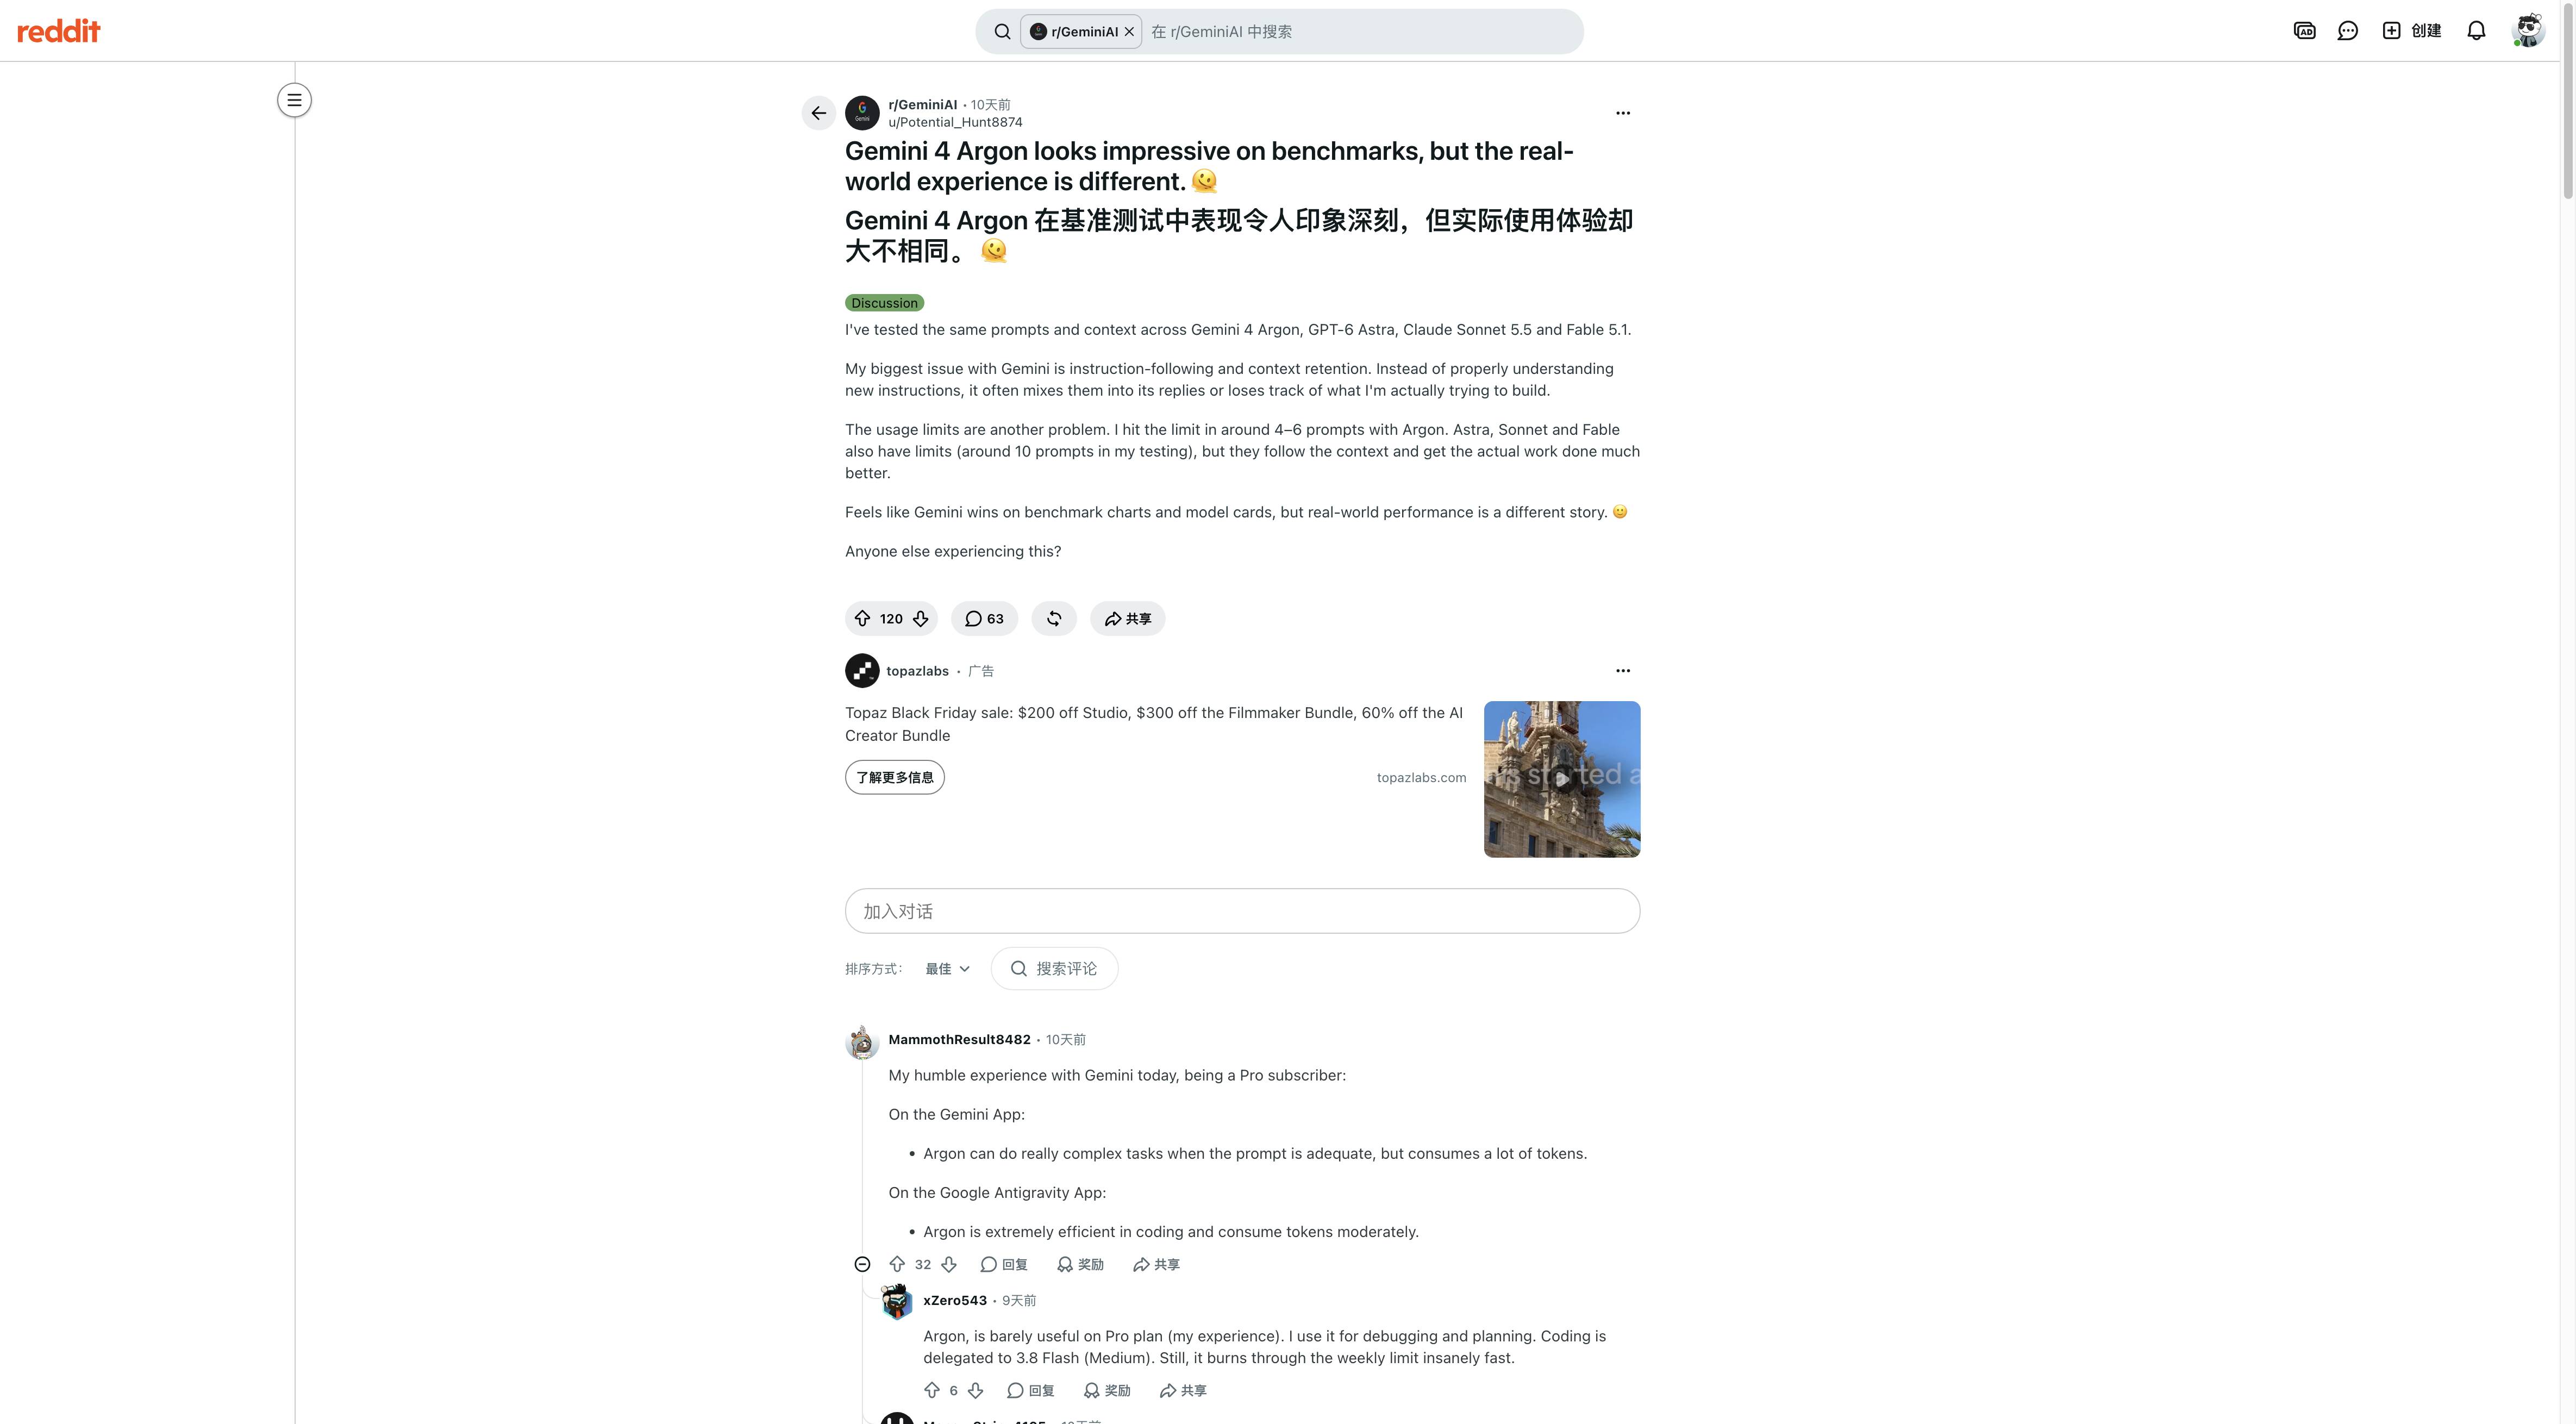
MammothResult8482 compara Gemini e Antigravity; cerca de 10 dias antes da coleta. Discussão original no Reddit
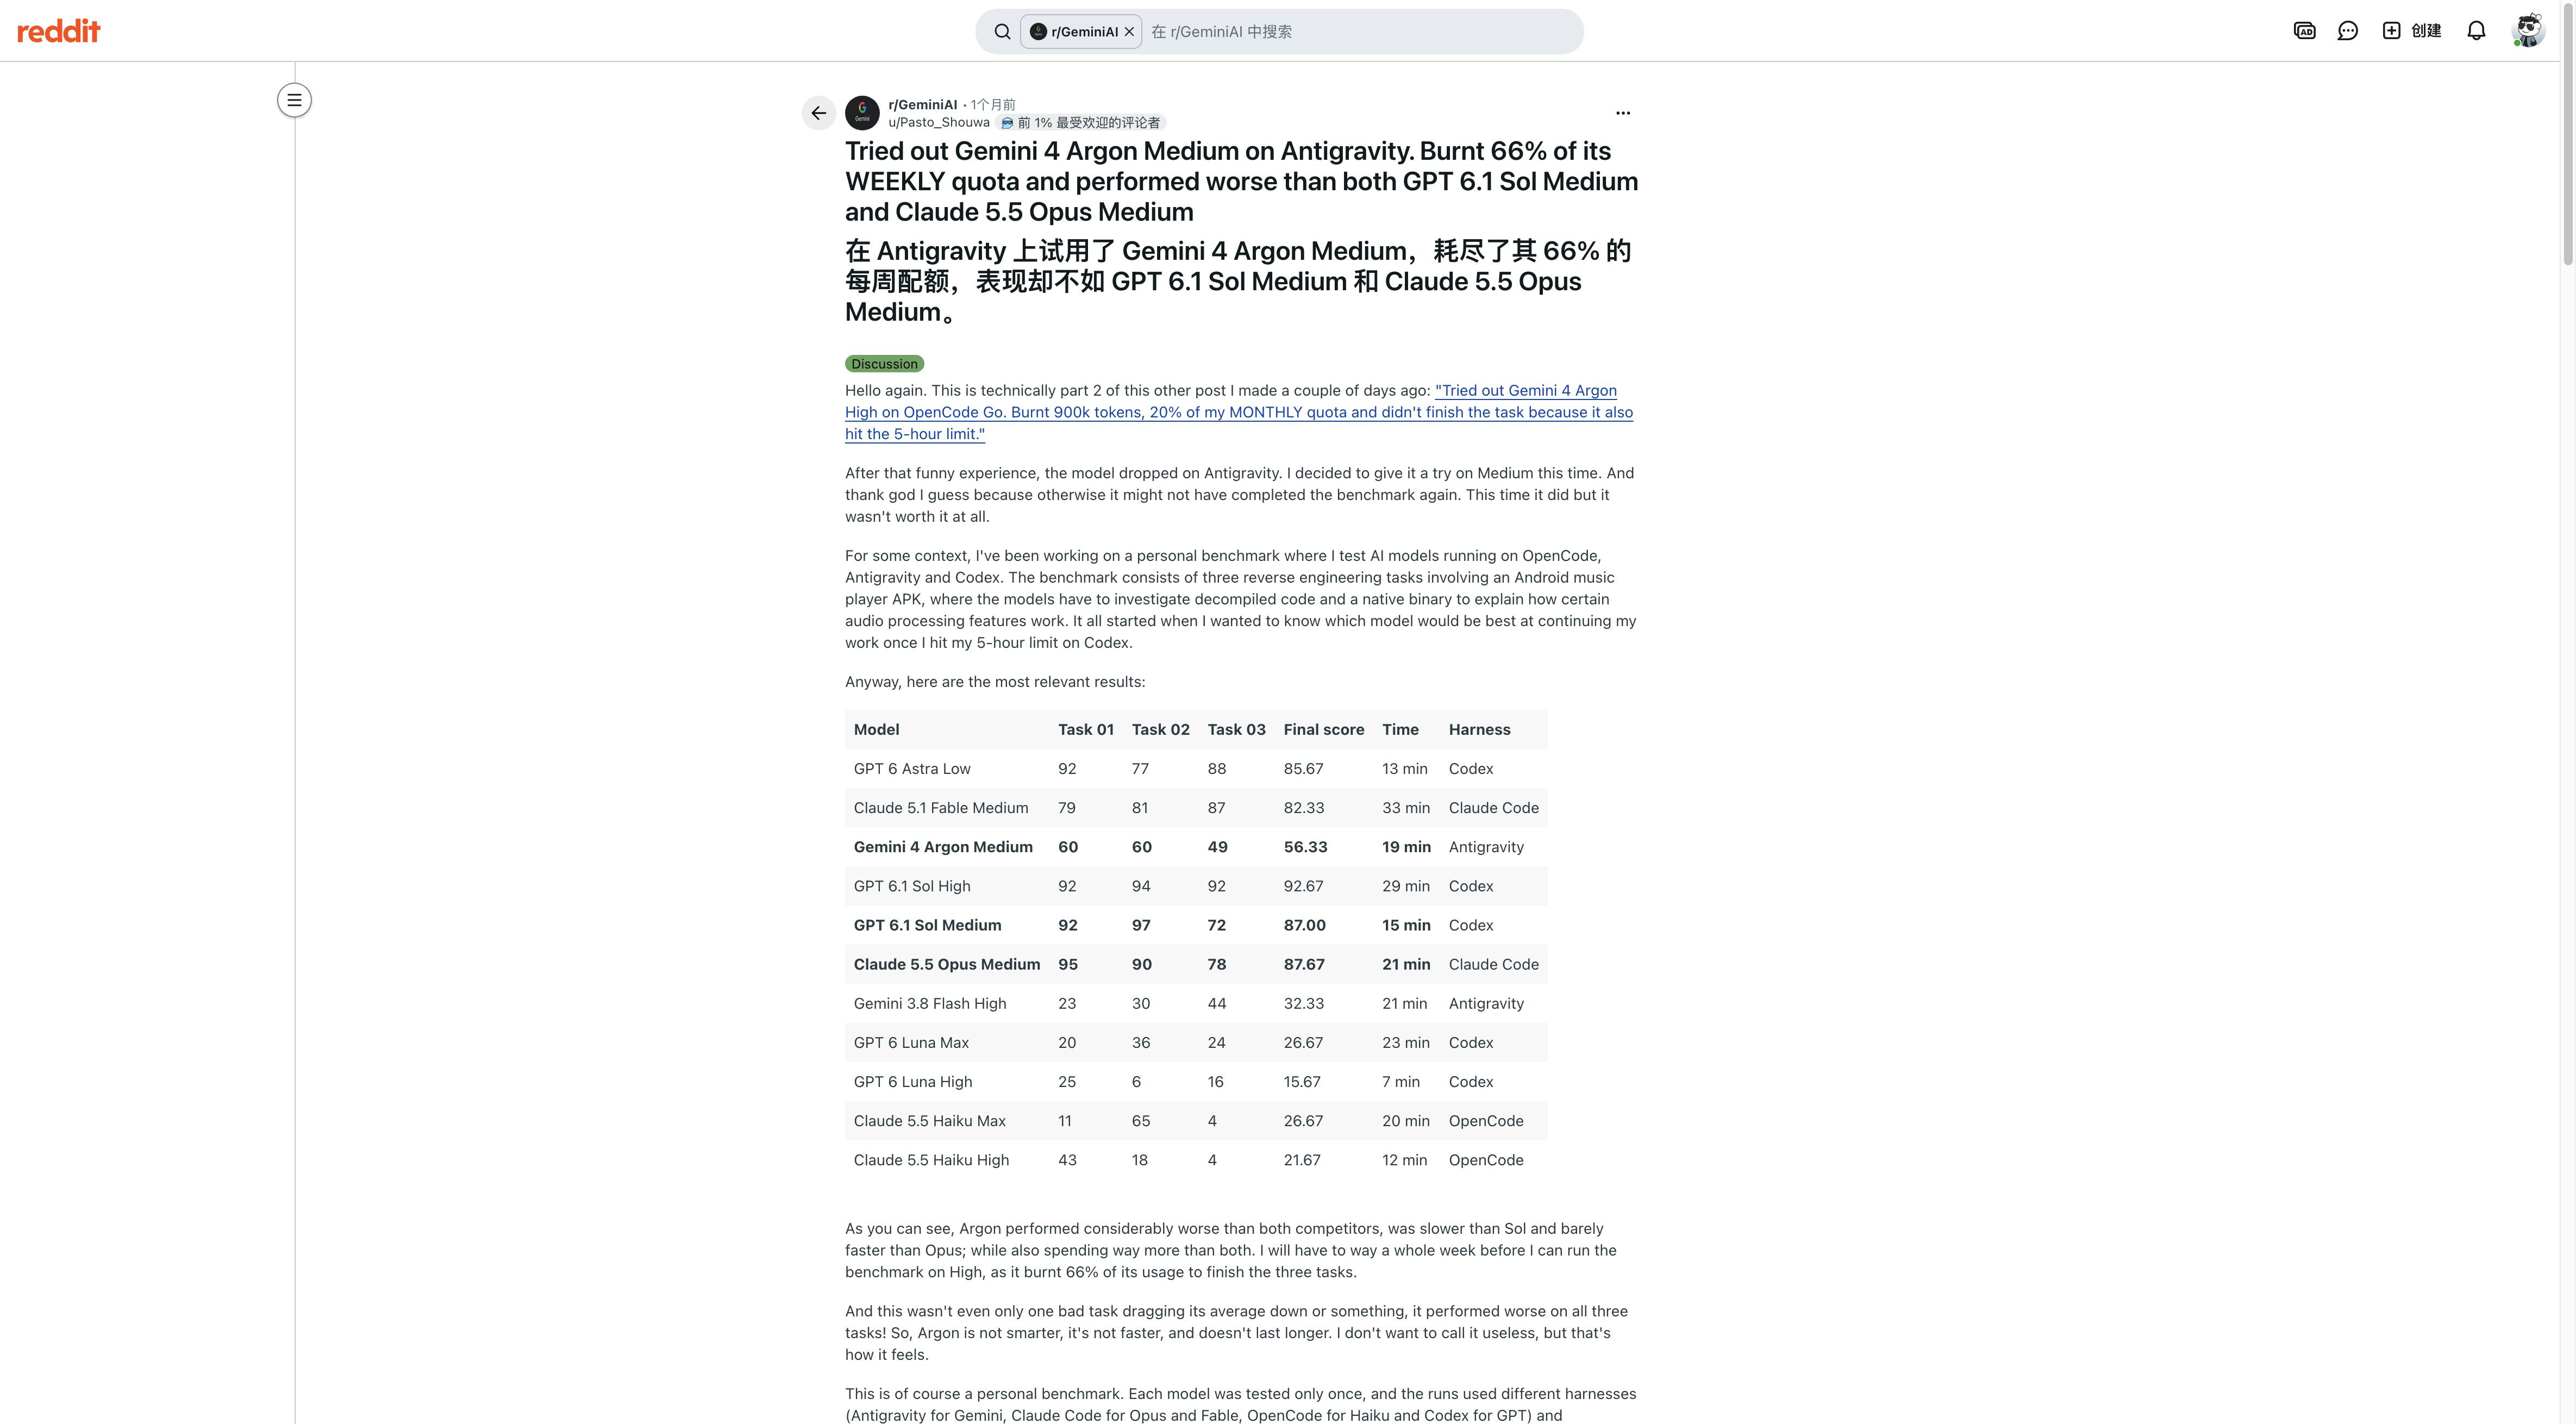
Pasto_Shouwa relata um teste pessoal de três tarefas com ambientes diferentes. Discussão original no Reddit
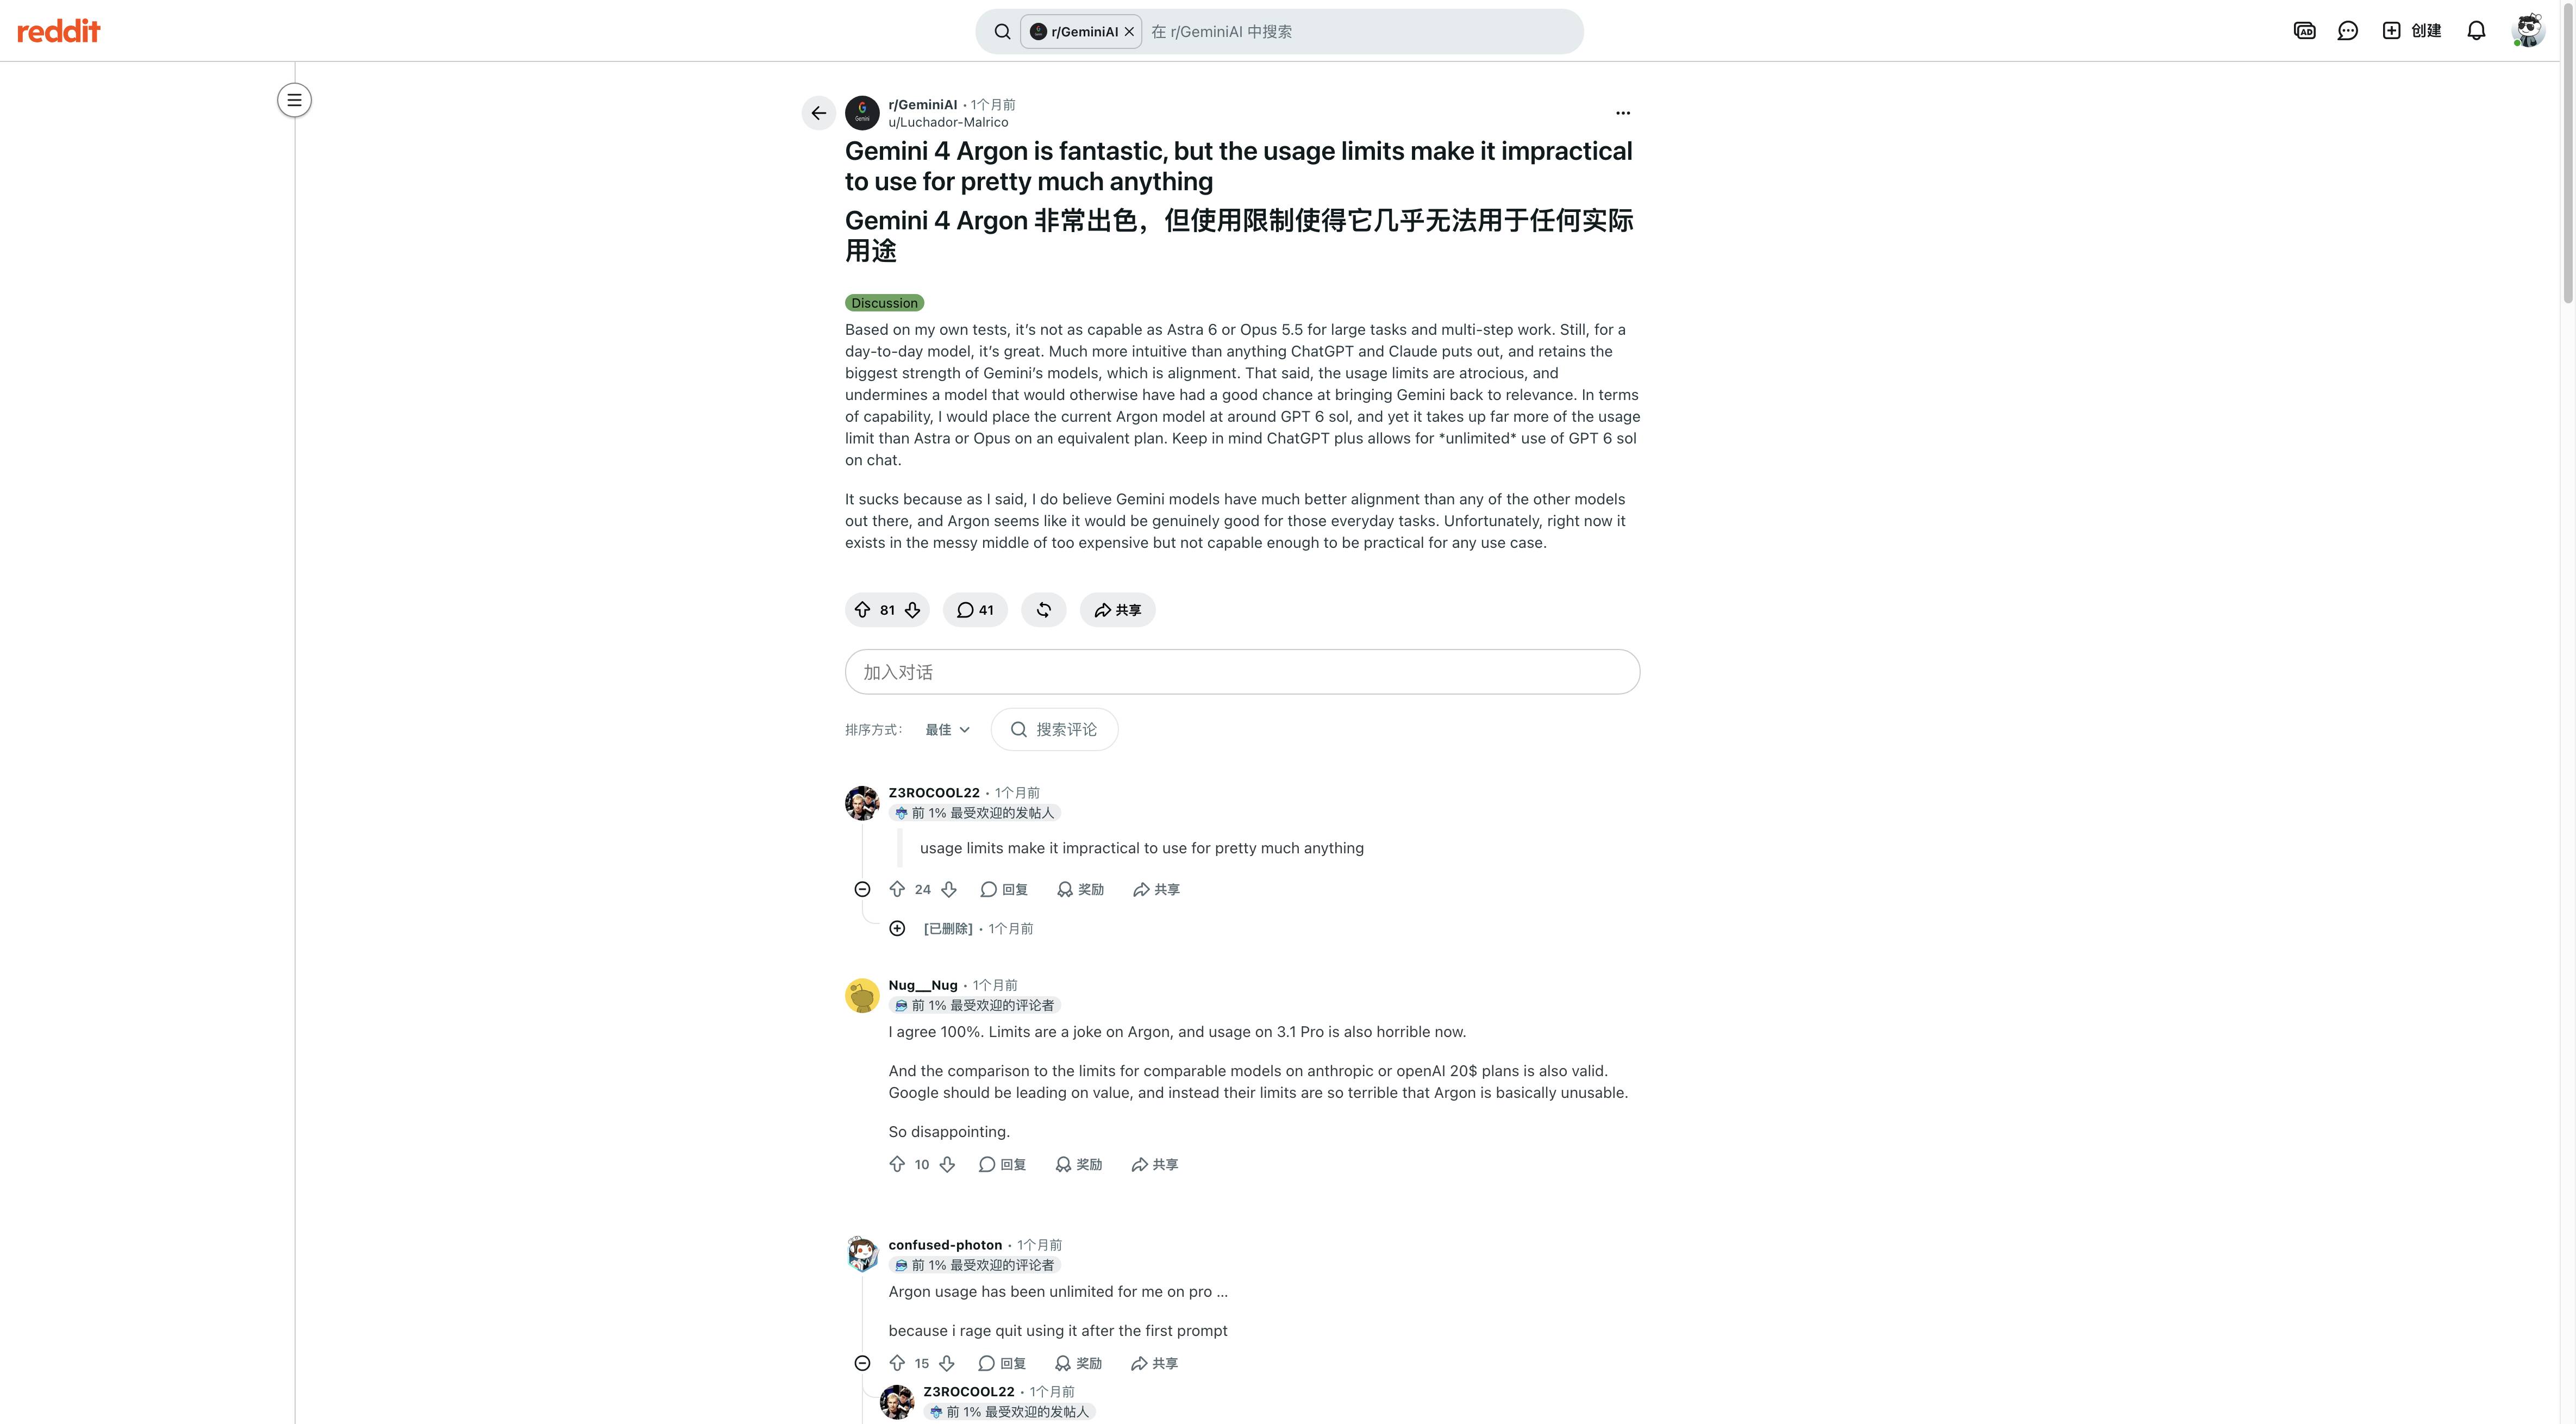
Usuários do Reddit descrevem limites diferentes; relatos pessoais por plano. Discussão original no Reddit
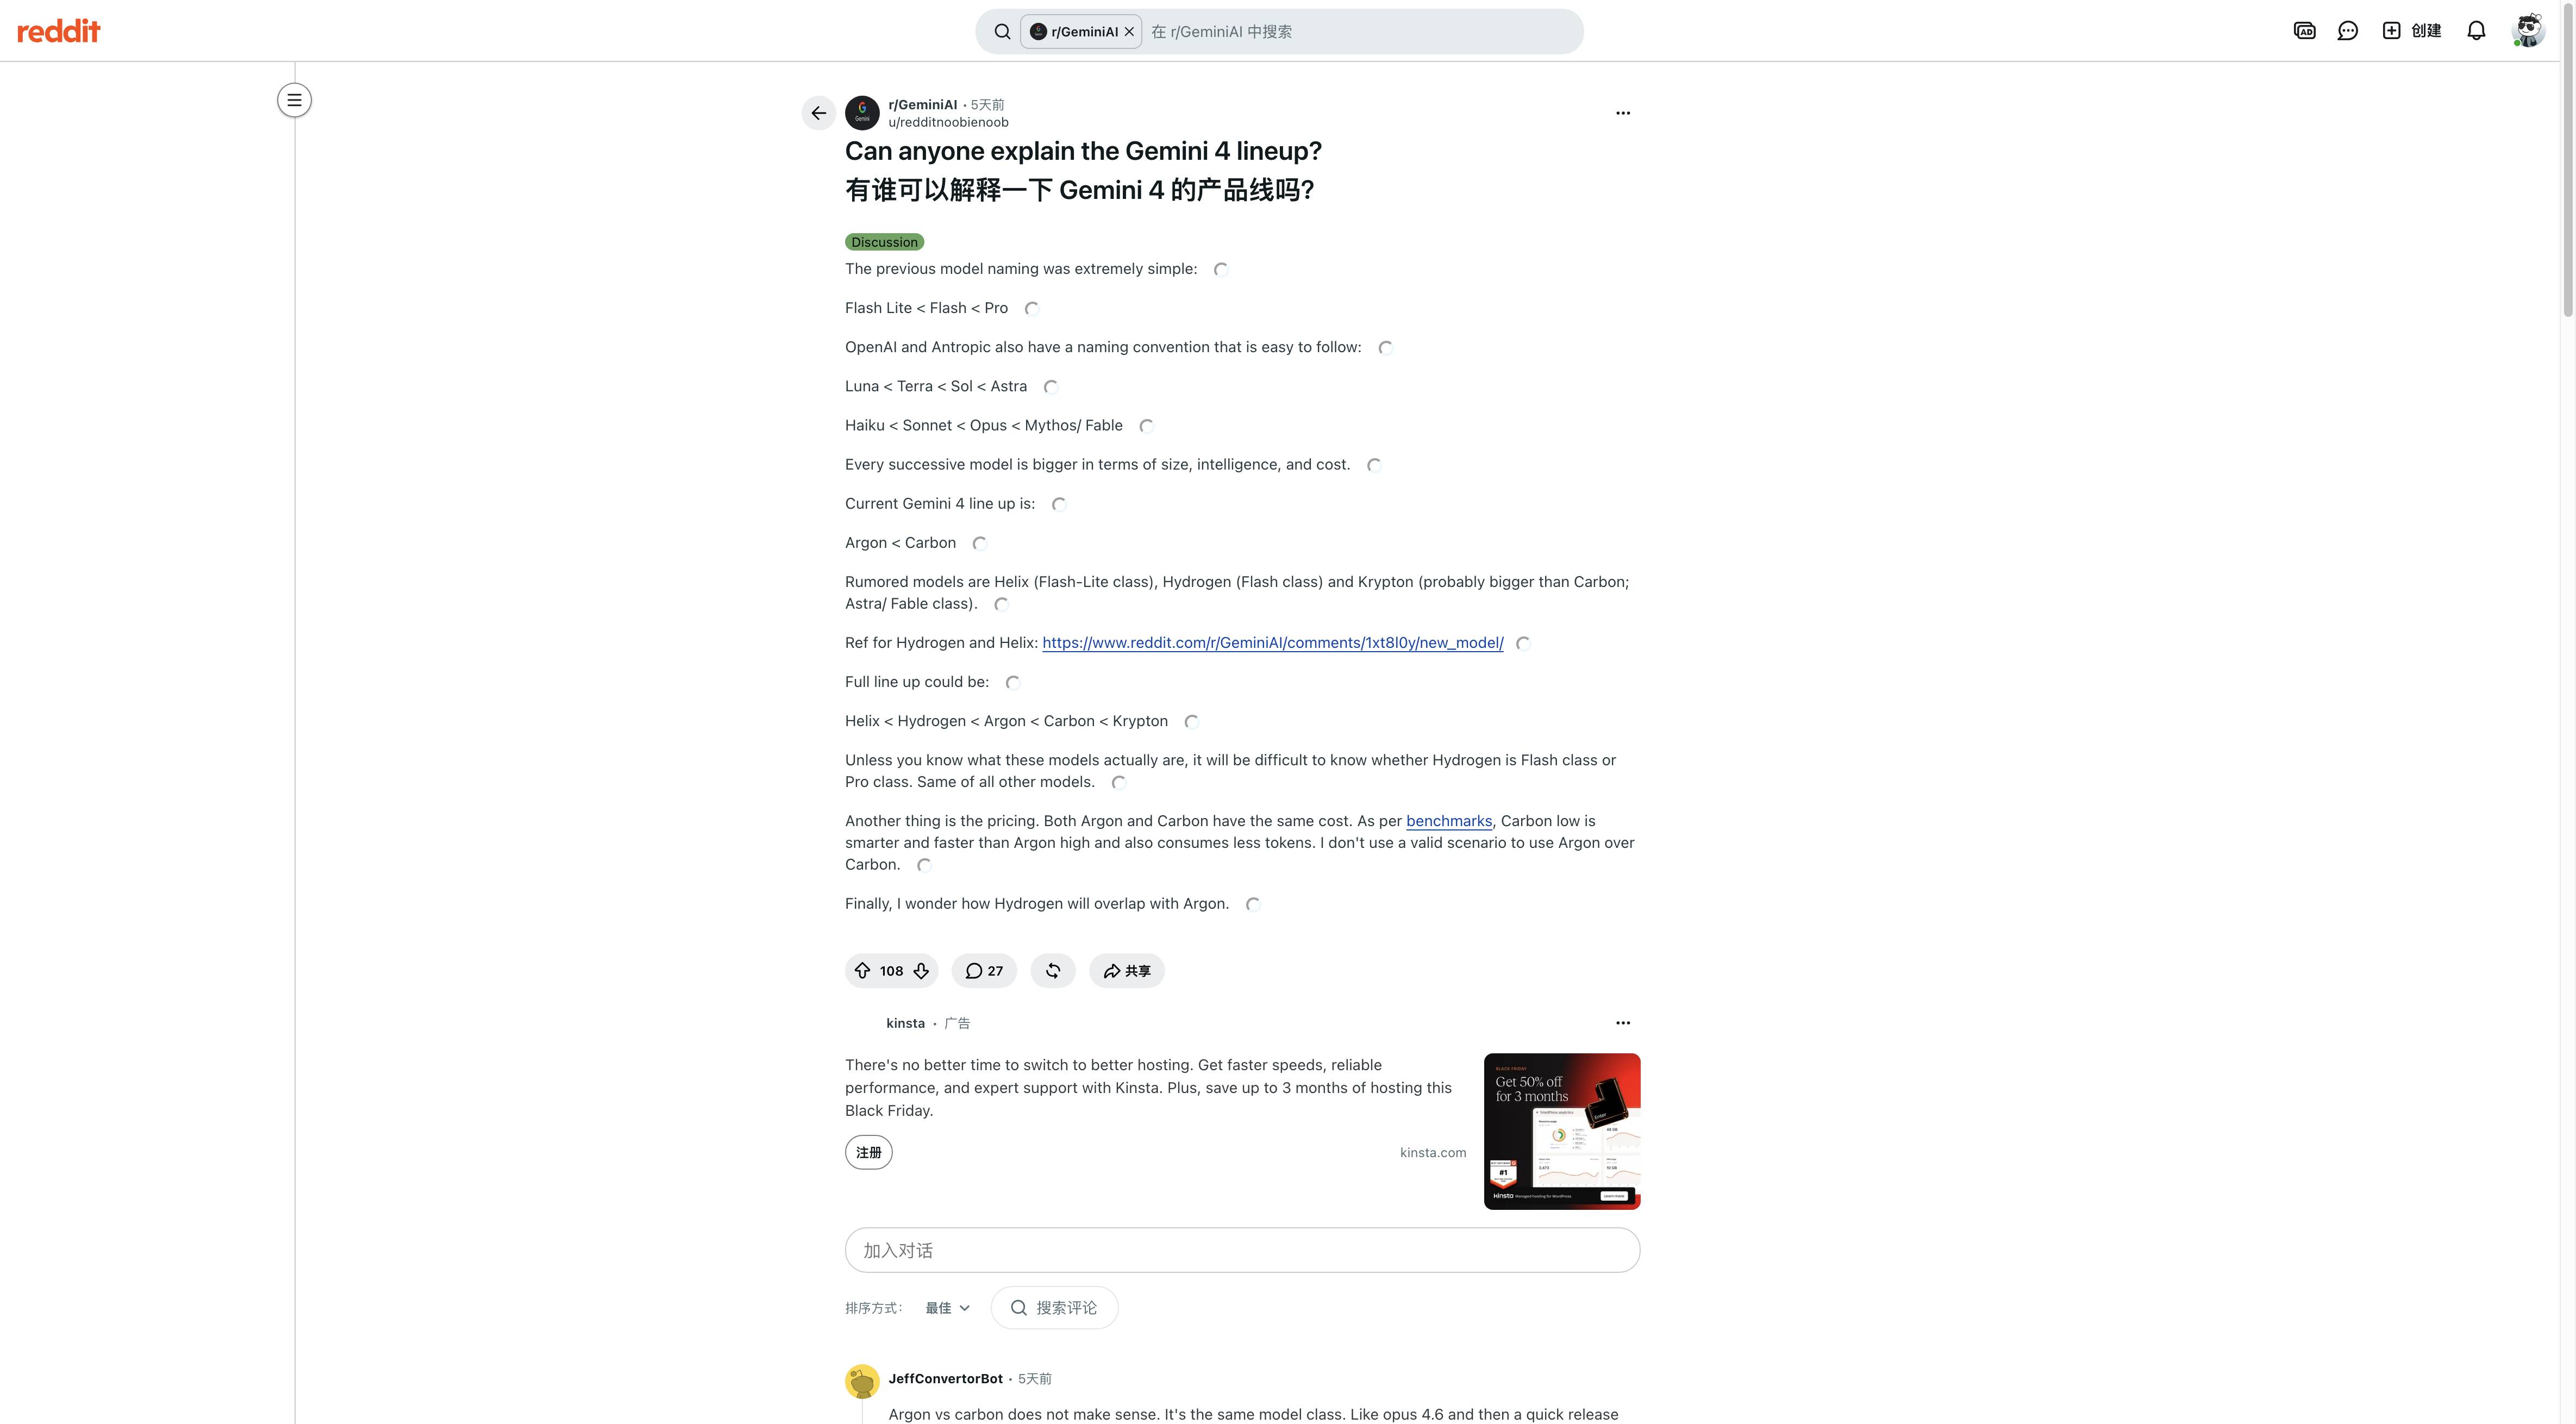
Discussão sobre a linha Gemini e o significado dos nomes Argon e Carbon. Discussão original no Reddit

Perguntas frequentes
Gemini 4 Argon é bom?
É uma opção para tarefas complexas de código e conhecimento que possam ser revisadas. As evidências públicas cobrem tarefas específicas; teste antes de adotá-lo por padrão.
Qual é a janela de contexto do Gemini 4 Argon?
O Google documenta até 1 milhão de tokens combinados de entrada e saída para Gemini API. Cada produto pode ter limites próprios.
Argon sempre supera Gemini 4 Carbon?
Não. Artificial Analysis Index v5.0.1 mostra 50 para Argon High e 60 para Carbon High; custo e latência também variam conforme a configuração.
Por que algumas pessoas dizem que Argon consome muita cota?
Relatos no Reddit variam entre Gemini, Antigravity e API. São experiências pessoais, não limites oficiais.
Como avaliar o Argon para meu trabalho?
Use uma tarefa representativa com o mesmo prompt, ferramentas e critérios de sucesso em cada modelo; registre conclusão, tentativas, tempo e custo em tokens.
Os benchmarks de Argon foram verificados de forma independente?
Existem avaliações independentes, como Artificial Analysis Index v5.0.1. Os casos do Google são relatos do fornecedor e não preveem todos os fluxos.