
Gemini 4 Argon 适合持续编码和知识工作,但现有公开证据不足以支持“全面最强”的结论。Google 公布了它在特定工程任务中的内部收益;独立结果会随推理档位和基准变化。对个人用户来说,关键问题是产出质量能否抵消 API 账单或订阅额度消耗。Google 的案例称,Argon 将 Python Agent Development Kit 长会话中的内存会话准备时间缩短了 40%,冷启动导入时间缩短了 21%。这是本文最清晰的判断依据:它是 Google 针对一个代码库公布的实测结果,不是所有项目都能得到的提升。
要点
Argon 面向复杂编码、研究和多步骤任务;Google API 的模型卡列出 100 万 Token 的输入与输出合并上下文窗口。
Google 的 ADK 案例称,长会话的内存准备时间减少 40%,冷导入时间减少 21%。页面没有给出独立复现结果。
Artificial Analysis 当前 Index v5.0.1 表中,Argon High 得分为 50,Carbon High 为 60。该分数综合九项评测,不代表每种工作流的效果。
Reddit 用户对编码能力、额度消耗和任务收尾有不同体验。这些是个人反馈,不是受控测试。
若任务确实需要更深推理,且你能检查结果,可以试 Argon。不要只看排行榜决定。
Gemini 4 Argon 测评速览
| 证据 | 公开内容 | 不能证明什么 |
|---|---|---|
| Google ADK 工程案例 | 长会话内存准备时间减少 40%,冷导入快 21% | 其他代码库也会获得同样提升 |
| Artificial Analysis Index v5.0.1 | Argon High 为 50;综合九项评测 | 永久排名或跨产品同档对比 |
| Gemini 4 Argon 模型卡 | API 合并输入与输出上下文为 100 万 Token;支持文本与图像输入 | 每个产品都提供相同上下文或额度 |
| Reddit 用户反馈 | 对任务质量、额度和跟进能力意见不一 | 产品规则、模型成功率或严格竞品排名 |
Argon 的公开优势
Google 将 Argon 定位于复杂编码、金融、法律、网络安全与科学任务。10 月发布的工程案例介绍了一次 ADK Python 优化:团队向 Argon 提供项目规则和目标,Argon 夜间执行后,长会话内存准备时间减少 40%,冷导入时间减少 21%。文中链接到具体代码提交,因此比没有出处的能力描述更便于核查。
但这个案例也有边界。它来自 Google 自选的项目,文章没有说明随机对照测试,收益对应特定代码路径。它可以说明 Argon 帮助完成了这项工作,不能保证你的代码库也会快 40%。Argon 模型卡列出预期用途、局限和评测数据,也提醒用户注意幻觉、超时及高推理档位下更高的 Token 消耗。
基准能回答什么
Artificial Analysis 的模型比较页目前显示,Argon High 在 Index v5.0.1 得分为 50,Carbon High 为 60;该指数由九项评测组成。页面定期更新,因此比较时应记录版本和日期。它不是永久排名。即使两个模型输出单价相同,实际任务成本也可能不同,因为输入、缓存、推理和答案 Token 数量不同。
另一位 Reddit 用户公布了一个小规模逆向工程比较,任务分别在 Codex、Claude Code、Antigravity 和 OpenCode 中运行。作者报告 Argon Medium 三项任务的平均分为 56.33,但各模型使用的执行工具不同。这份帖子适合作为评测方法的提醒,不能当作公平的模型对决。工具、提示、套餐和评分不同,结果无法支持普遍排名。
实际取舍
| 工作方式 | Argon 可能适合 | 重新考虑的情况 |
|---|---|---|
| 代码库分析或调试 | 能提供相关文件,也能审阅建议 | 任务必须保证成功或有固定时限 |
| 长篇研究或文档工作 | 多步推理能明显改善交付物 | 轻量模型即可完成快速查询 |
| API 调用 | 能跟踪输入、输出、缓存和思考 Token | 只能依赖固定订阅额度控制预算 |
| Gemini App / Antigravity | 当前账户选择器显示 Argon | 套餐或用量表明难以持续完成任务 |
社区反馈解释了最后一行。在 r/GeminiAI 一帖中,MammothResult8482 说,复杂提示在 Gemini 应用中能完成任务,但消耗不少 Token;他认为 Antigravity 编码时更省 Token。Lost-Willow386 则说,单条提示有时就会消耗过多额度。两位用户使用的界面和工作负载不同,不适合合并成一个能力分数;但这说明 API 价格表无法预测订阅版的实际体验。
结论:先用自己的任务验证
如果你的编码、分析或研究任务确实复杂,而且有审阅步骤和明确停止条件,Argon 值得小范围试用。简单问题、无人审查的高风险工作,或受消费端额度限制的流程,未必适合。先选一个有代表性的任务,保存提示和结果,核对源文件,再查看用量。不要从一次好或坏的运行推导普遍成功率。
如需把编码研究与浏览器任务结合,可参考 Gemini 4 Carbon 浏览器指南和 Gemini CLI 浏览器 MCP 指南,它们介绍的是独立工作流。
在原帖中,MammothResult8482 说 Gemini App “consumes a lot of tokens”(消耗不少 Token);Lost-Willow386 则说单条提示可能占用 “way too much quota for a single prompt”(过多额度)。这是两位用户的体验,不是额度测量。
延伸阅读
Reddit 原帖截图
以下为浏览器打开的原始讨论截图。帖子反映个人体验,不代表产品承诺。
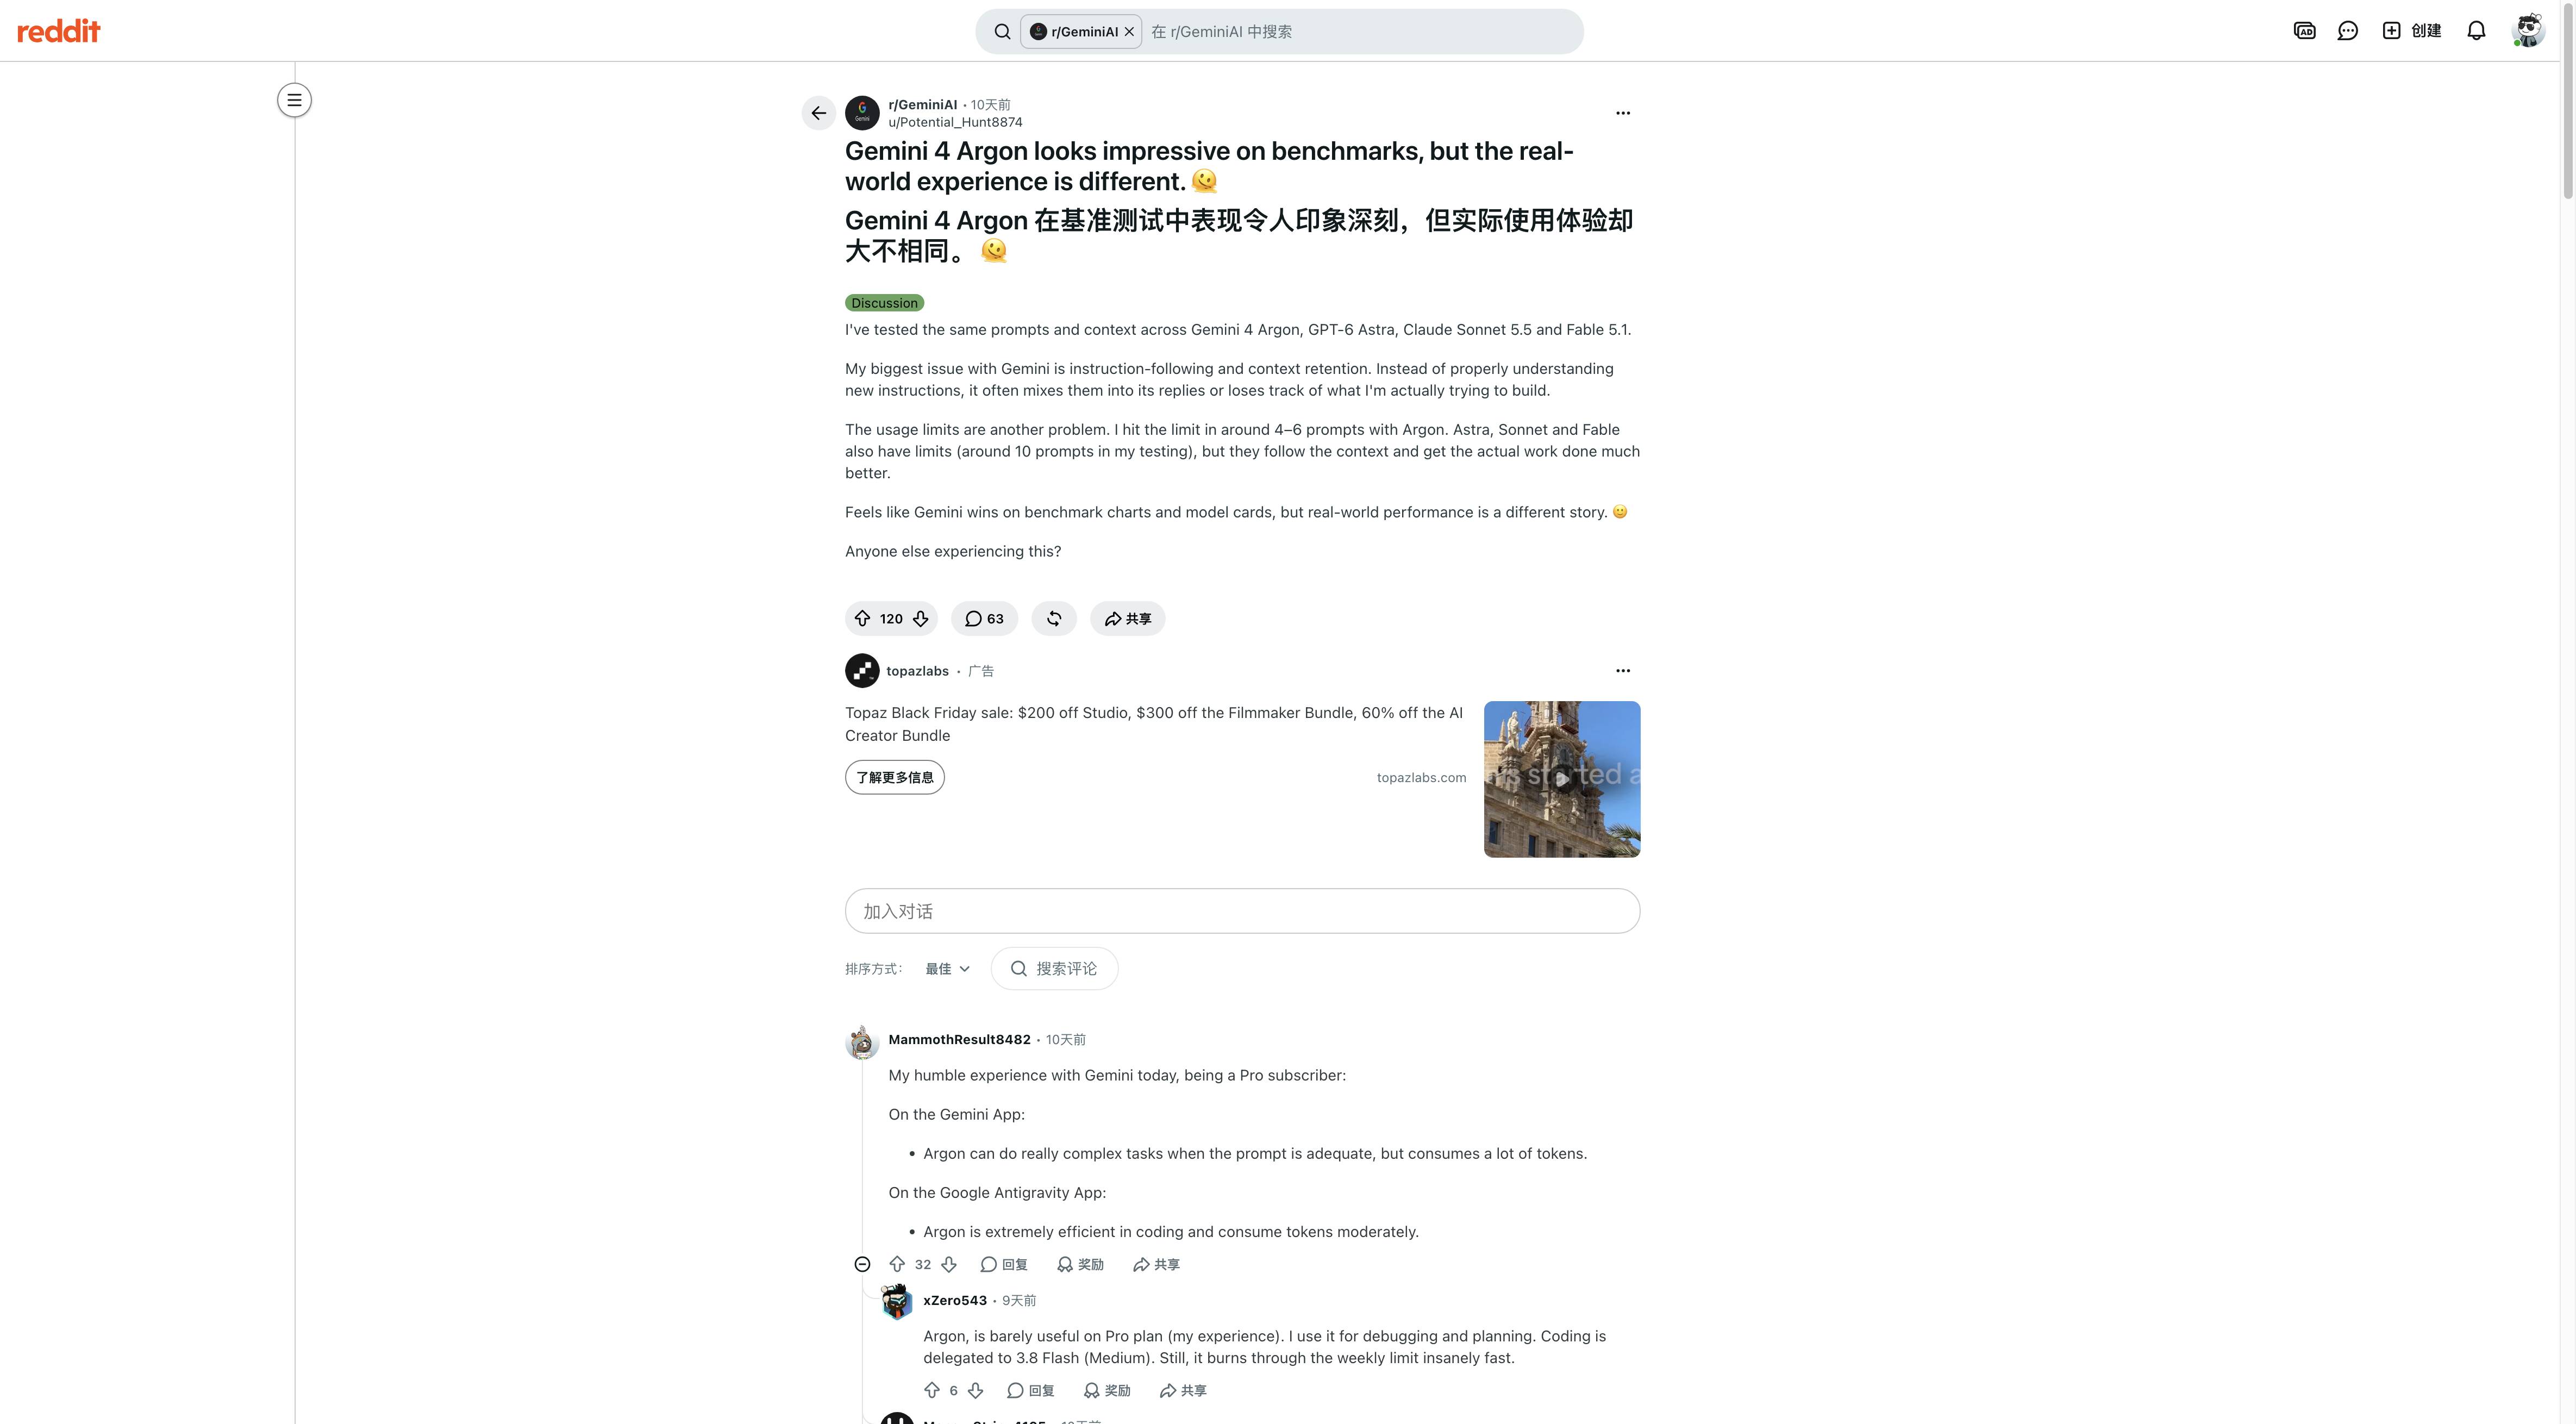
MammothResult8482 对比 Gemini App 与 Antigravity 的用量体验;采集时页面显示约 10 天前发布。 Reddit 原帖
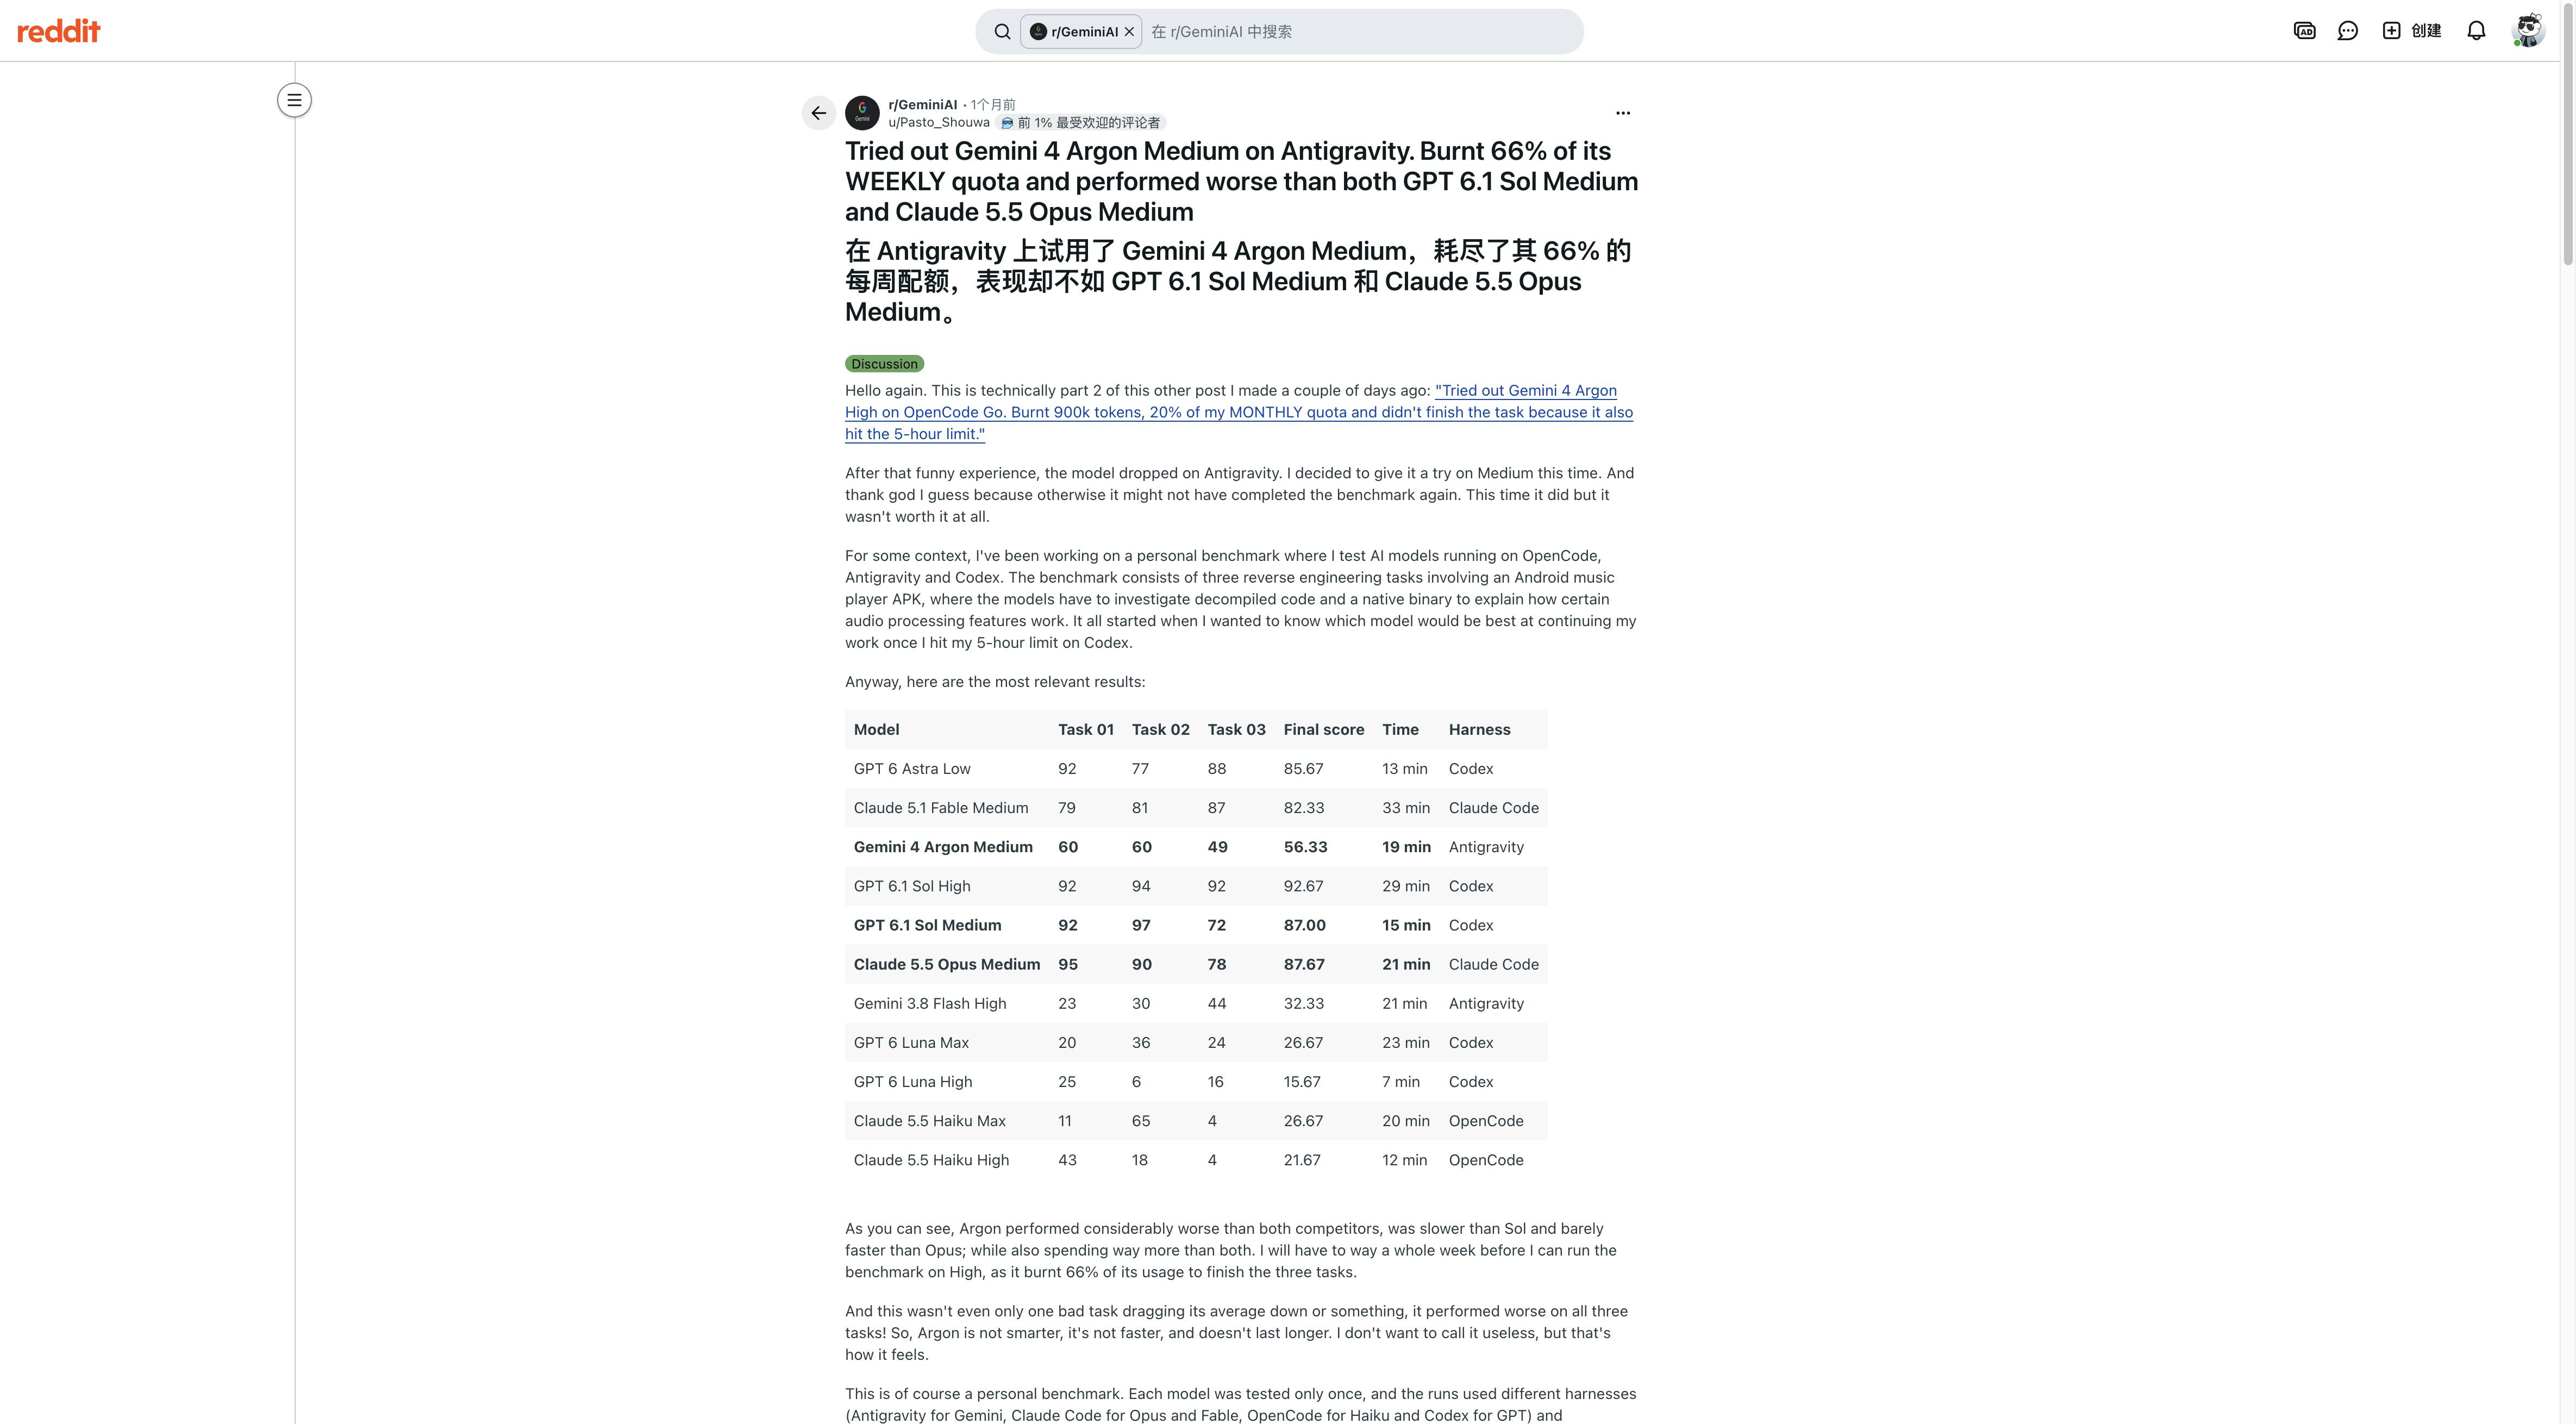
Pasto_Shouwa 分享三项个人基准任务,并说明各模型使用了不同工具链。 Reddit 原帖
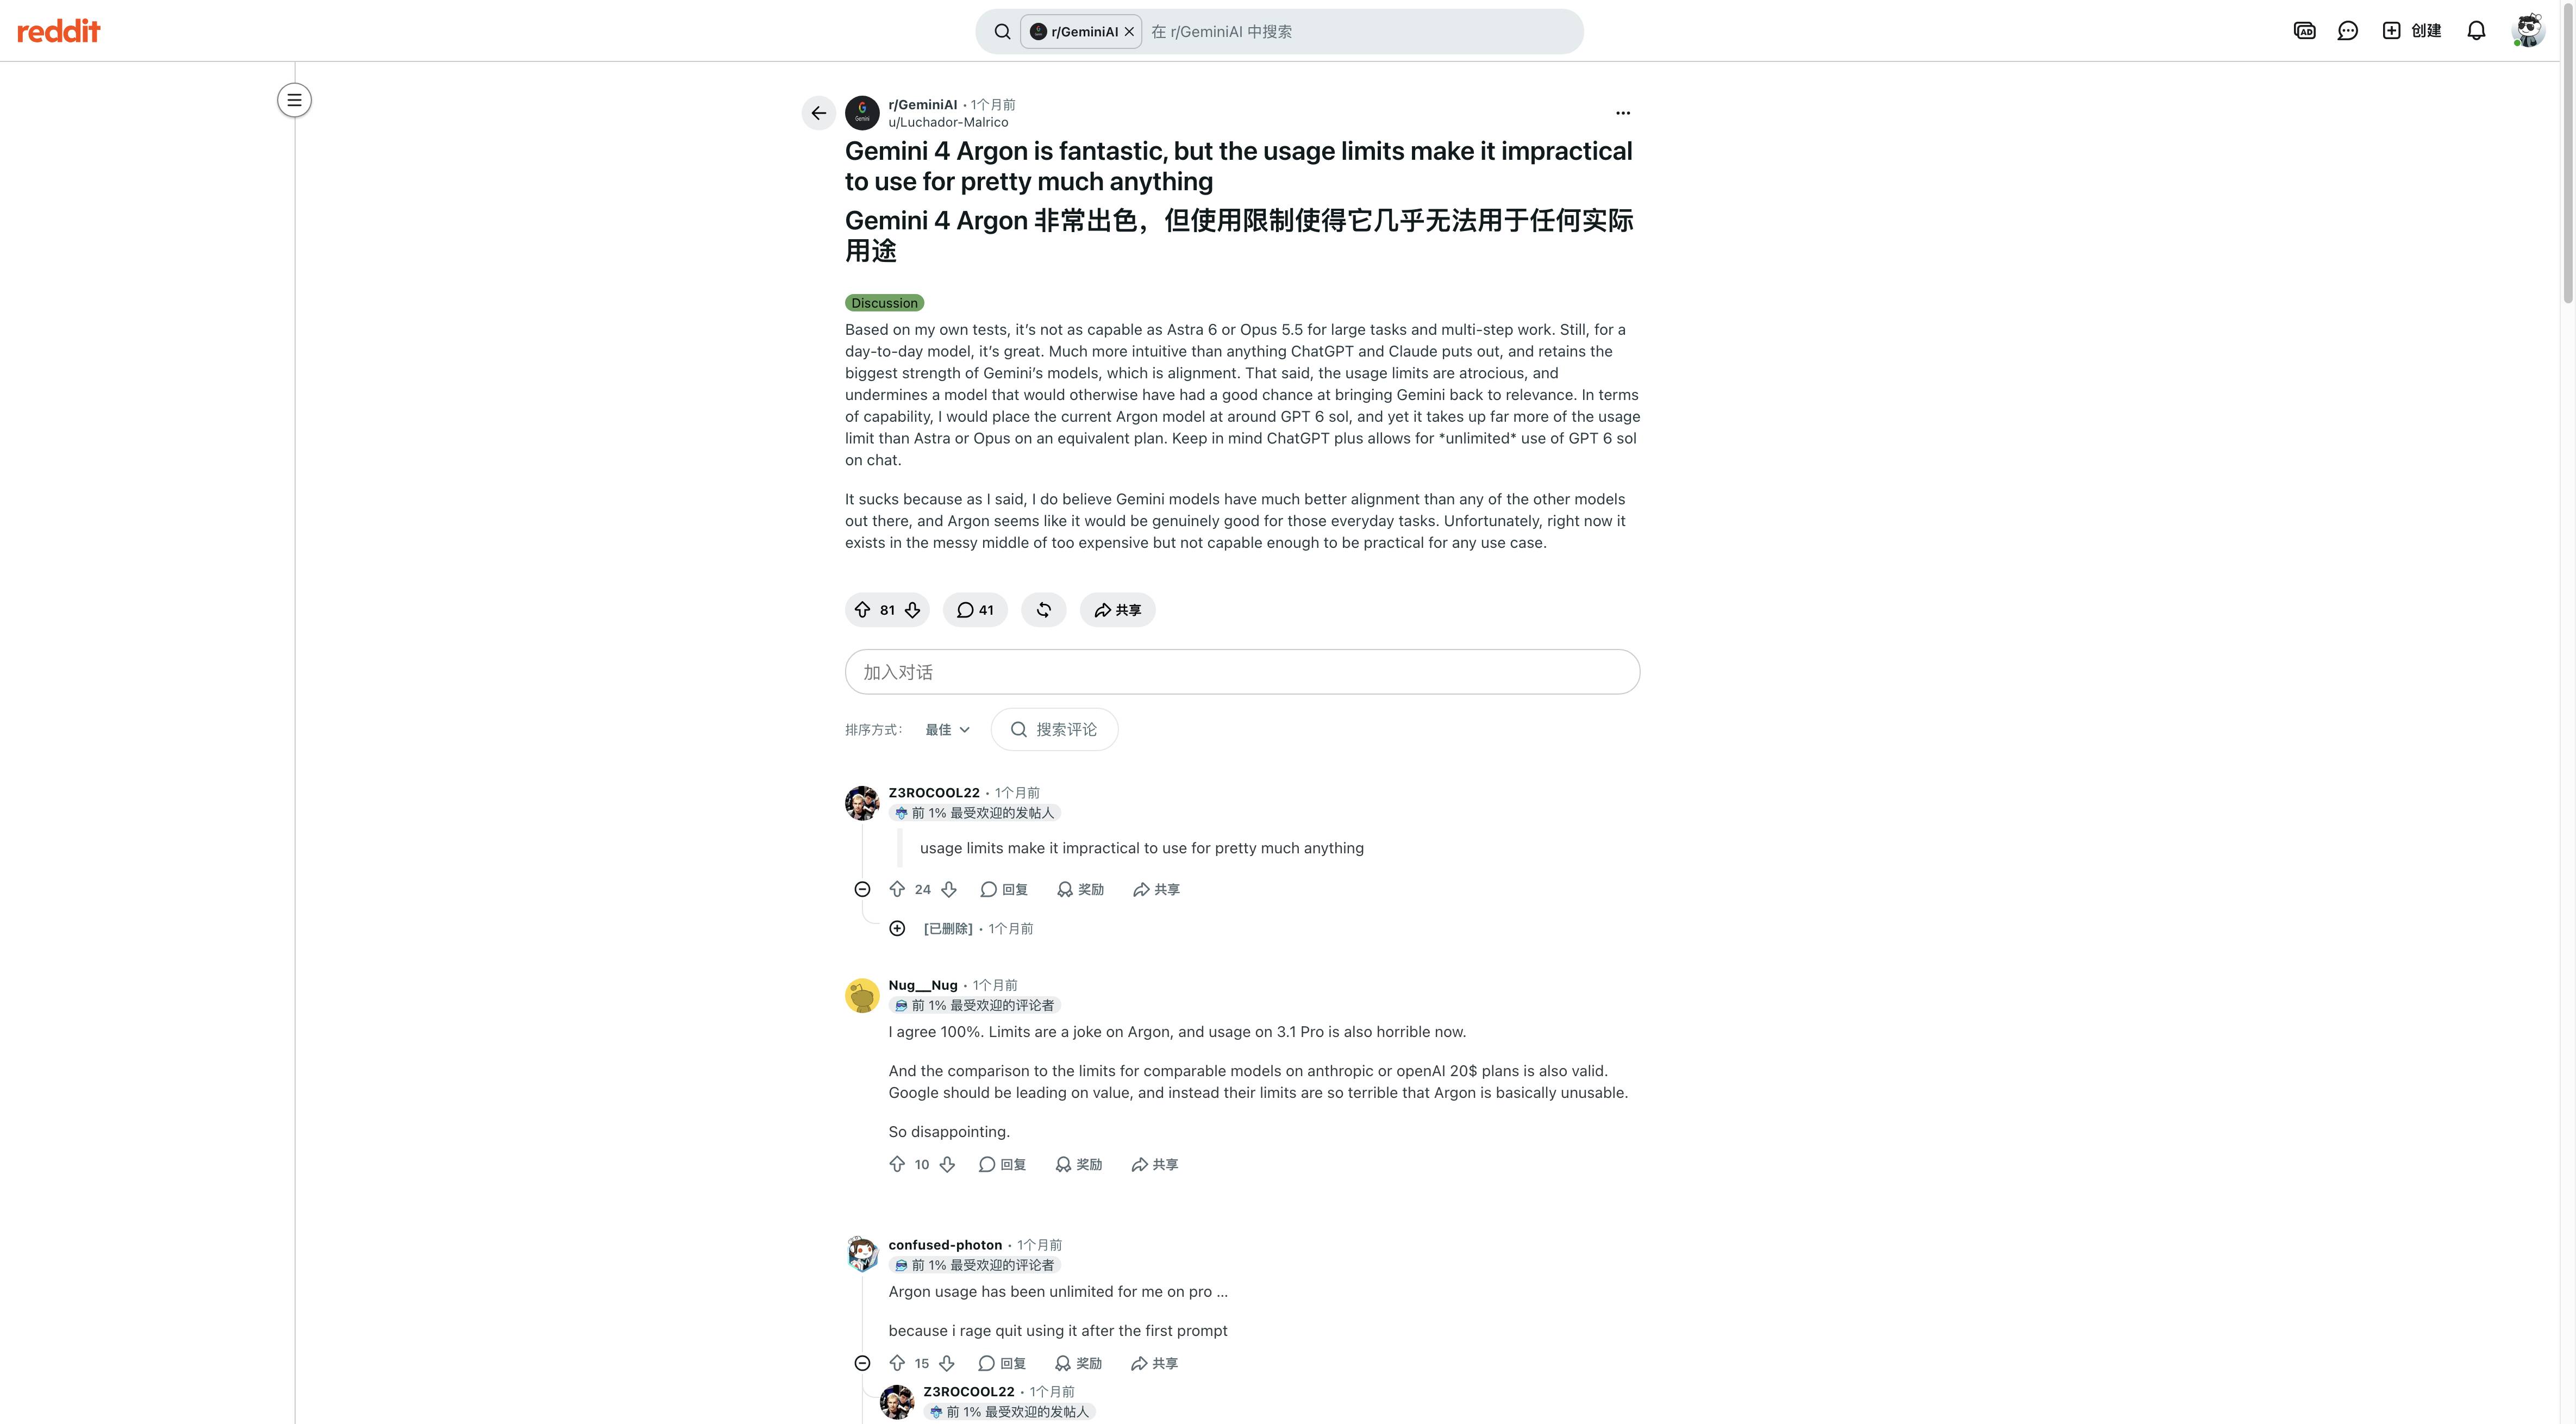
Reddit 订阅用户讨论 Argon 用量限制;属于个人体验,且受套餐影响。 Reddit 原帖
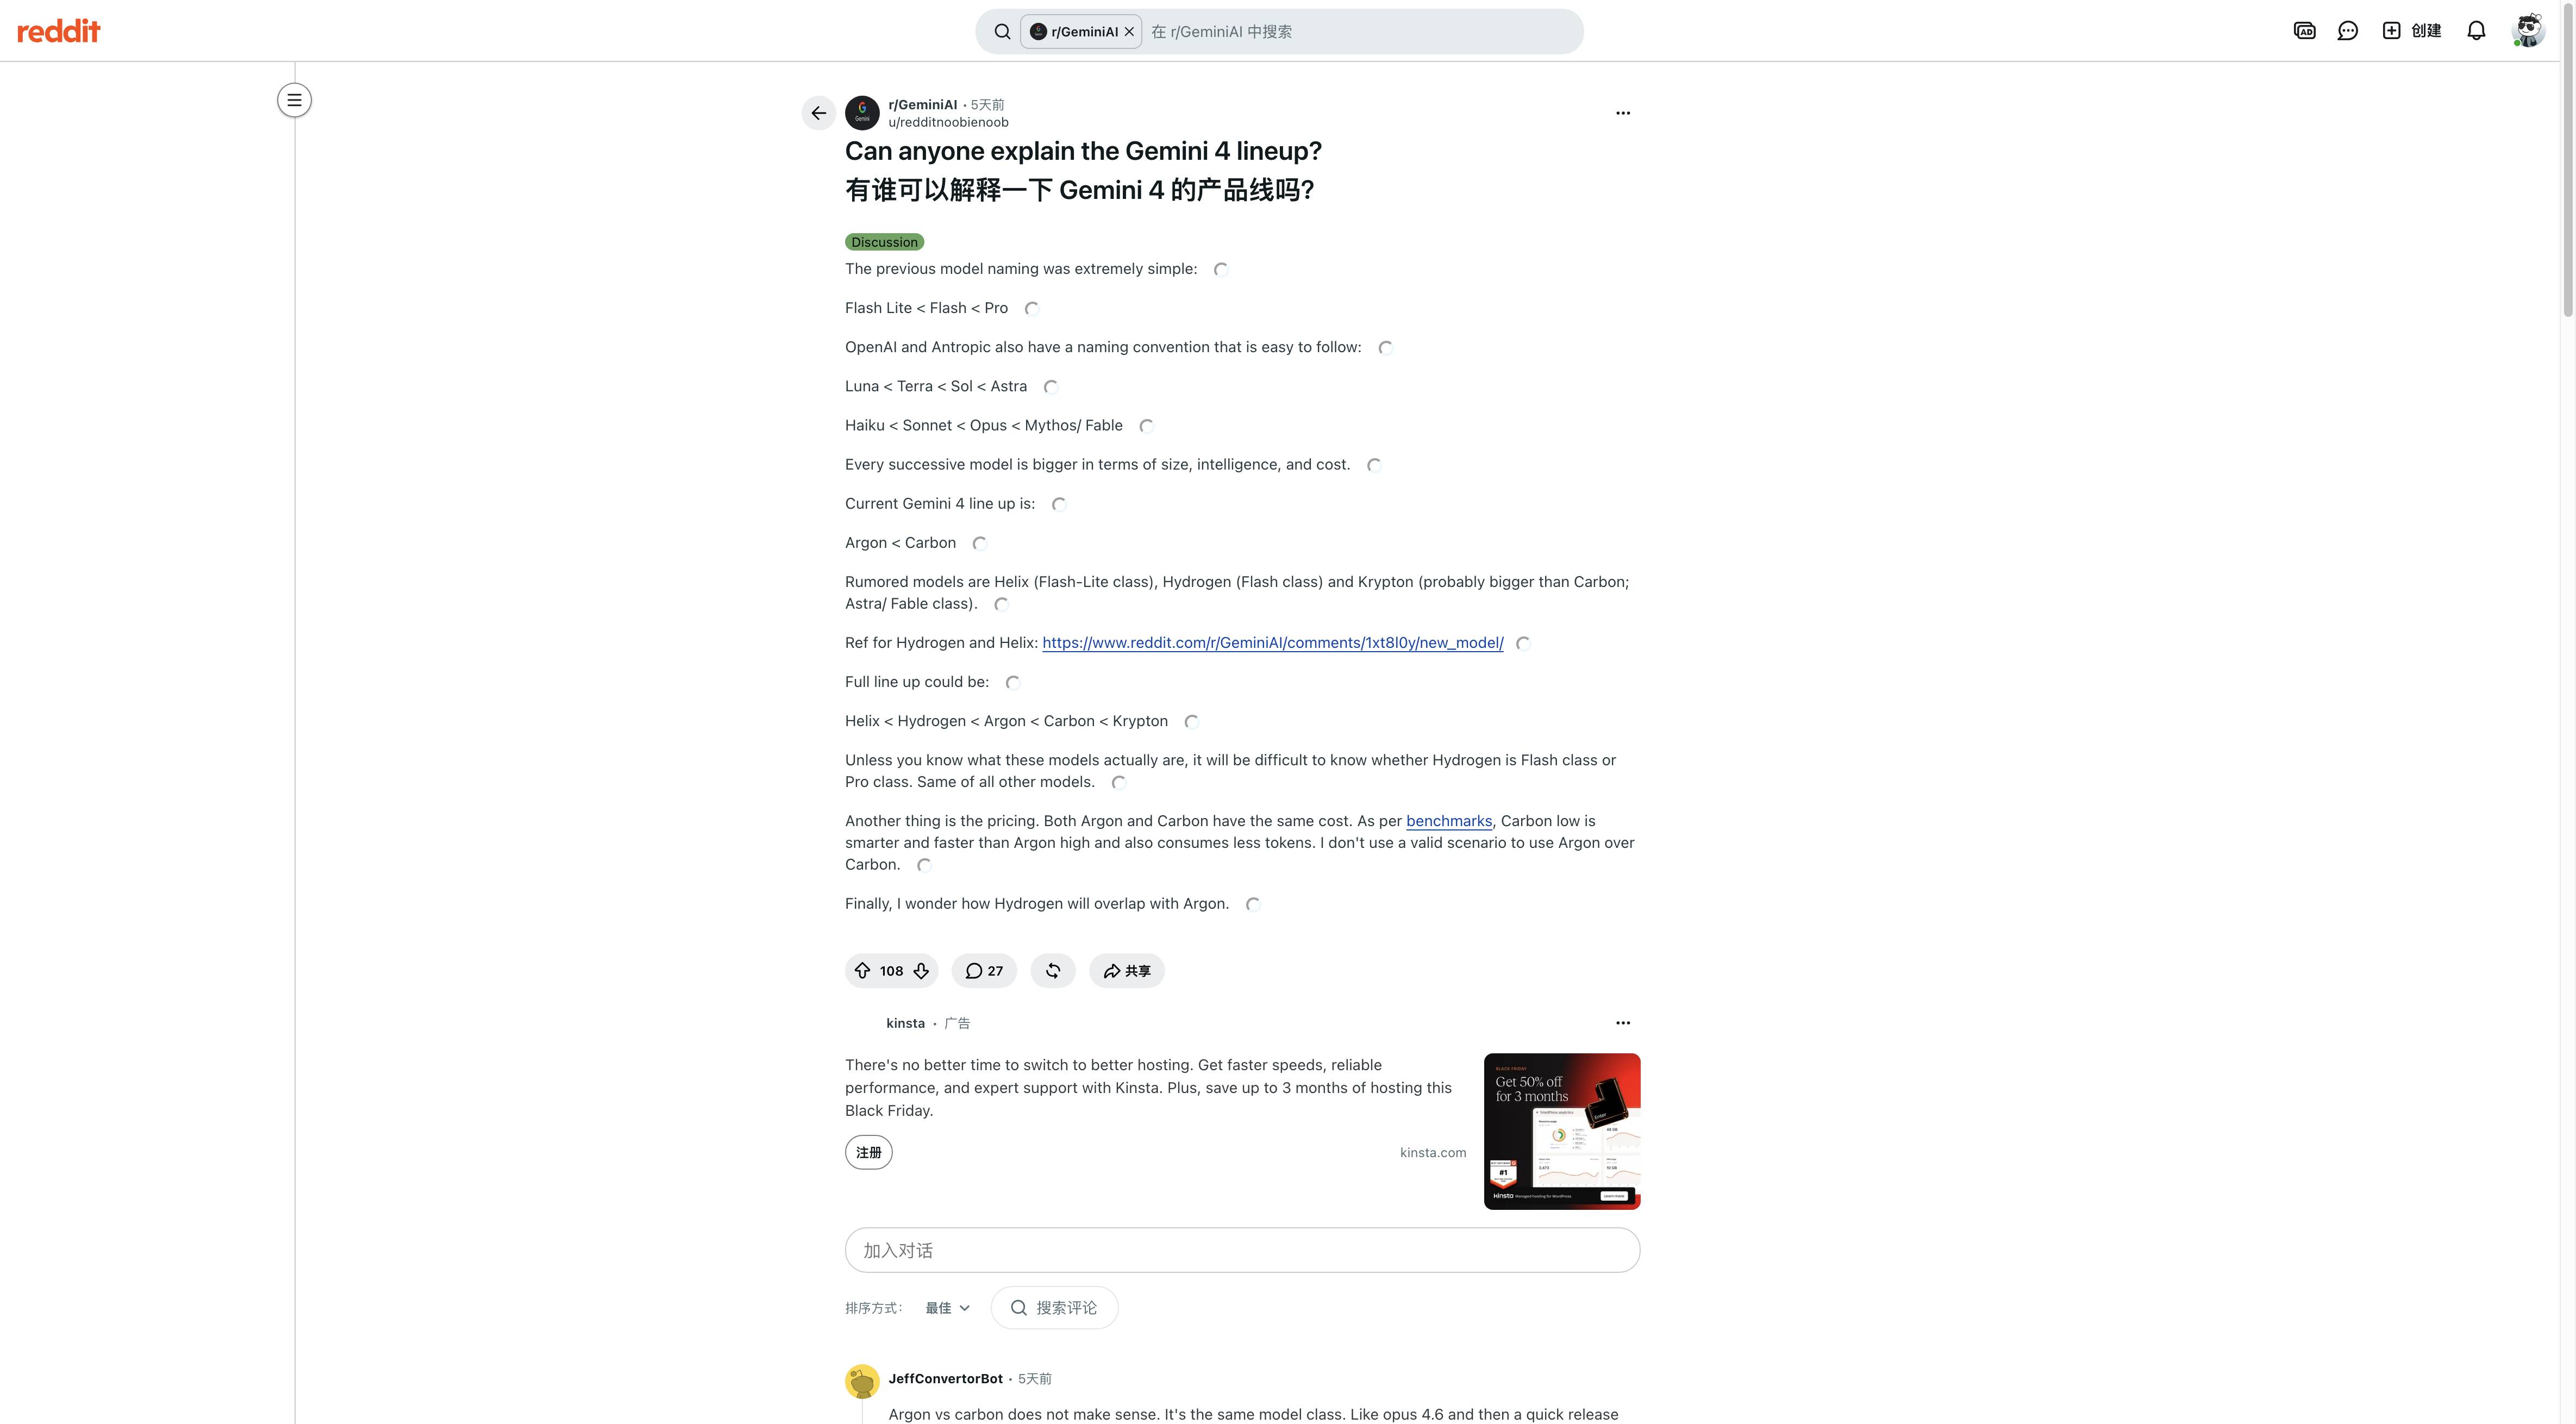
Gemini 产品线讨论中,用户询问 Argon 与 Carbon 名称代表什么。 Reddit 原帖

常见问题
Gemini 4 Argon 好用吗?
它适合复杂、可审查的编码与知识任务。公开证据只覆盖具体工作负载,设为默认模型前应先用自己的任务测试。
Gemini 4 Argon 的上下文窗口有多大?
Google 为 Gemini API 列出的输入与输出合并窗口最高为 100 万 Token。不同产品界面可能另有限制。
Argon 一定比 Gemini 4 Carbon 强吗?
不是。Artificial Analysis Index v5.0.1 当前显示 Argon High 为 50、Carbon High 为 60;任务成本和延迟也会随设置变化。
为什么有人说 Argon 很耗额度?
Reddit 用户在 Gemini App、Antigravity 和 API 工作流中的体验不同。这些是个人反馈,不是官方套餐规则。
如何判断 Argon 是否适合我的工作?
选一个有代表性的任务,在各模型中保持提示词、工具和成功标准一致,并记录完成情况、重试、耗时与 Token 费用。
Gemini 4 Argon 的基准结论有独立验证吗?
存在 Artificial Analysis Index v5.0.1 等独立评测。Google 的工程案例属于厂商报告,两类来源都不能预测每个人的工作流表现。