
Gemini 4 Argon 適合持續編碼與知識工作,但目前公開證據不足以支持「全面最強」的結論。Google 公布了它在特定工程任務中的內部成效;獨立結果會隨推理等級與基準不同而變化。對個人使用者而言,實際問題是產出品質能否抵銷 API 費用或訂閱用量。Google 的案例表示,Argon 將 Python Agent Development Kit 長工作階段的記憶體準備時間縮短 40%,冷啟動匯入時間縮短 21%。這是本文最明確的判斷依據:Google 針對一個程式碼庫公布的結果,不是所有專案都能得到的提升。
重點
Argon 面向複雜編碼、研究與多步驟任務;Google API 模型卡列出 100 萬 Token 的輸入與輸出合併上下文視窗。
Google 的 ADK 案例表示,長工作階段記憶體準備時間減少 40%,冷匯入時間減少 21%。該頁未提供獨立重現結果。
Artificial Analysis 目前的 Index v5.0.1 顯示 Argon High 為 50、Carbon High 為 60。此分數整合九項評測,不代表每種工作流程的成效。
Reddit 使用者對編碼、額度消耗與任務收尾有不同經驗。這些是個人回饋,不是控制測試。
若任務確實需要深入推理且你能檢查結果,可以試用 Argon。不要只依排行榜選擇。
Gemini 4 Argon 評測速覽
| 證據 | 公開資訊 | 無法證明的事 |
|---|---|---|
| Google ADK 工程案例 | 長工作階段記憶體準備時間減少 40%,冷匯入快 21% | 其他程式碼庫也能得到同樣提升 |
| Artificial Analysis Index v5.0.1 | Argon High 為 50;整合九項評測 | 永久排名或跨產品的同級比較 |
| Gemini 4 Argon 模型卡 | API 合併輸入與輸出上下文為 100 萬 Token;支援文字與圖像輸入 | 每個產品都提供相同上下文或額度 |
| Reddit 使用者回饋 | 對任務品質、額度與後續處理看法不一 | 產品規則、模型成功率或嚴格競品排名 |
Argon 的公開優勢
Google 將 Argon 定位於複雜編碼、金融、法律、網路安全與科學工作。10 月的工程案例介紹一次 ADK Python 效能最佳化:團隊提供專案規則與目標,Argon 夜間執行後,長工作階段的記憶體準備時間減少 40%,冷匯入時間減少 21%。文章連結至程式碼提交,較容易核對。
此案例也有邊界。它來自 Google 選定的專案,文章未說明隨機對照測試;效益對應特定程式碼路徑。它只能說明 Argon 協助完成這項工作,不能保證你的程式碼也快 40%。Argon 模型卡列出用途、限制與評測結果,也提醒幻覺、逾時及高推理等級下較高的 Token 用量。
基準能回答什麼
Artificial Analysis 的比較頁目前顯示,Argon High 在 Index v5.0.1 得分 50,Carbon High 得分 60;此指數整合九項評測。頁面會定期更新,比較時應記錄版本與日期。這不是永久排名。即使兩個模型輸出單價相同,任務總成本仍可能因輸入、快取、推理與答案 Token 數不同而有差異。
另一位 Reddit 使用者公開一項小型逆向工程比較,分別使用 Codex、Claude Code、Antigravity 與 OpenCode。作者表示 Argon Medium 三項任務平均為 56.33 分,但各模型使用的工具不同。這篇討論適合提醒評測條件的重要性,不是公平的模型對決。工具、提示、方案與評分不一致,不能支持普遍排名。
實際取捨
| 工作型態 | Argon 可能合適 | 可以重新考慮的情況 |
|---|---|---|
| 程式碼庫分析或除錯 | 能提供相關檔案並檢查建議 | 任務必須保證成功或有固定時限 |
| 長篇研究或文件工作 | 多步推理能改善交付成果 | 輕量模型即可完成快速查詢 |
| API 呼叫 | 能追蹤輸入、輸出、快取與思考 Token | 只能依靠固定訂閱額度控制預算 |
| Gemini App / Antigravity | 帳戶的目前選單顯示 Argon | 方案或用量顯示難以持續完成任務 |
社群回饋說明了最後一點。在 r/GeminiAI 一則討論中,MammothResult8482 表示,複雜提示在 Gemini App 能完成任務,但會使用不少 Token;他認為 Antigravity 編碼時較省 Token。Lost-Willow386 則說,單一提示有時便消耗過多額度。兩者的介面與工作型態不同,不適合合併為一個能力分數;但它們提醒我們,API 價格表無法預測訂閱版的實際體驗。
結論:先用自己的任務驗證
若編碼、分析或研究任務確實複雜,且有審查流程與明確停止條件,Argon 值得小規模試用。簡單問題、沒有審查的高風險工作,或受消費版額度限制的流程,未必適合。先選一個具代表性的任務,保存提示與結果、對照來源檔案,再查看用量。不要從單次成功或失敗推論整體成功率。
若要將編碼研究與瀏覽器任務結合,可參考 Gemini 4 Carbon 瀏覽器指南與 Gemini CLI 瀏覽器 MCP 指南,兩者介紹的是不同工作流程。
延伸閱讀
Reddit 原文截圖
以下為瀏覽器開啟的原始討論截圖。貼文反映個人經驗,不代表產品承諾。
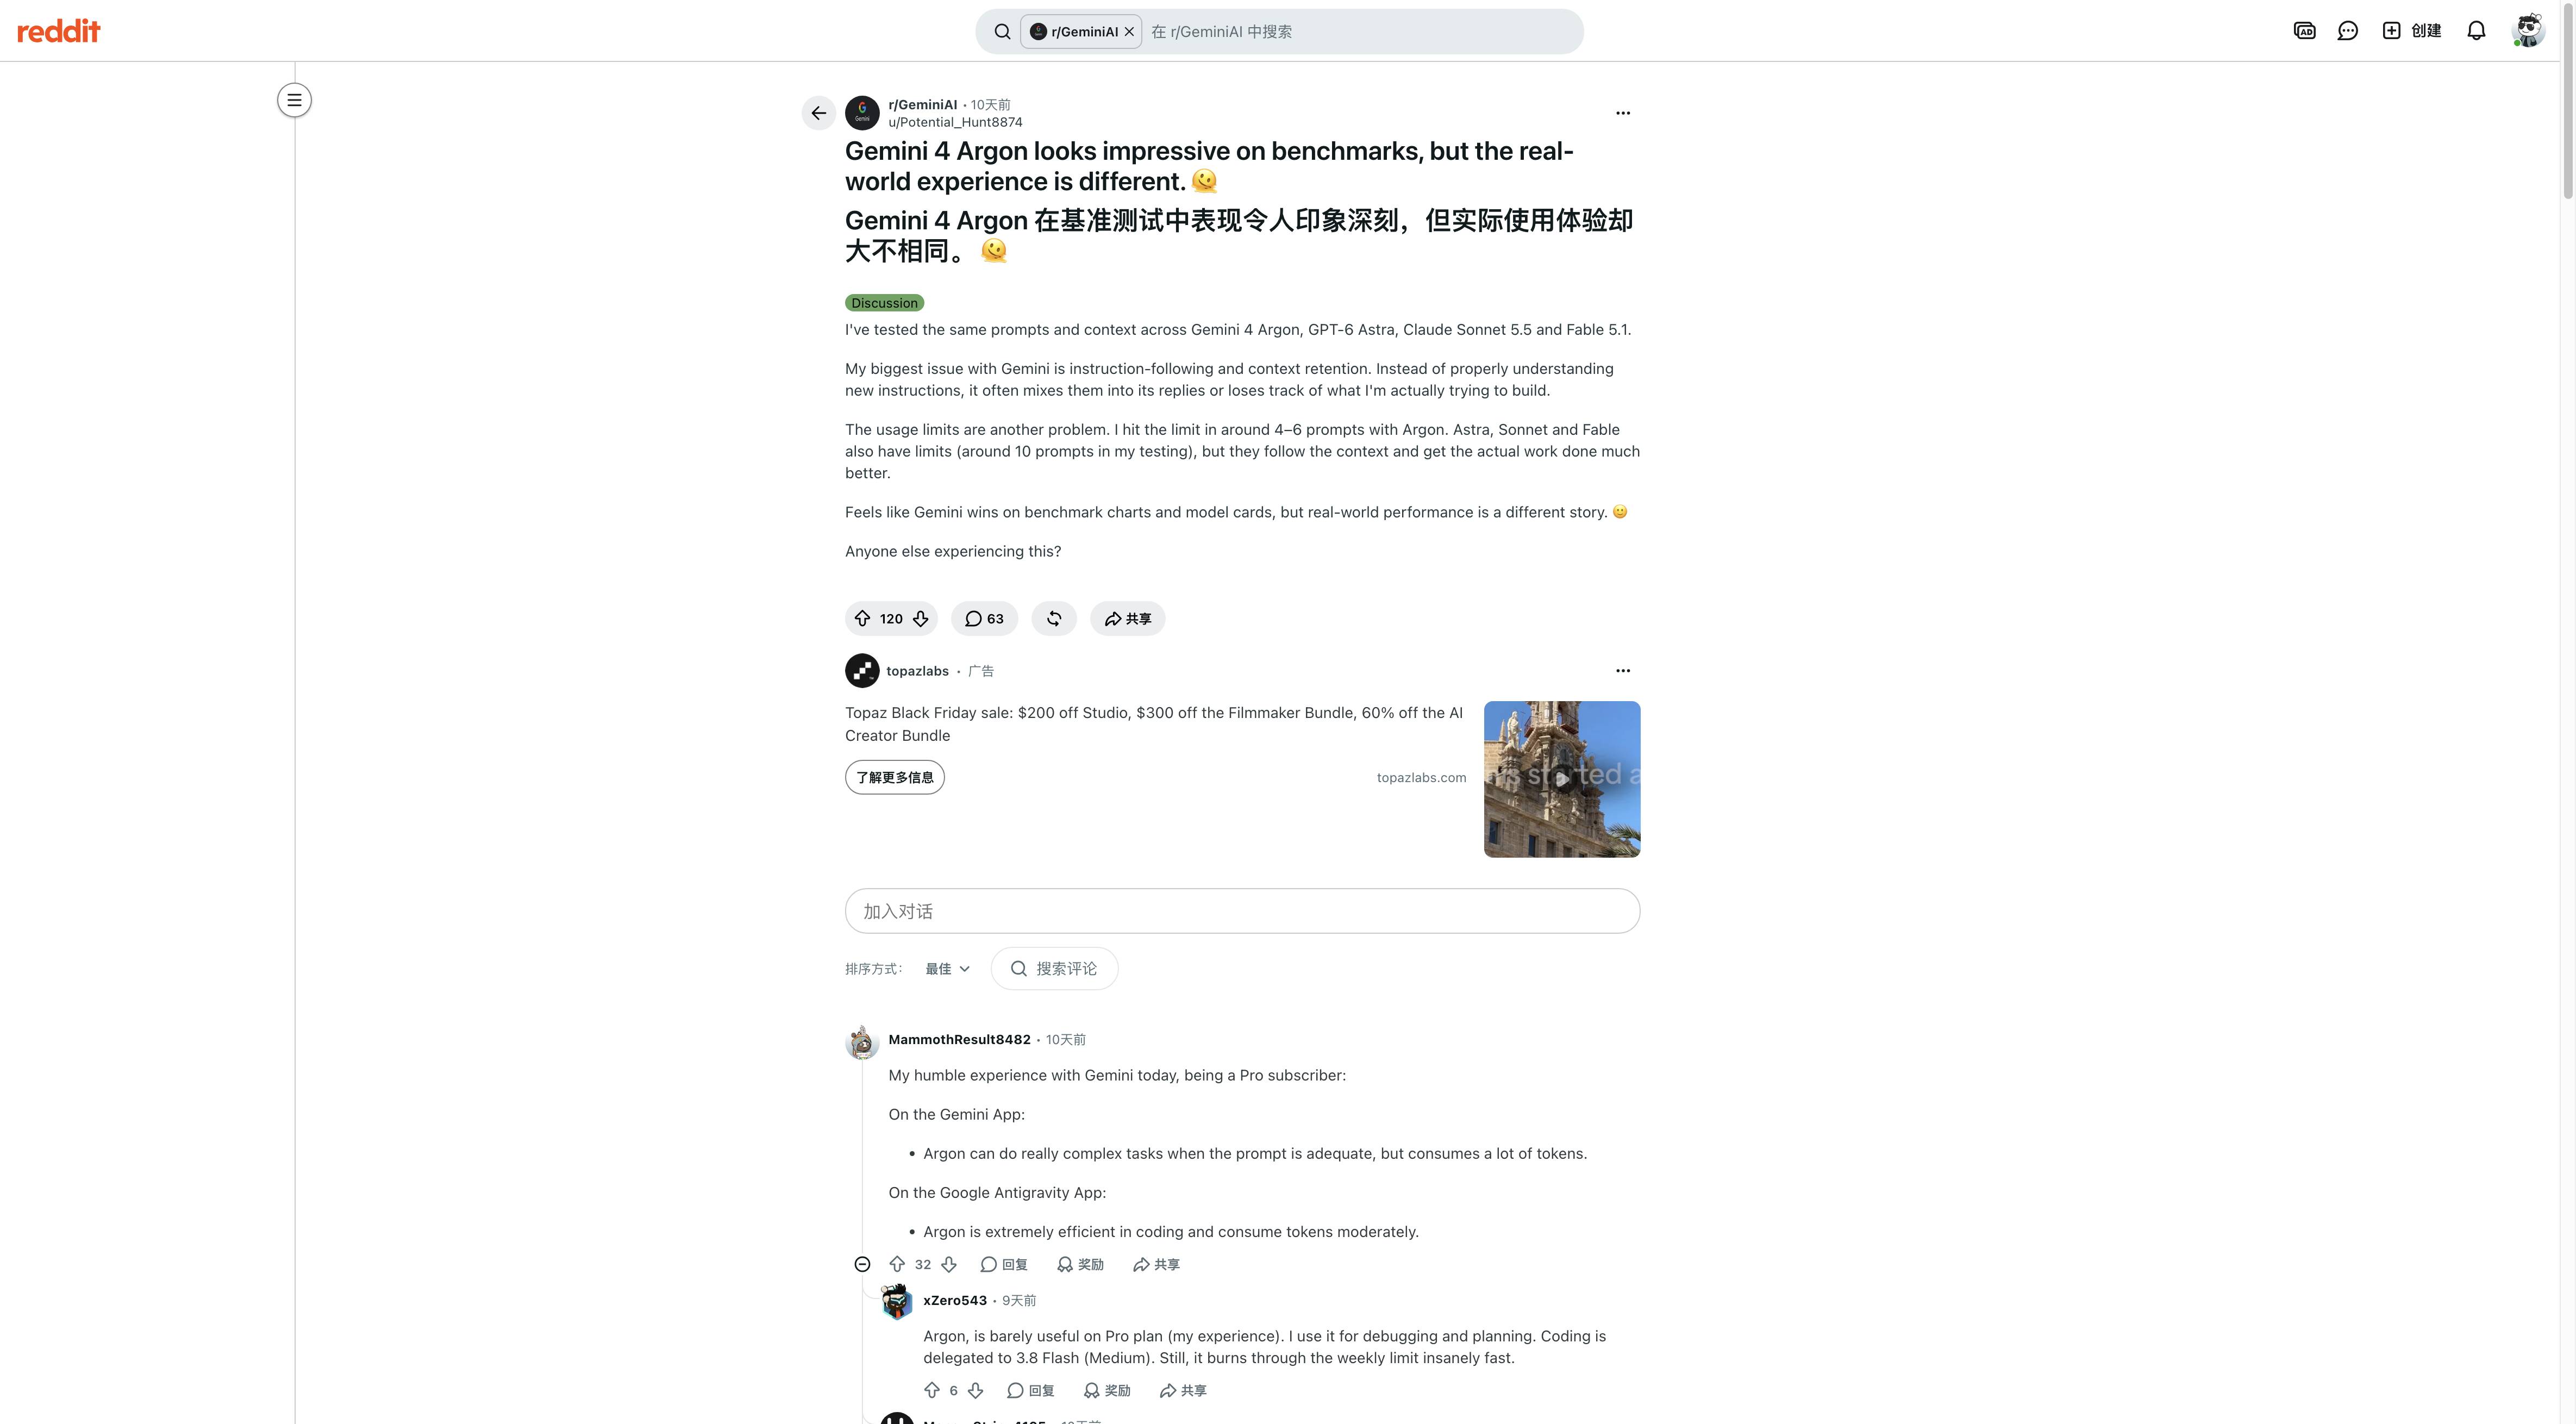
MammothResult8482 比較 Gemini App 與 Antigravity 的用量體驗;採集時頁面顯示約 10 天前發布。 Reddit 原帖
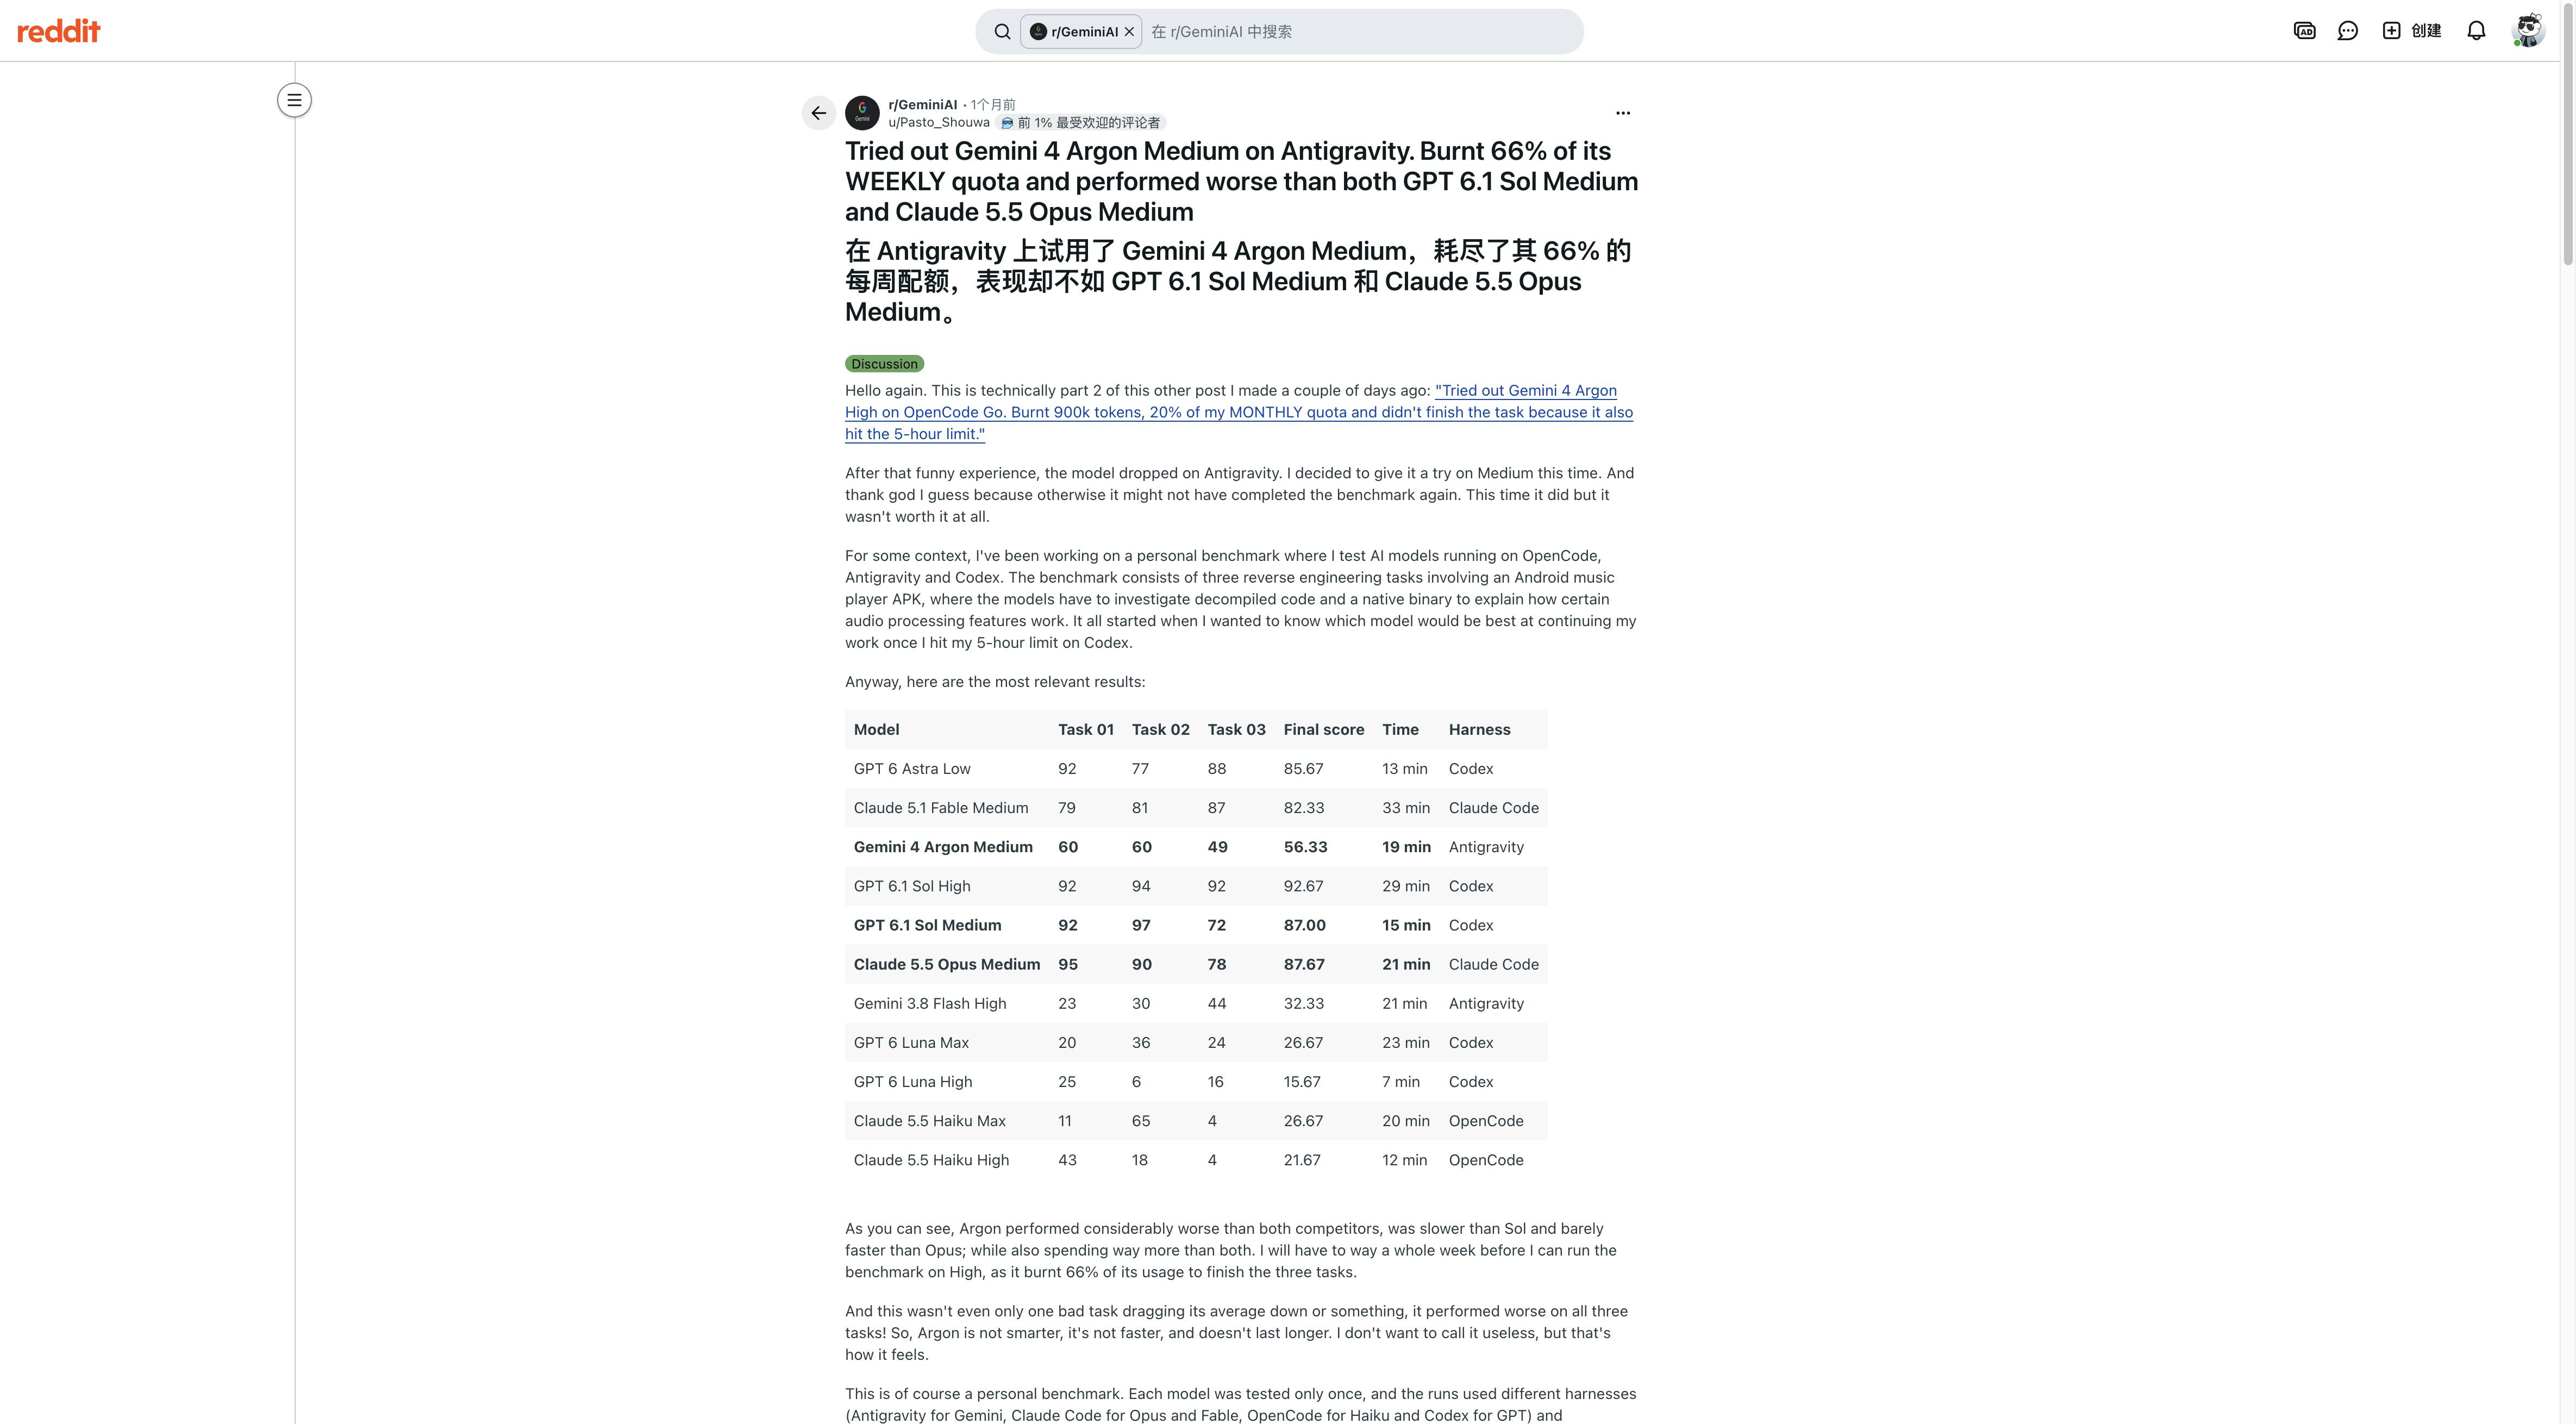
Pasto_Shouwa 分享三項個人基準任務,並說明各模型使用不同工具鏈。 Reddit 原帖
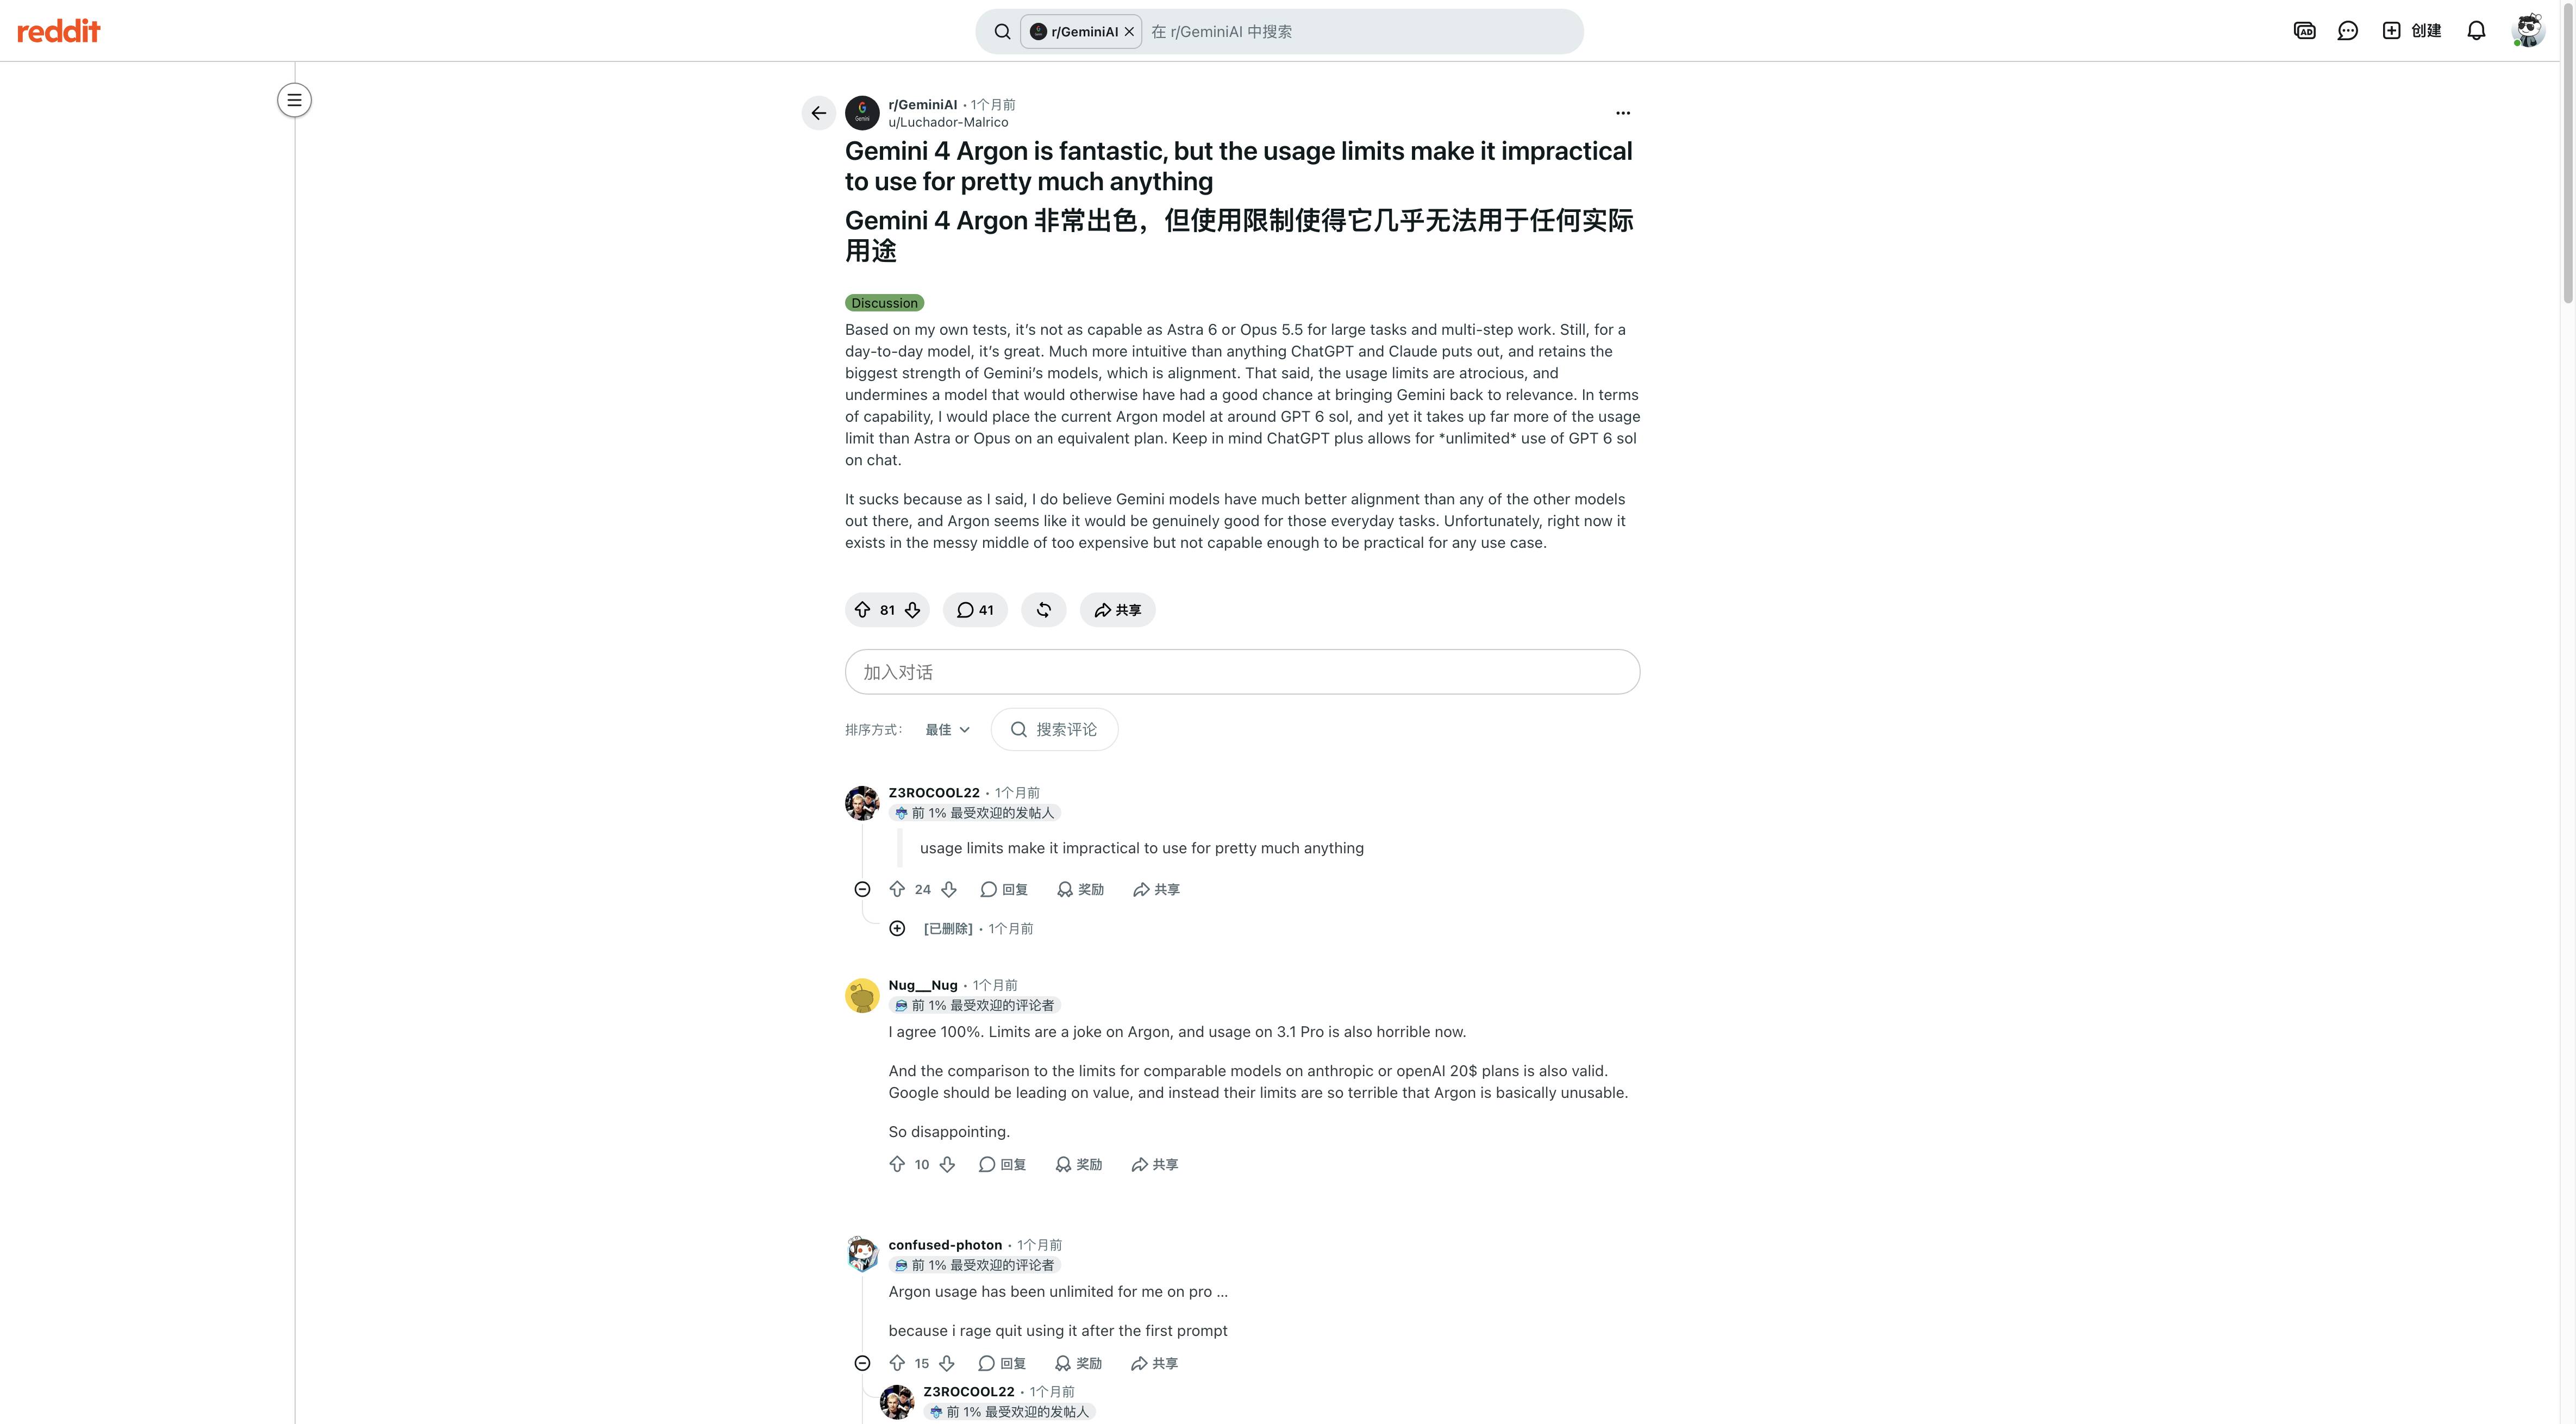
Reddit 訂閱者討論 Argon 用量限制;屬個人經驗,且受方案影響。 Reddit 原帖
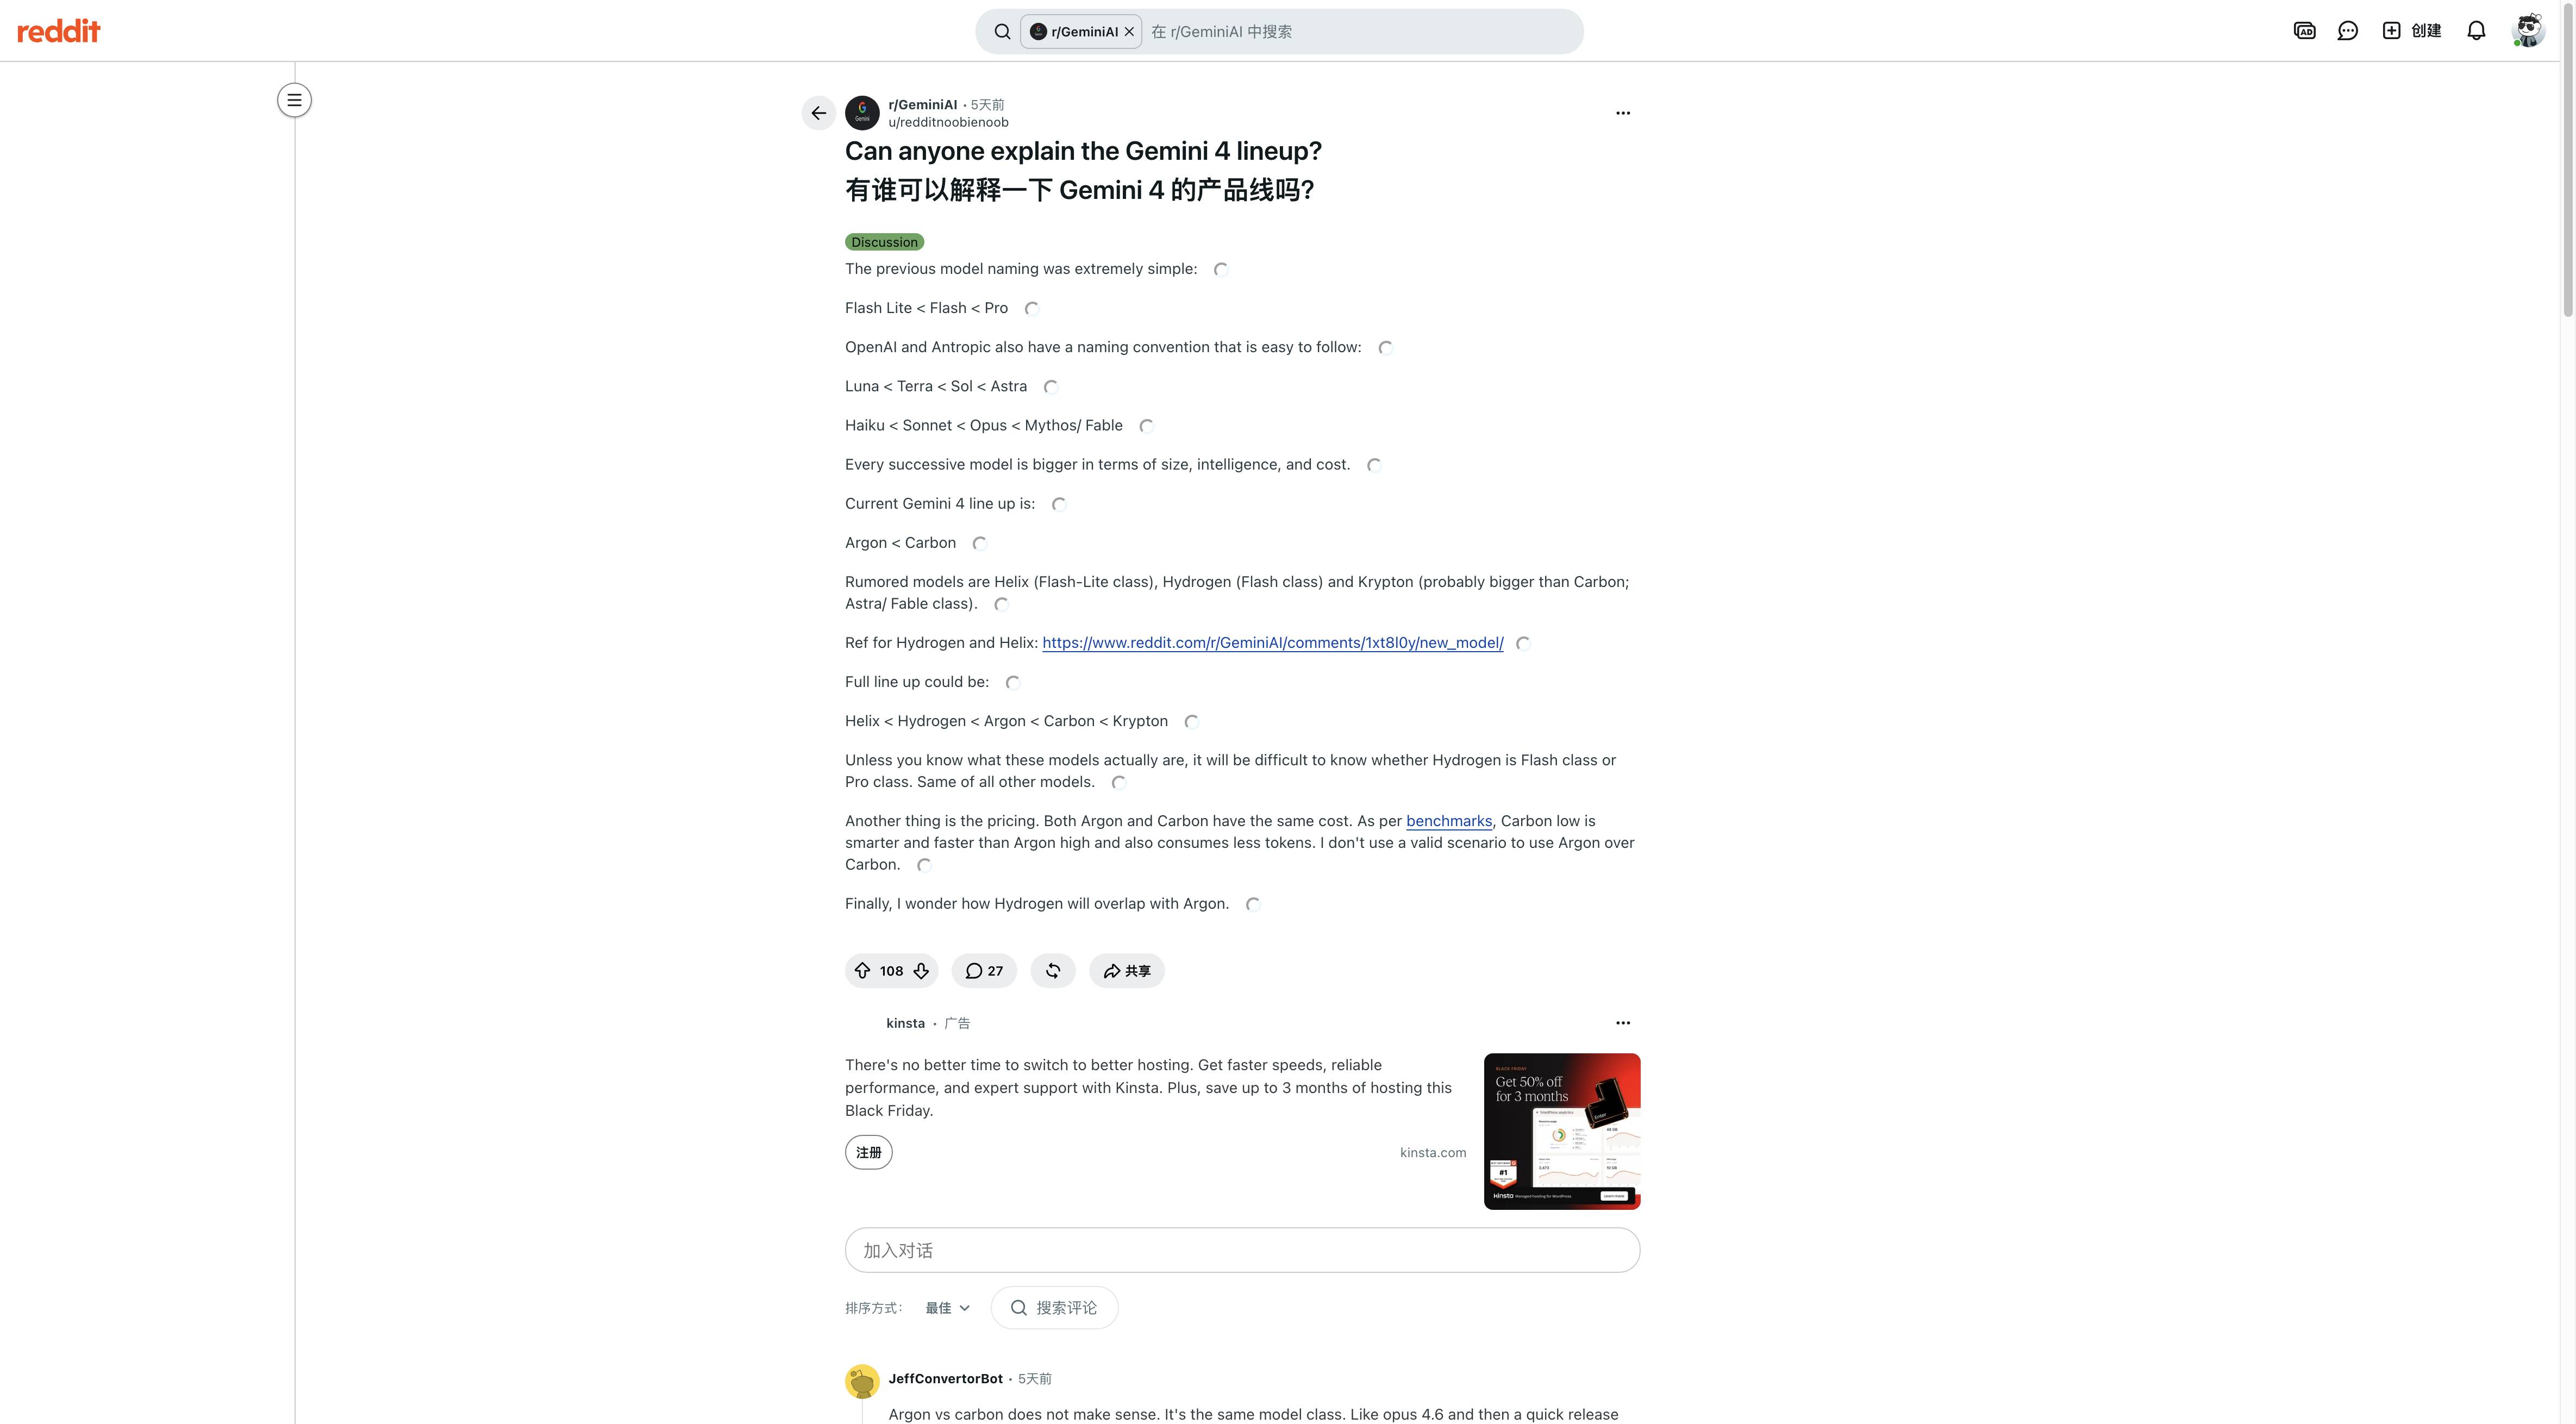
Gemini 產品線討論中,使用者詢問 Argon 與 Carbon 名稱的意義。 Reddit 原帖

常見問題
Gemini 4 Argon 好用嗎?
它適合複雜且可審查的編碼與知識工作。公開證據只涵蓋特定工作型態,設為預設模型前應先用自己的任務測試。
Gemini 4 Argon 的上下文視窗有多大?
Google 為 Gemini API 列出的輸入與輸出合併視窗最高為 100 萬 Token。不同產品介面可能另有限制。
Argon 一定比 Gemini 4 Carbon 強嗎?
不是。Artificial Analysis Index v5.0.1 目前列出 Argon High 為 50、Carbon High 為 60;任務成本與延遲也會隨設定改變。
為什麼有人說 Argon 很耗額度?
Reddit 使用者在 Gemini App、Antigravity 與 API 工作流程中的經驗不同。這些是個人回饋,不是官方方案規則。
如何判斷 Argon 是否適合我的工作?
選一項具代表性的任務,在各模型中固定提示詞、工具與成功標準,並記錄完成情況、重試次數、時間與 Token 費用。
Gemini 4 Argon 的基準結論有獨立驗證嗎?
有 Artificial Analysis Index v5.0.1 等獨立評測。Google 工程案例屬於廠商報告,兩種來源都無法預測每種工作流程。