
Reflection は 2026 年 10 月 16 日に Beam の重みを Apache 2.0 で公開しました。開発者がモデルをダウンロードし、実行場所を選び、周辺ソフトウェアを変更できるようになったことが具体的な変化です。10 月 5 日の紹介では重みは後日公開の予定でした。提供開始の発表で公開が確認できます。
r/LocalLLaMA の公開スレッドでは、derdigga が A23B なら一般向けハードウェアでも動くのか、と質問しています。重要なのはここです。Beam はトークンごとに約 23B パラメータを使いますが、保存・提供するモデル全体は約 501B パラメータです。
注目したいのは導入先の選択肢と公開されたエージェント用ツールです。あらゆるコーディング作業で最強と証明されたわけではありません。公開済みの成果物と今後の予定を分け、DeepSeek、Qwen、Mistral との選び方を整理します。Tabbit Browserは情報源を読む作業の例として扱い、Beam の搭載を確認したものではありません。
要点
10 月 5 日は紹介、16 日が重みの公開です。古い記事の「未公開」は日付を踏まえて読む必要があります。
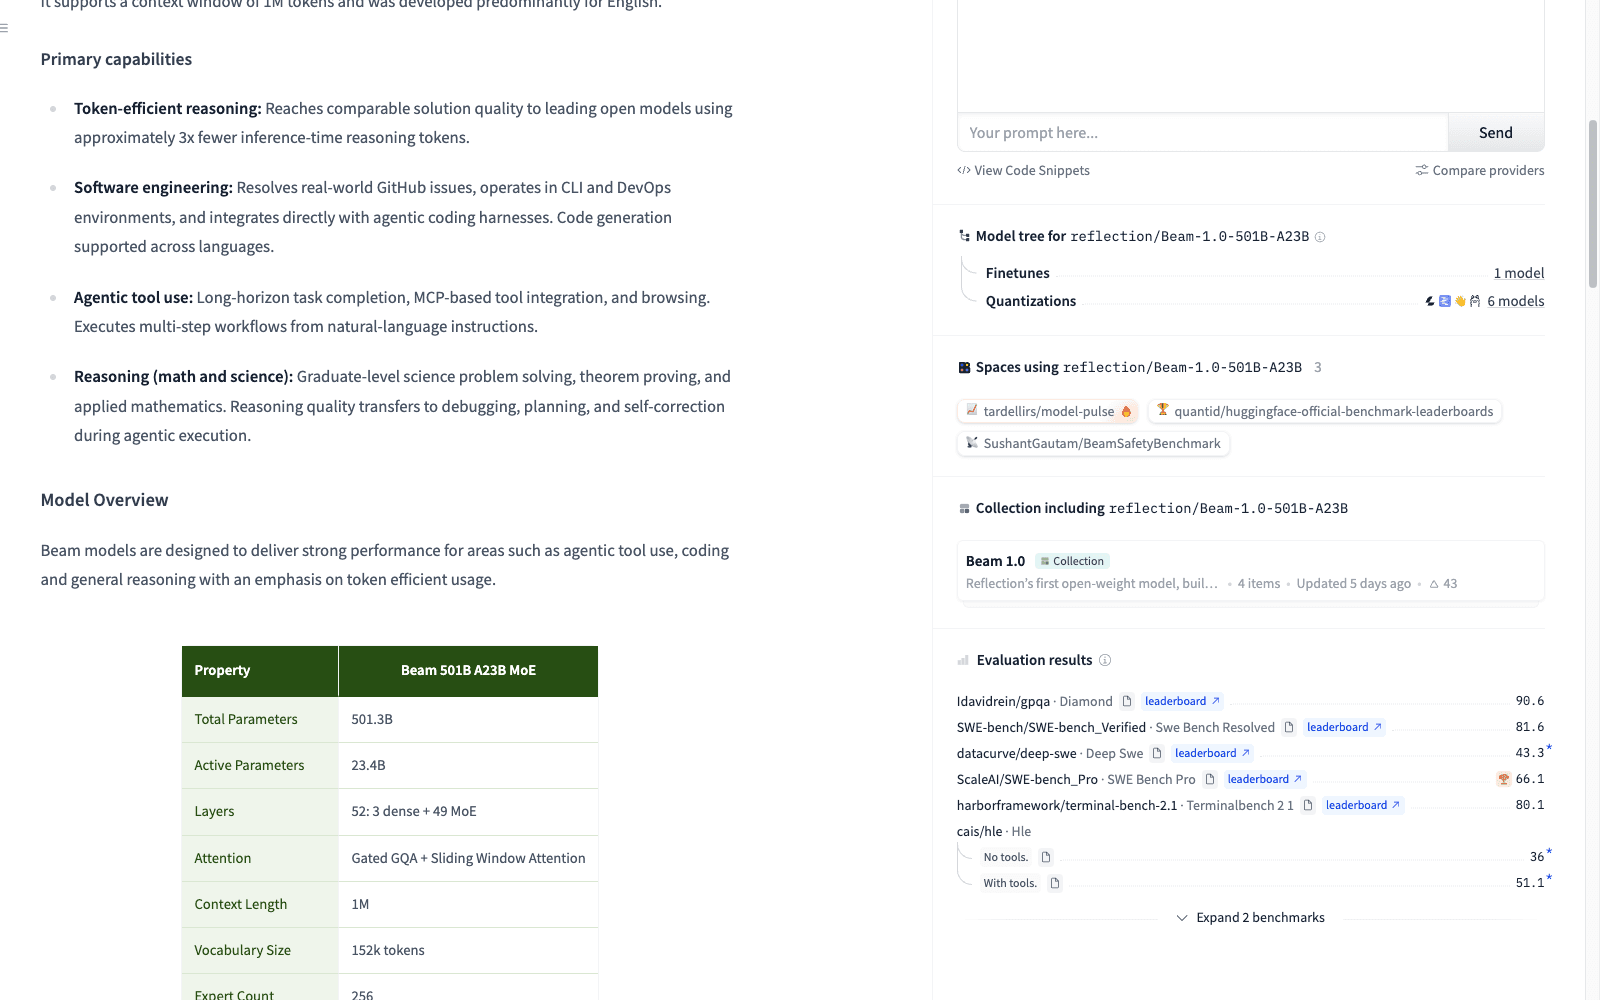
公式モデルカードによると、テキスト用 MoE、総パラメータ約 501B、アクティブ約 23B、コンテキスト 1M トークンです。
Apache 2.0 の重み、Mirror、推論基盤との連携、カスタマイズ手順が実行環境の選択肢を増やします。
アクティブパラメータは計算量に関係します。必要容量には総パラメータ、精度、コンテキスト、同時実行数も関係します。
まず利用可能なエンドポイントで範囲を絞った評価を行い、その結果から設備投資を判断します。
Reflection Beam の公開内容一覧
10 月 21 日に確認した情報です。この記事で Beam を実測した結果ではありません。
| 項目 | 公開・説明されている内容 | 判断への影響 |
|---|---|---|
| モデルの識別 | reflection/Beam-1.0-501B-A23B | Apache Beam、beam search、同名製品との混同を避ける |
| アーキテクチャ | 疎な MoE。詳細値は総数 501.3B、アクティブ 23.4B | 重みの容量とトークンあたりの計算を分ける |
| 入出力 | テキスト。主に英語向けに開発 | 日本語は個別評価が必要。ネイティブ画像入力を想定しない |
| コンテキスト | 1M トークン | 容量の上限であり、全情報の正確な検索を保証しない |
| 形式 | BF16、FP8、NVFP4、DFlash2 ドラフトモデル | 精度とハードウェアにより互換性や結果が変わる |
| ライセンス | 重みと Mirror リポジトリは Apache 2.0 | 実際のファイルと構成要素の表記を確認する |
| 利用経路 | 自己ホスト、Reflection API、提携サービス | 重みの取得とホスト型推論の契約は別の判断 |
出典:公式モデルカード、Mirror リポジトリ。モデルと実行システムの違いは AI エージェントの解説で確認できます。
10 月 16 日に何が公開されたのか
公式コレクションには本体、FP8、NVFP4、投機的デコーディング用のドラフトモデルが含まれます。形式が複数あれば容量やハードウェアを選べますが、すべてのタスクで同じ精度になる保証はありません。
Reflection はターミナル用コーディングエージェント Mirror も公開しました。リポジトリにはエージェント、CLI、関連構成要素があります。ファイルの読み書き、コマンド実行、別々の worktree での作業に対応し、Python フロントエンドが Rust のエージェントコアと通信します。実行ループを調べられる点に意味があります。
発表では Transformers、vLLM、SGLang の推論対応と、ファインチューニングや強化学習に関する協力が説明されています。AWS の導入ガイドにはマネージドエンドポイントと Kubernetes を利用する経路があります。重みの存在だけでなく、運用側が評価を始めるための資料もそろいました。
一方、モデルカードが説明するのは学習データの種類です。商業契約で取得したデータも含まれ、全コーパスの再構成をダウンロードできるわけではありません。技術レポートは公開予定の表示で、発表では自己蒸留のレシピも後日の予定です。重みの公開、学習の説明、学習全体の再現可能性は別の成果物です。「オープンウェイトとオープンソースのツール」が確認できる範囲に合った表現です。
アクティブ 23B でも導入が軽くならない理由
MoE は各トークンを一部のエキスパートへ送るため計算を減らせます。ただし、今使わなかったエキスパートを次のトークンが使う可能性があり、サーバーには全重みへのアクセスが必要です。
重みの保存容量 ≈ 総パラメータ数 × 1パラメータの保存バイト数
推論メモリ = 重み + KVキャッシュ + 実行時の追加領域 + バッファー
Hugging Face の公開ガイドでは BF16 が約 1TB、NVFP4 が約 280GB です。後者は、その容量だけであらゆるサービスを動かせるという意味ではありません。長いコンテキストや同時リクエストには追加領域が必要で、NVFP4 の実行にもハードウェア条件があります。
RAM やストレージへ重みをオフロードすれば容量と速度の条件は変わりますが、転送コストと遅延が生じます。本記事ではその構成を測定していません。掲示板の tokens/s をそのまま購入判断に使うことはできません。
同じスレッドで mindwip は、公開時点で複数精度の評価を載せた点を評価しています。投稿の bf16、q8、q4 は非公式の呼び方で、公式形式は BF16、FP8、NVFP4 です。実際に使える精度での結果を知りたい、という利用者の関心が読み取れます。
DeepSeek、Qwen、Mistral とはどう比較するか
企業名だけでなく具体的なチェックポイントを選びます。DeepSeek-V4.1-Flashは大規模モデルの候補で、リポジトリには MIT とマルチモーダル入力が記載されています。DeepSeek V4.1 Flash の解説は同モデル固有の構造と提供方法を扱っており、スコアを Beam に流用できません。
Qwen3-Coder-30B-A3B-Instructは総数 30.5B、アクティブ 3.3B、Apache 2.0、ネイティブ 256K コンテキストです。以前のチェックポイントを選んだのは導入規模の違いを示すためで、最新旗艦モデルという意味ではありません。Qwen3.8 Maxは別製品です。
Mistral の Devstral Small 2 24Bにも Apache 2.0 の重みと Mistral Vibe の連携説明があります。総パラメータが少ないため、必要容量の判断が変わります。このライセンスを Mistral 全製品へ一般化しないでください。
比較すべきは、大規模モデルを制御する必要があるか、小さなコーディングモデルが適切か、現在のエンドポイントを継続すべきかです。別条件のスコアをつないでも答えは出ません。エージェントではツール定義、再試行、コンテキスト管理、権限も結果を変えます。DeepSeek Harness のブラウザー連携ガイドはその区別の参考で、Beam や Mirror の同等対応を証明するものではありません。エージェントの推論に関する解説では、最終回答だけでは評価できない理由を説明しています。
Tabbit で公開資料をまとめて確認する
初期発表、更新されたモデルカード、導入手順、コミュニティの投稿は、日付を外すと矛盾して見えることがあります。Tabbit のワークフローでは、関連ページを分析のコンテキストとして扱えます。
二つの発表とモデルカード、導入ガイドを開き、各行に日付と URL を付けた成果物一覧を依頼します。「公開済み」と「予定」を別の列にすると確認しやすくなります。公式 v1.13 更新情報には外部コードエージェント向け Tabbit CLI の説明があります。設定と地域ごとの提供状況は確認が必要です。
これは資料調査の提案で、Tabbit 上の Beam の実測ではありません。資料を読んでもモデルの実行やスコアの検証にはなりません。コード実行は適切な harness に任せます。ブラウザーの役割は エージェント型ブラウザーのガイドを参照してください。
公開で分かったことと、評価で確かめること
重みと複数のツールが公開されたことは確認できます。自分のタスクで最速・最安になることまでは証明しません。生成トークンが少ないだけでは総費用が下がるとは限りません。
合格タスク1件の費用 = 全実行費用 ÷ 検収に合格したタスク数必要に応じて失敗、ツール呼び出し、設備の待機時間、人手の確認も含めます。リポジトリの版、タスク、harness、精度、推論予算、制限時間を固定し、テスト合格、ツールエラーからの復帰、修正に必要な人の時間を記録します。小規模な試行でも、全面的なベンチマークと称さずに意思決定へ使えます。
今、Beam を試すべき人
| 主な制約 | 妥当な最初の一歩 | 投資前に確かめる点 |
|---|---|---|
| 大規模コードモデルの実行環境を制御したい | 文書化されたエンドポイント、その後に自己ホスト試行 | 品質、容量、運用責任 |
| 一般的なワークステーションしかない | 小さな Qwen、Devstral を比較 | 重み全体の容量と許容遅延 |
| DeepSeek や Qwen が安定稼働中 | 同一タスクと harness で Beam を追加評価 | 移行に見合う改善 |
| 狭い分野に適応させたい | 公開済みの微調整・RL 手順を確認 | 計算、データ、評価の費用 |
| 発表の内容を理解したい | 発表とモデルカードを併読 | 現在の成果物と今後の予定 |
ダウンロード可能なモデルと、調査・変更できるエージェントツールが増えた点で、Beam は評価に値します。導入やカスタマイズの要件があるチームには選択肢が増えます。移行は自分たちの試行結果を待って決めればよいでしょう。
代表的なタスクを一つ選び、合格条件を書き、現行方式と比べるところから始めてください。出典確認には Tabbit、501B パラメータの提供には推論ガイドとハードウェア予算が出発点になります。

よくある質問
Reflection Beam の重みはいつ公開されましたか?
2026年10月5日はモデルの紹介、16日が重みの公開です。後者の発表で Apache 2.0、Hugging Face、導入とエージェントの連携が確認できます。
Beam はオープンソースですか、オープンウェイトですか?
正確には Apache 2.0 のオープンウェイトと、Mirror などのオープンソースツールです。学習コーパス全体や完全再現可能な学習工程の公開を意味せず、技術レポートは公開予定の表示です。
アクティブ23Bなら24GBのGPUで動きますか?
アクティブ数はトークンごとの計算であり、重み全体の容量ではありません。Hugging Face は BF16 約1TB、NVFP4 約280GB と説明しています。RAMやディスクへのオフロードは速度と容量の条件を変えますが、残りの重みを消すものではありません。
DeepSeek、Qwen、Mistral より優れていますか?
本記事は普遍的な優勝モデルを示していません。具体的なチェックポイントを、同じタスク、harness、精度、予算で比較してください。容量が限られる場合、小型モデルが適することもあります。
Apache Beam や beam search と同じですか?
違います。本記事は reflection/Beam-1.0-501B-A23B で識別される Reflection のモデルを扱います。Apache Beam はデータ処理、beam search はデコード手法です。
Tabbit Browser で Beam を選べますか?
本記事では Tabbit のモデル選択欄での提供を確認していません。資料の確認には Tabbit を使えますが、Beam の実行には対応するエンドポイントと harness が必要です。