
A Reflection publicou os pesos do Beam em 16 de outubro de 2026, sob Apache 2.0. A mudança é concreta: baixar o modelo, escolher onde executá-lo e adaptar o software ao redor dele. A apresentação de 5 de outubro ainda prometia os pesos para depois. O anúncio de disponibilidade confirma a entrega.
Na discussão do lançamento no r/LocalLLaMA, derdigga perguntou se A23B significava que o modelo rodava em hardware de consumo. Essa é a dificuldade: o Beam ativa cerca de 23B parâmetros por token, mas continua exigindo armazenamento e acesso a aproximadamente 501B parâmetros totais.
A notícia importa pelas opções de implantação e pelas ferramentas abertas para agentes. Não estabelece um vencedor universal em programação. Aqui separamos entregas de promessas, situamos DeepSeek, Qwen e Mistral e usamos o Tabbit Browser para organizar fontes. Isso não confirma uma integração do Beam com o Tabbit.
Pontos principais
A apresentação ocorreu em 5 de outubro; os pesos chegaram no dia 16. Artigos anteriores podem descrever uma situação ultrapassada.
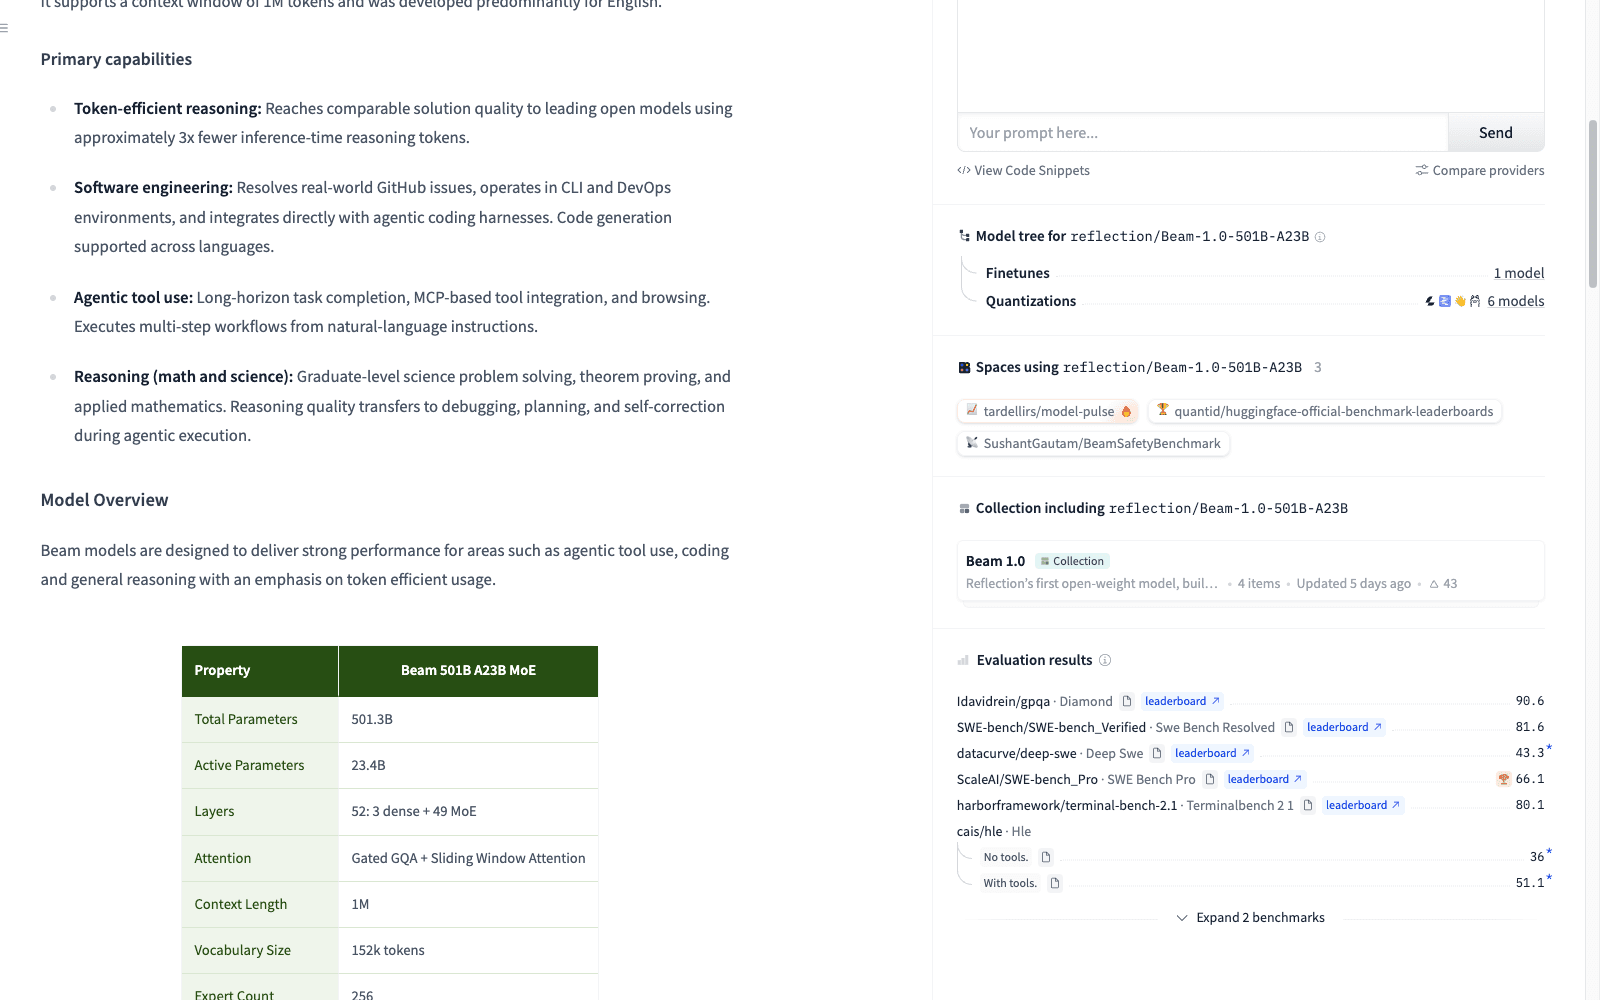
A ficha descreve um MoE de texto com 501B parâmetros totais, 23B ativos e contexto de 1M tokens.
Pesos Apache 2.0, Mirror, integrações de inferência e receitas de personalização ampliam o controle sobre o sistema.
Parâmetros ativos afetam o cálculo por token; total, precisão, contexto e concorrência determinam os recursos necessários.
Comece por uma tarefa delimitada em um endpoint disponível. Decida sobre infraestrutura com medições próprias.
Reflection Beam em resumo
Informações verificadas em 21 de outubro; não são resultados de um benchmark próprio do Beam.
| Item | O que está publicado ou documentado | Consequência prática |
|---|---|---|
| Identidade | reflection/Beam-1.0-501B-A23B | Distinguir de Apache Beam, beam search e produtos homônimos |
| Arquitetura | MoE esparso; 501.3B totais e 23.4B ativos na ficha detalhada | Separar armazenamento dos pesos e cálculo por token |
| Modalidades | Texto; desenvolvido principalmente para inglês | Testar outros idiomas; não presumir visão nativa |
| Contexto | 1M tokens | Limite de capacidade, sem garantia de recuperação perfeita |
| Formatos | BF16, FP8, NVFP4 e modelo auxiliar DFlash2 | Compatibilidade e qualidade dependem do formato |
| Licenças | Pesos e repositório Mirror sob Apache 2.0 | Conferir arquivos e avisos dos componentes |
| Acesso | Hospedagem própria, API Reflection e parceiros | Baixar pesos e contratar inferência hospedada são escolhas distintas |
Fontes: ficha oficial e repositório Mirror. A explicação sobre agentes de IA distingue o modelo do sistema que executa suas ações.
O que realmente foi aberto em 16 de outubro
A coleção oficial inclui o checkpoint principal, variantes FP8 e NVFP4 e um modelo auxiliar de decodificação especulativa. Os formatos oferecem opções de memória e hardware, sem garantir resultados idênticos em todas as tarefas.
A Reflection também publicou o Mirror, seu agente de programação para terminal. O repositório contém agente, CLI e componentes associados. Ele lê e edita arquivos, executa comandos e trabalha em worktrees separados. Um frontend Python conversa com um núcleo Rust, permitindo inspecionar o ciclo de execução.
O anúncio cita Transformers, vLLM e SGLang para inferência, além de parceiros de ajuste fino e aprendizado por reforço. O guia da AWS apresenta endpoints gerenciados e caminhos baseados em Kubernetes. A equipe de infraestrutura ganha material para uma avaliação operacional.
Há limites. A ficha descreve categorias de dados, incluindo conteúdo obtido por acordos comerciais, mas não oferece uma reconstrução do corpus completo para download. O relatório técnico continua marcado como futuro e o anúncio deixa receitas de autodestilação para depois. Publicar pesos, descrever o treinamento e permitir reproduzi-lo integralmente são entregas diferentes. A formulação precisa é «pesos abertos com ferramentas de código aberto».
Por que 23B ativos não tornam a implantação pequena
Um MoE direciona cada token a parte dos especialistas. Isso reduz o cálculo, mas o servidor continua precisando acessar todos os pesos. Especialistas não usados agora podem ser necessários no token seguinte.
Armazenamento dos pesos ≈ parâmetros totais × bytes por parâmetro
Memória de inferência = pesos + cache KV + sobrecarga + buffers
O guia do Hugging Face informa cerca de 1 TB para BF16 e 280 GB para NVFP4. O segundo valor não garante que um serviço completo caiba exatamente nessa memória. Contexto longo e requisições simultâneas exigem espaço adicional; NVFP4 também depende do hardware.
Descarregar pesos para RAM ou disco altera a relação entre capacidade, transferências e latência. Nenhuma configuração assim foi medida aqui. Uma velocidade relatada em fórum, isoladamente, não fundamenta a compra de equipamentos.
No mesmo tópico, mindwip elogiou a publicação de avaliações em diferentes precisões já no lançamento. O comentário usa bf16, q8 e q4 informalmente; os formatos oficiais são BF16, FP8 e NVFP4. O ponto útil é avaliar a precisão que realmente será usada.
Como comparar com DeepSeek, Qwen e Mistral
Compare checkpoints específicos, não apenas empresas. DeepSeek-V4.1-Flash é um candidato grande; seu repositório indica MIT e entrada multimodal. Nossa explicação do DeepSeek V4.1 Flash trata da arquitetura dele. Os resultados não se transferem para o Beam.
Qwen3-Coder-30B-A3B-Instruct documenta 30.5B parâmetros totais, 3.3B ativos, Apache 2.0 e contexto nativo de 256K. É um checkpoint anterior escolhido para ilustrar outra escala de implantação, não o modelo mais recente da família. Qwen3.8 Max é um produto diferente.
O Devstral Small 2 24B, da Mistral, oferece pesos Apache 2.0 e integração documentada com Mistral Vibe. O total menor leva a outra decisão de capacidade. Essa licença não descreve todos os modelos da Mistral.
A escolha real envolve controlar um modelo grande, implantar um modelo menor ou manter um endpoint que já funciona. Juntar pontuações de protocolos diferentes esconde essa escolha. Nos agentes, ferramentas, tentativas, contexto e permissões também mudam o resultado. O guia de integração do DeepSeek Harness com o navegador ilustra essa distinção, sem comprovar uma integração equivalente do Beam ou Mirror. O guia de raciocínio agêntico explica por que a resposta final não basta para avaliar o sistema.
Um papel prático para o Tabbit: reunir as fontes
Uma apresentação inicial, uma ficha atualizada e uma receita de implantação podem parecer contraditórias se as datas forem ignoradas. O fluxo de trabalho do Tabbit permite usar páginas relacionadas como contexto de análise.
Abra os dois anúncios, a ficha e o guia. Peça um inventário datado, com URL em cada linha e colunas separando entregas e promessas. As notas oficiais da v1.13 documentam o Tabbit CLI para agentes externos de código; configuração e disponibilidade regional ainda precisam ser verificadas.
É um fluxo de pesquisa proposto, não um teste do Beam no Tabbit. Ler uma ficha não executa o checkpoint nem valida seus números. Mantenha a execução de código em um harness adequado. O guia do navegador agêntico esclarece o papel do navegador.
O que o lançamento prova e o que precisa ser medido
Os pesos e várias ferramentas estão públicos. Isso não estabelece que o Beam seja o mais rápido ou barato para seu trabalho. Menos tokens gerados não garantem uma conta total menor.
Custo por tarefa aceita = custo total das execuções / tarefas aprovadasInclua falhas, ferramentas, recursos ociosos e revisão humana quando relevantes. Fixe revisão do repositório, tarefas, harness, precisão, orçamento de raciocínio e timeout. Verifique se o patch passa nos testes, se o agente se recupera de erros e quanto trabalho humano resta. Um piloto delimitado pode orientar a decisão sem ser apresentado como benchmark completo.
Quem deve experimentar o Beam agora?
| Restrição | Primeiro passo razoável | O que confirmar antes de investir |
|---|---|---|
| Controlar um modelo grande de código | Endpoint documentado, depois piloto próprio | Qualidade, capacidade e responsabilidade operacional |
| Estação de trabalho modesta | Checkpoints menores de Qwen ou Devstral | Pesos completos e latência aceitável |
| DeepSeek ou Qwen já funcionam bem | Mesmas tarefas e harness com Beam | Melhoria que justifique migração |
| Personalizar um domínio | Receitas disponíveis de ajuste fino e RL | Custo de computação, dados e avaliação |
| Entender a notícia | Ler anúncio e ficha juntos | Artefatos entregues e compromissos futuros |
Vale avaliar o Beam porque ele acrescenta um modelo para download e ferramentas de agente inspecionáveis. Equipes que precisam controlar implantação ou personalização ganham uma opção. Uma migração deve depender de um piloto bem-sucedido.
Comece pequeno: uma tarefa representativa, critérios de aceitação e a solução atual como referência. O Tabbit pode ajudar a conferir fontes; para servir 501B parâmetros, comece pelo guia de inferência e pelo orçamento de hardware.

Perguntas frequentes
Quando os pesos do Reflection Beam foram publicados?
A Reflection apresentou o Beam em 5 de outubro de 2026 e publicou os pesos no dia 16. O segundo anúncio confirma Apache 2.0, Hugging Face e integrações de implantação e agentes.
Beam é código aberto ou pesos abertos?
A descrição precisa é um modelo de pesos abertos Apache 2.0 com ferramentas de código aberto, como Mirror. Isso não comprova a publicação do corpus completo nem de um treinamento integralmente reproduzível; o relatório técnico continua anunciado como futuro.
Uma GPU de 24 GB basta porque só ativa 23B parâmetros?
Parâmetros ativos descrevem o cálculo por token, não o tamanho completo. O Hugging Face informa cerca de 1 TB em BF16 e 280 GB em NVFP4; descarregar pesos para RAM ou disco altera o desempenho, sem eliminar os demais pesos.
Beam é melhor que DeepSeek, Qwen ou Mistral?
Este artigo não estabelece um vencedor universal. Compare checkpoints específicos com tarefas, harness, precisão e orçamento iguais; modelos menores podem ser mais práticos com capacidade limitada.
É o mesmo Beam de Apache Beam ou beam search?
Não. Aqui Beam é o modelo da Reflection, identificado por reflection/Beam-1.0-501B-A23B. Apache Beam processa dados e beam search é um método de decodificação.
Posso selecionar Beam no Tabbit Browser?
Este artigo não confirma a presença do Beam no seletor do Tabbit. O Tabbit pode ajudar a conferir fontes; executar Beam exige endpoint e harness apropriados.