
Reflection publicó los pesos de Beam el 16 de octubre de 2026, bajo Apache 2.0. El cambio es concreto: descargar el modelo, elegir dónde ejecutarlo y adaptar el software que lo rodea. Conviene separar la presentación del 5 de octubre, cuando los pesos todavía eran una promesa, del anuncio de disponibilidad.
En el hilo de lanzamiento de r/LocalLLaMA, derdigga preguntó si A23B significaba que funcionaba en hardware de consumo. Esa es la dificultad: Beam activa unos 23B parámetros por token, pero almacenar y servir el modelo implica unos 501B parámetros totales.
La noticia merece atención por las opciones de despliegue y las herramientas abiertas para agentes. No demuestra un ganador universal en programación. Aquí distinguimos lo publicado de lo pendiente, situamos DeepSeek, Qwen y Mistral como alternativas concretas y usamos Tabbit Browser para organizar la lectura de fuentes. No se afirma que Beam esté integrado en Tabbit.
Ideas principales
El 5 de octubre fue la presentación; el 16 llegaron los pesos. Los artículos anteriores pueden describir un estado ya superado.
Beam es un MoE de texto: 501B parámetros totales, 23B activos y contexto de 1M tokens, según su ficha.
Los pesos Apache 2.0, Mirror, las integraciones de inferencia y las recetas de personalización amplían las posibilidades de control.
Los parámetros activos afectan al cálculo por token; el total, la precisión, el contexto y la concurrencia determinan la capacidad necesaria.
Primero conviene evaluar una tarea delimitada mediante un endpoint disponible. La infraestructura se decide con resultados propios.
Reflection Beam de un vistazo
Datos comprobados el 21 de octubre; no son resultados de una prueba propia de Beam.
| Elemento | Qué está publicado o documentado | Consecuencia práctica |
|---|---|---|
| Identidad | reflection/Beam-1.0-501B-A23B | Distinguirlo de Apache Beam, beam search y otros productos homónimos |
| Arquitectura | MoE disperso; 501.3B totales y 23.4B activos en la ficha detallada | Separar capacidad de pesos y cálculo por token |
| Modalidad | Texto; desarrollado principalmente para inglés | Evaluar otros idiomas por separado; no asumir visión nativa |
| Contexto | 1M tokens | Límite de capacidad, no garantía de recuperación perfecta |
| Formatos | BF16, FP8 y NVFP4; también un modelo auxiliar DFlash2 | La compatibilidad y la calidad dependen del formato |
| Licencias | Pesos y repositorio Mirror bajo Apache 2.0 | Revisar los archivos y avisos de los componentes |
| Acceso | Alojamiento propio, API de Reflection y proveedores asociados | Descargar pesos y pagar inferencia alojada son decisiones distintas |
Fuentes: ficha oficial y repositorio Mirror. La guía sobre agentes de IA explica la diferencia entre un modelo y el sistema que ejecuta sus acciones.
Qué se abrió realmente el 16 de octubre
La colección oficial incluye el checkpoint principal, las variantes FP8 y NVFP4 y un modelo auxiliar para decodificación especulativa. Ofrecen distintas opciones de memoria y hardware, sin garantizar la misma precisión en cualquier tarea.
Reflection también publicó Mirror, su agente de programación para terminal. El repositorio contiene el agente, la CLI y componentes asociados. Puede leer y editar archivos, ejecutar comandos y trabajar en distintos worktrees. Un frontend Python se comunica con un núcleo Rust: el equipo puede inspeccionar el ciclo de ejecución.
El anuncio incluye soporte en Transformers, vLLM y SGLang, además de colaboraciones para ajuste fino y aprendizaje por refuerzo. La guía de AWS describe rutas gestionadas y basadas en Kubernetes. Esto permite evaluar algo más que un archivo descargable.
Los límites siguen siendo importantes. La ficha describe categorías de datos, incluidos materiales obtenidos mediante acuerdos comerciales, pero no ofrece una reconstrucción descargable del corpus completo. El informe técnico todavía figura como pendiente y el anuncio deja las recetas de autodestilación para más adelante. Publicar pesos, describir el entrenamiento y permitir reproducirlo íntegramente son entregas distintas. La descripción precisa es «pesos abiertos y herramientas de código abierto».
Por qué 23B activos no hacen pequeño el despliegue
Un MoE dirige cada token a parte de sus expertos. Reduce el cálculo, pero el servidor sigue necesitando acceso al conjunto de pesos. Los expertos no utilizados en un token pueden ser necesarios en el siguiente.
Almacenamiento de pesos ≈ parámetros totales × bytes por parámetro
Memoria de inferencia = pesos + caché KV + sobrecarga + buffers
La guía de Hugging Face sitúa BF16 en aproximadamente 1 TB y NVFP4 en unos 280 GB. Eso no significa que 280 GB de memoria de dispositivo basten para cualquier servicio. El contexto largo y la concurrencia requieren espacio adicional; NVFP4 también depende del hardware.
Descargar parte de los pesos a RAM o almacenamiento cambia el equilibrio entre capacidad, transferencias y latencia. Aquí no se ha medido esa configuración. Las velocidades citadas en un foro no justifican por sí solas comprar hardware.
En el mismo hilo, mindwip celebró que se publicaran evaluaciones para diferentes precisiones desde el lanzamiento. Su comentario usa las etiquetas informales bf16, q8 y q4; los formatos oficiales son BF16, FP8 y NVFP4. La necesidad es clara: conocer el resultado de la precisión que realmente se va a desplegar.
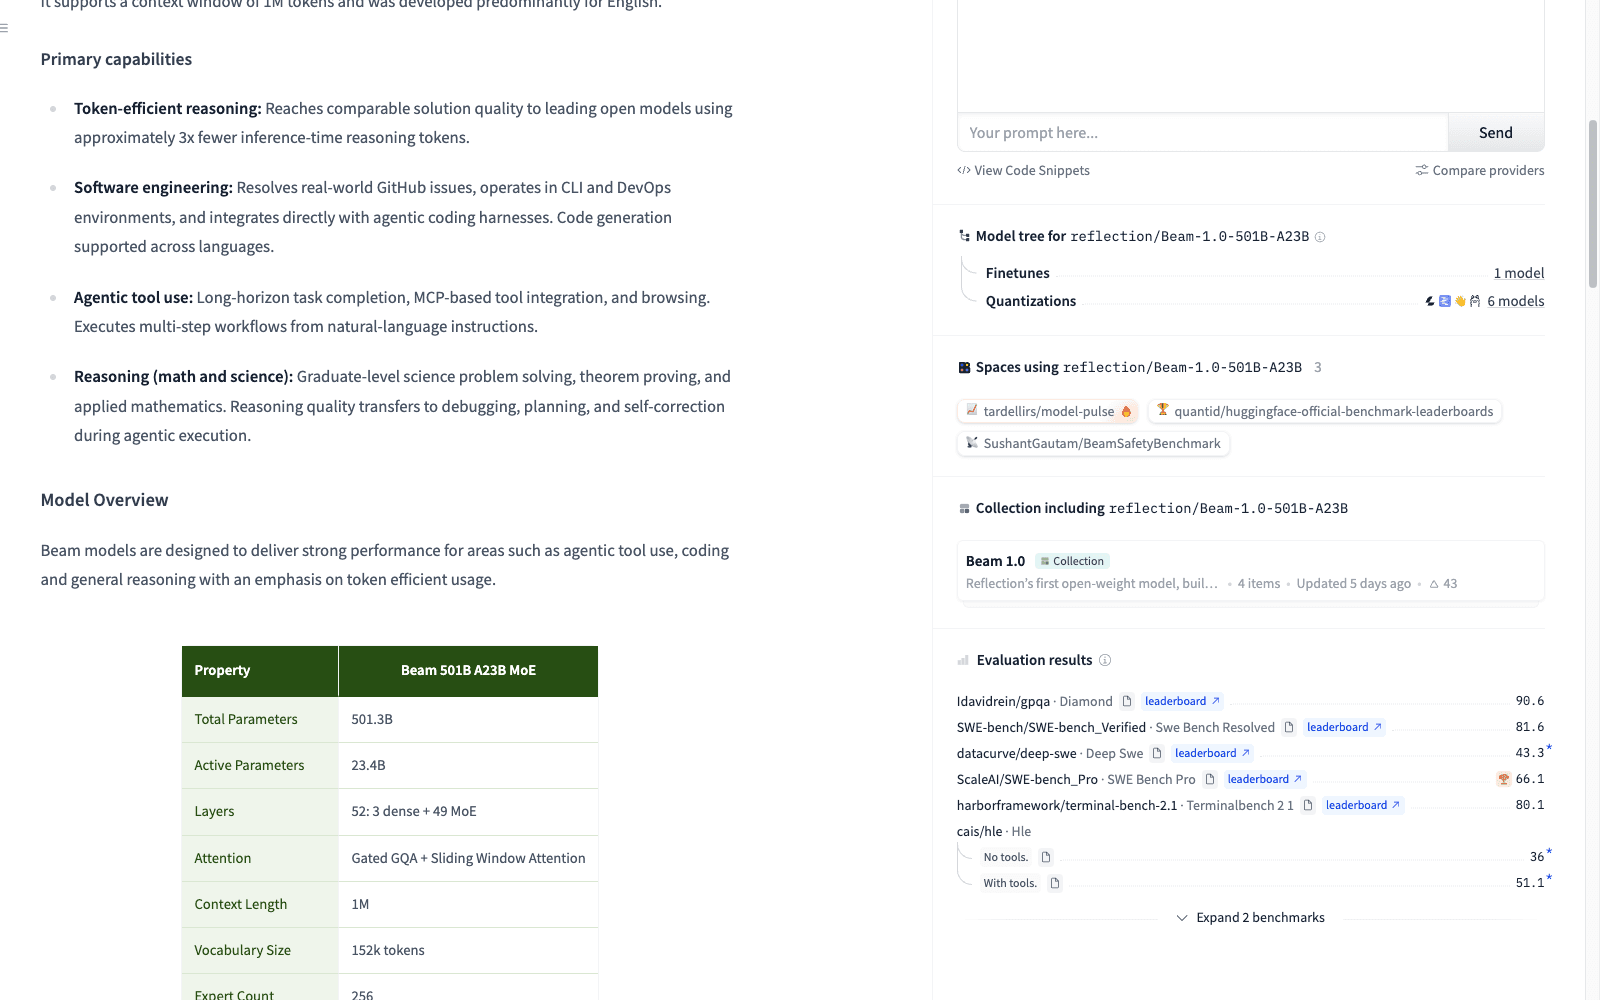
Cómo compararlo con DeepSeek, Qwen y Mistral
Hay que comparar checkpoints concretos. DeepSeek-V4.1-Flash es un candidato grande cuya ficha indica MIT y entrada multimodal. Nuestra explicación de DeepSeek V4.1 Flash trata su propia arquitectura; sus resultados no se trasladan a Beam.
Qwen3-Coder-30B-A3B-Instruct documenta 30.5B parámetros totales, 3.3B activos, Apache 2.0 y contexto nativo de 256K. Se elige un checkpoint anterior para ilustrar otra escala de despliegue, no para presentarlo como el modelo insignia actual. Qwen3.8 Max es otro producto.
Devstral Small 2 24B, de Mistral, aporta pesos Apache 2.0 e integración documentada con Mistral Vibe. Su menor tamaño total plantea una decisión de capacidad diferente. La licencia de este checkpoint no describe todos los modelos de Mistral.
La elección real es entre controlar un modelo grande, desplegar uno más pequeño o conservar un endpoint que ya funciona. Mezclar puntuaciones de fichas incompatibles no resuelve esa decisión. En agentes también importan las herramientas, los reintentos, la gestión del contexto y los permisos. La integración de DeepSeek Harness con el navegador ilustra esa separación, sin demostrar una integración equivalente de Beam o Mirror. La guía de razonamiento agéntico explica por qué la respuesta final no basta para evaluar el sistema.
Un uso práctico de Tabbit: reunir las fuentes del lanzamiento
Una presentación temprana, una ficha actualizada y un tutorial de despliegue pueden parecer contradictorios si se ignoran sus fechas. El flujo de trabajo de Tabbit permite usar páginas relacionadas como contexto para el análisis.
Abra ambos anuncios, la ficha y la guía. Pida un inventario fechado con URL por fila y columnas separadas para lo publicado y lo prometido. Las notas oficiales de v1.13 documentan Tabbit CLI para agentes de código externos; la configuración y disponibilidad regional requieren comprobación.
Es un flujo de investigación propuesto, no una prueba de Beam dentro de Tabbit. Leer una ficha no ejecuta el checkpoint ni valida sus resultados. Mantenga la ejecución de código en un harness adecuado. La guía del navegador agéntico aclara el papel del navegador.
Qué demuestra el lanzamiento y qué debe medir una evaluación
Las pruebas verifican que los pesos y varias herramientas son públicos. No establecen que Beam sea el más rápido o barato para su trabajo. Menos tokens generados no garantizan una factura total menor.
Coste por tarea aceptada = coste total de las ejecuciones / tareas aprobadasIncluya intentos fallidos, herramientas, capacidad inactiva y revisión humana cuando corresponda. Mantenga fijos la revisión del repositorio, tareas, harness, precisión, presupuesto de razonamiento y tiempo máximo. Compruebe si el parche supera las pruebas, si el agente se recupera de errores y cuánto trabajo humano falta. Un piloto acotado es útil sin convertirse en un benchmark general.
Quién debería probar Beam ahora
| Restricción | Primer paso razonable | Qué comprobar antes de invertir |
|---|---|---|
| Controlar un modelo grande de programación | Evaluar un endpoint documentado y después un piloto propio | Calidad, capacidad y responsabilidad operativa |
| Una estación de trabajo modesta | Comparar checkpoints menores de Qwen o Devstral | Pesos completos y latencia aceptable |
| DeepSeek o Qwen ya funcionan bien | Añadir Beam a las mismas tareas y harness | Mejora suficiente para justificar migración |
| Personalizar un dominio | Revisar recetas disponibles de ajuste fino y RL | Coste de cálculo, datos y evaluación |
| Entender la noticia | Contrastar anuncio y ficha | Artefactos presentes frente a compromisos futuros |
Beam merece evaluación porque añade un modelo descargable y herramientas de agente inspeccionables. Ofrece opciones para quienes necesitan controlar el despliegue o personalizarlo. La migración debe depender de un piloto satisfactorio.
El siguiente paso puede ser pequeño: una tarea representativa, criterios de aceptación y su solución actual como referencia. Para comprobar fuentes, Tabbit puede ayudar con la lectura. Para servir 501B parámetros, empiece por la guía de inferencia y el presupuesto de hardware.

Preguntas frecuentes
¿Cuándo se publicaron los pesos de Reflection Beam?
Reflection presentó Beam el 5 de octubre de 2026 y publicó sus pesos el 16. El segundo anuncio confirma Apache 2.0, Hugging Face y las integraciones de despliegue y agentes.
¿Beam es de código abierto o de pesos abiertos?
La descripción precisa es un modelo de pesos abiertos Apache 2.0 con herramientas de código abierto, como Mirror. No demuestra que estén publicados el corpus completo y una cadena de entrenamiento íntegramente reproducible; el informe técnico todavía figura como pendiente.
¿Basta una GPU de 24 GB porque solo activa 23B parámetros?
Los parámetros activos describen el cálculo por token, no el tamaño completo. Hugging Face sitúa los pesos BF16 en aproximadamente 1 TB y NVFP4 en unos 280 GB; descargar pesos a RAM o disco cambia el rendimiento, pero no elimina el resto del modelo.
¿Es mejor que DeepSeek, Qwen o Mistral?
Este artículo no establece un ganador universal. Compare checkpoints concretos con las mismas tareas, harness, precisión y presupuesto; modelos menores de Qwen o Mistral pueden resultar más prácticos con capacidad limitada.
¿Es el mismo Beam que Apache Beam o beam search?
No. Aquí se trata del modelo de Reflection identificado por reflection/Beam-1.0-501B-A23B. Apache Beam procesa datos y beam search es un método de decodificación.
¿Se puede elegir Beam en Tabbit Browser?
Este artículo no confirma su disponibilidad en el selector de Tabbit. Tabbit puede ayudar a contrastar fuentes; ejecutar Beam requiere un endpoint y un harness adecuados.