
GLM-5.2 是智谱于 2026 年 6 月 16 日发布的开放权重长程编码模型。关键不只是“753B”: GLM-5.2 模型页、本地权重、智谱 API、第三方别名和 Tabbit Browser 是不同路线,限制与账单也不同。
决策锚点是容量与证据的边界。一手模型卡描述 1M token 上下文;一份社区盲测则记录了约 4.42M 编码 token、约 1.73 美元的单次运行。这不是统一价格。比较时请先固定模型 ID 和路线,再查看智谱开发文档以及 GLM-5.3 的后续版本边界。
关键结论
GLM-5.2 于 2026-06-16 发布;模型卡列出 753B 参数和 MIT 许可。
1M 上下文是主要卖点,但不代表每个客户端或提供商都接受 1M token。
CAISI 与 Semgrep 提供带日期、任务和 harness 的独立证据,不能外推为所有部署的保证。
社区材料包括 React Native 评审、Pydantic Agent 任务和 VPS 盲评,规模都很小。
API、显卡与量化成本、第三方路由、编码套餐和 Tabbit 是不同产品。
规格与路线
提示词资源和评测资源只保存模型专属材料,不能证明你的提供商或 Tabbit 账户提供相同路线。
| 项目 | 当前证据 | 边界 |
|---|---|---|
| 发布 | 2026-06-16 | 发布日期不等于账户权限。 |
| 模型 | zai-org/GLM-5.2,753B 文本生成 | 量化、硬件和服务栈会改变表现。 |
| 上下文 | 一手模型卡称 1M token | 客户端和提供商可能降低有效窗口。 |
| 许可 | 模型卡为 MIT | 部署仍需硬件、软件和安全控制。 |
| 模态 | 文本生成 | 不要从编码结果推断图像输入能力。 |
评测与获取
CAISI 2026-07-08 的评估给出 ExploitBench 21.4、CTF Archive Diamond 39.3、SWE-Bench Verified 75.3 和 GPQA Diamond 91.4 等结果;Semgrep 在固定 IDOR 数据集和提示词上报告 39% F1,并记录了约 0.17 美元/漏洞。它们各自的测试集、日期和 harness 必须随数字保留。
社区实验更适合设计试点:同一开发者在 Code/Design/Game 任务上记录了 token、价格、修复次数和耗时;React Native 评审发现孤立 i18n key 和不可达分支;VPS 盲评报告 25/25,但只有一个项目和外部 Qwen 评审者。把这些当作场景线索,不当作总体排名。
| 路线 | 提供什么 | 不能证明什么 |
|---|---|---|
| 智谱 API | 托管模型 ID、路由和带日期的计费表 | 本地权重或 Tabbit 有相同限制。 |
| MIT 权重 | 自己选择服务栈和硬件 | 免费推理、轻松实现 1M 或相同工具行为。 |
| 第三方提供商 | 自己的别名、额度和数据政策 | 价格等于智谱官方路线。 |
| Tabbit Browser | 可能提供实时模型选择器 | 智谱 API 额度或稳定可用性。 |
场景自检与结论
用只读分支做仓库评审,用带标准答案的资料包做长上下文研究,用可丢弃工作区、测试和调用上限做智能体修复。记录日期模型 ID、实际接受的上下文、token、工具、重试、耗时和验收结果。安全分析只用授权的合成样本。
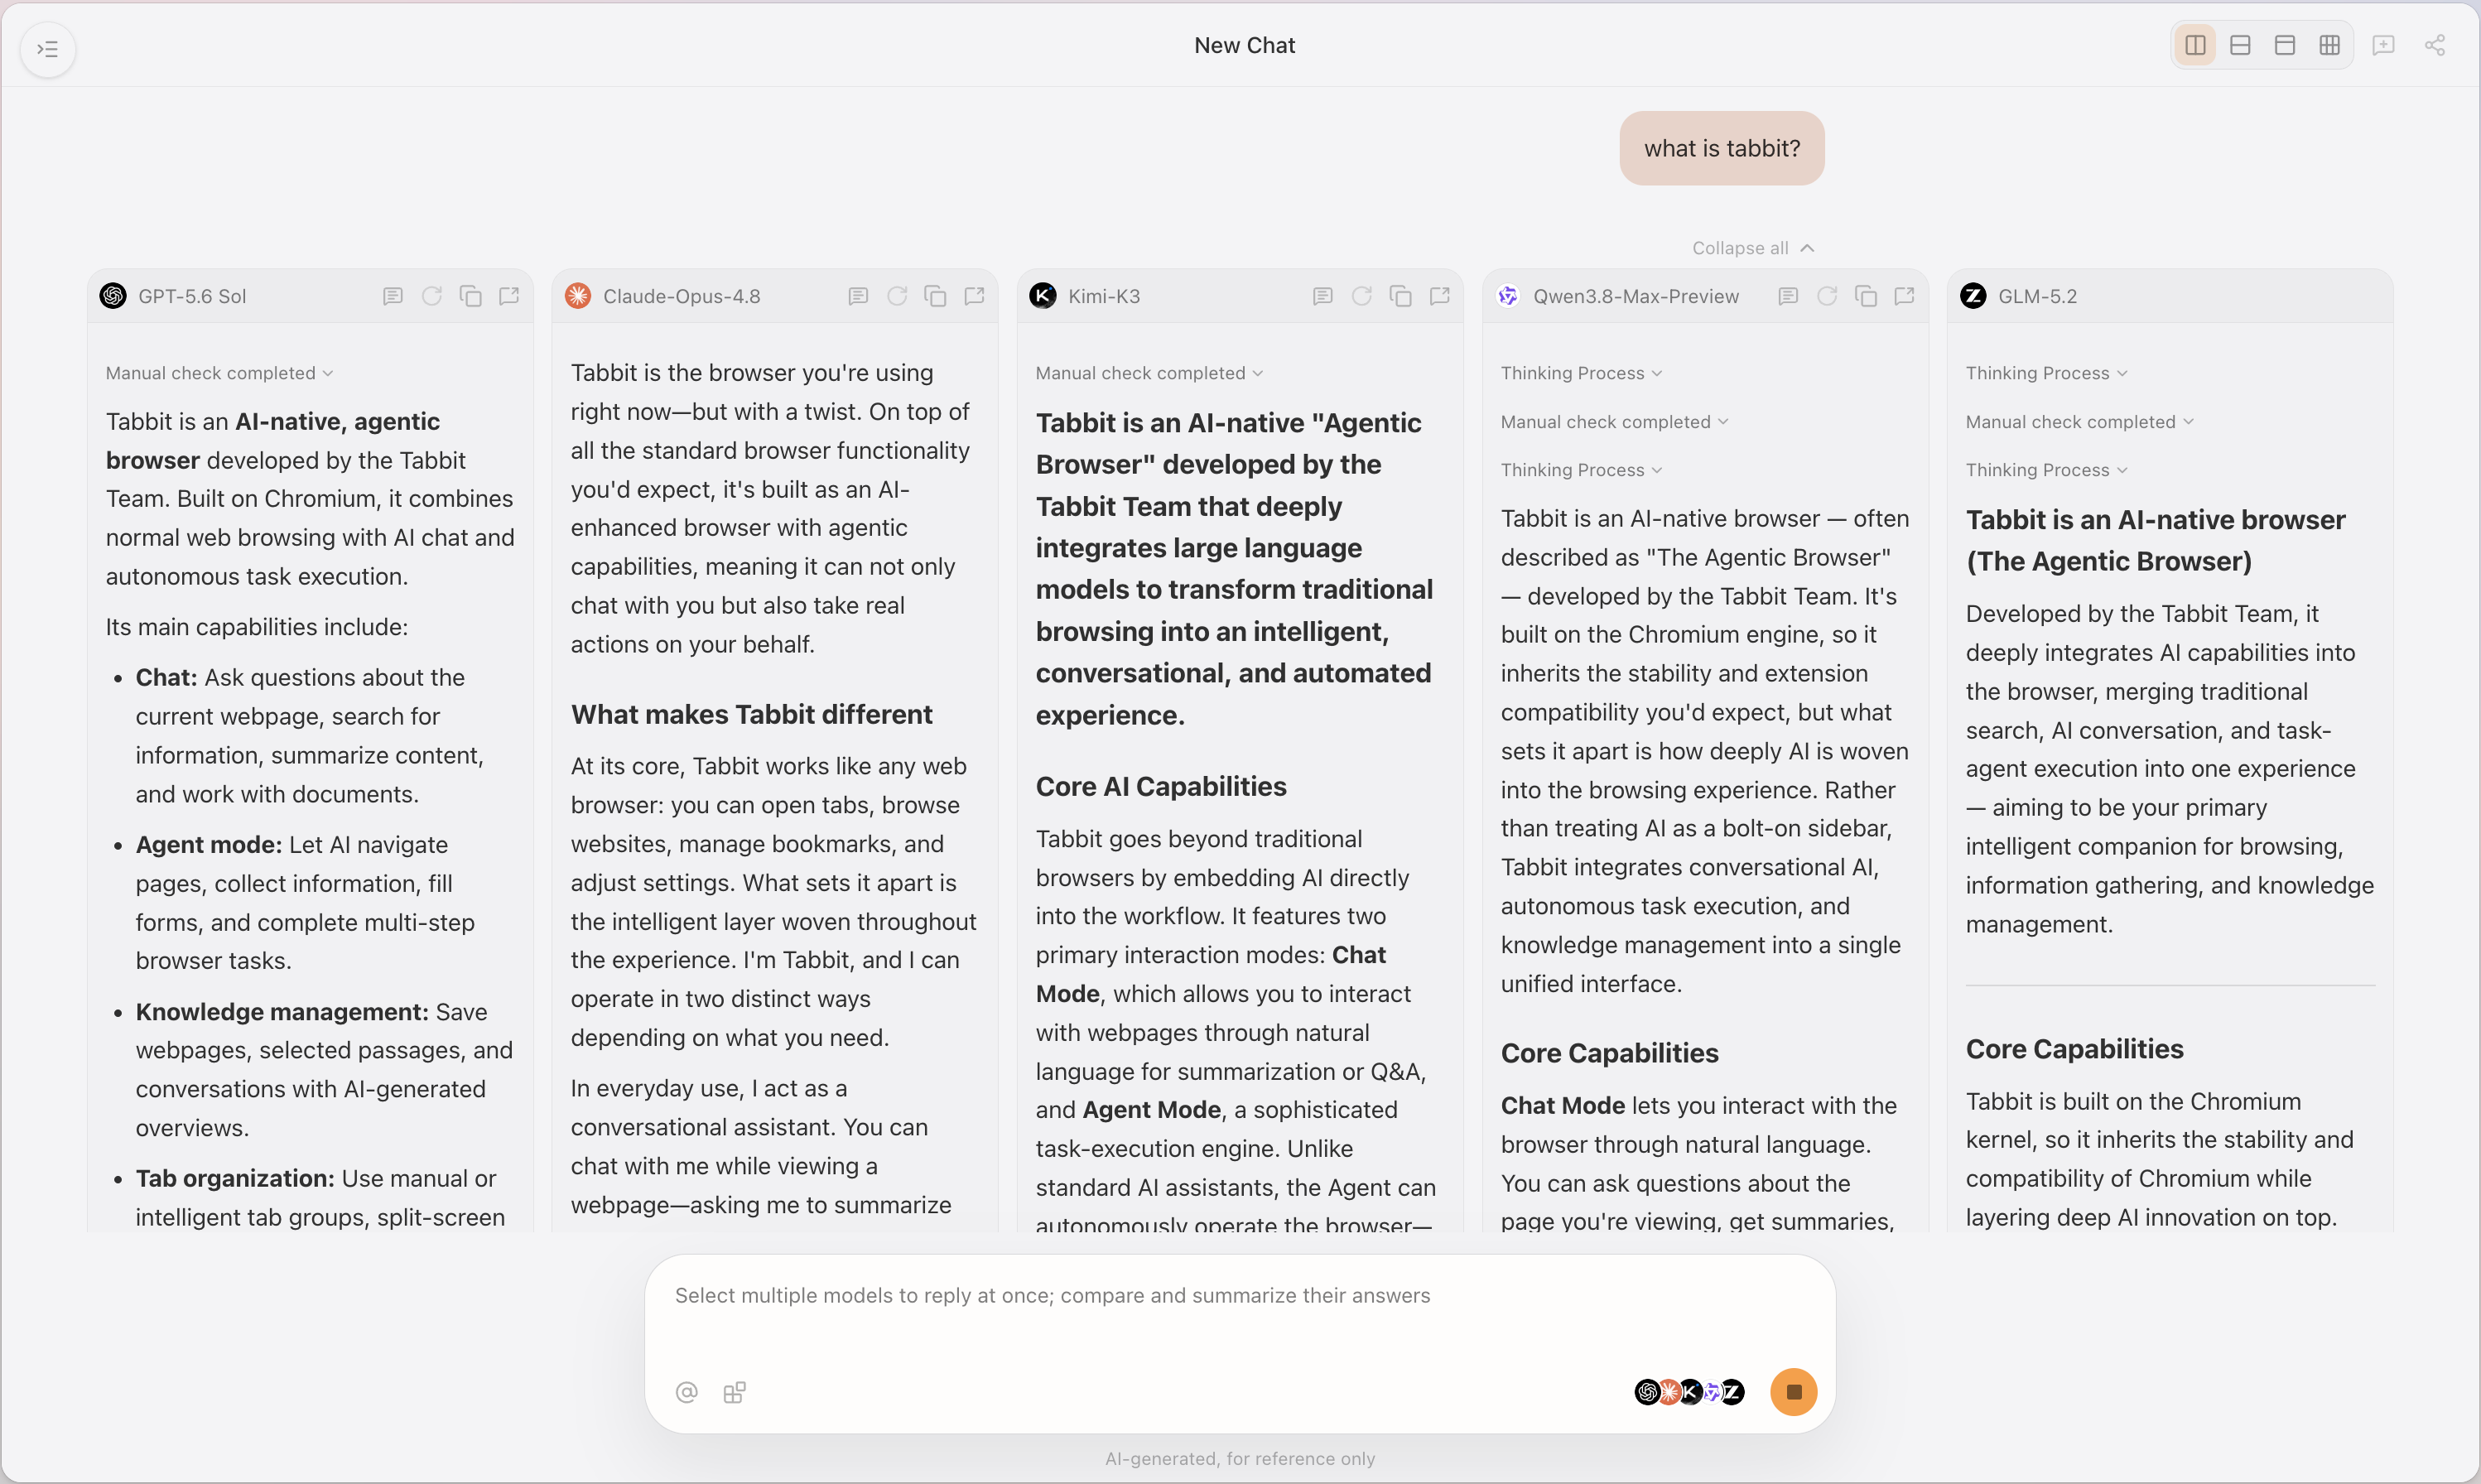
Tabbit Browser是独立浏览器层,不提供智谱 API 额度,也不保证选择器出现 GLM-5.2。本文未完成已登录实测,因此保持草稿。可先看AI 浏览器指南、浏览器自动化指南和GLM-5.2 评测。另可阅读GPT-5.6 Sol 1M 上下文总览与智能体推理指南,但它们不是 GLM-5.2 基准。
 Tabbit Browser
GLM-5.2 值得做受控的长上下文编码或评审试点,但必须锁定路线、保留 harness、限制工具权限。不要把 GLM-5.3、API 价格、本地权重、第三方提供商和 Tabbit 合并成一个结论。
来源与常见问题
主要来源是智谱发布说明、开发文档、模型卡和NIST 评估。独立证据包括CAISI 报告记录与Semgrep 基准。
GLM-5.2 开源吗?
模型卡以 MIT 发布权重,但本地部署仍有硬件和运维成本,API、提供商和 Tabbit 也不因此互通。
每条路线都有 1M 上下文吗?
模型卡有 1M 描述,实际窗口要按权重、客户端、提供商和服务配置验证。
1.73 美元就是价格吗?
不是,它是一次社区盲评的场景成本。发票价格应查看带日期的智谱 API 表。
可以让它自主写代码吗?
先只读评审、窄工具、测试和硬停止;安全评测说明不能把单次分数当作授权。
GLM-5.2 比 GLM-5.3 好吗?
本文不做总排名。两者是不同快照,应在同一固定任务上比较。
能在 Tabbit 使用吗?
本文没有验证登录账户。请检查实时选择器,并把成功视为账户级观察。

常见问题
GLM-5.2 是什么?
GLM-5.2 是智谱于 2026 年 6 月 16 日发布的开放权重长程编码模型。模型卡列出 753B 文本生成权重和 1M token 上下文;本地权重与智谱 API 是不同路线。
GLM-5.2 开源吗?
zai-org/GLM-5.2 模型卡以 MIT 发布权重。开放权重不等于 API、第三方提供商、编码套餐或本地推理免费。
GLM-5.2 有多长上下文?
一手模型卡描述 1M token 上下文,但实际限制还取决于权重、客户端、提供商、提示格式和服务配置。
GLM-5.2 怎么收费?
发票级价格应以带日期的智谱 API 表为准;社区运行成本和第三方标准化价格只是场景证据,不是统一价格。
GLM-5.2 适合编码智能体吗?
CAISI、Semgrep 和社区报告在明确 harness 下显示出编码潜力,但也有安全与方法限制。请用固定仓库、窄工具、测试和预算试用。
能在 Tabbit Browser 使用 GLM-5.2 吗?
本文没有登录 Tabbit 实测,因此不声称选择器或可用性。请检查实时选择器,并先验证一个可回滚的小任务。