
Los pesos de Inkling 2 Small ya se pueden descargar desde Hugging Face bajo una licencia Apache 2.0. Sin embargo, descargar no basta para ejecutarlos. La ficha oficial exige al menos 500 GB de VRAM agregada para inferencia local con NVFP4 y 800 GB para MXFP8. Si no tienes un clúster GPU así, una API alojada suele ser más realista. Consulta la actualización de Thinking Machines y la ficha oficial.
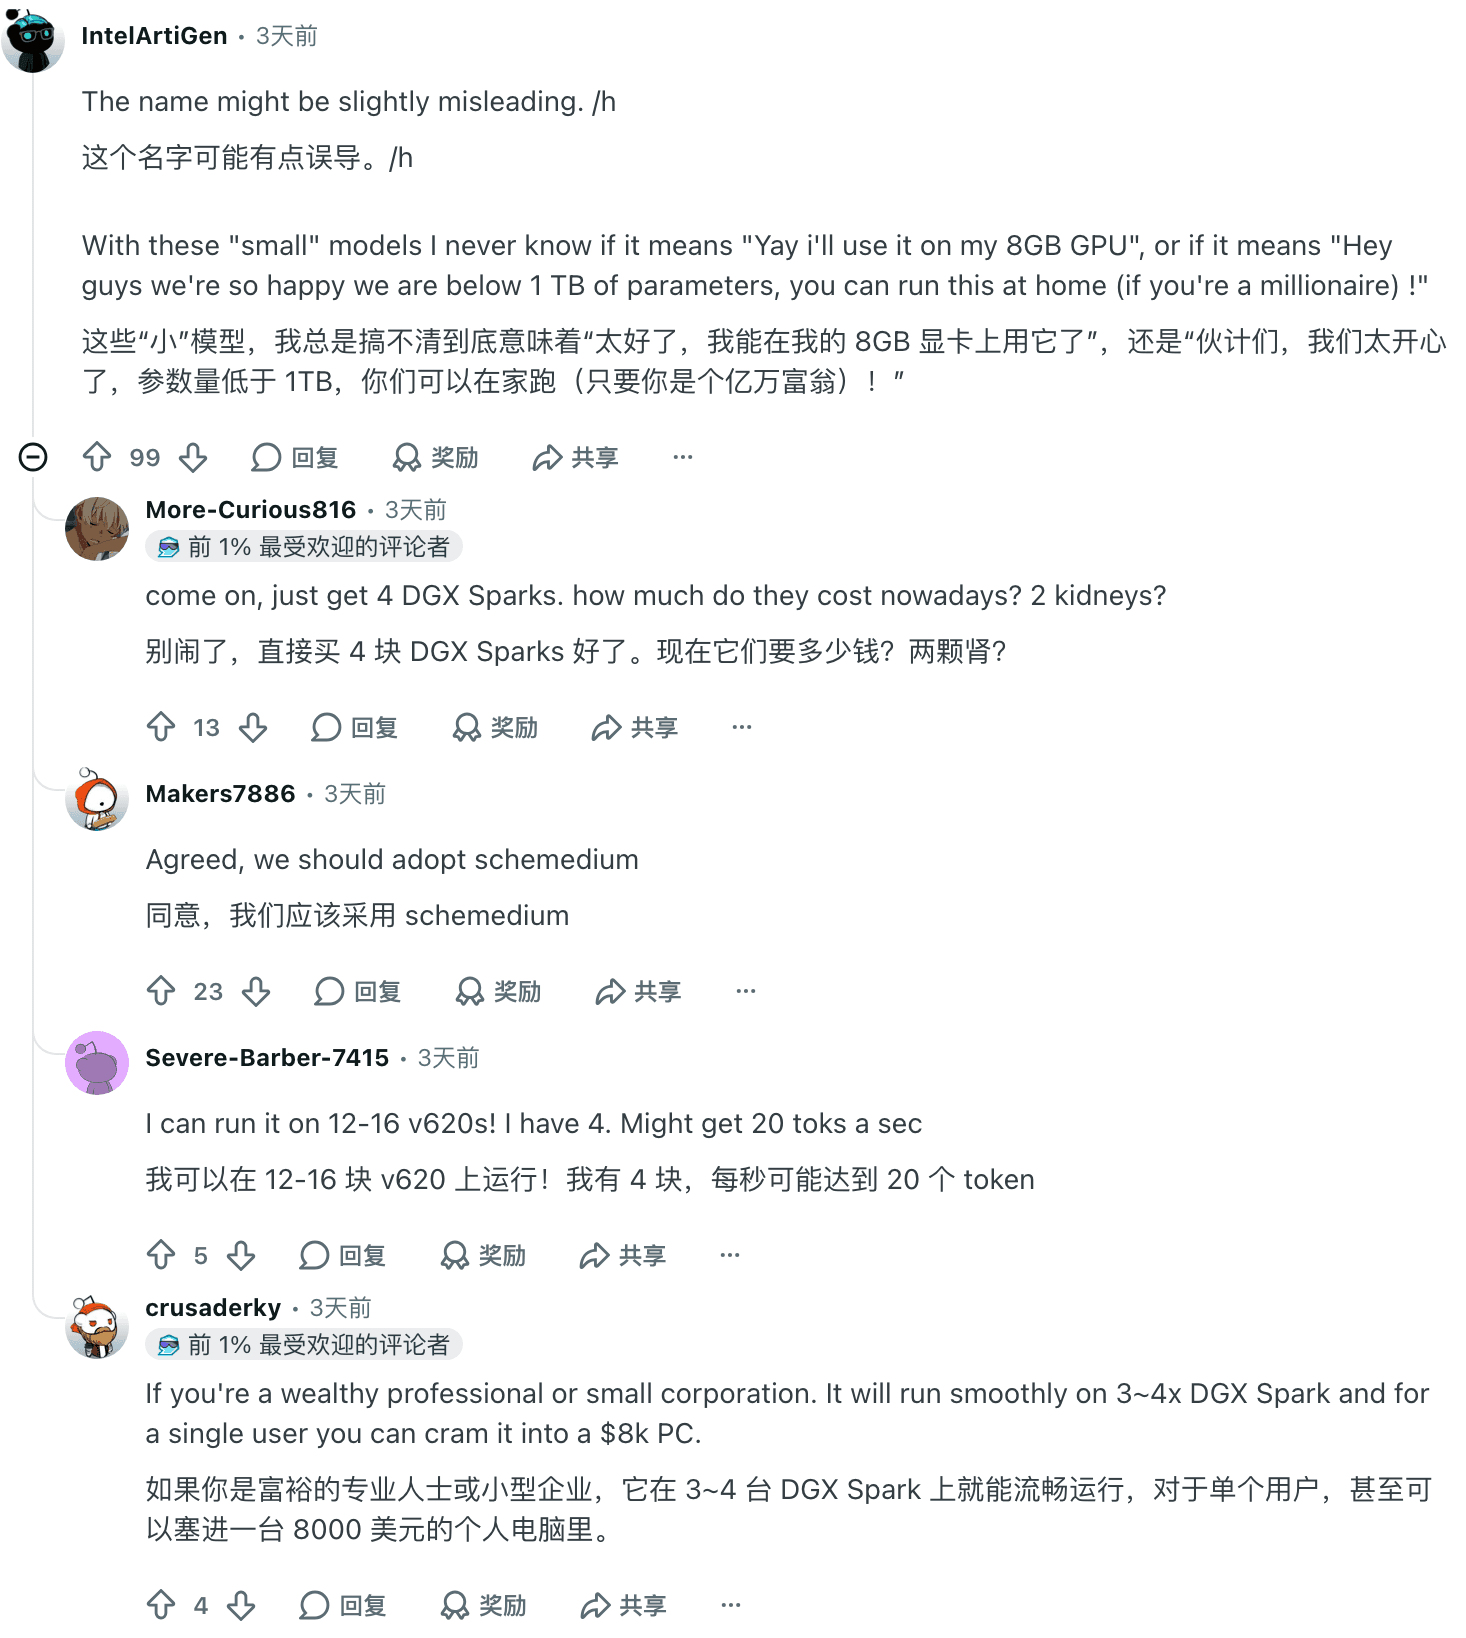
En Reddit, una persona preguntó si un modelo llamado "Small" cabría en una GPU de 8 GB. Conviene aclararlo antes de descargar cientos de gigabytes de archivos. "Pesos abiertos" habla del acceso a los parámetros, no de que un PC habitual pueda servir el modelo. Comentario original.
Puntos clave
Thinking Machines anunció que los pesos estarían disponibles el 12 de noviembre de 2026 tras pruebas externas de seguridad. Hugging Face muestra Apache 2.0.
Pesos abiertos no significa que los datos o todo el proceso de entrenamiento sean abiertos. Lee también la política de uso aceptable.
La ficha oficial fija 500 GB de VRAM agregada para NVFP4 y 800 GB para MXFP8. Los 17B activos no son una estimación de memoria para un PC.
La inferencia local necesita un framework de servicio. Una API aloja el modelo, pero cada proveedor fija precio, ID, disponibilidad y política de datos.
Tabbit Browser no aloja modelos. Puede conectar el navegador si el agente elegido admite su CLI o skill.
Opciones de acceso a Inkling 2 Small
| Ruta | Qué obtienes | Qué verificar | Conviene si |
|---|---|---|---|
| Descargar los pesos de Hugging Face | Archivos para desplegar o adaptar por tu cuenta. | Apache 2.0, la AUP, el checkpoint, capacidad GPU y soporte del framework. | Controlas la infraestructura y gestionarás la inferencia. |
| Usar una API | Inferencia alojada en el proveedor. | ID vigente, precio, región, límites, herramientas, retención y términos. | No quieres operar un clúster GPU grande. |
| Usar Tinker | Plataforma de Thinking Machines para muestreo y ajuste fino. | Acceso actual, términos, modos disponibles y precio. | Quieres el flujo de entrenamiento o acceso alojado de Tinker. |
Son rutas distintas. Una descarga es un conjunto de archivos, no un endpoint activo; una API es un servicio alojado, no la prueba de que tengas los pesos; el ajuste fino es otra tarea. Thinking Machines confirma la publicación en Hugging Face y la ficha enumera frameworks locales y proveedores de API. La documentación de Tinker lista el ID de Inkling 2 Small y una variante 256K separada; esos IDs son propios de Tinker. La actualización de lanzamiento nombra otros proveedores. La documentación de Cloudflare muestra una ruta concreta y dice que requiere acceso de pago. Este artículo no cita precios en tiempo real ni llama a una API de pago.
Qué cubre Apache 2.0
Hugging Face marca la licencia como apache-2.0 y enlaza la política de uso aceptable del modelo de Thinking Machines. La empresa dice que la política se aplica al acceso y uso de los pesos, parámetros y materiales asociados. Antes de integrar el modelo en un producto, lee los dos documentos. La etiqueta de la licencia por sí sola no resuelve todos los requisitos.
"Pesos abiertos" es una descripción más precisa que "código abierto total". Los parámetros se pueden descargar según los términos indicados, pero eso no demuestra que sean públicos los datos de entrenamiento, el código de entrenamiento o todo el proceso de desarrollo. La licencia de los pesos tampoco fija el precio o el uso de datos de una API externa.
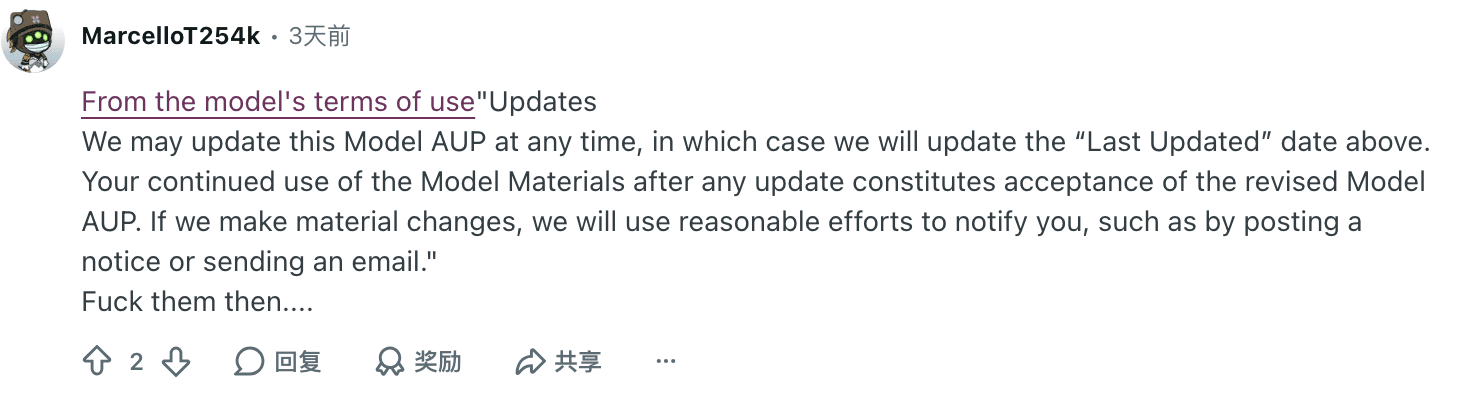
Un comentarista citó la cláusula de actualización de la AUP. Tómalo como recordatorio para consultar el texto vigente, no una captura o resumen. La página de la política indicaba fecha de actualización del 15 de julio de 2026 cuando se revisó el 16 de noviembre. Comentario original.
La inferencia local requiere un clúster GPU grande
La ficha describe un modelo de 594.000 millones de parámetros totales y 17.000 millones activos. "Activos" se refiere a la parte MoE que se usa para cada token, no a una versión reducida que pueda cargarse en un PC común. Usa los requisitos de checkpoint publicados para planificar.
| Checkpoint | VRAM agregada indicada por el editor | Ejemplos de la ficha | Orientación del editor |
|---|---|---|---|
| NVFP4 | Al menos 500 GB | 2 NVIDIA B300 o 4 H200 | Recomendado por Thinking Machines; el modelo se entrenó en NVFP4. |
| MXFP8 | Al menos 800 GB | 4 NVIDIA B300 o 8 H200 | La ficha reporta una mejora de 1–2 puntos en evaluaciones, que considera irrelevante en la práctica. |
Son requisitos y ejemplos del editor, no resultados medidos aquí. Se refieren a VRAM total de GPU, no a RAM del sistema. Una sola tarjeta de 8 GB queda muy lejos de esas configuraciones. En r/LocalLLaMA alguien preguntó cuándo habría una versión GGUF. La pregunta no demuestra si ese formato ya existe o no. Comentario original.
La ficha enumera SGLang, vLLM, TokenSpeed, Unsloth y Hugging Face para inferencia local. Antes de descargar, revisa si la receta vigente del framework admite el checkpoint, el hardware y las versiones que tienes. Thinking Machines recomienda NVFP4, pero no afirma que todos los frameworks tengan los mismos pasos o rendimiento.
Cuándo conviene una API
Si no tienes un servidor multi-GPU, compara primero las API alojadas. Thinking Machines enumera NVIDIA, Fireworks, Together, Baseten, Nebius, Modal y Cloudflare. La documentación de Cloudflare identifica el modelo como @cf/thinkingmachines/inkling-2-small, muestra endpoints de Workers y compatibles con OpenAI, y señala que se requiere acceso de pago. Esto demuestra una ruta de Cloudflare, no los precios o términos de los demás.
Antes de integrar una aplicación, verifica disponibilidad para tu región y cuenta, ID y formato de API, precio y límites, tratamiento de prompts e imágenes y compatibilidad con las herramientas o modalidades necesarias. No supongas que la API es gratis porque los pesos se puedan descargar.
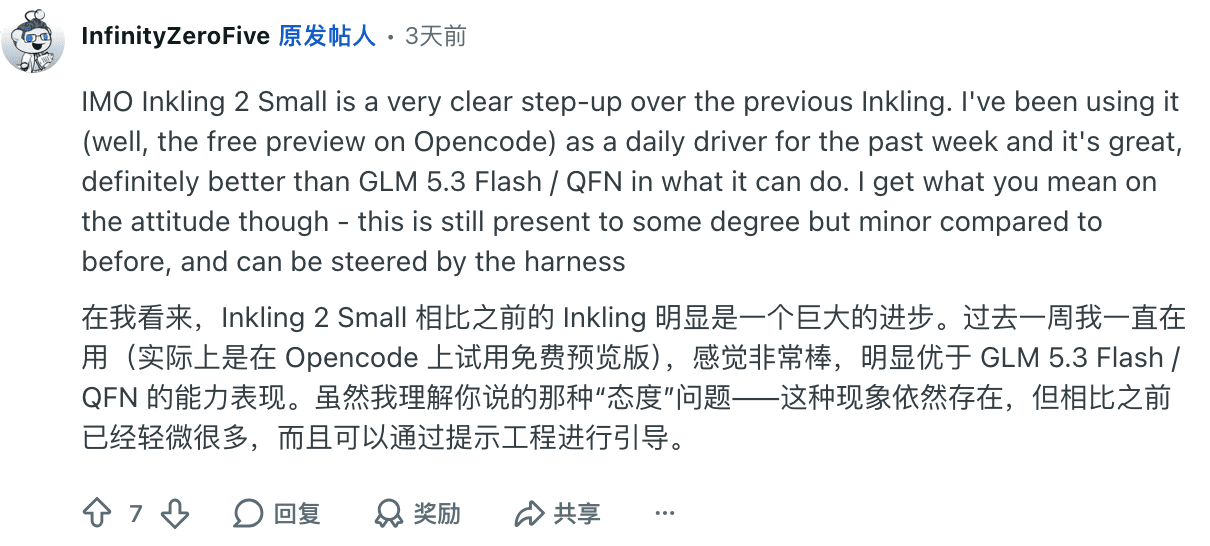
Un usuario de Reddit contó que usó la vista previa gratuita de Inkling 2 Small en OpenCode. Es una anécdota sobre una ruta alojada, no una prueba de inferencia local ni de disponibilidad actual. Comentario original.
Elige una ruta antes de descargar
Lee los términos vigentes. Comprueba Apache 2.0 y la AUP. Si tu empresa tiene un proceso de aprobación, envía ambos documentos.
Decide si necesitas autoalojamiento. Compara la VRAM publicada con tus GPU y el framework. Si no tienes capacidad suficiente, compara primero una API.
Elige juntos el checkpoint y el runtime. Confirma que la receta admite el formato elegido.
Calcula el coste completo. En local, considera GPU, energía y operaciones. En una API, revisa precio, cuota, región y datos. Este artículo no estima facturas.
Prueba con entradas no sensibles. Registra el modelo y el proveedor exactos y revisa la respuesta antes de conectarlo a producción.
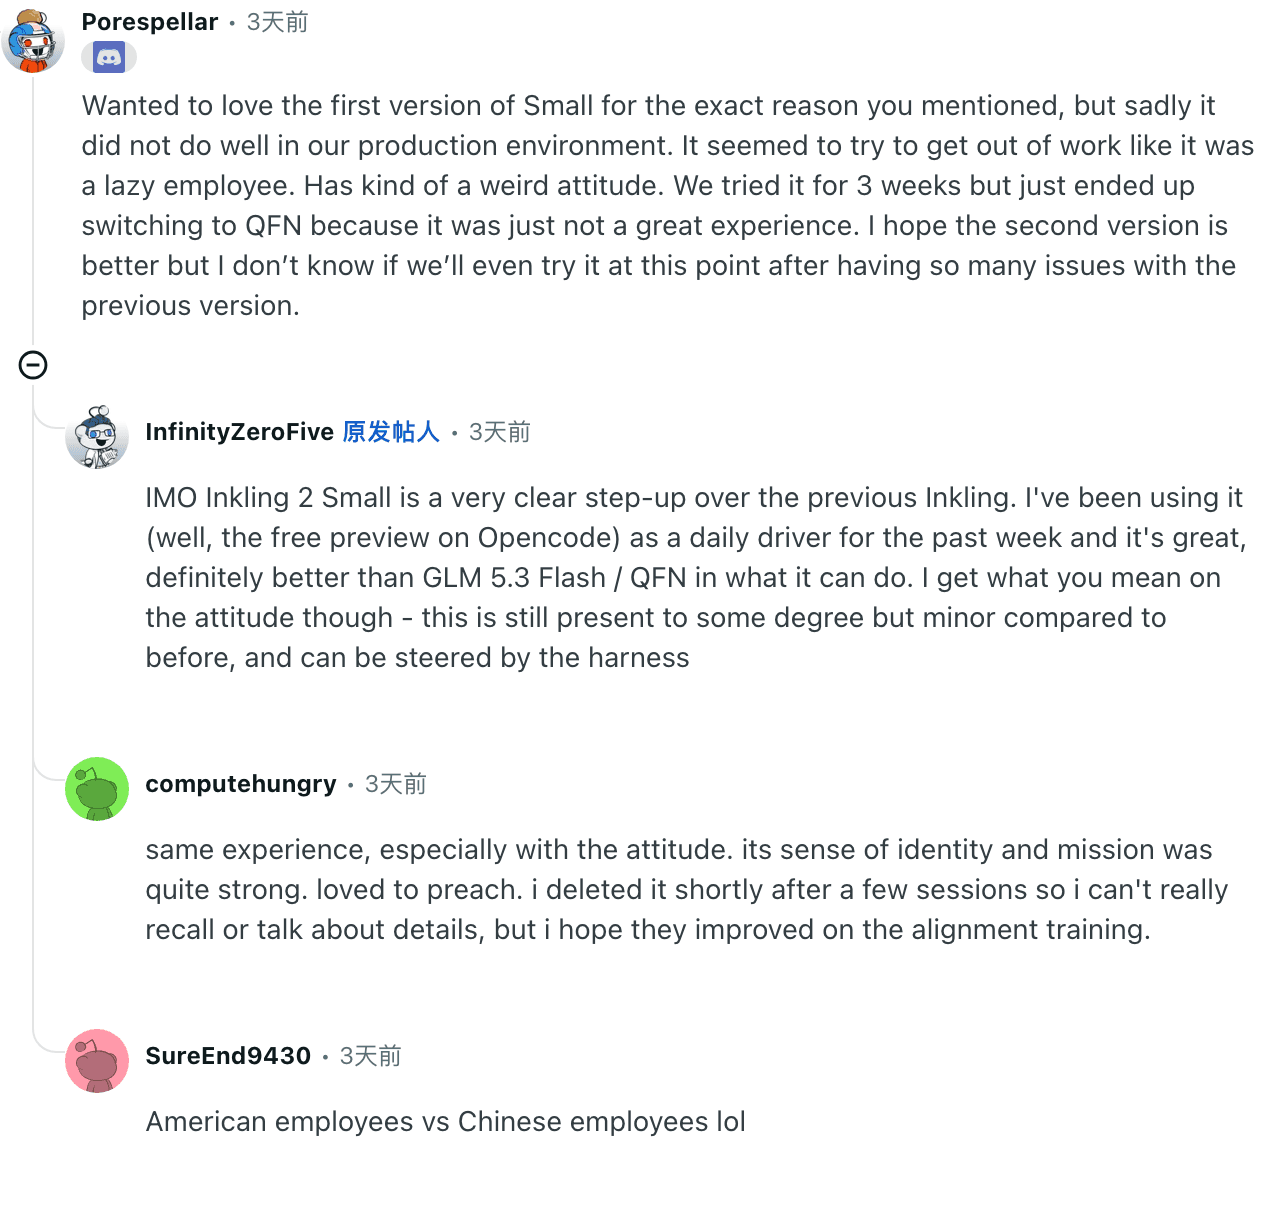
Una persona dijo que el primer Inkling no funcionó bien en su entorno de producción. Otra describió una semana positiva con la vista previa de Inkling 2 Small. Son versiones y condiciones distintas, no una predicción de tu resultado. Experiencia con la primera versión · Experiencia con la vista previa de Inkling 2
El navegador es otra capa
Tabbit Browser puede encargarse del navegador si el agente elegido admite su CLI o skill. No aloja Inkling, carga sus pesos ni ofrece una API. El endpoint del modelo, el agente que lo llama y la conexión al navegador son componentes separados.
Si quieres usar Inkling con un agente en un sitio donde ya iniciaste sesión, la guía de Inkling 2 Small para el navegador explica un flujo de solo lectura con un agente local y Tabbit CLI. Esa guía cubre una ruta alojada y no demuestra que un endpoint local de Inkling funcione con ese cliente. Consulta la guía de Tabbit CLI, el tutorial para conectar un navegador existente, la lista de comprobación para la primera tarea y la comparación entre Browser MCP y CLI.
Tabbit encaja si la tarea necesita una página visible o un perfil con sesión iniciada. No es la capa adecuada para alojar un modelo o descargar pesos. La configuración de Codex y la guía sobre agentes que controlan el navegador explican este límite. Quienes usan OpenCode pueden consultar la configuración de navegador con sesión y la guía para reutilizar una sesión. No se probó una integración de Inkling con Tabbit.
Veredicto: pesos accesibles, requisitos locales altos
Inkling 2 Small tiene pesos descargables con etiqueta Apache 2.0, y su ficha pública enumera varias opciones de inferencia local y API. Pero "abierto" no significa pequeño, barato de operar ni listo para usar. Los requisitos publicados de 500 GB NVFP4 y 800 GB MXFP8 ayudan a resolver la primera pregunta: ¿tienes el servidor o necesitas que un proveedor lo aloje?
Antes de descargar, verifica la licencia y la AUP actuales, elige un checkpoint y framework compatibles, o revisa los términos del proveedor de API. Para automatización del navegador, sigue la guía separada. Tabbit aporta la conexión al navegador; no ejecuta el modelo.

Preguntas frecuentes
¿Inkling 2 Small es de código abierto?
Thinking Machines lo describe como un modelo de pesos abiertos y la ficha de Hugging Face muestra una licencia Apache 2.0. La ficha también enlaza una política de uso aceptable independiente. Esto no demuestra que los datos de entrenamiento, todo el proceso de entrenamiento o cada servicio de proveedores sean de código abierto.
¿Puedo ejecutar Inkling 2 Small en una GPU de escritorio normal?
La ficha oficial indica que el checkpoint NVFP4 necesita al menos 500 GB de VRAM agregada, con 2 B300 o 4 H200 como ejemplos. Para MXFP8 indica 800 GB. Comprueba la ficha actual y tu configuración real antes de planificar una instalación local.
¿Qué checkpoint de Inkling 2 Small debería elegir?
La ficha recomienda NVFP4, el formato usado durante el entrenamiento. Afirma que MXFP8 mejora entre 1 y 2 puntos porcentuales en evaluaciones, una cifra del editor que considera poco relevante en la práctica. MXFP8 exige más hardware, así que compara los requisitos con tu sistema.
¿Puedo usar Inkling 2 Small mediante una API?
Sí. Thinking Machines enumera NVIDIA, Fireworks, Together, Baseten, Nebius, Modal y Cloudflare. El ID del modelo, precio, disponibilidad y tratamiento de datos cambian según el proveedor; verifica su documentación antes de conectar una aplicación.
¿Ejecutar los pesos descargados es gratis?
Un repositorio público y una licencia Apache 2.0 no eliminan los costes de infraestructura. La ejecución local requiere mucha capacidad GPU y una API alojada puede cobrar por uso. Revisa los precios y términos actuales del proveedor elegido.
¿Tabbit Browser aloja o ejecuta Inkling 2 Small?
No. Tabbit gestiona el navegador en flujos compatibles con agentes y CLI; no aloja este modelo ni despliega sus pesos. La ruta del modelo, el agente y la conexión al navegador son decisiones independientes.