
Les poids d’Inkling 2 Small sont téléchargeables sur Hugging Face sous une licence Apache 2.0. Mais le téléchargement ne suffit pas pour exécuter le modèle. La fiche officielle indique un minimum de 500 Go de VRAM agrégée en NVFP4 et 800 Go en MXFP8. Sans un tel cluster GPU, une API hébergée sera généralement plus réaliste. Consultez la mise à jour de Thinking Machines et la fiche officielle.
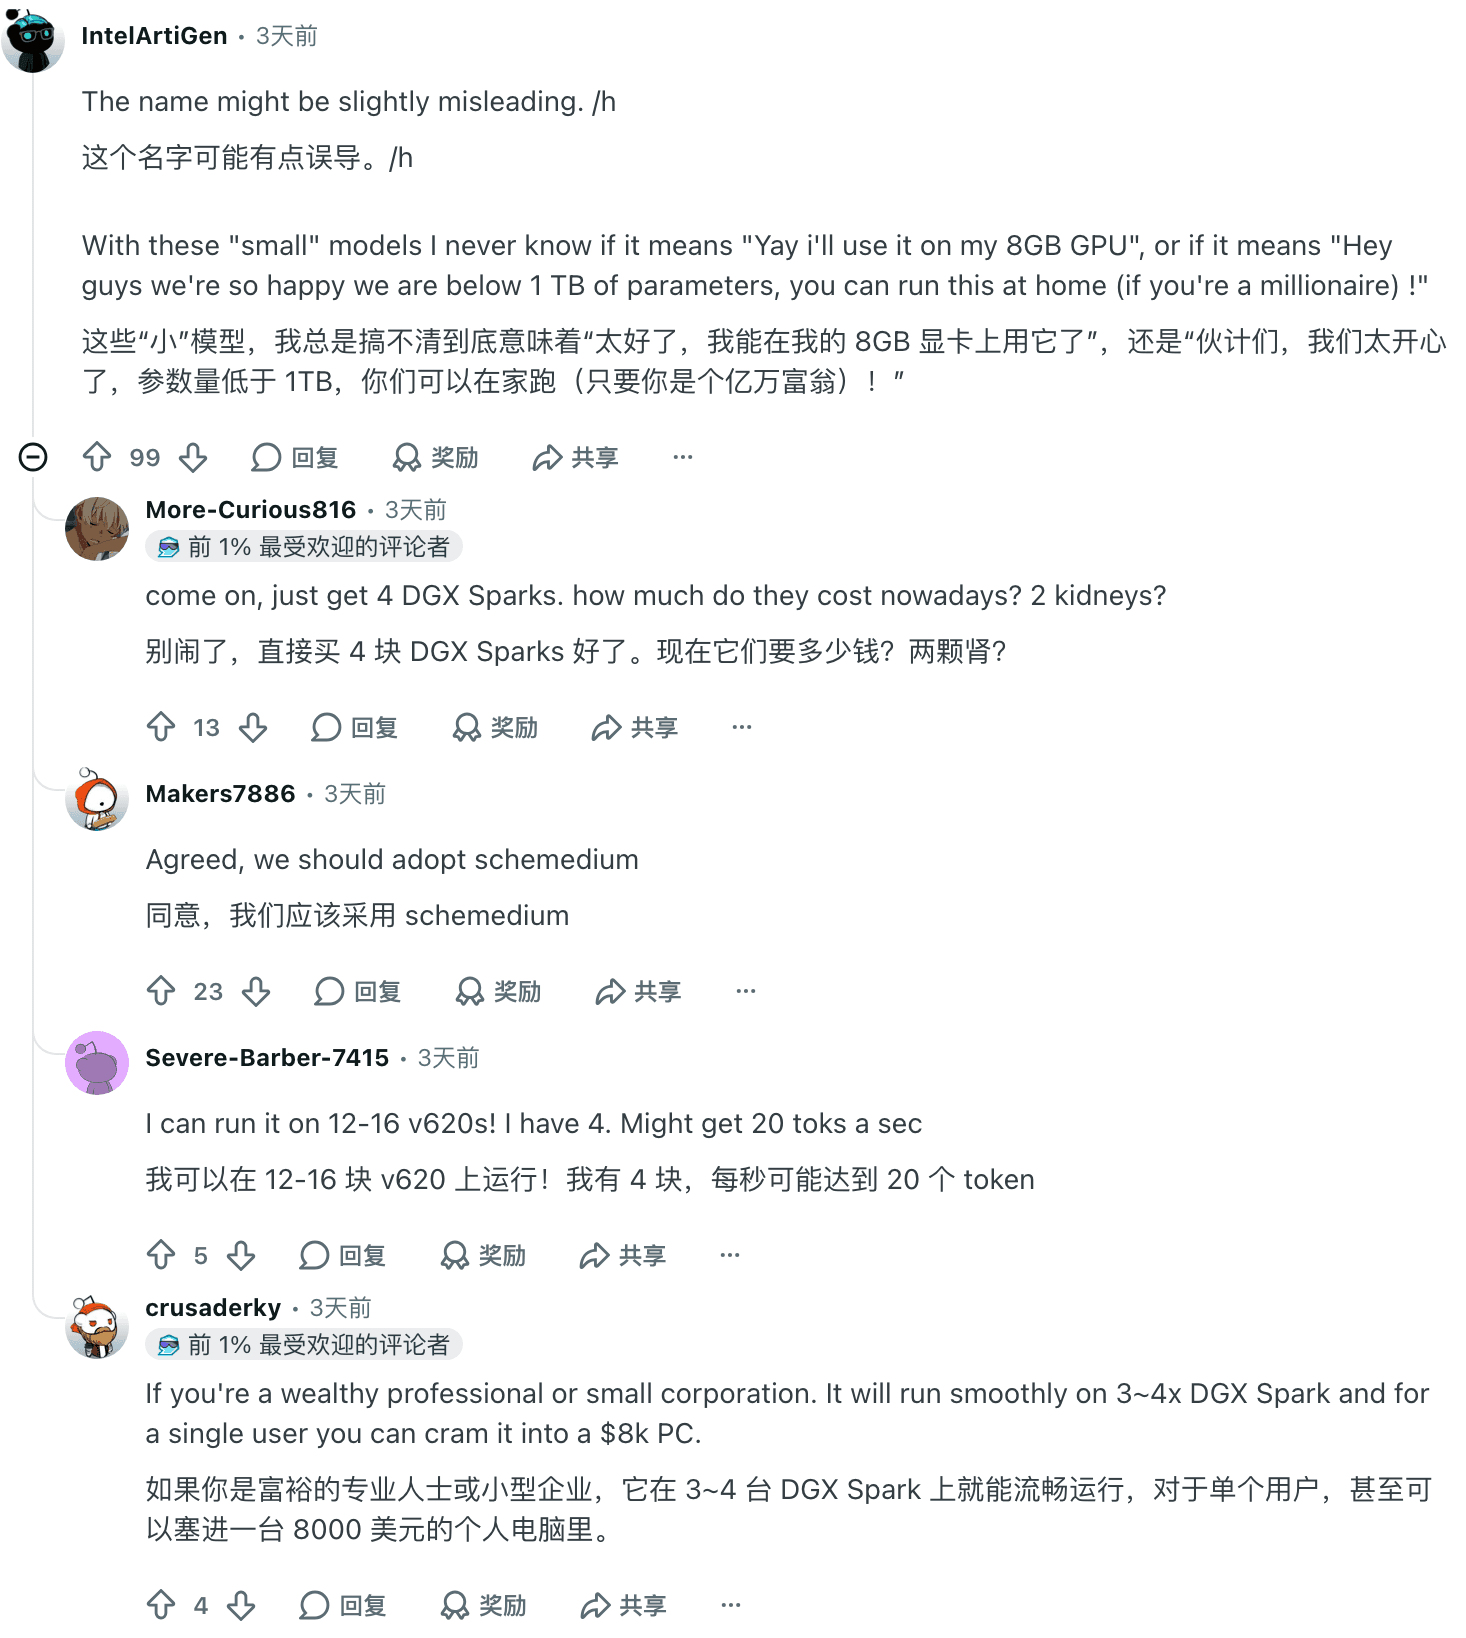
Sur Reddit, un membre se demandait si un modèle nommé « Small » pouvait tenir sur un GPU de 8 Go. Mieux vaut répondre à cette question avant de télécharger des centaines de gigaoctets de fichiers. « Poids ouverts » décrit l’accès aux paramètres, pas la capacité d’un ordinateur classique à servir le modèle. Commentaire original.
À retenir
Thinking Machines indique que les poids sont disponibles depuis le 12 novembre 2026, après des tests de sécurité externes. La fiche Hugging Face porte l’étiquette Apache 2.0.
Des poids ouverts ne signifient pas que les données ou tout le processus d’entraînement sont ouverts. Lisez aussi la politique d’utilisation acceptable.
La fiche officielle demande au moins 500 Go de VRAM agrégée pour NVFP4 et 800 Go pour MXFP8. Les 17B paramètres actifs ne sont pas une estimation pour un PC.
L’inférence locale nécessite un framework. Les API hébergées évitent l’exploitation d’un cluster, mais chaque fournisseur fixe ses prix, identifiants, régions et règles de données.
Tabbit Browser n’héberge pas de modèle. Il peut assurer la connexion au navigateur si l’agent choisi prend en charge son CLI ou son skill.
Les voies d’accès à Inkling 2 Small
| Voie | Ce que vous obtenez | Points à vérifier | À choisir si |
|---|---|---|---|
| Télécharger les poids sur Hugging Face | Fichiers pour gérer l’inférence ou les adapter. | Apache 2.0, AUP séparée, checkpoint, GPU et framework. | Vous gérez l’infrastructure et le service d’inférence. |
| Passer par une API | Inférence hébergée par un fournisseur. | Identifiant actuel, prix, région, limites, outils, conservation et conditions. | Vous ne voulez pas exploiter un grand cluster GPU. |
| Utiliser Tinker | Plateforme de Thinking Machines pour l’échantillonnage et le fine-tuning. | Accès, conditions, modes disponibles et tarifs actuels. | Vous voulez le flux d’entraînement ou l’accès hébergé de Tinker. |
Ces voies sont différentes. Un téléchargement est un ensemble de fichiers, pas une API en cours d’exécution. Une API est un service hébergé, pas la preuve que vous possédez les poids. Le fine-tuning est encore autre chose. Thinking Machines annonce la publication sur Hugging Face et sa fiche cite des frameworks locaux et des fournisseurs d’API. La documentation Tinker répertorie Inkling 2 Small et une variante distincte de 256K ; ses identifiants sont propres à Tinker. La mise à jour de lancement nomme d’autres fournisseurs. La documentation Cloudflare montre un exemple précis et indique qu’un accès payant est requis. Cet article ne cite pas de tarif actuel et n’appelle aucune API payante.
Ce que couvre Apache 2.0
La fiche Hugging Face indique apache-2.0 et renvoie à la politique d’utilisation acceptable du modèle de Thinking Machines. L’entreprise dit que cette politique s’applique à l’accès et à l’utilisation des poids, paramètres et documents associés. Lisez les deux avant d’intégrer le modèle à un produit. L’étiquette de licence ne répond pas à toutes les questions d’usage.
« Poids ouverts » est plus précis que « entièrement open source ». Les paramètres peuvent être téléchargés selon les conditions indiquées. Cela ne prouve pas que les données d’entraînement, le code ou l’ensemble du processus de développement soient publics. La licence des poids ne fixe pas non plus le prix et le traitement des données chez une API tierce.
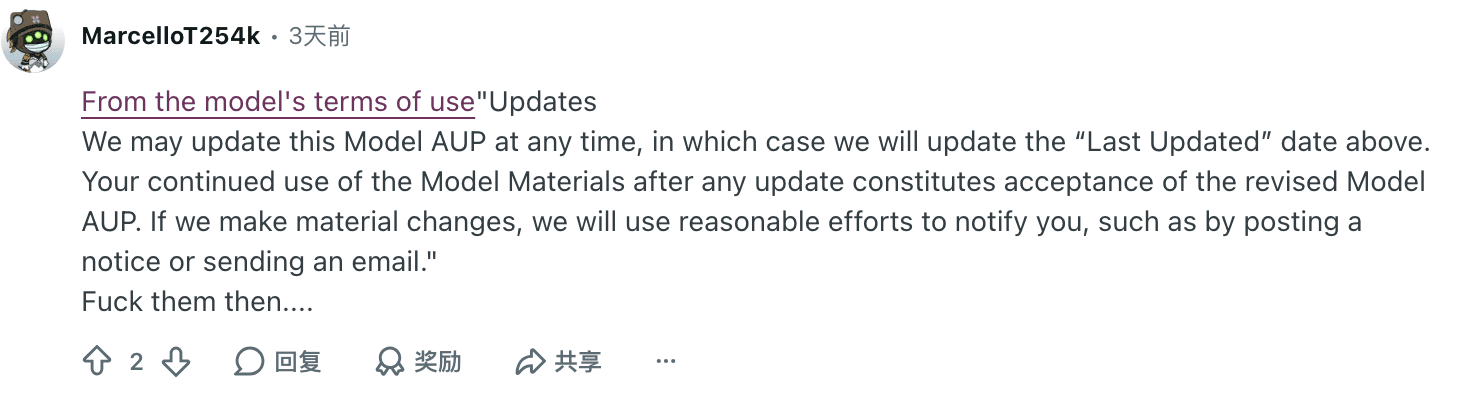
Un commentateur a cité la clause de mise à jour de l’AUP. Servez-vous en comme rappel de lire la politique en vigueur, pas de vous fier à une capture ou à un résumé. La page indiquait une mise à jour au 15 juillet 2026 lors de notre vérification du 16 novembre. Commentaire original.
L’inférence locale demande un grand cluster GPU
La fiche décrit 594 milliards de paramètres au total, dont 17 milliards actifs. « Actifs » désigne la partie MoE utilisée pour chaque token, pas une version de 17 milliards de paramètres prévue pour un PC classique. Pour le déploiement, partez des exigences de checkpoint publiées.
| Checkpoint | VRAM agrégée indiquée par l’éditeur | Exemples de la fiche | Conseil de l’éditeur |
|---|---|---|---|
| NVFP4 | Au moins 500 Go | 2 NVIDIA B300 ou 4 H200 | Recommandé par Thinking Machines ; modèle entraîné en NVFP4. |
| MXFP8 | Au moins 800 Go | 4 NVIDIA B300 ou 8 H200 | Gain de 1 à 2 points sur les évaluations selon l’éditeur, jugé peu utile en pratique. |
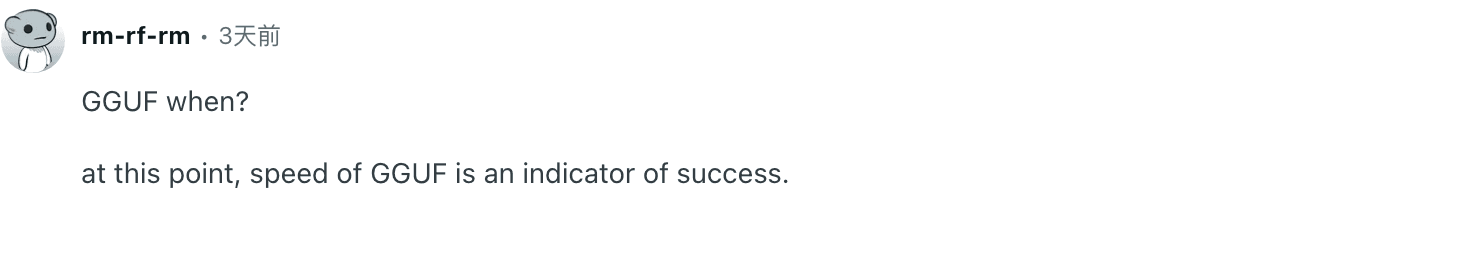
Ce sont les exigences et exemples de l’éditeur, pas les résultats d’un test effectué ici. Il s’agit du total de VRAM GPU, pas de la RAM système. Une carte graphique de 8 Go est loin de ces configurations. Un membre de r/LocalLLaMA demandait quand une version GGUF serait disponible. Cette question ne confirme ni sa présence ni son absence. Commentaire original.
La fiche cite SGLang, vLLM, TokenSpeed, Unsloth et Hugging Face pour l’inférence locale. Avant le téléchargement, vérifiez que la recette actuelle du framework prend en charge le checkpoint, le matériel et les versions que vous avez. Thinking Machines recommande NVFP4, mais ne dit pas que les étapes et performances sont identiques partout.
Quand une API est préférable
Sans serveur multi-GPU, comparez d’abord les API hébergées. Thinking Machines cite NVIDIA, Fireworks, Together, Baseten, Nebius, Modal et Cloudflare. La documentation Cloudflare donne l’identifiant @cf/thinkingmachines/inkling-2-small, montre des points d’accès Workers et compatibles OpenAI, et indique qu’un accès payant est requis. Cela ne fixe pas les tarifs ou conditions des autres fournisseurs.
Avant d’intégrer votre application, vérifiez la disponibilité dans votre région et votre compte, l’identifiant et le format d’API exacts, les limites et le prix, le traitement des prompts et images, ainsi que les outils et modalités pris en charge. Ne supposez pas que l’API est gratuite parce que les poids sont téléchargeables.
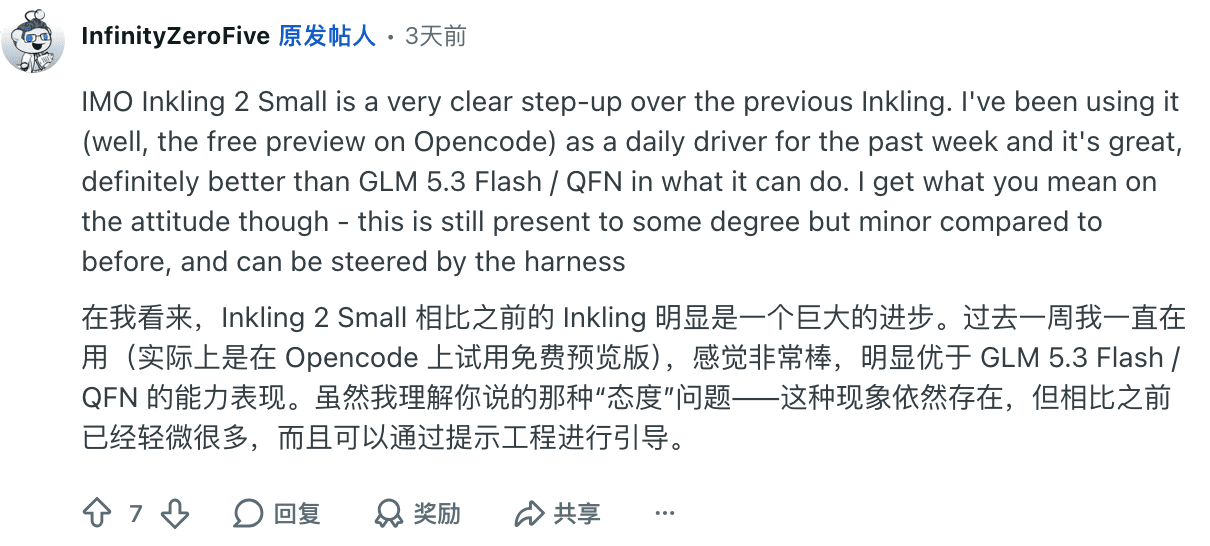
Un membre de Reddit dit avoir utilisé l’aperçu gratuit d’Inkling 2 Small sur OpenCode. C’est un témoignage sur un aperçu hébergé, pas une preuve d’inférence locale ou de disponibilité actuelle. Commentaire original.
Choisir avant de télécharger
Lisez les conditions actuelles. Vérifiez Apache 2.0 et l’AUP. Si votre organisation a un processus d’approbation, soumettez les deux.
Décidez si l’auto-hébergement est nécessaire. Comparez la VRAM publiée à vos GPU et à votre framework. Sinon, commencez par comparer les API.
Choisissez ensemble le checkpoint et le runtime. Confirmez que la recette actuelle accepte le format voulu.
Évaluez le coût complet. En local, comptez GPU, électricité et exploitation. En API, vérifiez tarif, quota, région et données. Cet article ne calcule aucun coût.
Testez avec des entrées non sensibles. Notez le modèle et le fournisseur exacts, puis vérifiez le résultat avant la production.
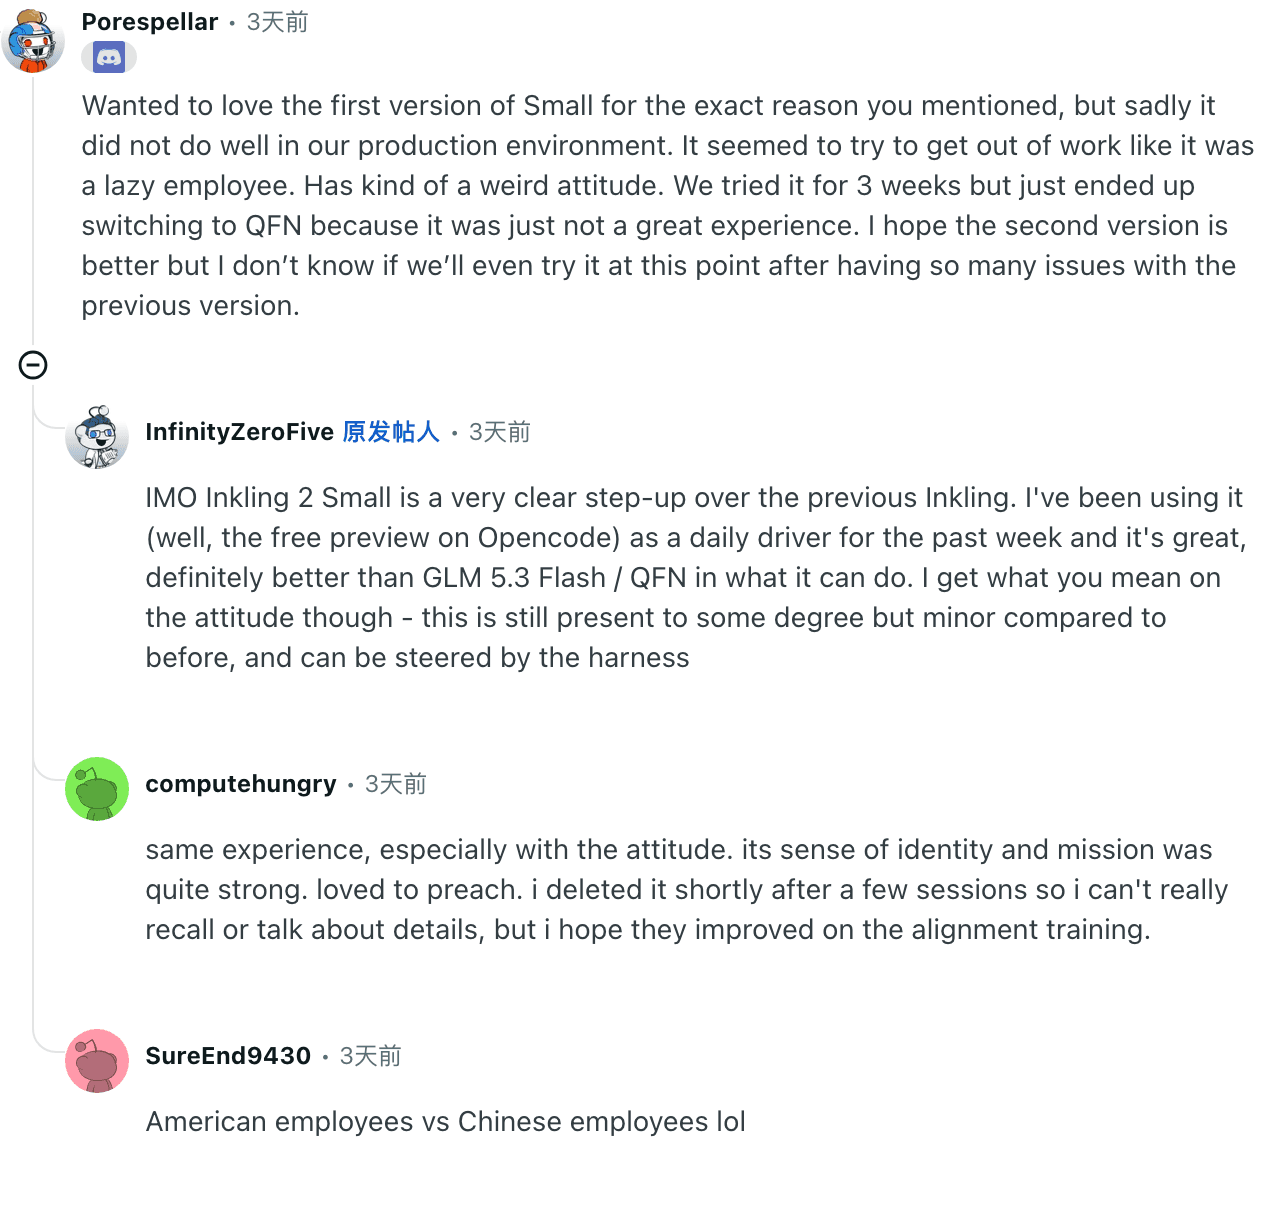
Un utilisateur dit que le premier Inkling s’est mal comporté dans son environnement de production. Un autre rapporte une bonne semaine avec l’aperçu gratuit d’Inkling 2 Small. Les versions et conditions d’hébergement diffèrent. Ces avis ne prédisent pas votre résultat ; ils justifient un essai sur votre tâche. Retour sur la première version · Retour sur l’aperçu Inkling 2
Le navigateur est une couche séparée
Tabbit Browser peut gérer le navigateur si l’agent choisi prend en charge son CLI ou son skill. Il n’héberge pas Inkling, ne charge pas ses poids et ne fournit pas d’API. Le point d’accès au modèle, l’agent et la connexion au navigateur sont trois composants distincts.
Pour utiliser Inkling avec un agent sur un site déjà connecté, le guide navigateur Inkling 2 Small décrit un flux en lecture seule avec un agent local et Tabbit CLI. Il porte sur une route hébergée et ne prouve pas qu’un endpoint Inkling auto-hébergé sera compatible. Consultez aussi le guide Tabbit CLI, le tutoriel pour connecter un navigateur existant, la liste de contrôle de première tâche et la comparaison Browser MCP ou CLI.
Tabbit peut convenir si la tâche nécessite une page visible ou une session déjà ouverte. Il ne remplace pas un serveur de modèle ni un dépôt de poids. La configuration Codex et le guide sur les agents qui contrôlent un navigateur précisent cette limite. Les utilisateurs d’OpenCode peuvent lire la configuration du navigateur connecté et le guide pour réutiliser une session. Aucune intégration Inkling-Tabbit n’a été testée ici.
Verdict : poids accessibles, fortes exigences locales
Inkling 2 Small est publié avec une étiquette Apache 2.0 et sa fiche répertorie des options locales et API. Mais « ouvert » ne signifie ni petit, ni économique à exploiter, ni prêt à démarrer. Les exigences officielles de 500 Go en NVFP4 et 800 Go en MXFP8 aident à trancher : avez-vous le serveur ou faut-il confier l’hébergement à un fournisseur ?
Avant le téléchargement, vérifiez licence et AUP actuelles, puis choisissez un checkpoint et un framework compatibles. Si vous passez par une API, lisez les conditions du fournisseur. Pour l’automatisation du navigateur, suivez un guide distinct. Tabbit connecte le navigateur ; il n’exécute pas le modèle.

Questions fréquentes
Inkling 2 Small est-il open source ?
Thinking Machines le présente comme un modèle à poids ouverts et la fiche Hugging Face indique Apache 2.0. La fiche renvoie aussi vers une politique d’utilisation acceptable distincte. Cela ne signifie pas que les données d’entraînement, tout le processus d’entraînement ou chaque service fournisseur sont open source.
Puis-je exécuter Inkling 2 Small sur un GPU de bureau classique ?
La fiche officielle indique au moins 500 Go de VRAM agrégée pour le checkpoint NVFP4, avec 2 B300 ou 4 H200 comme exemples. Elle indique 800 Go pour MXFP8. Vérifiez la fiche actuelle et votre configuration avant de planifier une installation locale.
Quel checkpoint Inkling 2 Small choisir ?
La fiche recommande NVFP4, le format utilisé pendant l’entraînement. Elle rapporte un gain de 1 à 2 points sur les évaluations pour MXFP8, une affirmation de l’éditeur qu’il juge peu utile en pratique. MXFP8 demande plus de VRAM, vérifiez donc votre configuration.
Peut-on utiliser Inkling 2 Small par API ?
Oui. Thinking Machines cite NVIDIA, Fireworks, Together, Baseten, Nebius, Modal et Cloudflare. L’identifiant du modèle, le prix, la disponibilité régionale et les conditions de données diffèrent selon le fournisseur. Consultez sa documentation avant l’intégration.
Le téléchargement des poids permet-il une exécution gratuite ?
Un dépôt public et une licence Apache 2.0 ne suppriment pas les coûts d’infrastructure. L’inférence locale demande beaucoup de GPU, tandis qu’une API hébergée peut facturer l’usage. Vérifiez les tarifs et conditions actuels du fournisseur choisi.
Tabbit Browser héberge-t-il ou exécute-t-il Inkling 2 Small ?
Non. Tabbit gère le navigateur dans les flux agent et CLI pris en charge, mais n’héberge pas ce modèle et ne déploie pas ses poids. Le point d’accès au modèle, l’agent et le navigateur sont trois choix distincts.