
Os pesos do Inkling 2 Small estão disponíveis no Hugging Face sob a licença Apache 2.0. Mas baixar os arquivos não basta para executar o modelo. A ficha oficial exige pelo menos 500 GB de VRAM agregada para inferência local com NVFP4 e 800 GB para MXFP8. Sem um cluster de GPUs assim, uma API hospedada costuma ser mais viável. Consulte a atualização da Thinking Machines e a ficha oficial do modelo.
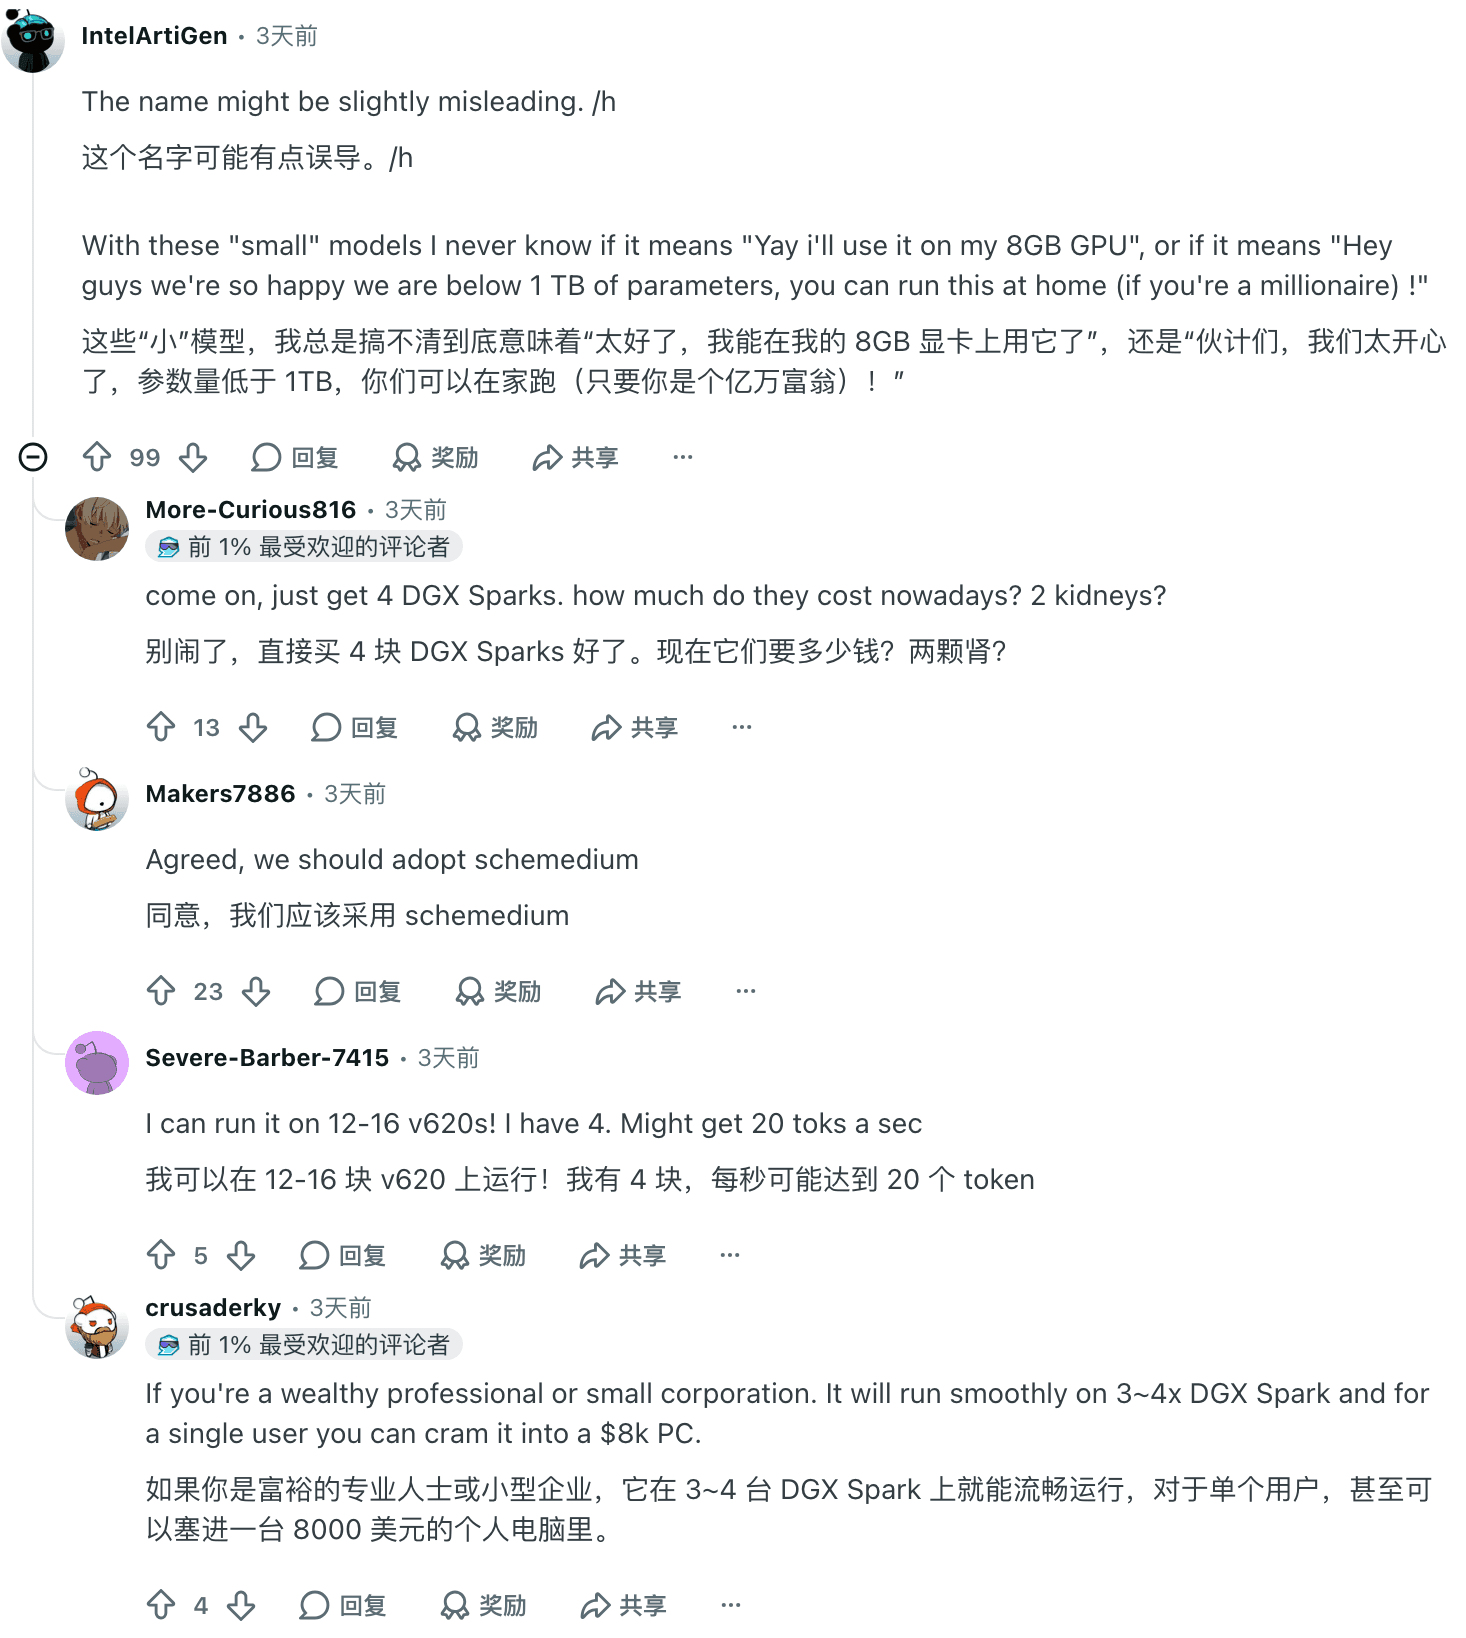
No Reddit, uma pessoa questionou se um modelo chamado "Small" caberia em uma GPU de 8 GB. Vale responder antes de baixar centenas de gigabytes de arquivos. "Pesos abertos" indica acesso aos parâmetros, não que um computador comum possa servir o modelo. Comentário original.
Resumo
A Thinking Machines informou que os pesos ficaram disponíveis em 12 de novembro de 2026, depois de testes externos de segurança. A ficha do Hugging Face mostra Apache 2.0.
Pesos abertos não significa que os dados ou todo o processo de treinamento sejam públicos. Leia também a política de uso aceitável.
A ficha oficial pede pelo menos 500 GB de VRAM agregada para NVFP4 e 800 GB para MXFP8. Os 17B de parâmetros ativos não são uma estimativa para desktop.
A inferência local precisa de um framework de execução. Provedores de API hospedam o modelo, mas preço, ID, disponibilidade e política de dados variam.
O Tabbit Browser não hospeda modelos. Ele pode cuidar da conexão do navegador se o agente escolhido aceitar o CLI ou skill do Tabbit.
Formas de acessar o Inkling 2 Small
| Caminho | O que você recebe | O que verificar | Faz sentido quando |
|---|---|---|---|
| Baixar os pesos no Hugging Face | Arquivos do modelo para operar ou adaptar por conta própria. | Apache 2.0, AUP separada, checkpoint, GPUs e suporte do framework. | Você controla a infraestrutura e administra a inferência. |
| Usar um provedor de API | Inferência hospedada pelo provedor. | ID atual, preço, região, limites, ferramentas, retenção e termos. | Você não quer operar um cluster grande de GPUs. |
| Usar o Tinker | Plataforma da Thinking Machines para amostragem e fine-tuning. | Acesso atual, termos, modos disponíveis e preço. | Você precisa do fluxo de treinamento ou acesso hospedado do Tinker. |
Os caminhos são diferentes. O download é um conjunto de arquivos, não um endpoint ativo. Uma API é um serviço hospedado, não prova que você possui os pesos. Fine-tuning é outra tarefa. A Thinking Machines anunciou a publicação no Hugging Face, e a ficha lista frameworks locais e provedores de API. A documentação do Tinker lista o Inkling 2 Small e uma variante 256K separada; esses IDs são específicos do Tinker. A atualização de lançamento nomeia outros provedores. A documentação da Cloudflare mostra uma rota de API específica e informa que exige acesso pago. Este artigo não cita preços em tempo real nem chama uma API paga.
O que Apache 2.0 cobre
A ficha do Hugging Face indica a licença apache-2.0 e aponta para a Política de Uso Aceitável do modelo da Thinking Machines. A empresa diz que a política se aplica ao acesso e uso dos pesos, parâmetros e materiais associados. Leia os dois documentos antes de incorporar o modelo a um produto. A etiqueta da licença, sozinha, não responde a todas as condições.
"Pesos abertos" é mais preciso do que "totalmente de código aberto". Os parâmetros podem ser baixados conforme os termos listados, mas isso não demonstra que os dados de treinamento, o código ou todo o desenvolvimento sejam públicos. A licença dos pesos também não define preços e tratamento de dados de APIs terceirizadas.
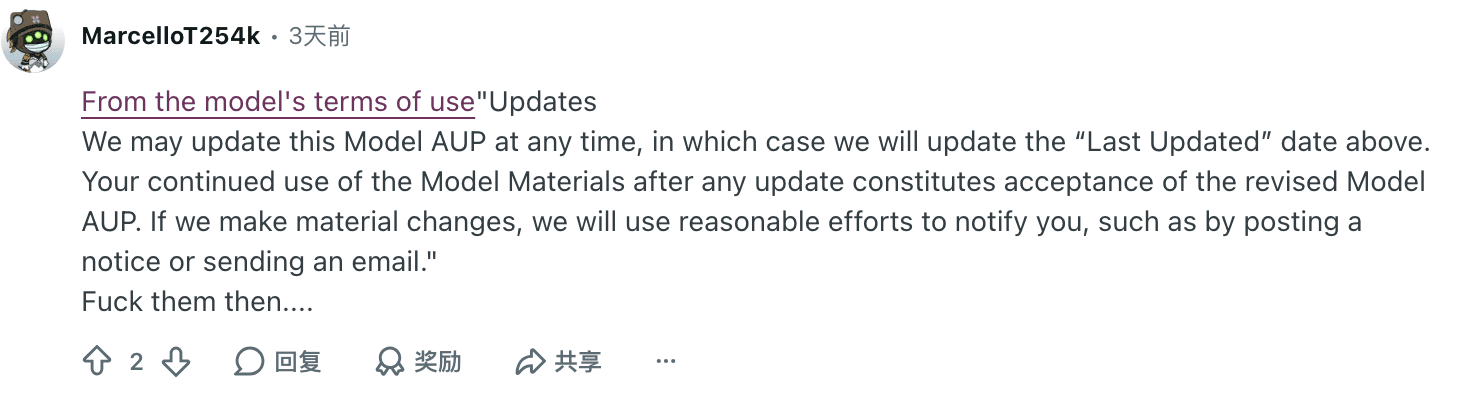
Um comentarista citou a cláusula que permite atualizações da AUP. Use isso como lembrete para ler a política atual, e não confiar apenas em uma captura ou resumo. Na consulta de 16 de novembro, a página da política indicava atualização em 15 de julho de 2026. Comentário original.
A inferência local exige um grande cluster de GPUs
A ficha descreve 594 bilhões de parâmetros totais e 17 bilhões ativos. "Ativos" é a parte MoE usada por token, não uma versão menor que possa ser carregada em um PC comum. Planeje com os requisitos publicados para cada checkpoint.
| Checkpoint | VRAM agregada indicada pelo fabricante | Exemplos da ficha | Orientação do fabricante |
|---|---|---|---|
| NVFP4 | Pelo menos 500 GB | 2 NVIDIA B300 ou 4 H200 | Recomendado pela Thinking Machines; o modelo foi treinado em NVFP4. |
| MXFP8 | Pelo menos 800 GB | 4 NVIDIA B300 ou 8 H200 | A ficha relata ganho de 1–2 pontos em avaliações, que considera sem importância prática. |
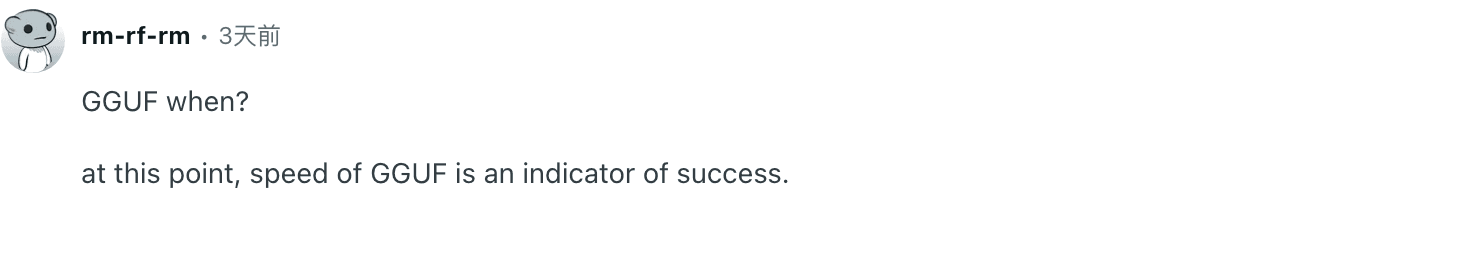
Esses são requisitos e exemplos da empresa, não resultados medidos neste artigo. São valores de VRAM total das GPUs, não de RAM do sistema. Uma placa de vídeo de 8 GB está longe dessas configurações. No r/LocalLLaMA, alguém perguntou quando sairia uma versão GGUF. A pergunta não confirma que esse formato já exista ou não. Comentário original.
A ficha lista SGLang, vLLM, TokenSpeed, Unsloth e Hugging Face para inferência local. Antes de baixar, confira se a receita atual do framework aceita o checkpoint, hardware e versões disponíveis. A Thinking Machines recomenda NVFP4, mas não afirma que todas as opções tenham os mesmos passos ou desempenho.
Quando uma API é mais adequada
Se você não tem um servidor com várias GPUs, compare primeiro as APIs hospedadas. A Thinking Machines lista NVIDIA, Fireworks, Together, Baseten, Nebius, Modal e Cloudflare. A documentação da Cloudflare mostra o ID @cf/thinkingmachines/inkling-2-small, endpoints de Workers e compatíveis com OpenAI, e diz que o acesso pago é obrigatório. Isso se aplica à rota da Cloudflare, não aos preços ou termos dos outros provedores.
Antes de integrar a aplicação, verifique a disponibilidade para sua região e conta, o ID e formato exatos da API, preço e limites, tratamento de prompts e imagens, e suporte às ferramentas ou modalidades necessárias. Não presuma que a API é gratuita só porque os pesos podem ser baixados.
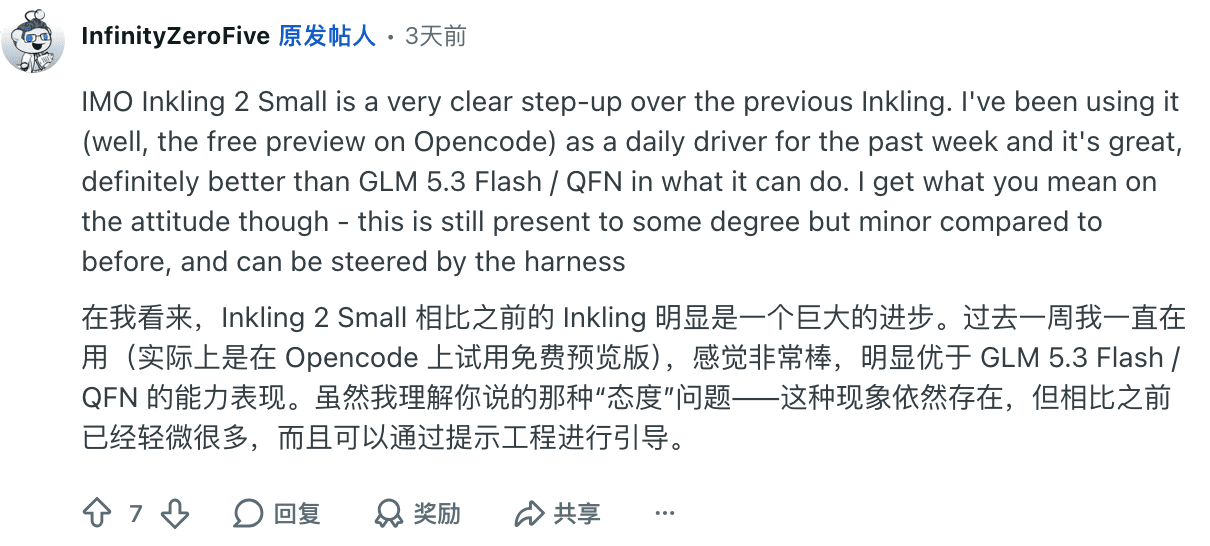
Um usuário do Reddit disse ter usado a prévia gratuita do Inkling 2 Small no OpenCode. É uma experiência pessoal com uma prévia hospedada, não prova de inferência local ou disponibilidade atual. Comentário original.
Escolha o caminho antes de baixar
Leia os termos atuais. Confira Apache 2.0 e a AUP. Se sua organização tem aprovação de modelos, encaminhe ambos.
Decida se precisa hospedar por conta própria. Compare a VRAM oficial com suas GPUs e o framework. Sem capacidade suficiente, compare APIs primeiro.
Escolha o checkpoint e o runtime juntos. Confirme se a receita atual aceita o formato escolhido.
Estime o custo completo. No ambiente local, considere GPU, energia e operação. Na API, confira preço, cotas, região e dados. Este artigo não calcula custos.
Teste com dados não sensíveis. Registre os IDs do modelo e do provedor e revise os resultados antes de conectar à produção.
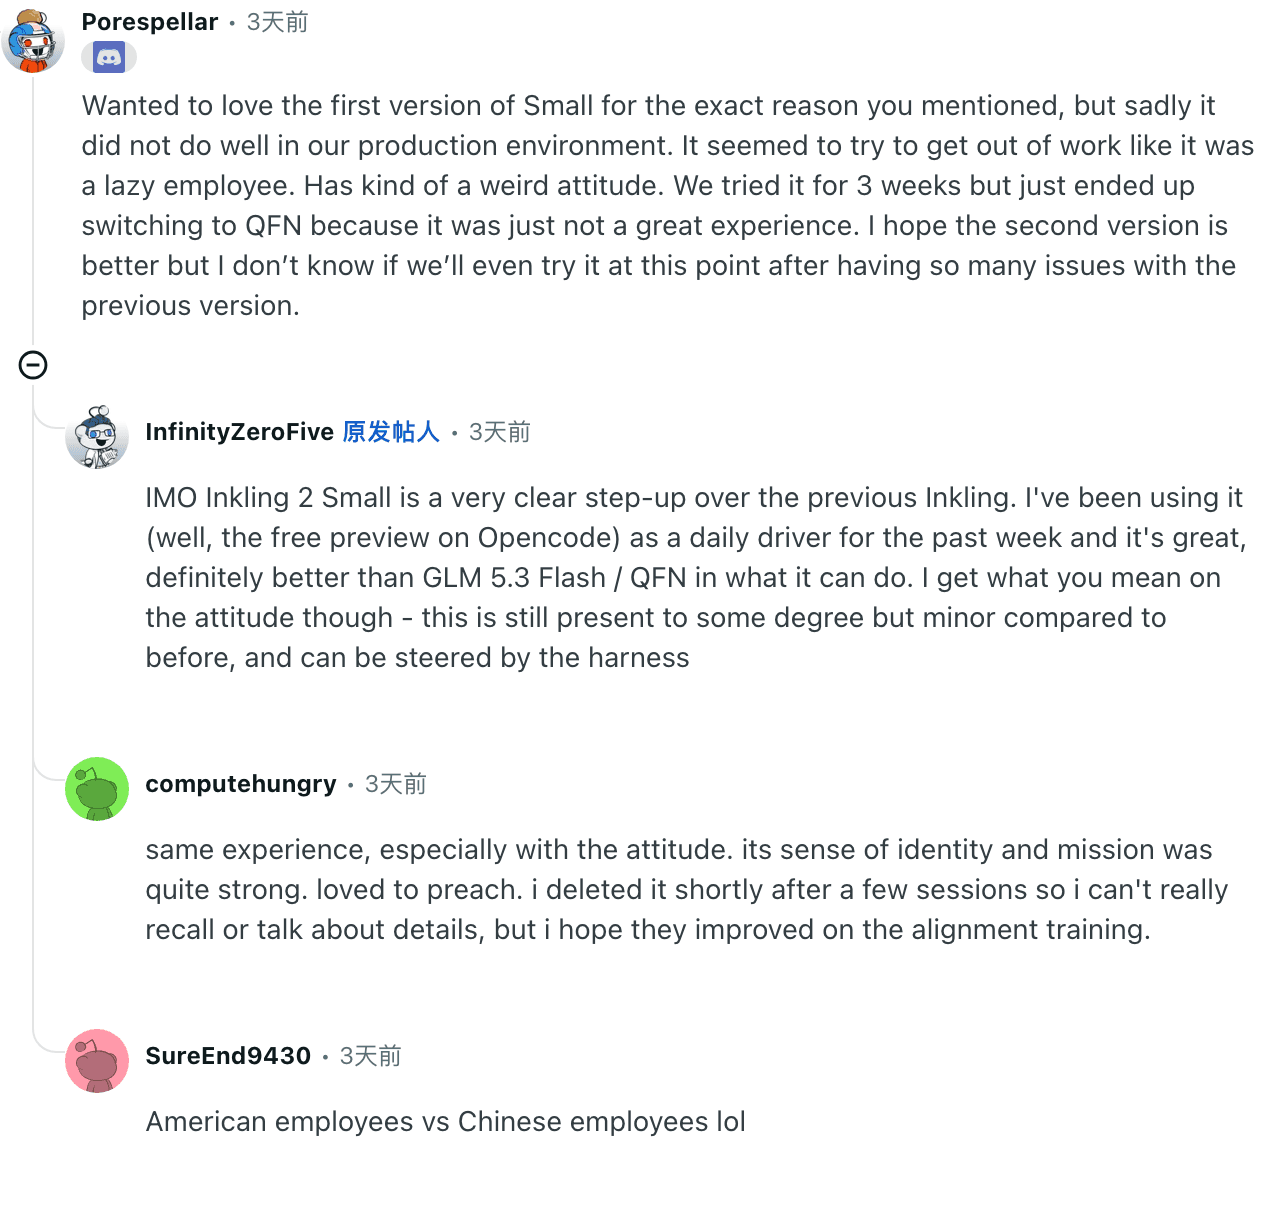
Uma pessoa relatou que o primeiro Inkling não funcionou bem no ambiente de produção dela. Outra descreveu uma semana positiva com a prévia do Inkling 2 Small. São versões e condições diferentes, portanto não preveem seu resultado. Use esses relatos como motivo para testar sua própria tarefa. Experiência com a primeira versão · Experiência com a prévia do Inkling 2
O navegador é outra camada
O Tabbit Browser pode cuidar das tarefas no navegador quando o agente escolhido oferece suporte ao CLI ou skill do Tabbit. Ele não hospeda Inkling, carrega seus pesos nem fornece API. Endpoint do modelo, agente e conexão ao navegador são componentes separados.
Se sua meta é usar Inkling com um agente em um site já autenticado, o guia de uso do Inkling 2 Small no navegador explica um fluxo somente de leitura com agente local e Tabbit CLI. Esse guia cobre uma rota hospedada e não prova que um endpoint local de Inkling seja compatível com o cliente. Veja também o guia do Tabbit CLI, o tutorial para conectar a um navegador existente, a lista da primeira tarefa e a comparação Browser MCP ou CLI.
O Tabbit faz sentido quando a tarefa precisa de uma página visível ou perfil já autenticado. Não serve como servidor de modelo ou local para baixar pesos. O guia de configuração do Codex e a visão geral de agentes que controlam o navegador explicam essa fronteira. Usuários do OpenCode podem consultar a configuração do navegador autenticado e o guia para reutilizar uma sessão. Este artigo não testou a integração do modelo Inkling com o Tabbit.
Conclusão: pesos disponíveis, requisitos locais altos
Inkling 2 Small tem pesos sob Apache 2.0, e a ficha pública apresenta opções de inferência local e API. Mas "aberto" não quer dizer pequeno, barato de operar ou pronto para executar. Os requisitos oficiais de VRAM agregada, 500 GB para NVFP4 e 800 GB para MXFP8, ajudam a responder à primeira pergunta: você tem o servidor ou precisa de um provedor?
Antes de baixar, confira licença e AUP atuais e escolha um checkpoint e framework compatíveis. Se preferir API, examine os termos de cada provedor. Automação de navegador é um fluxo separado. O Tabbit conecta o navegador; não executa o modelo.

Perguntas frequentes
O Inkling 2 Small é de código aberto?
A Thinking Machines o descreve como um modelo de pesos abertos, e a ficha do Hugging Face mostra a licença Apache 2.0. A ficha também aponta para uma Política de Uso Aceitável separada. Isso não significa que os dados ou todo o processo de treinamento, nem todos os serviços de provedores, sejam de código aberto.
Posso executar o Inkling 2 Small em uma GPU de desktop comum?
A ficha oficial informa que o checkpoint NVFP4 precisa de pelo menos 500 GB de VRAM agregada, com 2 B300 ou 4 H200 como exemplos. Para MXFP8, a exigência é 800 GB. Confira a ficha atual e a configuração real antes de planejar uma implantação local.
Qual checkpoint devo escolher?
A ficha recomenda NVFP4, formato usado durante o treinamento. Ela relata ganho de 1 a 2 pontos percentuais em avaliações para MXFP8, uma afirmação da empresa que ela considera pouco relevante na prática. MXFP8 exige mais hardware, então compare os requisitos com sua configuração.
Posso usar o Inkling 2 Small por API?
Sim. A Thinking Machines lista NVIDIA, Fireworks, Together, Baseten, Nebius, Modal e Cloudflare como provedores de API. ID do modelo, preço, disponibilidade regional e condições de dados variam. Consulte a documentação do provedor antes de conectar uma aplicação.
Baixar os pesos significa que posso executar de graça?
Um repositório público e uma licença Apache 2.0 não eliminam custos de infraestrutura. A inferência local exige muita capacidade de GPU, e APIs hospedadas podem cobrar pelo uso. Confira os preços e termos atuais do provedor escolhido.
O Tabbit Browser hospeda ou executa o Inkling 2 Small?
Não. O Tabbit cuida do navegador em fluxos compatíveis com agentes e CLI; ele não hospeda o modelo nem implanta os pesos. O endpoint do modelo, o agente e a conexão com o navegador são escolhas separadas.