
Inkling 2 Small 權重已在 Hugging Face 開放下載,模型卡標示 Apache 2.0。但下載只是第一步。官方模型卡指出,NVFP4 本機推論至少需要 500 GB 聚合顯存,MXFP8 則需要 800 GB。如果你沒有這樣的 GPU 叢集,API 通常更實際。請看 Thinking Machines 的發布更新和官方模型卡。
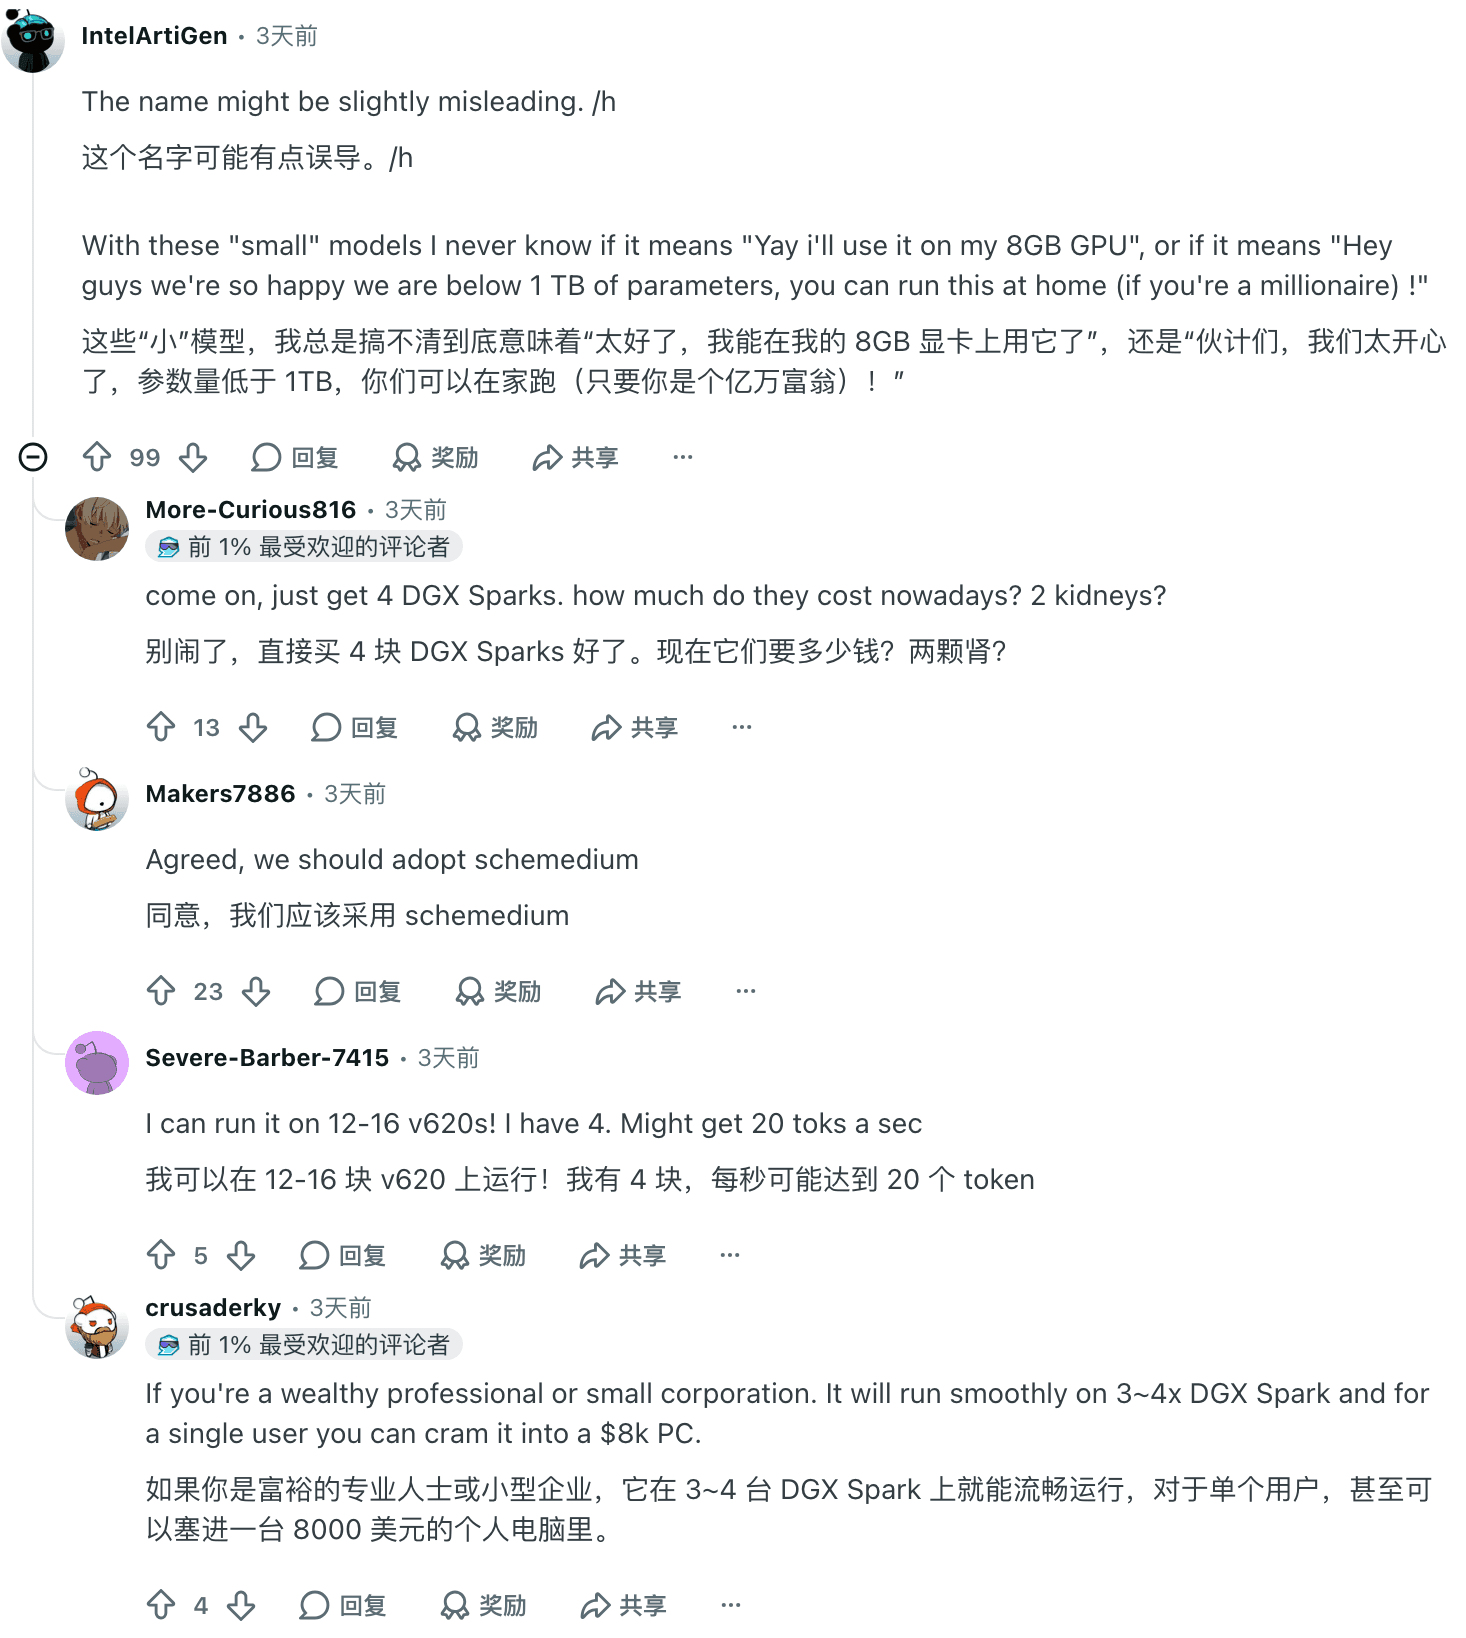
一位 Reddit 使用者看到「small」這個名稱時,疑惑它是否能放進 8 GB 顯卡。這個問題值得在下載大量模型檔案前先確認。「開放權重」代表參數可取得,不等於一般桌機可以部署。查看原留言。
重點整理
Thinking Machines 表示權重在 2026 年 11 月 12 日開放,Hugging Face 模型卡標示 Apache 2.0。
開放權重不代表訓練資料與完整訓練流程都開源。除了授權,也要閱讀模型的可接受使用政策。
官方卡片列出 NVFP4 至少 500 GB 聚合顯存、MXFP8 800 GB。17B 啟用參數不是桌機顯存需求。
本機推論需要部署框架。API 供應商替你託管模型,但價格、模型 ID、供應地區和資料政策各不相同。
Tabbit Browser 不是模型託管服務。只有 agent 支援 Tabbit CLI 或 skill 時,Tabbit 才會處理瀏覽器連線這一層。
Inkling 2 Small 的使用路徑
| 路徑 | 你會取得什麼 | 需要確認 | 適合情況 |
|---|---|---|---|
| 從 Hugging Face 下載權重 | 可自行部署或調整的模型檔案。 | Apache 2.0 授權、另一份模型政策、檢查點、GPU 能力與框架支援。 | 你管理自己的基礎設施和推論服務。 |
| 使用 API 供應商 | 由供應商端點託管推論。 | 目前模型 ID、價格、地區、輸入限制、工具支援、資料保留和服務條款。 | 你不想維運大型 GPU 叢集。 |
| 使用 Tinker | Thinking Machines 的取樣與微調平台。 | 目前存取資格、平台條款、模型模式和價格。 | 你需要廠商的訓練流程或 Tinker 託管存取。 |
三種方式不能互換。下載的是模型檔案,不會自動成為 API;API 是託管服務,不代表你持有權重;微調又是另一回事。Thinking Machines 表示權重已放上 Hugging Face,模型卡列出本機推論框架與第三方 API 供應商。Tinker 模型文件列出 Inkling 2 Small 和獨立的 256K 版本,這些 ID 只適用於 Tinker。發布更新列出其他供應商;Cloudflare 文件展示一個具體 API 路徑,並標明需要付費存取。本文不引用即時價格,也沒有呼叫付費端點。
Apache 2.0 授權涵蓋什麼
Hugging Face 模型卡將授權標示為 apache-2.0,並連到 Thinking Machines 的模型可接受使用政策。廠商表示,該政策適用於模型權重、參數及相關資料的存取與使用。將模型用於產品前,請同時閱讀兩份文件,不要只看授權標籤就假設所有用途都沒有額外條件。
這裡用「開放權重」比「完全開源」精確。它表示模型參數可以依列出的條款下載,不代表訓練資料、訓練程式碼或完整研發流程都公開。第三方 API 的價格與資料處理也不由權重授權決定,需逐家確認。
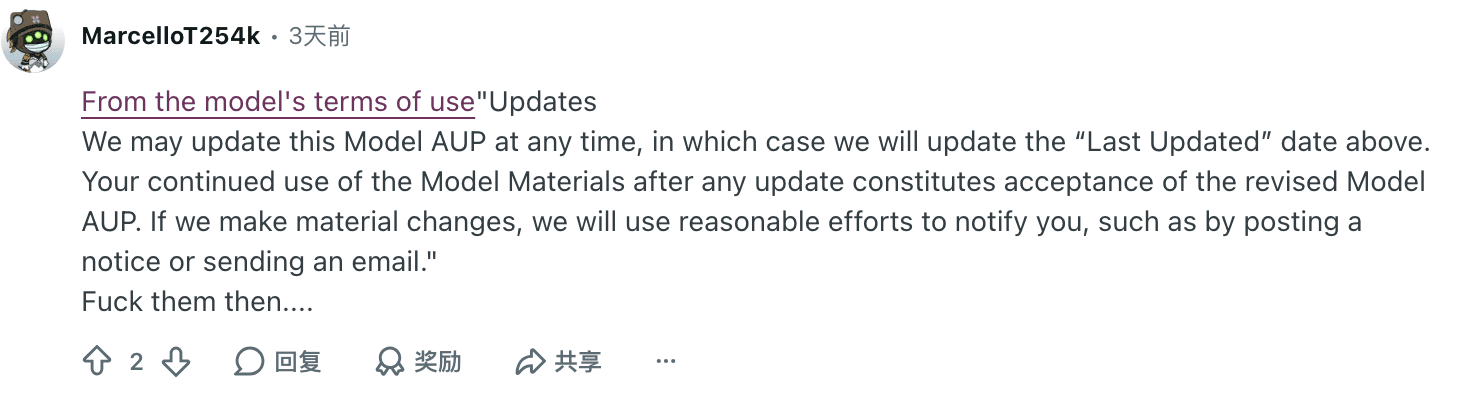
一位留言者引用了模型政策可更新的文字。這提醒讀者應閱讀目前的政策,而不是依賴截圖或摘要。政策頁標示最後更新於 2026 年 7 月 15 日,本文於 11 月 16 日查閱。原始留言。
本機推論需要大型 GPU 叢集
模型卡把 Inkling 2 Small 列為 5940 億總參數、170 億啟用參數。「啟用」指每個 token 使用的混合專家部分,不代表只需載入一個 170 億參數版本。規劃部署時,應以廠商的檢查點需求為準。
| 檢查點 | 廠商列出的聚合顯存 | 模型卡示例配置 | 廠商建議 |
|---|---|---|---|
| NVFP4 | 至少 500 GB | 2 張 NVIDIA B300 或 4 張 H200 | Thinking Machines 建議使用;模型以 NVFP4 完成訓練。 |
| MXFP8 | 至少 800 GB | 4 張 NVIDIA B300 或 8 張 H200 | 卡片稱評測高 1–2 個百分點,但認為實務用途差異有限。 |
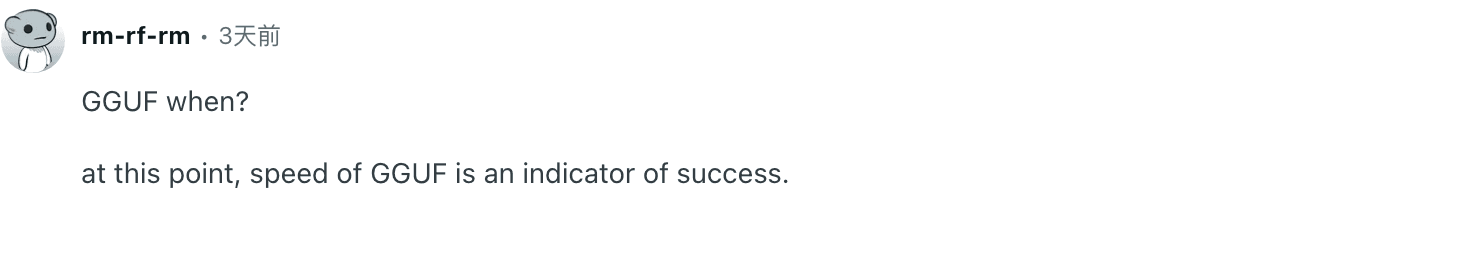
這些是廠商列出的需求與示例,不是本文測試結果。這裡指 GPU 顯存總量,不是一般系統記憶體。單張 8 GB 顯卡和表格中的配置差距很大。r/LocalLLaMA 有人詢問是否會提供 GGUF 版本,但問題本身不能證明該格式已發布或尚未發布。原始留言。
模型卡列出 SGLang、vLLM、TokenSpeed、Unsloth 和 Hugging Face 作為本機推論選項。下載前先查看框架配方是否支援你選的檢查點、硬體與版本。Thinking Machines 建議 NVFP4,但沒有說所有框架的設定步驟或效能相同。
什麼時候 API 較合適
若你沒有多 GPU 伺服器,先比較託管 API。Thinking Machines 列出 NVIDIA、Fireworks、Together、Baseten、Nebius、Modal 與 Cloudflare。Cloudflare 文件使用模型 ID @cf/thinkingmachines/inkling-2-small,展示 Workers 和 OpenAI 相容端點,並標明需要付費存取。這只證明 Cloudflare 有這條路徑,不代表其他供應商的價格或條款。
串接前請逐項查看地區和帳號是否可用、精確模型 ID 與 API 格式、輸入輸出限制和價格、提示詞與圖片如何處理,以及端點支援哪些工具或模態。不要因為權重可下載,就以為 API 免費。
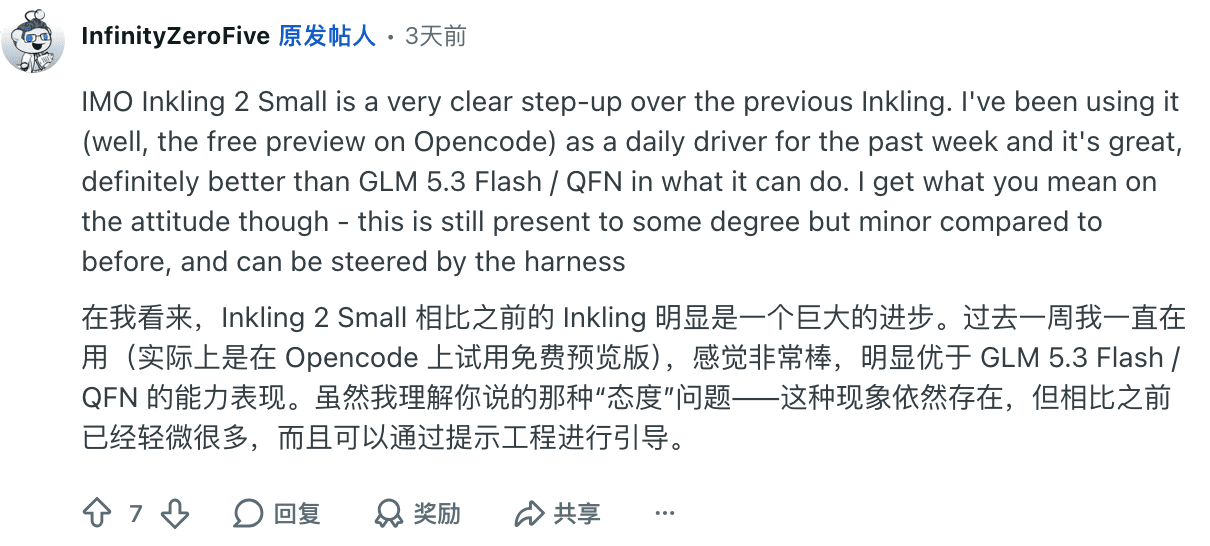
一位 Reddit 使用者提到自己曾透過 OpenCode 免費預覽版使用 Inkling 2 Small。這是託管預覽的個人描述,不代表本機推論能力或目前的存取狀態。原始留言。
下載前先選好路徑
閱讀現行條款。 同時確認 Apache 2.0 授權和模型 AUP。企業部署依照組織的模型審核流程處理。
判斷是否一定要自架。 若必須在自有設備推論,把官方顯存需求與伺服器 GPU 逐項核對。容量不足時先比較 API。
一起選檢查點與框架。 模型卡列出兩種格式和多種框架,先確認配方支援指定檢查點。
估算整體成本。 本機服務要考慮 GPU、電力與維運;API 要查看價格、額度、地區和資料條款。本文不估算費用。
先用非敏感資料測試。 記錄模型與供應商識別碼,檢查輸出後再連接正式流程。
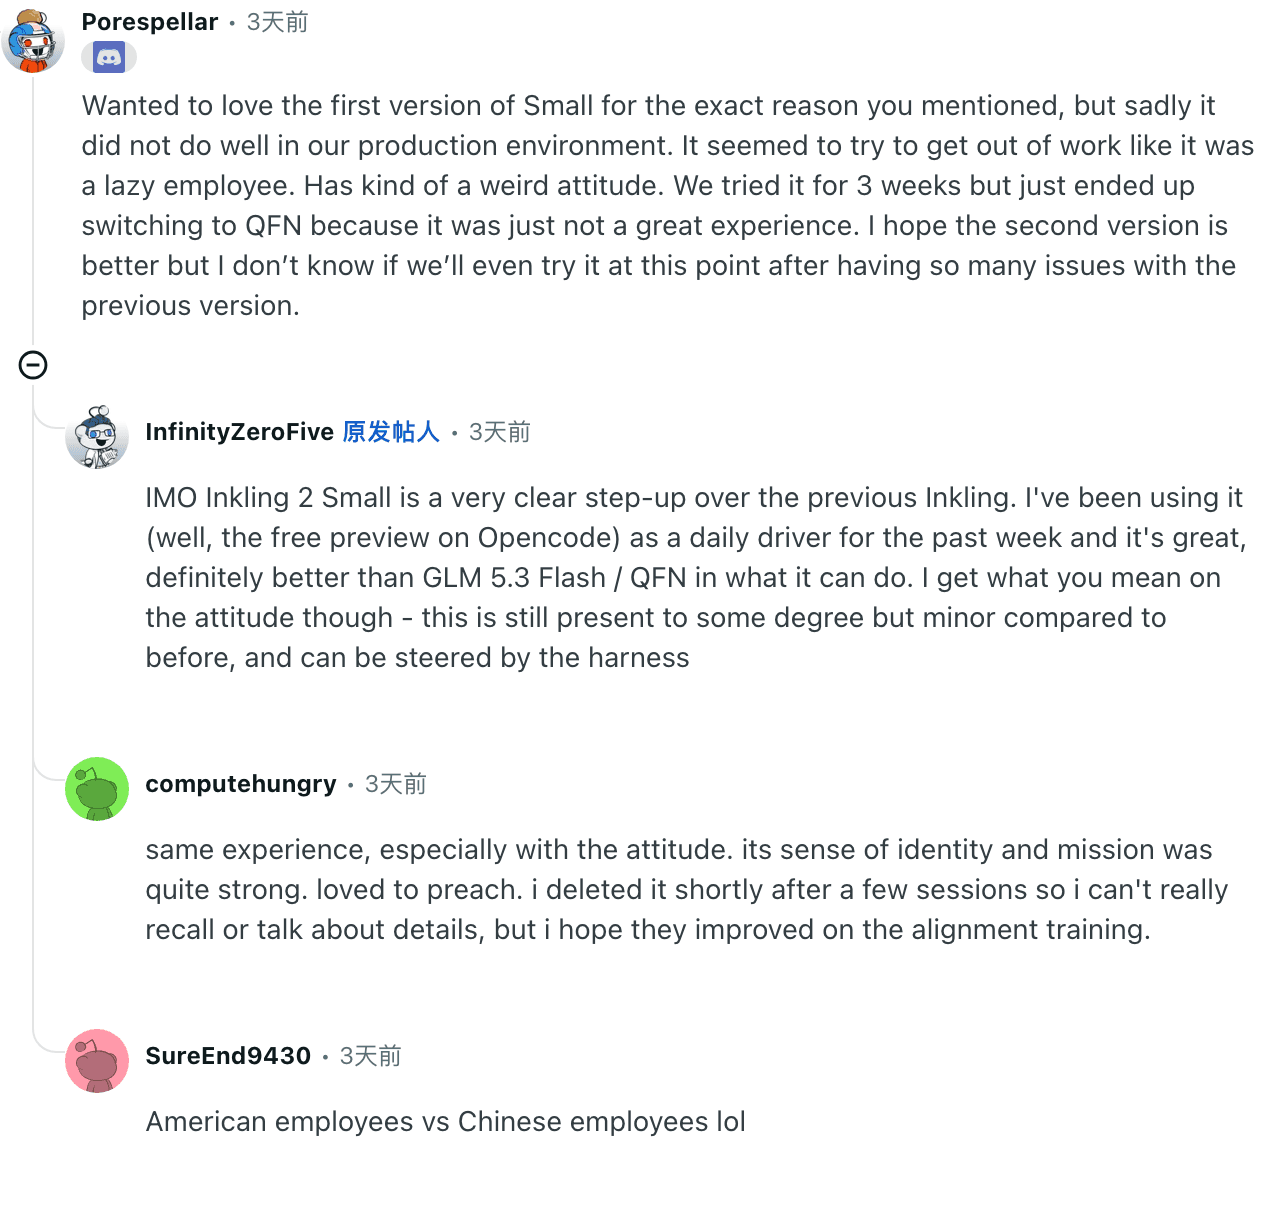
一位使用者說初代 Inkling 在他們的正式環境中表現不理想;另一位則稱曾在免費預覽版上連續使用一週。兩則心得涉及不同版本和託管條件,不能證明 Inkling 2 Small 在你的環境會如何表現。它們說明了為什麼應先用自己的任務試跑。初代使用心得 · Inkling 2 預覽心得
瀏覽器工作屬於另一層
當你選用的 agent 支援 Tabbit CLI 或 skill 時,Tabbit Browser 可以處理瀏覽器工作。它不會託管 Inkling、載入權重或提供 API。模型端點、呼叫模型的 agent 和瀏覽器連線是三個不同環節。
如果你要透過 agent 使用 Inkling 操作已登入網站,Inkling 2 Small 瀏覽器指南說明了 agent 搭配 Tabbit CLI 的唯讀流程。那篇文章針對託管模型路徑撰寫,不能證明自架 Inkling 端點能接上相同客戶端。可先看 Tabbit CLI 指南、連接既有瀏覽器和第一個任務檢查清單。連線方式可參考Browser MCP 與 CLI 比較。
當工作需要讀取已登入帳號的瀏覽器頁面,Tabbit 可能有幫助;如果你要的是模型伺服器或權重下載位置,Tabbit 就不是那一層。Codex 設定指南和agent 瀏覽器控制說明解釋了這個邊界。OpenCode 使用者也可看登入瀏覽器設定與重用登入狀態指南。本文沒有測試 Inkling 與 Tabbit 的模型整合。
結論:權重可取得,本機門檻很高
Inkling 2 Small 的公開模型卡標示 Apache 2.0,也列出本機推論和 API 路徑。但「開放」不等於體積小、營運成本低或下載後就能執行。官方卡片列出的 NVFP4 500 GB 與 MXFP8 800 GB 聚合顯存,足以讓多數團隊先判斷:你有合適伺服器,還是應由供應商託管?
下載前核對目前的授權和 AUP,選好支援的檢查點與框架;若偏好 API,則逐家確認服務條款。若下一步是瀏覽器自動化,請把瀏覽器指南當作獨立流程。Tabbit 能提供瀏覽器連線,不會執行模型。

常見問題
Inkling 2 Small 是開源模型嗎?
Thinking Machines 將它稱為開放權重模型,Hugging Face 模型卡標示 Apache 2.0。模型卡也連到另一份可接受使用政策。這不代表訓練資料、完整訓練流程或所有供應商服務都已開源。
一般桌上型電腦的 GPU 能執行 Inkling 2 Small 嗎?
官方模型卡指出 NVFP4 至少需要 500 GB 聚合顯存,並以 2 張 B300 或 4 張 H200 為例。MXFP8 需要 800 GB。規劃本機部署前,請按目前模型卡核對實際 GPU 配置。
應該選哪個檢查點?
模型卡建議使用 NVFP4,這也是訓練時採用的格式。卡片表示 MXFP8 的評測高 1–2 個百分點,這是廠商數據,且廠商認為實用差異不大。MXFP8 的硬體門檻更高,應按你的配置決定。
可以透過 API 使用 Inkling 2 Small 嗎?
可以。Thinking Machines 列出 NVIDIA、Fireworks、Together、Baseten、Nebius、Modal 與 Cloudflare 等 API 供應商。模型 ID、價格、地區可用性和資料條款會因供應商而異,串接前應查看目前文件。
下載權重後就能免費執行嗎?
公開模型倉庫和 Apache 2.0 授權不會消除基礎設施費用。本機服務需要大量 GPU 資源,託管 API 也可能依用量收費。請查看所選供應商目前的價格與服務條款。
Tabbit Browser 會託管或執行 Inkling 2 Small 嗎?
不會。Tabbit 透過支援的 agent 與 CLI 流程處理瀏覽器工作,不託管此模型,也不部署其權重。模型路徑、agent 執行環境和瀏覽器連線是不同選擇。