
Inkling 2 Smallの重みはHugging Faceからダウンロードでき、モデルカードにはApache 2.0と記載されています。ただし、ダウンロードしただけでは実行できません。公式カードはローカル推論にNVFP4で合計500 GB以上、MXFP8で800 GBのVRAMを必要としています。これだけのGPUクラスターがない場合は、ホスト型APIのほうが現実的です。Thinking Machinesの更新と公式モデルカードを確認してください。
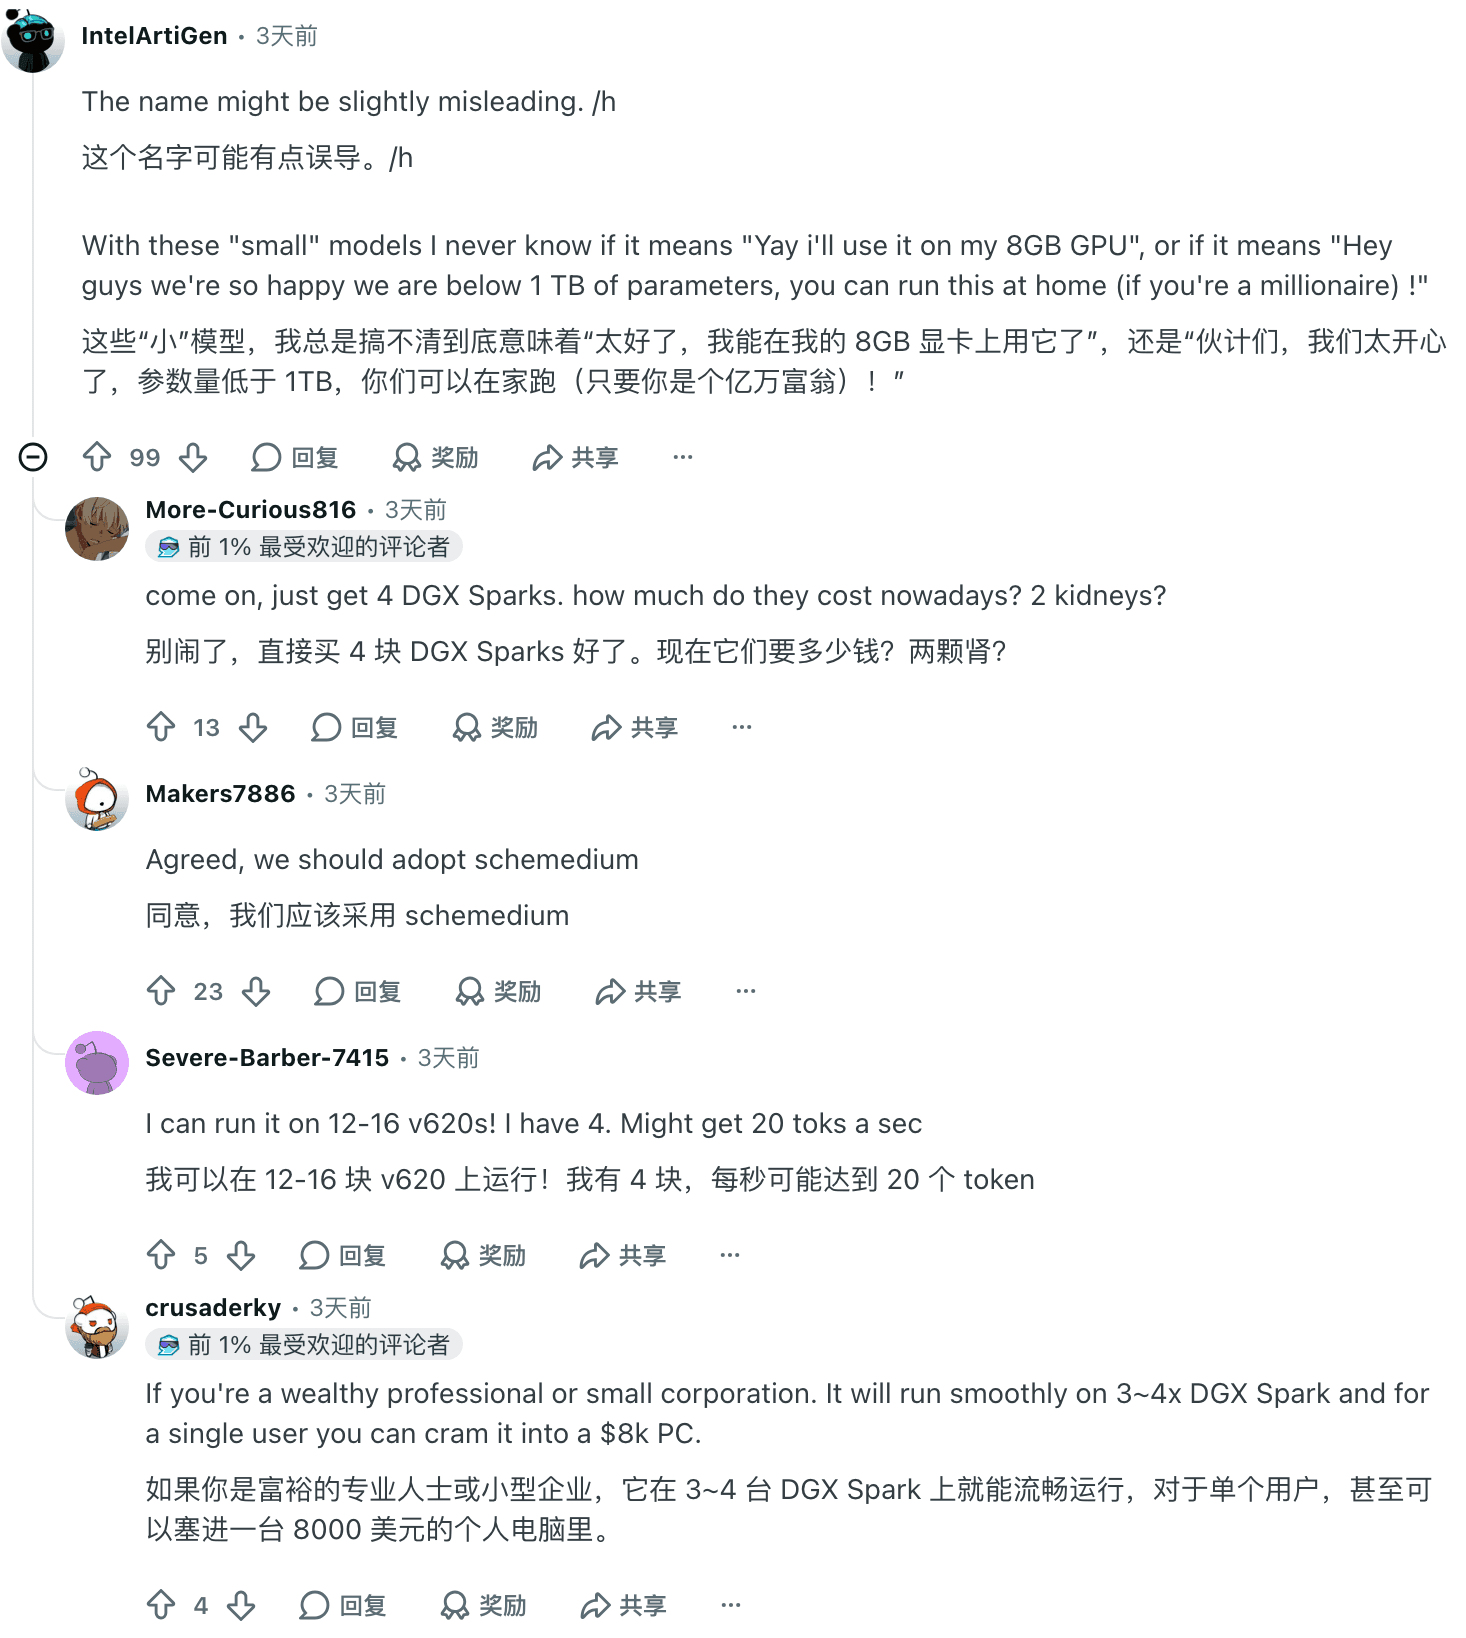
Redditでは、「Small」という名前から8 GBのGPUに載るのか疑問に思ったユーザーがいました。大量のモデルファイルを落とす前に確認したい点です。「オープンウェイト」はパラメーターへのアクセスを指し、一般的なデスクトップで配信できるという意味ではありません。元のコメント。
要点
Thinking Machinesの更新によると重みは2026年11月12日に公開され、Hugging FaceのカードはApache 2.0を表示しています。
オープンウェイトでも学習データや学習工程全体が公開されるとは限りません。利用ポリシーも読んでください。
公式カードはNVFP4に合計500 GB以上、MXFP8に800 GBのVRAMを要求しています。17B activeはデスクトップのメモリ要件ではありません。
ローカル推論にはサービング用フレームワークが必要です。APIならプロバイダーがホストしますが、料金、ID、提供状況、データ条件は異なります。
Tabbit Browserはモデルホストではありません。選んだagentがTabbit CLIまたはskillに対応する場合、ブラウザー接続を担当できます。
Inkling 2 Smallの利用経路
| 経路 | 得られるもの | 確認すること | 向いている状況 |
|---|---|---|---|
| Hugging Faceから重みを取得 | 自分で運用・調整するモデルファイル。 | Apache 2.0、別途の利用ポリシー、チェックポイント、GPU容量、フレームワーク対応。 | インフラを管理し、推論も自分で運用する。 |
| APIプロバイダーを使う | プロバイダー側のホスト型推論。 | 現在のモデルID、料金、地域、上限、ツール、データ保持、サービス条件。 | 大規模GPUクラスターを運用したくない。 |
| Tinkerを使う | Thinking Machinesのサンプリング・微調整プラットフォーム。 | 現在のアクセス条件、利用条件、モード、料金。 | Tinkerの学習フローやホスト型アクセスが必要。 |
3つの経路は別のものです。ダウンロードはモデルファイルであり、稼働中のAPIではありません。APIはホスト型サービスで、重みを所有している証拠でもありません。微調整も別の作業です。Thinking MachinesはHugging Faceでの配布を告知し、モデルカードにはローカル推論フレームワークとAPIプロバイダーが載っています。Tinkerのモデル文書にはInkling 2 Smallと別の256K版があり、モデルIDはTinker専用です。リリース更新には他のプロバイダーも記載されています。Cloudflareのモデル文書はAPIの例を示し、有料アクセスが必要としています。この記事では現在の料金を掲載せず、有料APIも呼び出していません。
Apache 2.0が示す範囲
Hugging Faceのモデルカードはライセンスをapache-2.0とし、Thinking Machinesのモデル利用許容ポリシーへリンクしています。提供元は、このポリシーが重み、パラメーター、関連資料のアクセスと利用に適用されるとしています。製品に組み込む前に両方を読んでください。ライセンス表示だけではすべての条件を判断できません。
ここでは「完全なオープンソース」より「オープンウェイト」が正確です。モデルパラメーターを条件に従って取得できるという意味であり、学習データ、学習コード、開発工程全体が公開されたとは限りません。第三者APIの料金やデータ処理も重みのライセンスでは決まりません。
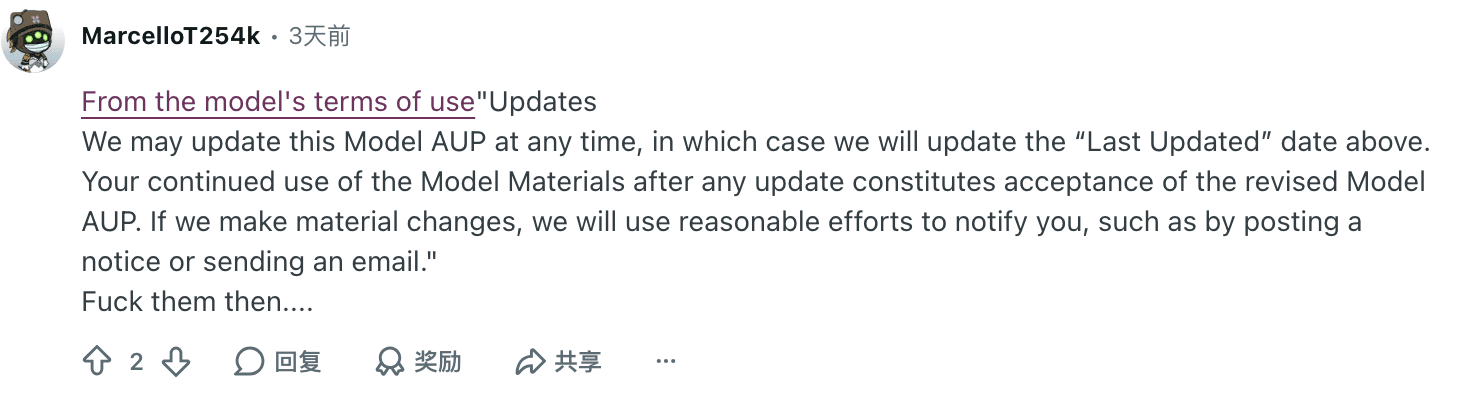
あるコメント投稿者は、モデルAUPが更新される可能性を指摘しました。スクリーンショットや要約に頼らず、現行ポリシーを読むきっかけとして扱ってください。調査時にページに記載されていた更新日は2026年7月15日です。元のコメント。
ローカル推論には大規模GPUクラスターが必要
モデルカードは総594B、active 17Bのモデルと説明しています。「active」は各tokenで使われるMoE部分を指し、一般的なPCに載る小型版があるという意味ではありません。導入計画では公開されたチェックポイント要件を使ってください。
| チェックポイント | 提供元のVRAM要件 | カードの構成例 | 提供元の案内 |
|---|---|---|---|
| NVFP4 | 合計500 GB以上 | NVIDIA B300を2基、またはH200を4基 | Thinking Machinesが推奨。モデルはNVFP4で学習。 |
| MXFP8 | 合計800 GB以上 | NVIDIA B300を4基、またはH200を8基 | 評価で1〜2ポイント上と報告。ただし実用上の意味は小さいとの見解。 |
これは提供元の要件と例であり、この記事で測定した結果ではありません。数値はGPU VRAMの合計で、通常のシステムRAMではありません。8 GBのグラフィックカード1枚では構成例から大きく離れています。r/LocalLLaMAではGGUF版の予定を尋ねる投稿がありましたが、その質問から形式の公開状況は判断できません。元のコメント。
カードはローカル推論の選択肢としてSGLang、vLLM、TokenSpeed、Unsloth、Hugging Faceを挙げています。ダウンロード前に、使うフレームワークの現行手順がチェックポイント、ハードウェア、バージョンに対応するか確認してください。NVFP4は推奨されていますが、すべてのフレームワークの設定や性能が同じとは限りません。
APIが合うケース
マルチGPUサーバーがないなら、まずホスト型APIを比較します。Thinking MachinesはNVIDIA、Fireworks、Together、Baseten、Nebius、Modal、Cloudflareを列挙しています。CloudflareはモデルIDを@cf/thinkingmachines/inkling-2-smallとし、WorkersとOpenAI互換エンドポイントを掲載し、有料アクセスが必要と説明しています。これはCloudflareの例で、他社の料金や条件は別です。
接続前に地域とアカウントの提供状況、正確なモデルIDとAPI形式、入出力上限と料金、promptや画像のデータポリシー、必要なツールやモダリティへの対応を確認します。重みをダウンロードできるからといってAPIが無料とは限りません。
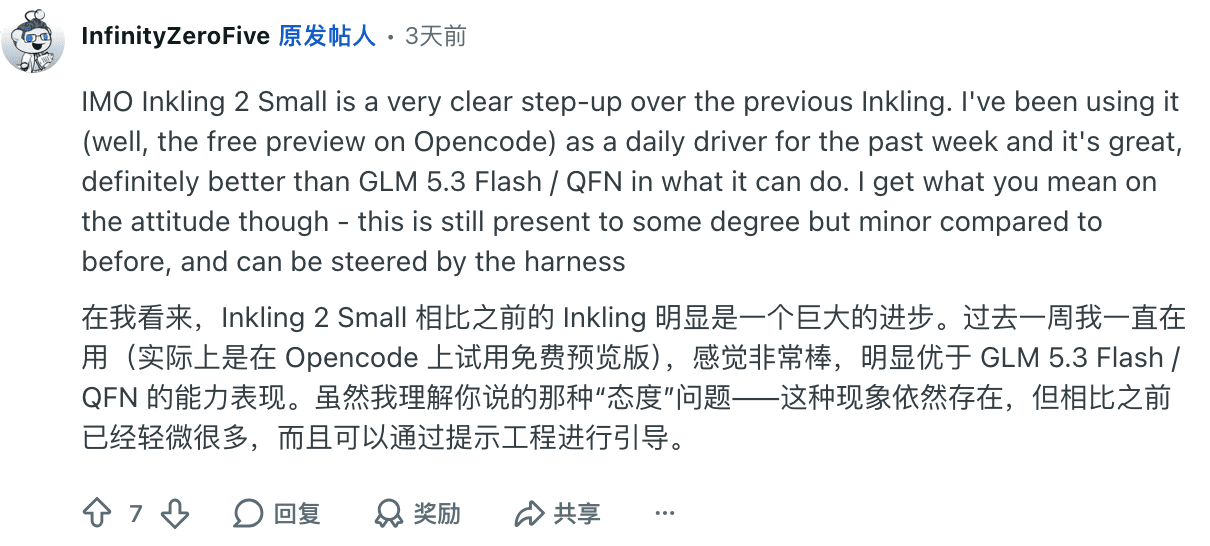
RedditのユーザーはOpenCodeの無料プレビューでInkling 2 Smallを使ったと述べています。これはホスト型プレビューについての個人的な話であり、ローカル推論や現在の提供状況を示しません。元のコメント。
ダウンロード前に経路を決める
現行条件を読む。 Apache 2.0とモデルAUPを確認します。組織の審査手順があれば両方提出します。
自前運用が必要か決める。 公開VRAM要件を実際のGPUとサービングフレームワークに照らします。容量が足りなければAPIを先に比較します。
チェックポイントと実行環境をセットで選ぶ。 現行レシピが選択した形式に対応するか確認します。
全体コストを確認する。 ローカルならGPU、電力、運用を、APIなら料金、上限、地域、データ条件を確認します。この記事では費用を試算していません。
非機密データで試す。 モデルとプロバイダーを記録し、結果を確認してから本番ワークフローにつなぎます。
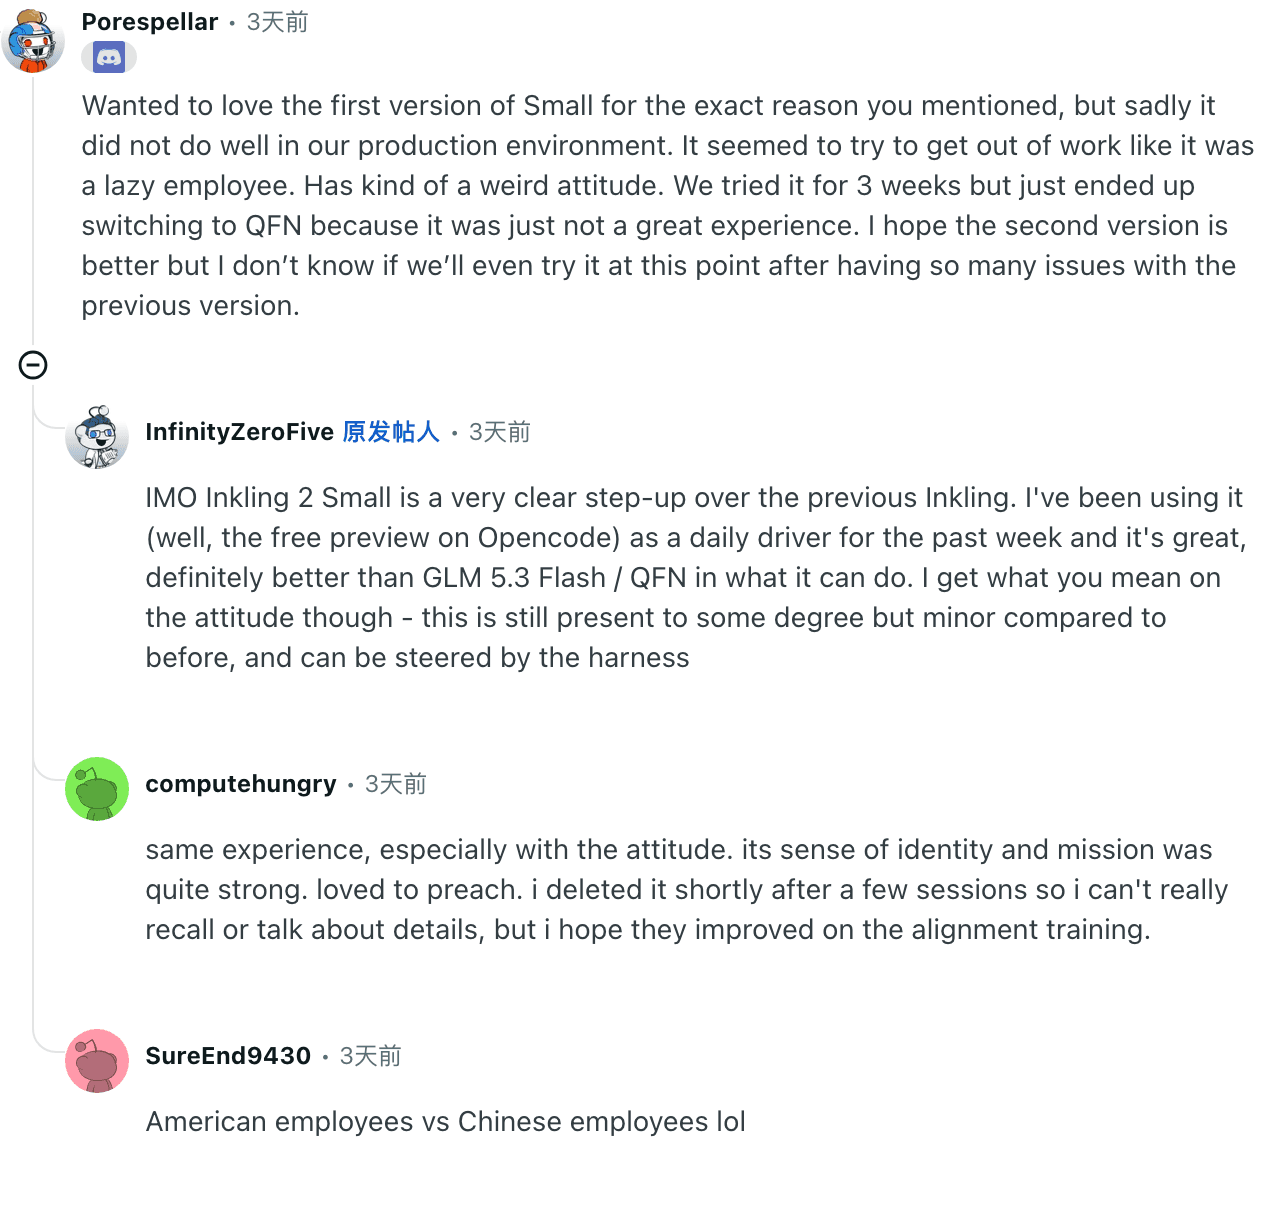
あるユーザーは初代Inklingが自分たちの本番環境でうまくいかなかったと報告し、別の人はInkling 2 Smallの無料プレビューを1週間使って好印象だったと述べています。バージョンとホスト環境が異なるため、自分の結果は予測できません。自分のタスクを試す理由として扱ってください。初代の報告・Inkling 2のプレビュー報告
ブラウザー操作は別の層
選んだagentがTabbit CLIまたはskillに対応するなら、Tabbit Browserでブラウザー作業ができます。TabbitはInklingをホストせず、重みをロードせず、APIも提供しません。モデルの接続先、agent、ブラウザー接続は別々です。
ログイン済みサイトをagentで操作したい場合は、既存のInkling 2 Smallブラウザー利用ガイドでローカルagentとTabbit CLIの読み取り専用フローを確認できます。これはホスト型モデル経路向けで、自己ホストしたInklingの接続性を証明しません。Tabbit CLIガイド、既存ブラウザーへの接続手順、最初のタスク確認表も参照してください。接続方法はBrowser MCPとCLIの比較で確認できます。
既にサインインしたページを読む仕事ならTabbitが役立つ場合があります。モデルサーバーや重みのダウンロード先としては使えません。Codexの設定とagentによるブラウザー操作の概要が境界を説明します。OpenCodeならログイン済みブラウザーの設定とセッション再利用ガイドを参照してください。この記事ではInklingとTabbitのモデル連携をテストしていません。
結論:重みは公開済み、ローカル運用の要件は高い
Inkling 2 SmallはApache 2.0表示の重みが公開され、モデルカードにローカル推論とAPIの選択肢があります。しかし「オープン」は、小型・低運用コスト・すぐ実行可能という意味ではありません。NVFP4で500 GB、MXFP8で800 GBという公式要件を見て、まずサーバーを用意できるか、プロバイダーに任せるか決めてください。
ダウンロード前に現行ライセンスとAUPを確認し、対応するチェックポイントとフレームワークを選びます。APIを使う場合はプロバイダーごとの条件を読みます。ブラウザー自動化は別の手順です。Tabbitが接続するのはブラウザーで、モデルは実行しません。

よくある質問
Inkling 2 Smallはオープンソースですか?
Thinking Machinesはオープンウェイトと説明し、Hugging FaceのモデルカードはApache 2.0を表示しています。カードは別個の利用許容ポリシーにもリンクしています。学習データ、学習工程全体、各プロバイダーのサービスまで公開されているという意味ではありません。
一般的なデスクトップGPUで実行できますか?
公式カードによると、NVFP4には合計500 GB以上のVRAMが必要で、B300を2基またはH200を4基使う構成が例示されています。MXFP8は800 GBです。ローカル運用を計画する前に最新の要件を確認してください。
どのチェックポイントを選べばよいですか?
モデルカードは学習にも使われたNVFP4を推奨しています。MXFP8は評価で1〜2ポイント上回ると記載されていますが、これは提供元の報告で、実用上は意味がないという見解も同カードにあります。必要VRAMも高いため、構成と照らして選んでください。
API経由で使えますか?
はい。Thinking MachinesはNVIDIA、Fireworks、Together、Baseten、Nebius、Modal、CloudflareをAPIプロバイダーとして挙げています。モデルID、料金、提供地域、データ条件は各社で異なるため、接続前に確認してください。
重みをダウンロードすれば無料で実行できますか?
公開リポジトリとApache 2.0ライセンスでも、インフラ費用はなくなりません。ローカル推論には大規模なGPU環境が必要で、ホスト型APIは従量課金の場合があります。選んだプロバイダーの料金と利用条件を確認してください。
Tabbit BrowserはInkling 2 Smallをホストまたは実行しますか?
いいえ。Tabbitは対応するagentとCLIのワークフローでブラウザー操作を支援しますが、モデルのホストや重みの展開はしません。モデルの接続先、agentの実行環境、ブラウザー接続は別の要素です。