
Inkling 2 Small 权重已在 Hugging Face 开放下载,模型卡标注 Apache 2.0。但下载只是第一步。官方模型卡称,NVFP4 本地推理至少需要 500 GB 聚合显存,MXFP8 需要 800 GB。如果你没有这样的 GPU 集群,API 通常更现实。请看 Thinking Machines 的发布更新 和官方模型卡。
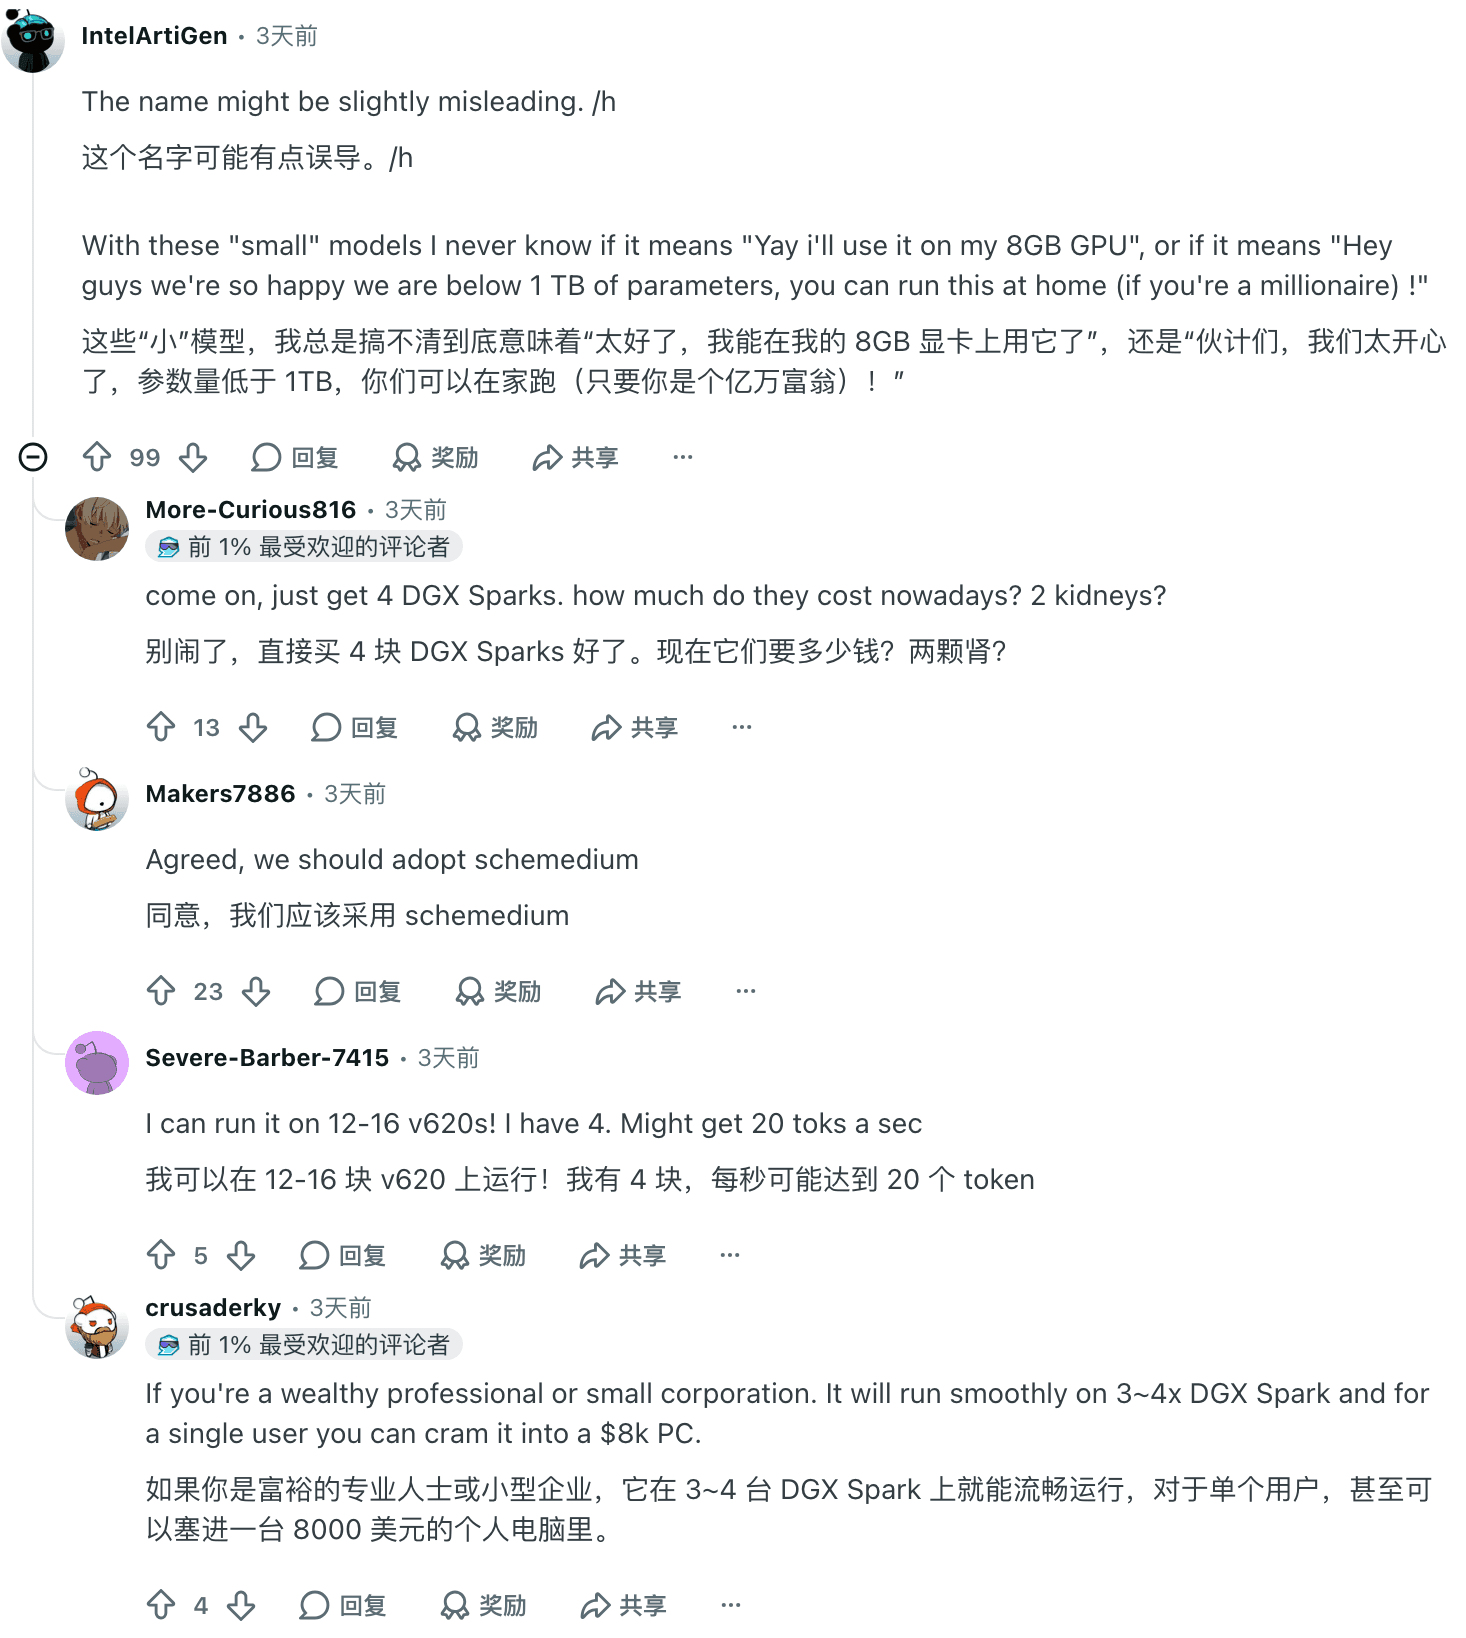
一位 Reddit 用户看到"小型"这个名称时,疑惑它是否能在 8 GB 显卡上运行。这个问题值得先问清楚,再下载庞大的模型文件。"开放权重"描述的是参数可获取,并不意味着普通电脑可以部署。查看原评论。
要点
Thinking Machines 的更新称权重于 2026 年 11 月 12 日开放,Hugging Face 模型卡标注 Apache 2.0。
开放权重不等于训练数据和完整训练流程开源。除了许可,也要读模型的可接受使用政策。
官方卡片对 NVFP4 给出的最低聚合显存是 500 GB,对 MXFP8 是 800 GB。17B 激活参数不是桌面显存需求。
本地推理需要部署框架。API 供应商替你托管模型,但价格、模型 ID、可用地区和数据政策各不相同。
Tabbit Browser 不是模型托管服务。agent 支持 Tabbit CLI 或 skill 时,Tabbit 才能负责浏览器连接这一层。
Inkling 2 Small 的获取方式
| 方式 | 得到什么 | 需要核实 | 适合场景 |
|---|---|---|---|
| 从 Hugging Face 下载权重 | 自行部署或改造用的模型文件。 | Apache 2.0 许可、单独的模型政策、检查点、GPU 能力和框架支持。 | 你有基础设施,需要自己管理推理。 |
| 使用 API 供应商 | 通过供应商端点托管推理。 | 当前模型 ID、价格、地区、输入限制、工具支持、数据保留和服务条款。 | 不想运维大型 GPU 集群。 |
| 使用 Tinker | Thinking Machines 的采样与微调平台。 | 当前访问资格、平台条款、模型模式和价格。 | 需要厂商的训练流程或 Tinker 托管访问。 |
三种方式不能互换。下载只是模型文件,不会自动变成服务端点;API 是托管服务,也不代表你拥有权重;微调又是另一件事。Thinking Machines 表示权重已在 Hugging Face 发布,模型卡列出本地推理框架和第三方 API 供应商。Tinker 模型文档列出 Inkling 2 Small 及单独的 256K 版本,标识只适用于 Tinker。发布更新列出其他供应商;Cloudflare 文档展示了一个 API 路由,并注明需要付费访问。本文不引用即时价格,也没有调用付费端点。
Apache 2.0 许可具体说明什么
Hugging Face 模型卡将许可标为 apache-2.0,并链接到 Thinking Machines 的模型可接受使用政策。厂商表示该政策适用于模型权重、参数和相关材料的访问及使用。用于产品前应同时阅读两份文件,不能只看许可标签就认为所有使用场景都没有额外条件。
这里使用"开放权重"比"完全开源"更准确:模型参数可以依照所列条款下载,但这不能证明训练数据、训练代码或整个开发过程都已公开。第三方 API 的价格和数据处理也不由权重许可决定,需逐家查看服务条款。
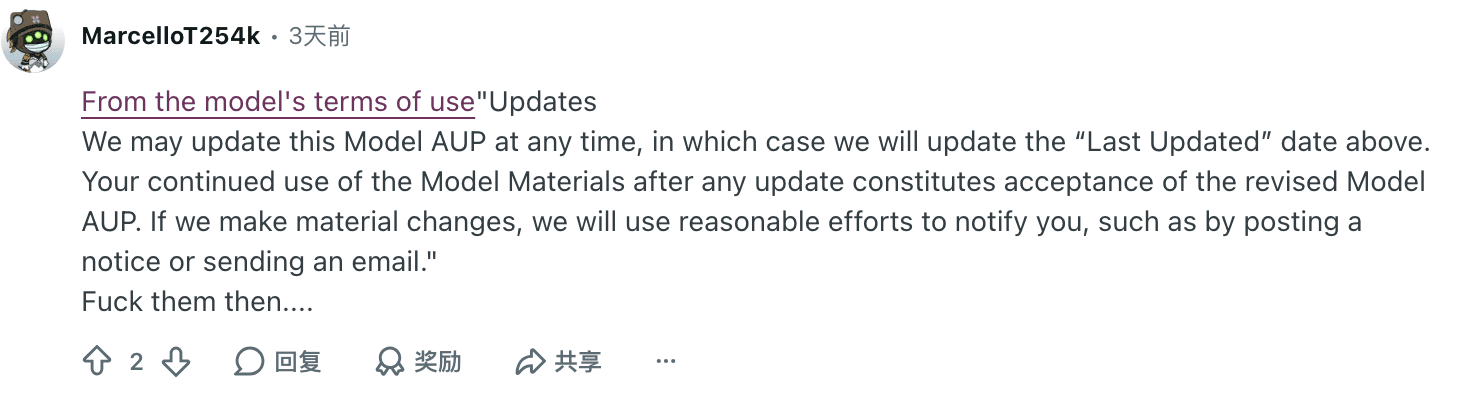
一位评论者引用了模型政策可更新的文字。这提醒读者应查看当前政策,而不是只依赖截图或摘要。政策页面标注的更新时间是 2026 年 7 月 15 日,调研日期为 11 月 16 日。原评论。
本地推理需要大型 GPU 集群
模型卡将 Inkling 2 Small 描述为 5940 亿总参数、170 亿激活参数。"激活"描述每个 token 使用的混合专家部分,不代表只需加载一个 170 亿参数版本。部署前应以官方检查点要求为准。
| 检查点 | 厂商列出的聚合显存 | 模型卡举例配置 | 厂商建议 |
|---|---|---|---|
| NVFP4 | 至少 500 GB | 2 张 NVIDIA B300 或 4 张 H200 | Thinking Machines 推荐;模型以 NVFP4 完成训练。 |
| MXFP8 | 至少 800 GB | 4 张 NVIDIA B300 或 8 张 H200 | 卡片称评测高 1–2 个百分点,但认为对实际使用没有意义。 |
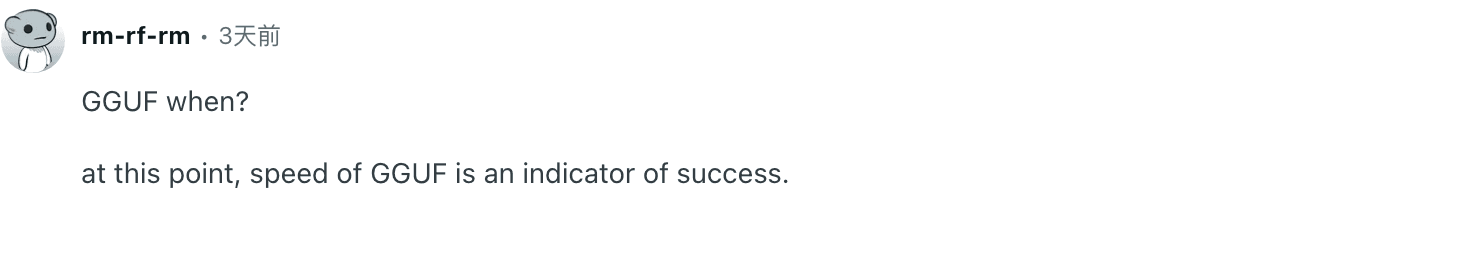
这些是厂商给出的要求和示例,不是本文测试结果。数字指 GPU 显存总量,不是普通系统内存。单张 8 GB 显卡与表中配置相差很大。r/LocalLLaMA 有用户追问是否会提供 GGUF 版本,但提问不能证明该格式已经发布或尚未发布。原评论。
模型卡列出 SGLang、vLLM、TokenSpeed、Unsloth 和 Hugging Face 作为本地推理选项。下载前先查看当前框架配方是否支持对应检查点、硬件和版本。官方推荐 NVFP4,但没有说所有框架的步骤或性能都相同。
什么时候 API 更合适
如果你没有多 GPU 服务器,可以先比较托管 API。Thinking Machines 列出 NVIDIA、Fireworks、Together、Baseten、Nebius、Modal 和 Cloudflare。Cloudflare 文档提供模型 ID @cf/thinkingmachines/inkling-2-small,展示 Workers 与 OpenAI 兼容接口,并注明需要付费访问。这只能证明 Cloudflare 有此路径,不能代表其他供应商的价格或条款。
接入前,逐项核实地区和账号可用性、准确模型 ID 与 API 格式、输入输出限制和价格、提示词与图片的处理政策,以及端点是否支持你所需的工具或模态。不能因为权重可以下载,就假设 API 免费。
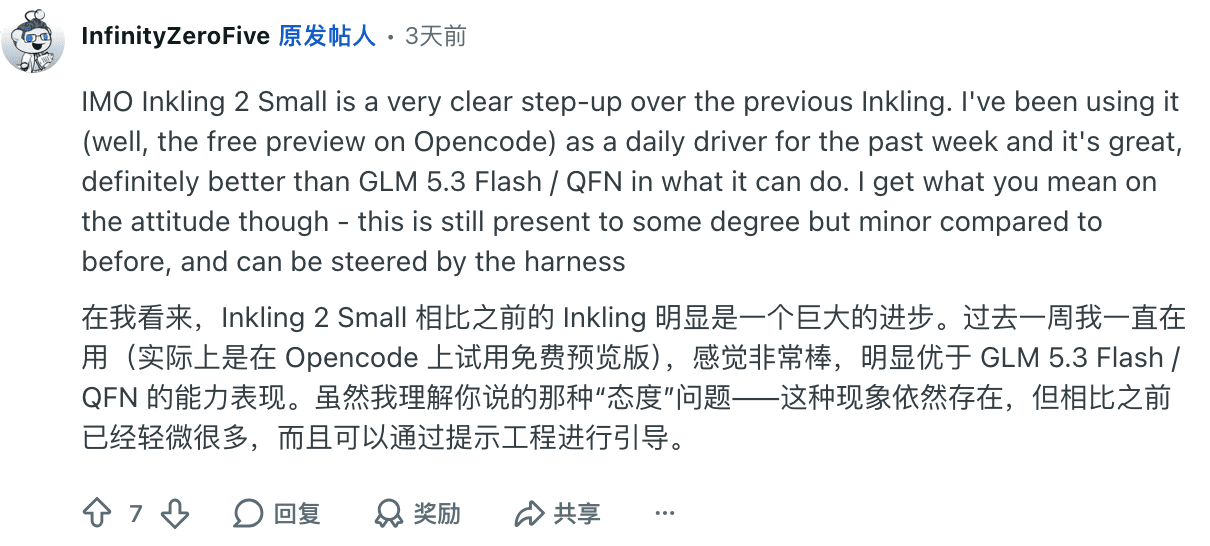
一位 Reddit 用户提到,自己曾通过 OpenCode 的免费预览版使用 Inkling 2 Small。这是对托管预览的个人描述,不证明本地推理能力或当前访问状态。原评论。
下载前先确定路线
读当前条款。 同时核对 Apache 2.0 许可和模型 AUP。企业部署按组织的模型审批流程处理。
确定是否必须自托管。 若必须在自有环境推理,应把官方显存要求和现有服务器逐项核对。没有足够 GPU 时,先比较 API。
一起选择检查点和框架。 模型卡列有两种格式和多个框架,先确认框架配方支持你选的检查点。
估算完整成本。 本地运行需考虑 GPU、电力和运维;API 要查看价格、配额、地区和数据条款。本文不估算账单。
用非敏感输入试跑。 记录准确的模型与供应商标识,检查结果后再接入生产流程。
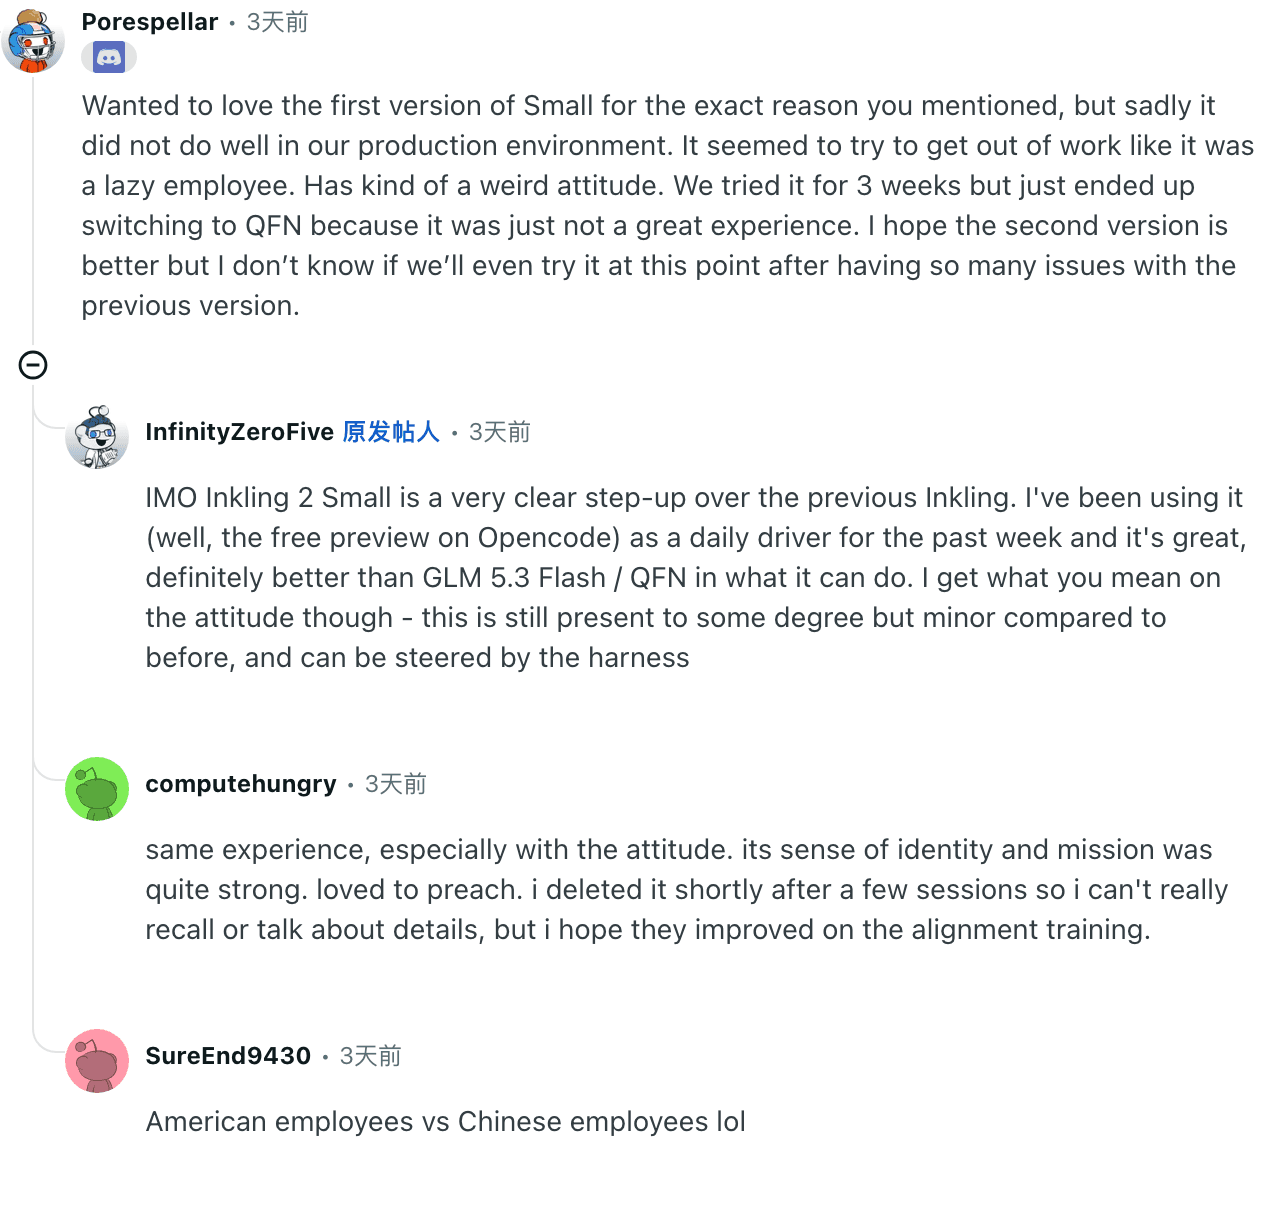
一位用户说初代 Inkling 在他们的生产环境表现不理想;另一位用户则称曾在免费预览版上连续使用一周。这两种体验涉及不同版本和托管条件,不能证明 Inkling 2 Small 在你的环境表现如何。它们只说明应先用自己的任务试点。初代体验 · Inkling 2 预览体验
浏览器工作属于另一层
当你选择的 agent 支持 Tabbit CLI 或 skill 时,Tabbit Browser 可以负责浏览器任务。它不会托管 Inkling、加载权重或提供 API。模型端点、调用模型的 agent 和浏览器连接是三项独立配置。
如果你要用 Inkling 操作已登录网站,Inkling 2 Small 浏览器指南介绍了 agent 加 Tabbit CLI 的只读流程。它针对托管模型路线编写,不能证明自托管 Inkling 端点能接入该客户端。可先看 Tabbit CLI 指南、连接现有浏览器和首次任务检查清单。要比较连接方式,请看Browser MCP 与 CLI。
当任务需要读取浏览器中已登录账号的页面时,Tabbit 可能适合。若你需要模型服务器或权重下载位置,它就不是对应组件。Codex 设置指南与agent 浏览器控制说明解释了这条边界。OpenCode 用户可看登录浏览器设置及复用登录状态的指南。本文没有测试 Inkling 与 Tabbit 的模型集成。
结论:权重可获取,本地运行门槛很高
Inkling 2 Small 的公开模型卡标注 Apache 2.0,并列出了本地推理和 API 路径。但"开放"不等于小型、低成本或开箱即用。官方卡片给出的 NVFP4 500 GB 和 MXFP8 800 GB 聚合显存要求,足以帮助多数团队先作判断:你有合适的服务器,还是应该找供应商托管?
下载前核对当前许可与 AUP,选好受支持的检查点和框架;如果更倾向 API,则逐家查看条款。如果下一步是浏览器自动化,请把浏览器指南作为单独流程来读。Tabbit 能提供浏览器连接,不会运行模型。

常见问题
Inkling 2 Small 是开源模型吗?
Thinking Machines 将其称为开放权重模型,Hugging Face 模型卡标注 Apache 2.0。模型卡还链接了单独的可接受使用政策。这并不代表训练数据、完整训练流程或所有供应商服务都已开源。
普通桌面显卡能运行 Inkling 2 Small 吗?
官方模型卡称 NVFP4 至少需要 500 GB 聚合显存,并举例 2 张 B300 或 4 张 H200。MXFP8 的要求是 800 GB。规划本地部署前应对照当前模型卡核实实际 GPU 配置。
应该选择哪个检查点?
模型卡推荐 NVFP4,这是训练时使用的格式。卡片称 MXFP8 在评测上高 1–2 个百分点,属于厂商数据,且厂商认为对实际用途没有意义。MXFP8 的硬件门槛更高,应按自己的配置选择。
可以通过 API 使用 Inkling 2 Small 吗?
可以。Thinking Machines 列出 NVIDIA、Fireworks、Together、Baseten、Nebius、Modal 和 Cloudflare 等 API 供应商。模型 ID、价格、地区可用性和数据条款因供应商而异,接入前要核实对应文档。
下载权重后就能免费运行吗?
公开模型仓库和 Apache 2.0 许可不会消除基础设施成本。本地服务需要大量 GPU 资源,托管 API 也可能按量收费。请查看所选供应商当前的价格与服务条款。
Tabbit Browser 会托管或运行 Inkling 2 Small 吗?
不会。Tabbit 通过受支持的 agent 与 CLI 流程处理浏览器任务,不托管模型,也不部署模型权重。模型接入、agent 运行时和浏览器连接是不同选择。