
Inkling 2 Small 웨이트는 Hugging Face에서 받을 수 있으며 모델 카드에는 Apache 2.0이 표시됩니다. 하지만 다운로드가 실행을 뜻하지는 않습니다. 공식 모델 카드는 NVFP4 로컬 추론에 통합 VRAM 최소 500GB, MXFP8에는 800GB를 요구합니다. 이런 GPU 클러스터가 없다면 호스팅 API가 더 현실적일 수 있습니다. Thinking Machines 업데이트와 공식 모델 카드를 확인하세요.
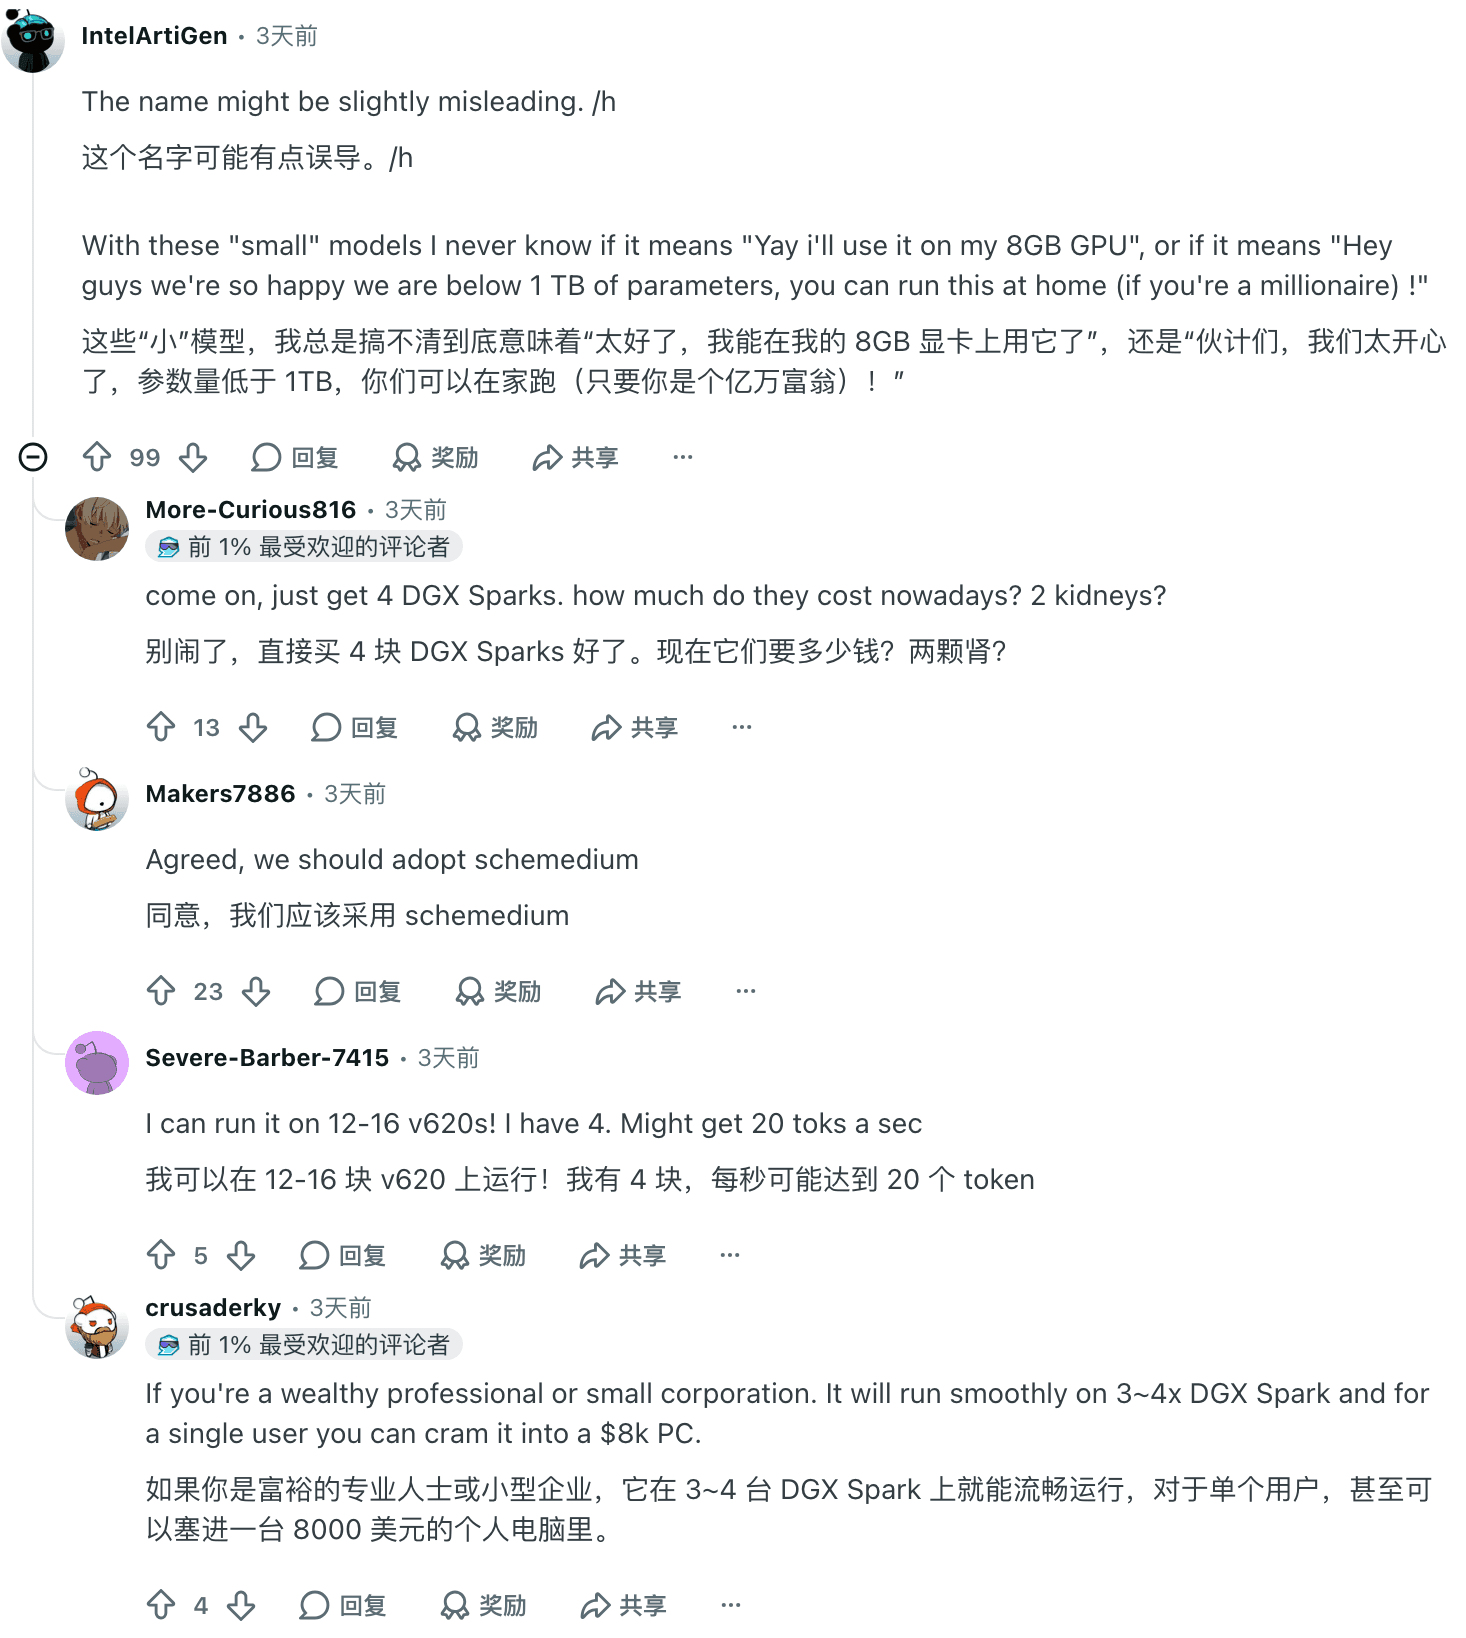
Reddit 사용자는 이름에 "Small"이 들어가면 8GB GPU에서도 돌릴 수 있는지 궁금하다고 했습니다. 수백 GB의 파일을 받기 전에 확인할 부분입니다. "오픈 웨이트"는 파라미터를 받을 수 있다는 뜻이지, 일반 PC에서 서빙된다는 뜻은 아닙니다. 원 댓글.
핵심 요약
Thinking Machines는 외부 안전성 테스트 후 2026년 11월 12일 웨이트가 공개됐다고 밝혔습니다. Hugging Face 모델 카드는 Apache 2.0을 표시합니다.
오픈 웨이트가 학습 데이터와 전체 학습 과정의 공개를 뜻하지는 않습니다. 별도 허용 사용 정책도 읽으세요.
공식 카드가 요구하는 통합 VRAM은 NVFP4 500GB 이상, MXFP8 800GB입니다. 활성 파라미터 17B는 데스크톱 메모리 요구량이 아닙니다.
로컬 추론에는 서빙 프레임워크가 필요합니다. API 공급자는 모델을 호스팅하지만 가격, 모델 ID, 지역 제공 여부, 데이터 정책은 각각 다릅니다.
Tabbit Browser는 모델 호스트가 아닙니다. agent가 Tabbit CLI나 skill을 지원할 때 브라우저 연결을 담당할 수 있습니다.
Inkling 2 Small 이용 경로
| 경로 | 얻는 것 | 확인할 항목 | 적합한 경우 |
|---|---|---|---|
| Hugging Face에서 웨이트 다운로드 | 직접 배포하거나 조정할 모델 파일. | Apache 2.0, 별도 모델 정책, 체크포인트, GPU 용량, 프레임워크 지원. | 인프라를 관리하고 추론을 직접 운영할 때. |
| API 공급자 이용 | 공급자가 호스팅하는 추론. | 현재 모델 ID, 가격, 지역, 제한, 도구 지원, 데이터 보존, 약관. | 대규모 GPU 클러스터를 운영하고 싶지 않을 때. |
| Tinker 이용 | Thinking Machines의 샘플링 및 파인튜닝 플랫폼. | 현재 접근, 플랫폼 약관, 모델 모드와 가격. | Tinker의 학습 흐름 또는 호스팅 경로가 필요할 때. |
세 경로는 서로 다른 선택입니다. 다운로드는 모델 파일이지 실행 중인 엔드포인트가 아니며, API는 웨이트를 보유했다는 증명이 아닙니다. 파인튜닝은 또 다른 작업입니다. Thinking Machines는 Hugging Face 배포를 발표했고 모델 카드는 로컬 추론 프레임워크와 API 공급자를 열거합니다. Tinker 모델 문서에는 Inkling 2 Small과 별도 256K 버전이 나오며, ID는 Tinker 전용입니다. 출시 업데이트에는 다른 공급자도 나옵니다. Cloudflare 모델 문서는 구체적인 API 경로와 유료 접근 조건을 보여 줍니다. 이 글은 현재 가격을 인용하지 않고 유료 API도 호출하지 않습니다.
Apache 2.0이 설명하는 것
Hugging Face 모델 카드에는 apache-2.0이 표시되어 있으며 Thinking Machines의 모델 허용 사용 정책으로 연결됩니다. 회사는 이 정책이 모델 웨이트, 파라미터 및 관련 자료에 대한 접근과 사용에 적용된다고 설명합니다. 제품에 넣기 전에 두 문서를 함께 읽으세요. 라이선스 표시만으로 모든 사용 조건을 알 수는 없습니다.
여기서는 "완전 오픈 소스"보다 "오픈 웨이트"가 정확합니다. 파라미터를 제시된 조건에 따라 받을 수 있다는 뜻이지, 학습 데이터나 학습 코드, 개발 과정 전체가 공개됐다는 증거는 아닙니다. 제3자 API의 가격과 데이터 처리도 웨이트 라이선스가 정하지 않습니다.
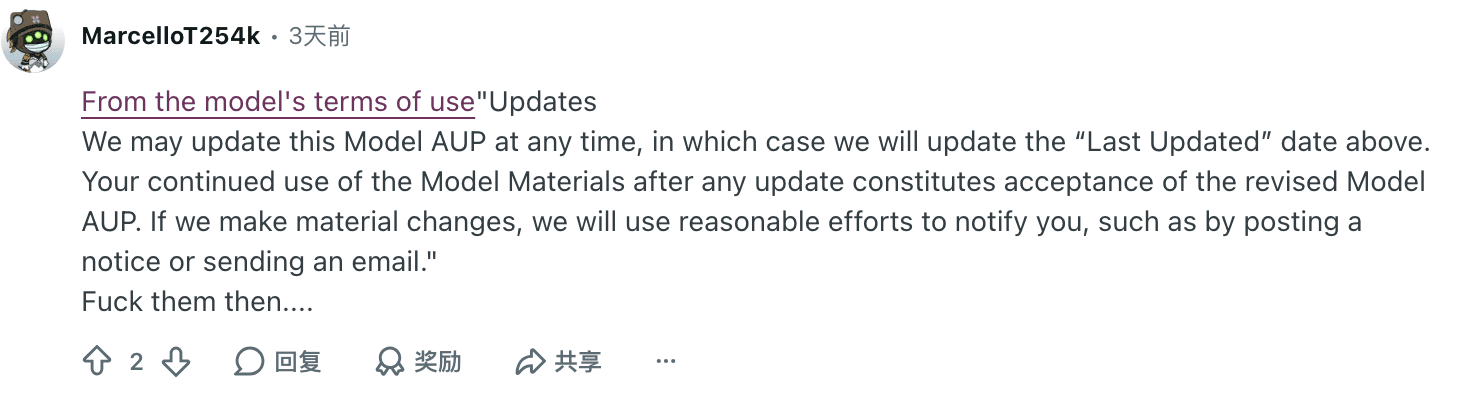
한 댓글 작성자는 모델 AUP가 갱신될 수 있다는 문구를 인용했습니다. 스크린샷이나 요약에 의존하지 말고 현재 정책을 읽으라는 신호로 보세요. 조사 당시 정책 페이지의 갱신일은 2026년 7월 15일이었습니다. 원 댓글.
로컬 추론에는 큰 GPU 클러스터가 필요합니다
모델 카드는 전체 594B, 활성 17B 파라미터로 설명합니다. "활성"은 토큰마다 사용되는 MoE 부분을 뜻하며 일반 PC에서 실행 가능한 17B 버전이라는 뜻이 아닙니다. 배포 계획에는 공개된 체크포인트 요구사항을 사용하세요.
| 체크포인트 | 제공자 명시 통합 VRAM | 모델 카드의 구성 예 | 제공자 안내 |
|---|---|---|---|
| NVFP4 | 최소 500GB | NVIDIA B300 2개 또는 H200 4개 | Thinking Machines 권장. 모델이 NVFP4로 학습됐습니다. |
| MXFP8 | 최소 800GB | NVIDIA B300 4개 또는 H200 8개 | 평가는 1~2%포인트 높다고 보고했지만 실용적 의미는 작다는 설명입니다. |
표의 수치는 제공자가 밝힌 요구사항과 예시이지 이 글에서 측정한 결과가 아닙니다. GPU VRAM 합계이며 시스템 RAM이 아닙니다. 8GB 그래픽 카드 한 장은 해당 구성과 거리가 멉니다. r/LocalLLaMA 사용자는 GGUF 버전 출시 시점을 물었지만, 그 질문만으로 형식의 출시 여부를 알 수는 없습니다. 원 댓글.
모델 카드는 로컬 추론용으로 SGLang, vLLM, TokenSpeed, Unsloth, Hugging Face를 열거합니다. 다운로드 전에 현재 프레임워크 레시피가 체크포인트, 하드웨어, 버전을 지원하는지 확인하세요. NVFP4를 권장하지만 각 프레임워크의 설정이나 성능이 같다는 뜻은 아닙니다.
API가 더 적합한 경우
멀티 GPU 서버가 없다면 호스팅 API부터 비교하세요. Thinking Machines는 NVIDIA, Fireworks, Together, Baseten, Nebius, Modal, Cloudflare를 열거합니다. Cloudflare 문서는 모델 ID를 @cf/thinkingmachines/inkling-2-small로 표시하고 Workers 및 OpenAI 호환 엔드포인트를 보여 주며 유료 접근이 필요하다고 설명합니다. 이는 Cloudflare 경로의 예이며 다른 공급자의 가격이나 약관을 대신하지 않습니다.
앱을 연결하기 전 지역과 계정의 사용 가능성, 정확한 모델 ID와 API 형식, 입력·출력 한도와 가격, 프롬프트 및 이미지 정책, 필요한 도구나 모달리티 지원을 확인하세요. 웨이트를 받을 수 있다는 이유로 API까지 무료라고 가정하지 마세요.
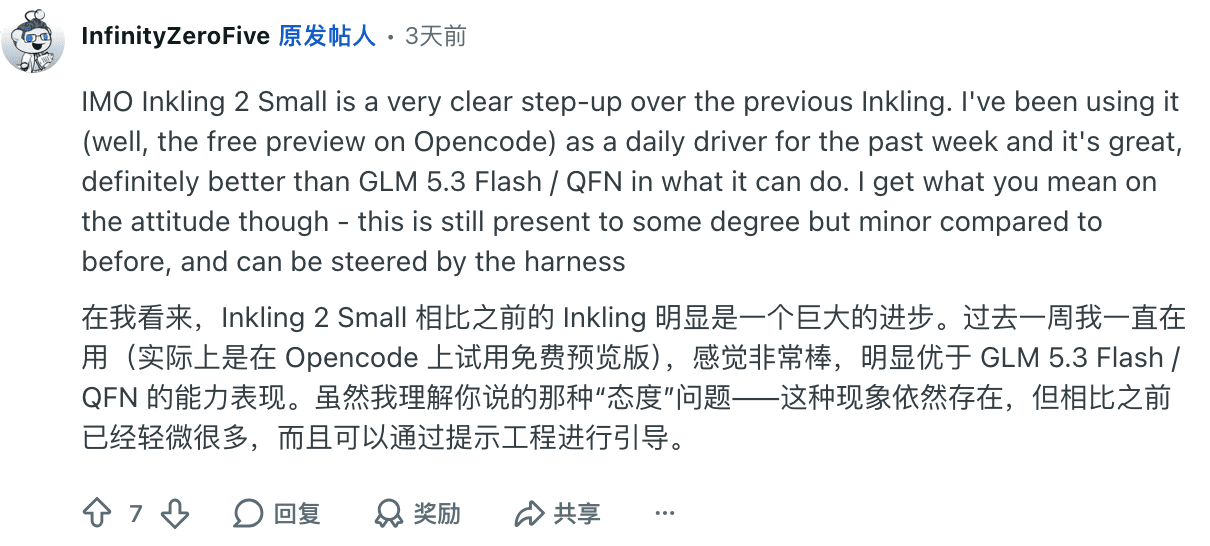
Reddit 사용자는 OpenCode 무료 프리뷰에서 Inkling 2 Small을 썼다고 설명했습니다. 이는 호스팅 프리뷰에 관한 개인 경험이지 로컬 추론이나 현재 제공 여부를 증명하지 않습니다. 원 댓글.
다운로드 전에 경로를 정하세요
현재 약관을 읽습니다. Apache 2.0과 모델 AUP를 확인하세요. 회사 승인이 필요하면 둘 다 절차에 넣습니다.
직접 호스팅할지 결정합니다. 공식 VRAM 요건을 실제 GPU와 프레임워크에 대조하세요. 용량이 부족하면 API를 먼저 비교합니다.
체크포인트와 런타임을 함께 고릅니다. 현재 레시피가 선택한 형식을 지원하는지 확인하세요.
전체 비용을 계산합니다. 로컬은 GPU, 전력과 운영을, API는 가격, 한도, 지역과 데이터 조건을 확인하세요. 이 글은 비용을 산출하지 않습니다.
민감하지 않은 입력으로 시험합니다. 모델과 공급자 ID를 기록하고 결과를 확인한 뒤 운영 흐름에 연결하세요.
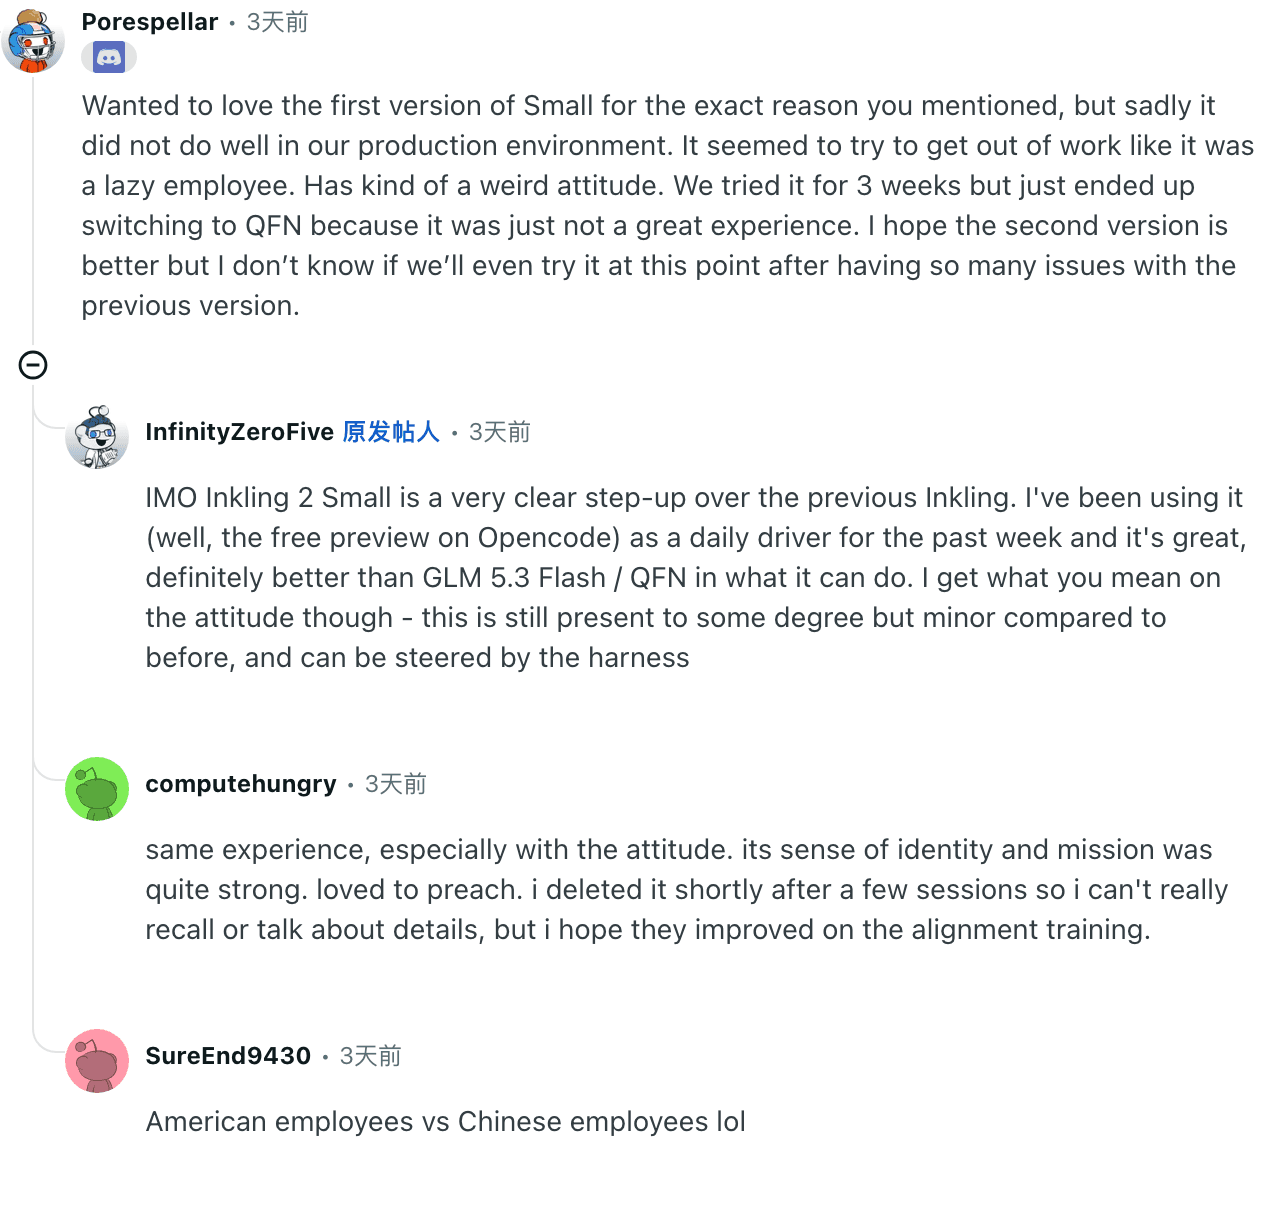
한 사용자는 첫 Inkling이 자신의 프로덕션 환경에서 잘 작동하지 않았다고 했고, 다른 사용자는 Inkling 2 Small 무료 프리뷰를 일주일간 썼다고 했습니다. 버전과 호스팅 조건이 다르므로 여러분의 결과를 예측하지는 못합니다. 직접 과제를 시험해야 하는 이유로만 보세요. 첫 모델 경험 · Inkling 2 프리뷰 경험
브라우저 작업은 별도 계층입니다
선택한 agent가 Tabbit CLI나 skill을 지원할 때 Tabbit Browser가 브라우저 작업을 맡을 수 있습니다. Inkling을 호스팅하거나 웨이트를 로드하거나 API를 제공하지는 않습니다. 모델 엔드포인트, agent, 브라우저 연결은 분리된 구성 요소입니다.
로그인된 사이트에서 Inkling으로 작업하려면 기존 Inkling 2 Small 브라우저 사용 가이드에서 로컬 agent와 Tabbit CLI의 읽기 전용 절차를 볼 수 있습니다. 해당 가이드는 호스팅 모델 경로를 다루며 자체 호스팅한 Inkling의 연결을 증명하지 않습니다. Tabbit CLI 가이드, 기존 브라우저 연결 안내, 첫 작업 체크리스트와 Browser MCP·CLI 비교를 참고하세요.
이미 로그인된 페이지를 읽어야 한다면 Tabbit이 맞을 수 있습니다. 모델 서버나 웨이트 다운로드가 목적이라면 해당하지 않습니다. Codex 설정과 agent 브라우저 제어 안내가 경계를 설명합니다. OpenCode 사용자는 로그인 브라우저 설정과 세션 재사용 안내를 볼 수 있습니다. 이 글에서는 Inkling과 Tabbit 모델 통합을 시험하지 않았습니다.
결론: 웨이트는 공개됐지만 로컬 실행 요건은 높습니다
Inkling 2 Small은 Apache 2.0 표시로 웨이트가 공개됐고 모델 카드에는 로컬 추론과 API 경로가 나와 있습니다. 그러나 "오픈"이 작거나 저렴하거나 즉시 실행할 수 있다는 뜻은 아닙니다. NVFP4 500GB와 MXFP8 800GB라는 공식 요건을 보고 서버가 있는지, 제공자에게 맡길지 먼저 결정하세요.
다운로드 전에 현재 라이선스와 AUP를 확인하고 지원되는 체크포인트와 프레임워크를 고르세요. API를 선택한다면 공급자 약관을 확인합니다. 브라우저 자동화는 별도의 흐름입니다. Tabbit은 브라우저 연결을 담당할 뿐 모델을 실행하지 않습니다.

자주 묻는 질문
Inkling 2 Small은 오픈 소스인가요?
Thinking Machines는 오픈 웨이트라고 설명하며 Hugging Face 모델 카드에는 Apache 2.0이 표시됩니다. 모델 카드는 별도의 허용 사용 정책에도 연결됩니다. 학습 데이터나 전체 학습 과정, 모든 공급자 서비스까지 오픈 소스라는 뜻은 아닙니다.
일반 데스크톱 GPU에서 Inkling 2 Small을 실행할 수 있나요?
공식 모델 카드에 따르면 NVFP4는 최소 500GB의 통합 VRAM이 필요하며 예시로 B300 2개 또는 H200 4개를 듭니다. MXFP8은 800GB가 필요합니다. 로컬 배포 계획 전에 최신 카드와 실제 GPU 구성을 확인하세요.
어떤 체크포인트를 선택해야 하나요?
모델 카드는 학습에 사용된 NVFP4를 권장합니다. MXFP8은 평가에서 1~2%포인트 높다고 적혀 있지만, 이는 제공자 보고 수치이며 실용적 의미가 작다는 의견도 카드에 있습니다. MXFP8은 하드웨어 요구량도 더 높으므로 구성을 확인하세요.
API로 Inkling 2 Small을 사용할 수 있나요?
가능합니다. Thinking Machines는 NVIDIA, Fireworks, Together, Baseten, Nebius, Modal, Cloudflare를 API 공급자로 나열합니다. 모델 ID, 가격, 지역별 제공 여부, 데이터 조건은 공급자별로 다르므로 앱 연결 전에 문서를 확인하세요.
웨이트를 다운로드하면 무료로 실행할 수 있나요?
공개 저장소와 Apache 2.0 라이선스가 인프라 비용을 없애지는 않습니다. 로컬 서빙에는 대규모 GPU 용량이 필요하며 호스팅 API는 사용료를 청구할 수 있습니다. 선택한 공급자의 현재 가격과 서비스 약관을 확인하세요.
Tabbit Browser가 Inkling 2 Small을 호스팅하거나 실행하나요?
아닙니다. Tabbit은 지원되는 agent와 CLI 워크플로에서 브라우저 작업을 처리하지만 모델을 호스팅하거나 웨이트를 배포하지 않습니다. 모델 경로, agent 실행 환경, 브라우저 연결은 별개의 선택입니다.