
如果任务需要直接读取截图或视频,或你最关注当前官方 API 账单,可以先试 LongCat 2.5。如果必须使用已公开、可自行部署的模型权重,DeepSeek V4 Pro 是目前更明确的选择。对于纯文本编程任务,现有证据不足以判定总冠军。
一个关键差异与跑分无关:LongCat 官方 API 接收图片和视频,而 DeepSeek 当前 V4 Pro API 标注不支持视觉输入。两者都提供约百万 token 的上下文,但相同容量不代表能力相同。本文资料核对日期为 2026 年 11 月 3 日。(LongCat 视觉文档、DeepSeek API)
一位开发者用 LongCat 2.5 Preview 分析五个 C# 类时,报告模型反复思考且未完成任务。这只是预览版的一次运行,不能代表正式版,但说明选模型时需要测试实际编程环境。后文也会介绍如何用 Tabbit Browser 整理资料和复核结果。(Reddit 原帖)
要点
LongCat 2.5 官方 API 支持图片和视频输入;DeepSeek V4 Pro 官方 API 当前为文本输入。
LongCat 每百万 token 限时价为未缓存输入 $0.30、缓存输入 $0.006、输出 $1.20,低于 Pro 的官方峰谷费率。
DeepSeek 已发布 MIT 许可的 V4 Pro 权重;核对时 LongCat 2.5 权重仍标注即将推出。
LongCat Preview 社区反馈有正有负,不应直接套用到 11 月 2 日的正式版。
在 Tabbit 中,同一道算术题各运行一次,两者都算对;这不能证明谁更擅长编程。
LongCat 2.5 与 DeepSeek V4 Pro 一览
| 比较项 | LongCat 2.5 | DeepSeek V4 Pro | 选择时的含义 |
|---|---|---|---|
| 版本 | LongCat-2.5,11 月 2 日发布 | deepseek-v4-pro,当前对应 V4-Pro-0813 | 测试时记录版本和服务商。 |
| 输入 | 文本、图片、视频 | 文本;官方 API 不支持视觉 | 需要直接读图或视频时选 LongCat。 |
| 官方上下文 | 1,048,576 token | 1M token | 容量不等于召回准确率。 |
| 权重 | 标注即将推出 | MIT 许可公开 | 当前需要自行部署时考虑 Pro。 |
| 官方输入 / 输出费率 | $0.30 / $1.20,限时价 | 非峰 $0.66 / $1.98;峰时 $1.32 / $3.96 | 单位均为美元 / 百万 token,并非单次任务价格。 |
| 编程质量 | 有官方数据及预览版反馈 | 有官方数据 | 本文缺少可复核的同 harness 性能测试。 |
美团发布文章称 LongCat 2.5 总参数 1.6 万亿,每个 token 约激活 480 亿;DeepSeek V4 模型卡给 V4 Pro 家族的数字为总参数 1.6 万亿、激活 490 亿。参数量相近不代表质量相同。上下文与价格分别见 LongCat 参数、LongCat 价格和 DeepSeek API 价格页。LongCat 发布页在本次浏览器会话中未显示正文;eesel 的发布报道展示了该页 GitHub 和 Hugging Face 即将推出的标记。部署前请重新核对官方仓库。
LongCat 2.0 总览介绍前代,DeepSeek V4 Pro 总览介绍其发布和获取方式;本文集中回答这两个版本怎么选。
视觉输入决定可以直接提交什么任务
LongCat 2.5 支持以 base64 或公开 URL 传入图片;视频需要公开 URL。官方文档限制每张图片不超过 10 MB,每次最多 50 张;每个视频不超过 100 MB、时长小于 3,600 秒,每次最多 10 个。它输出文本,不直接生成编辑后的图片。格式及限制以视觉文档为准。
例如,截图转页面时,LongCat 可以直接读取截图,再描述布局或生成代码。使用官方 V4 Pro 接口时,需要单独的视觉识别步骤或人工描述。也可以将视觉结果交给 V4 Pro 做后续文本推理,但这会增加步骤、成本和误差来源。
不要把 V4 Pro 和 DeepSeek V4.1 Flash混为一谈。官方价格页为 Flash 标注支持视觉、为 Pro 标注不支持。旧 Flash 接口名已转发到 V4.1 Flash;同一页面仍将 deepseek-v4-pro 列为 V4-Pro-0813,不能把 Flash 的转发说明套到 Pro。
编程证据能说明什么
美团发布资料列出 LongCat 2.5 的代码 Agent 和视觉成绩,但竞品数字混用了自测和公开报告,环境可能不同。DeepSeek 模型卡也有厂商测试结果;把不同厂商的数字拼在一起,不能证明同条件下谁胜出。
预览版用户的反馈值得看,但要保留边界。u/aleamadorq 称 Preview 在 OpenCode 中分析五个 C# 类时反复循环,约 20 分钟未完成。原帖没有完整代码、提示词和重复试验,无法分离模型、服务端和工具的影响。
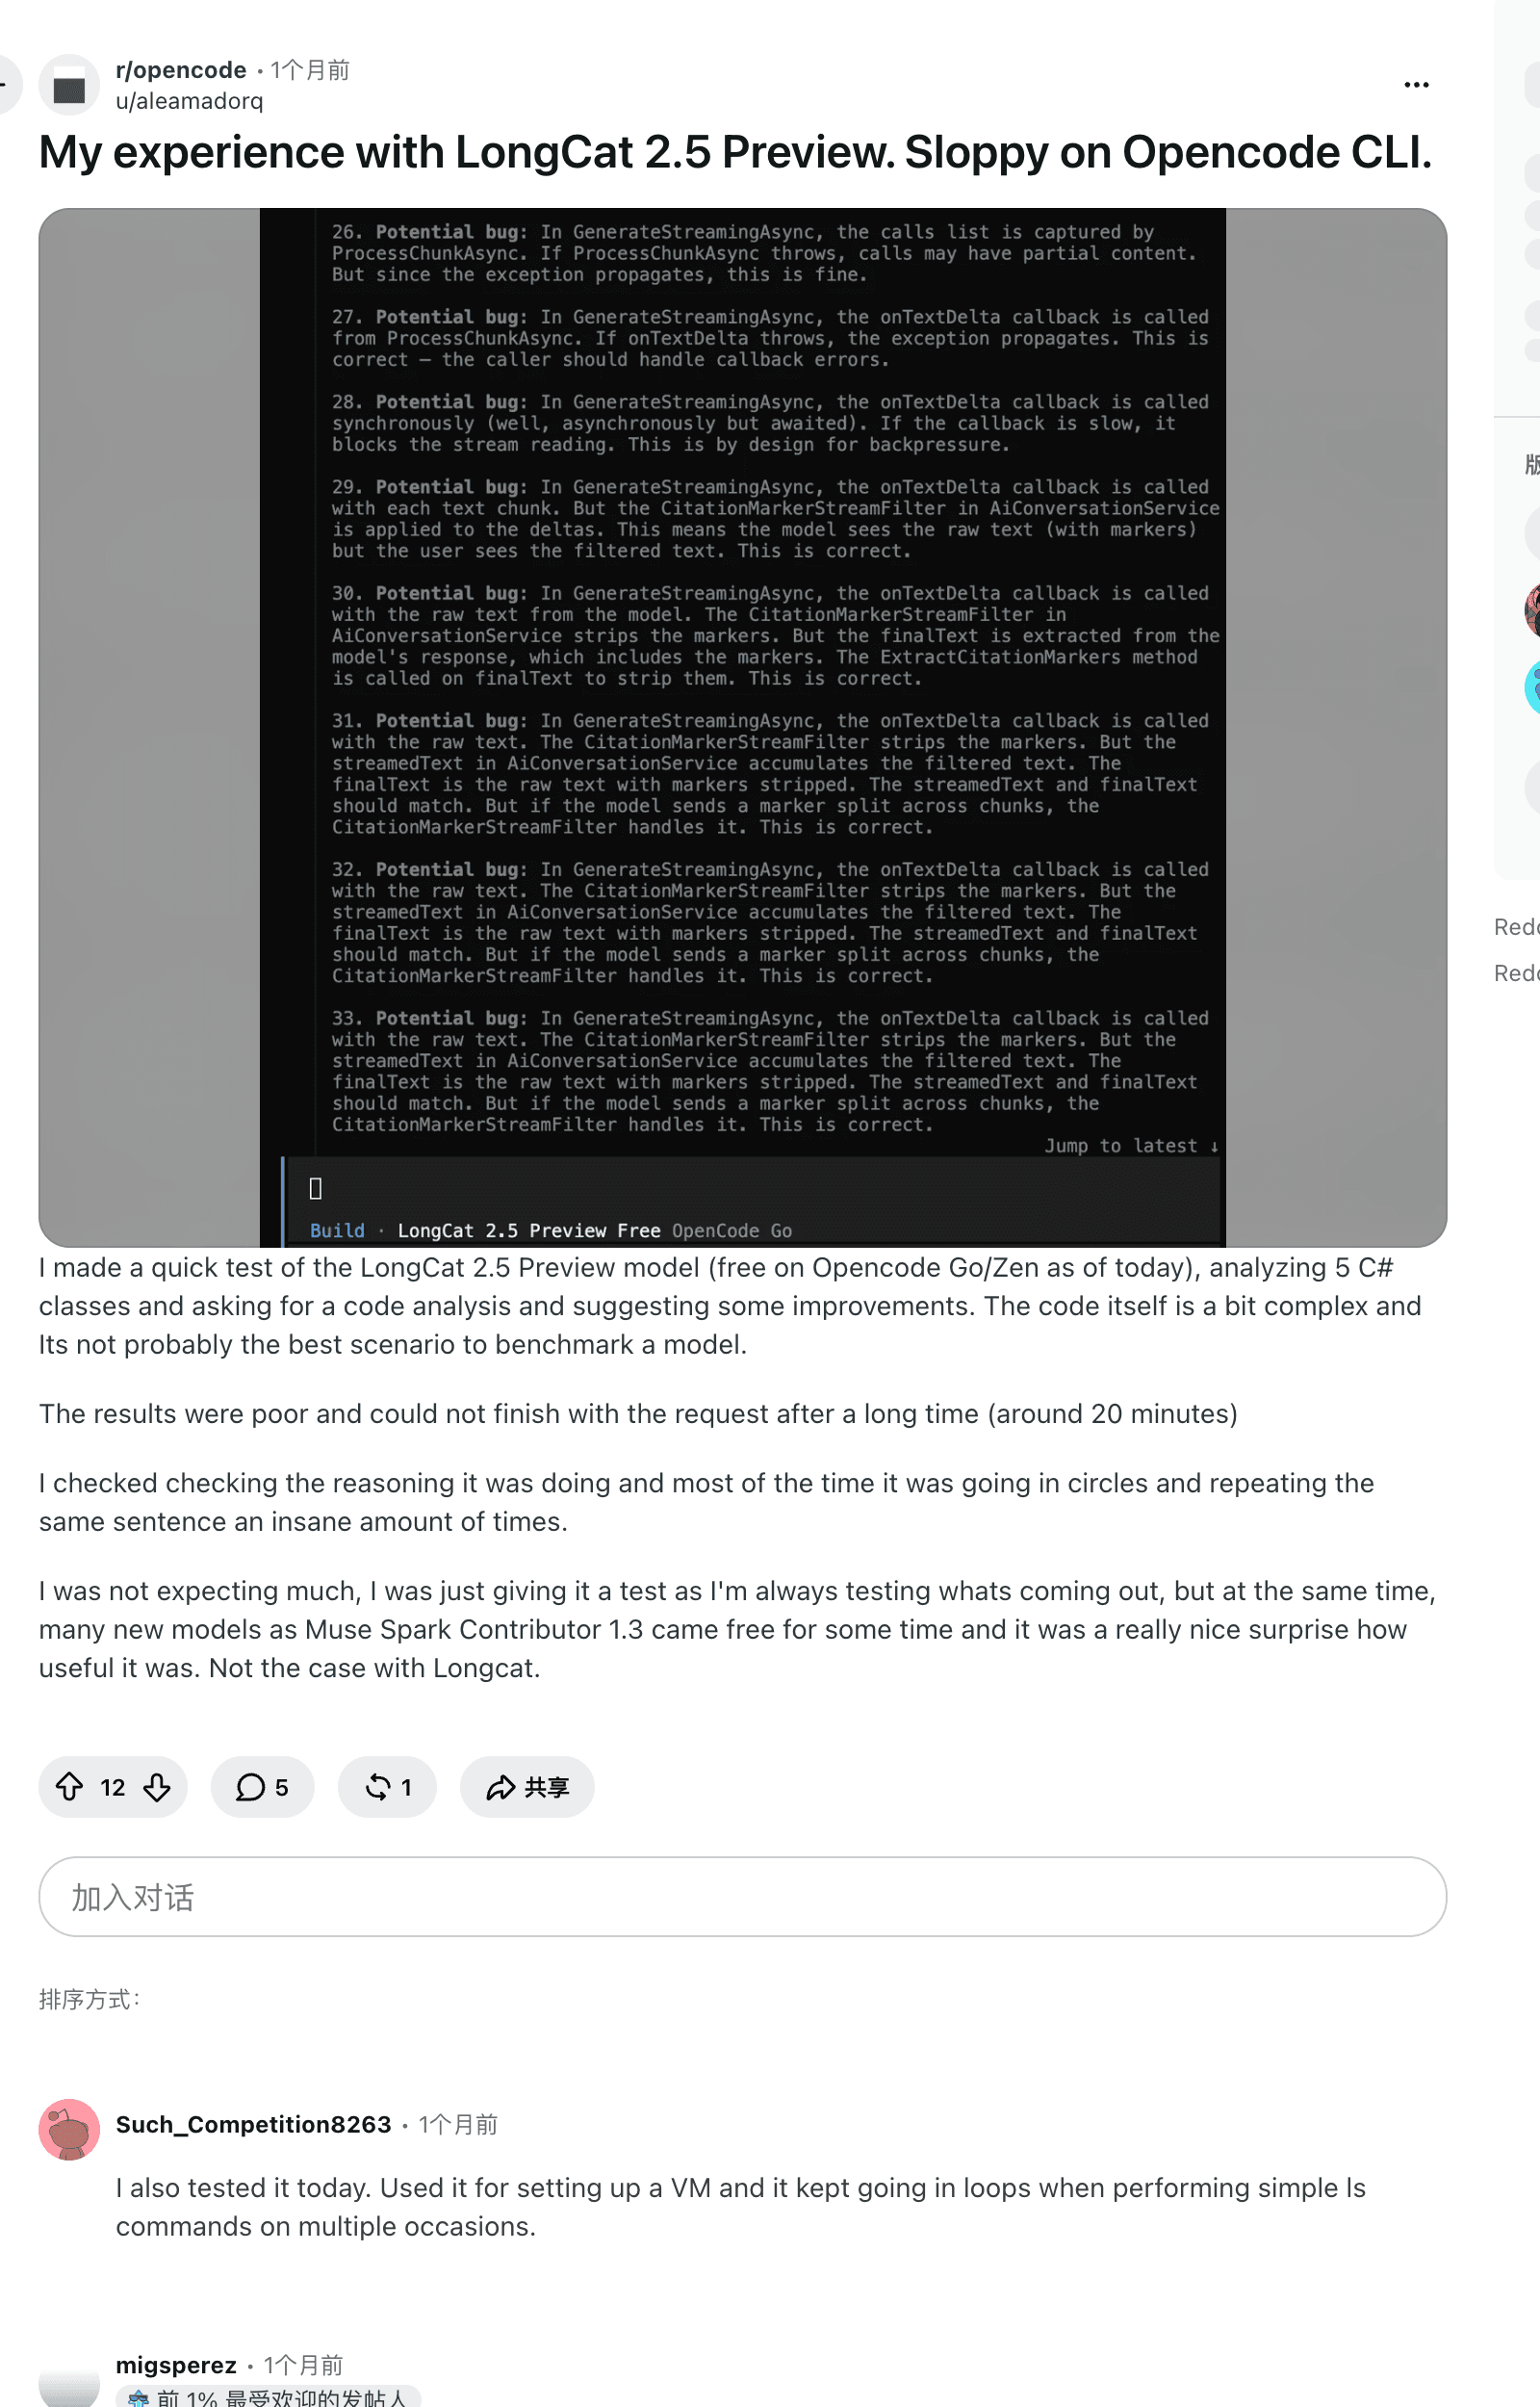
查看原帖。
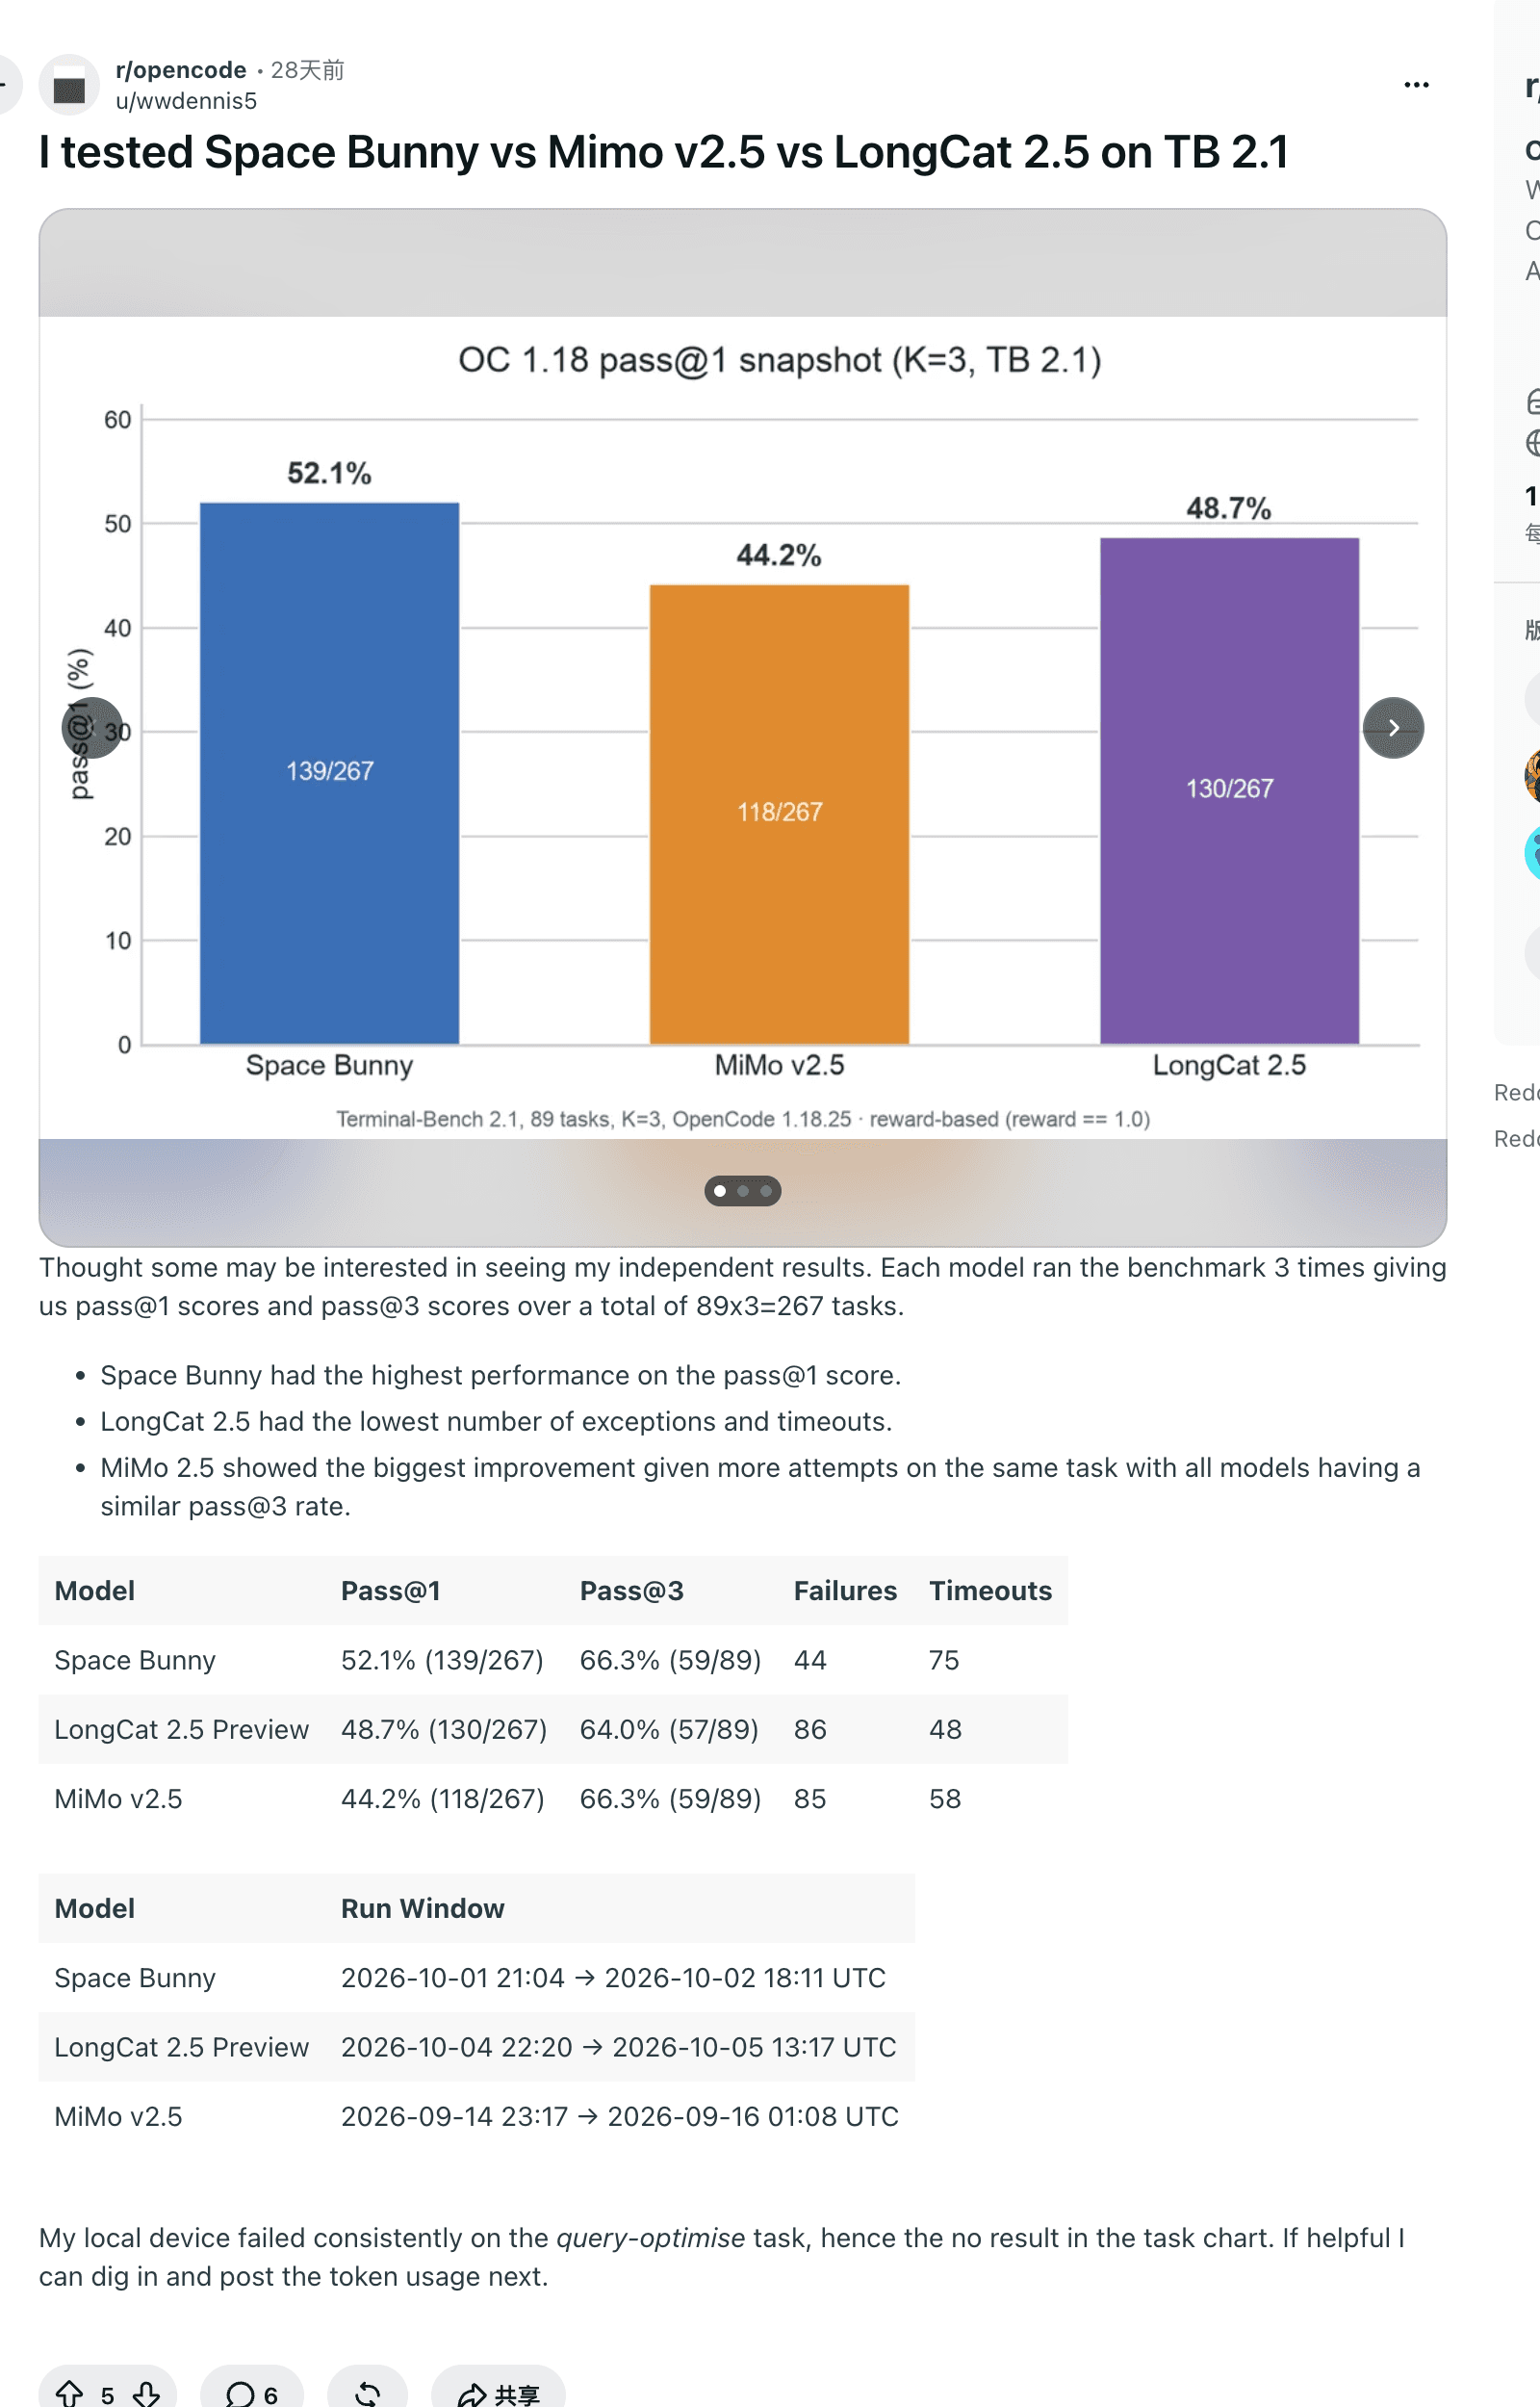
另一位用户报告了 Terminal-Bench 2.1 测试:89 个任务,每个模型各运行三次,LongCat 2.5 Preview 的 pass@1 为 130/267,即 48.7%。测试没有包含 DeepSeek V4 Pro,作者也说明一个任务受本机故障影响,因此它不是两者的直接对比。(测试原帖)
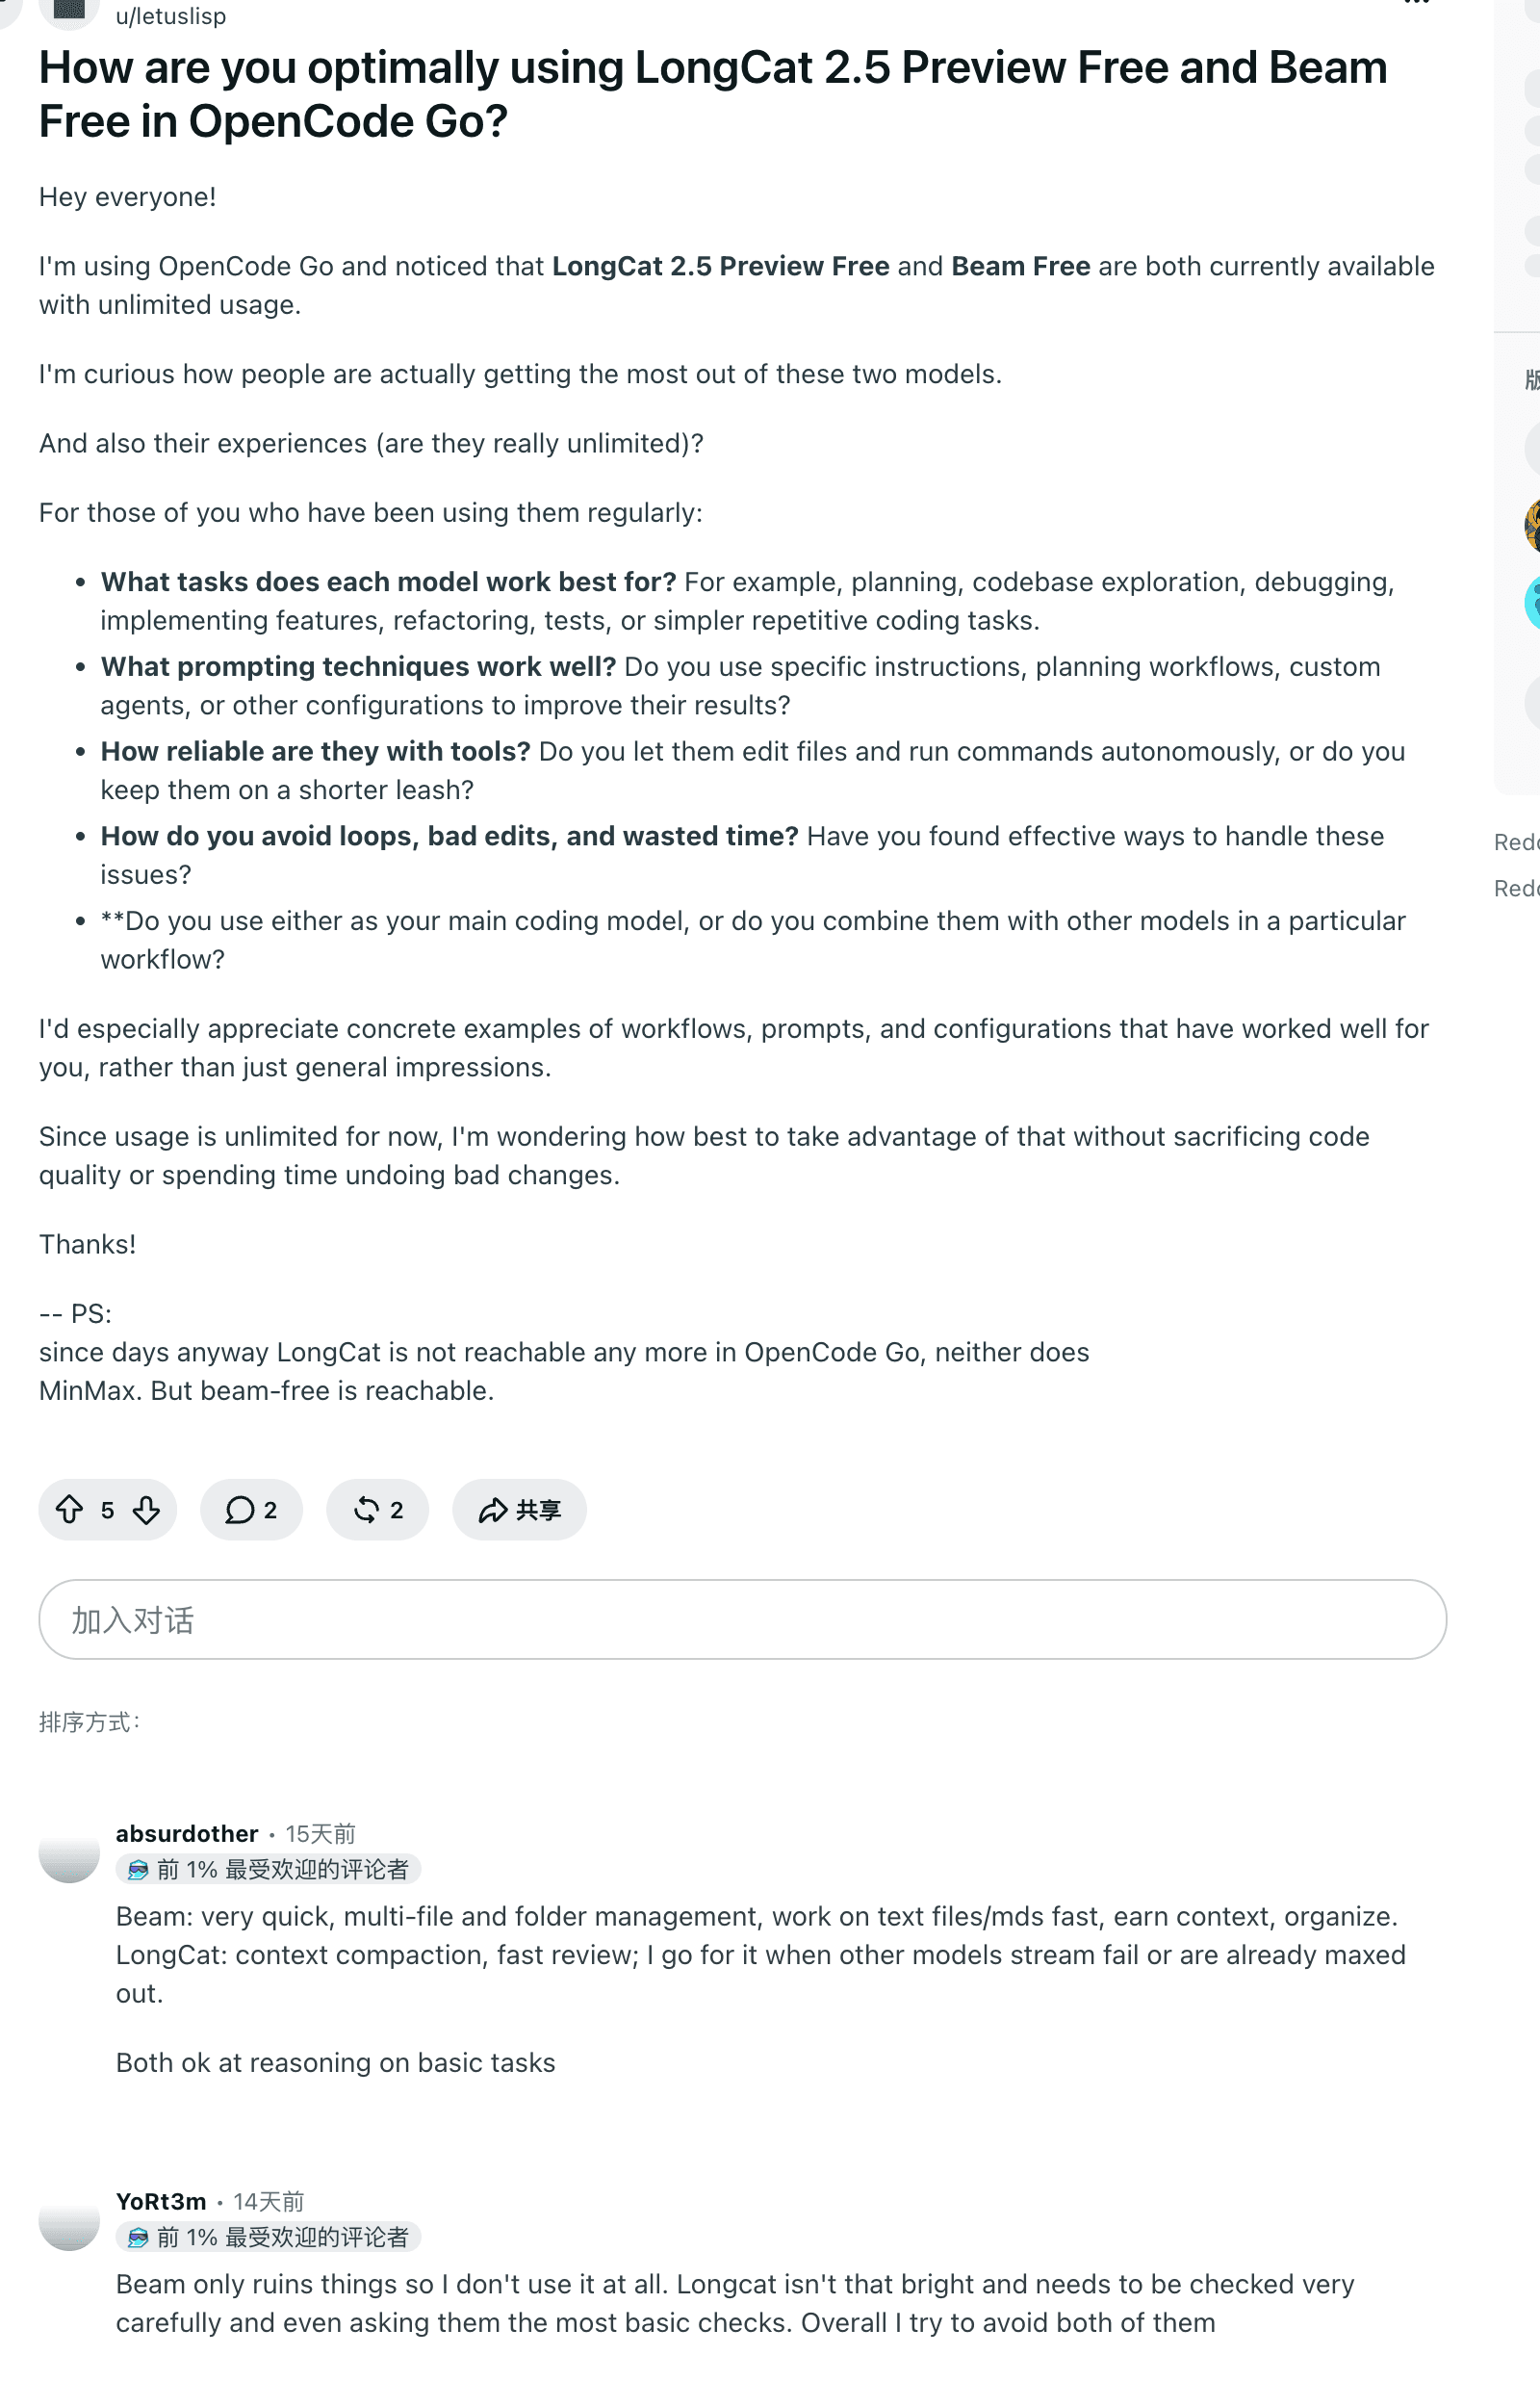
在另一条 OpenCode 讨论中,一位用户用 Preview 做上下文压缩和快速审查,另一位认为输出需要仔细检查。两条评论都不能得出成功率。更稳妥的试用方式是先限定任务范围,审查修改,再运行测试。
API 价格:算完成任务的成本
下表使用 2026 年 11 月 3 日核对的官方 API 美元价格,每项单位均为每百万 token。LongCat 标注限时优惠,DeepSeek 区分峰谷;第三方平台、订阅和 Tabbit 的费用另计。
| 计费项 | LongCat 2.5 限时价 | DeepSeek V4 Pro 非峰时 | DeepSeek V4 Pro 峰时 |
|---|---|---|---|
| 未缓存输入 | $0.30 | $0.66 | $1.32 |
| 缓存输入 | $0.006 | $0.022 | $0.044 |
| 输出 | $1.20 | $1.98 | $3.96 |
DeepSeek 的峰时是工作日 UTC 01:00–04:00 和 06:00–10:00,中国法定节假日除外;其他时间为非峰时。预算前应重新核对 DeepSeek 和 LongCat 的实时价格。
假设一次任务使用 100 万未缓存输入和 25 万输出 token,不考虑缓存或工具费:
LongCat:          1 × $0.30 + 0.25 × $1.20 = $0.60
DeepSeek 非峰时:  1 × $0.66 + 0.25 × $1.98 = $1.155
DeepSeek 峰时:    1 × $1.32 + 0.25 × $3.96 = $2.31
算例假设两者用量一致且一次完成。输出更多或需要重试时,每个合格结果的成本就会改变。图片处理、工具、税费、优惠和不同供应商的计费也可能影响账单。DeepSeek 的 Search 和 Fetch 另按请求计费,不能当作 token 费率的一部分。
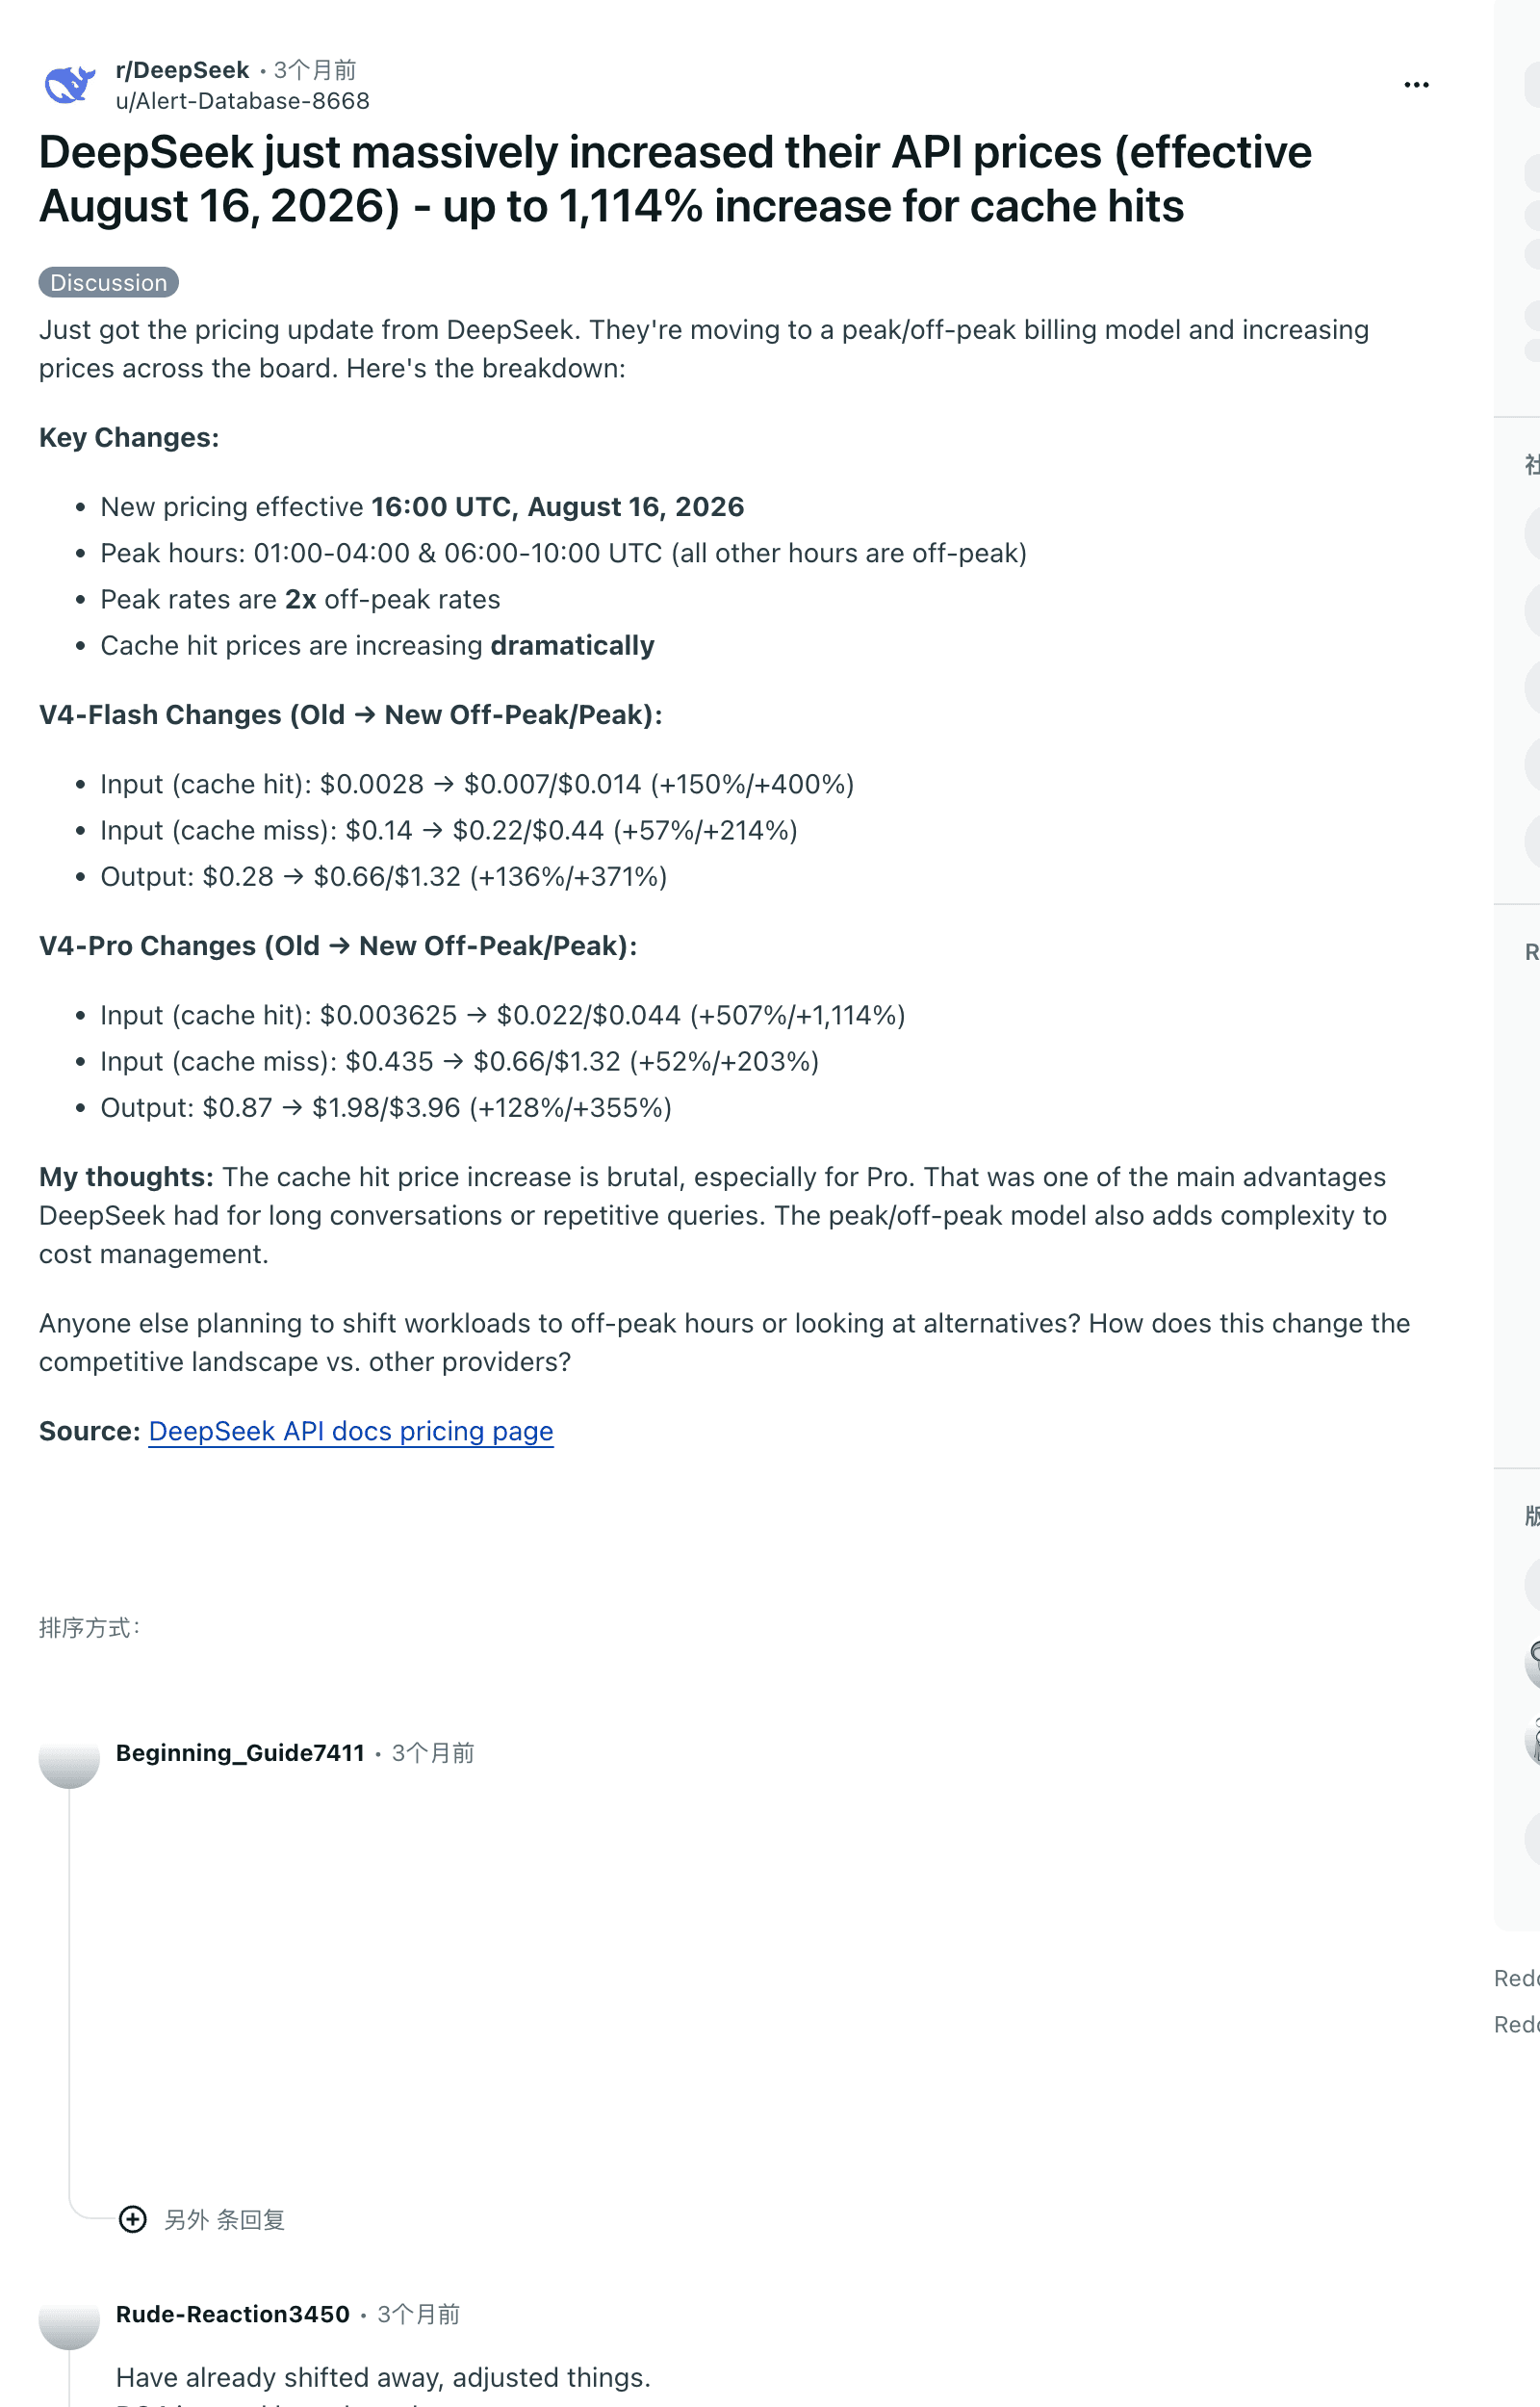
一条 Reddit 讨论展示了为什么要单列缓存价格:用户担心 Pro 缓存涨价影响长对话。该帖是对历史变化的反应,当前价格仍应以官方页面为准。
在自己的环境中测试
对每个模型使用相同的代码仓库版本、任务描述、工具、权限和停止条件,并分别从干净副本开始。记录供应商、模型 ID、日期、推理设置、token 用量以及测试是否通过。除了最终回答,还要检查代码 diff。
第一个任务可以选一个有失败测试的小 bug:要求 Agent 解释失败原因、做最小修改并运行现有测试。检查它是否改了无关文件、重复调用工具,以及测试能否独立通过。重复多个有代表性的任务后再推广结论;一次成功不能说明可靠率。
如果比较视觉任务,可将 LongCat 的直接截图输入,与独立识图后交给 V4 Pro 的流程对照。这比较的是完整工作流,不是纯模型能力;应记录额外步骤和成本。延伸阅读:什么是 AI Agent、Agent 浏览器和浏览器自动化。
用 Tabbit 整理对比资料
Tabbit Browser 可以把官方文档和测试结果放在一起查看。打开 LongCat 价格、视觉文档与 DeepSeek API 价格页,将标签分组,再让侧栏总结各自限制。预算前仍要回到原页面核实数字。Tabbit 指南介绍了相关浏览器工作流。
11 月 3 日,我们在 Tabbit Dev 中分别创建两个 Chat 对话,使用相同的合成费用计算题,每个模型运行一次,未引用文件。界面分别显示 LongCat-2.5 和 DeepSeek-V4-Pro;两者都得到预期的 $0.7824,并列出分项。当前账号的两次回答均为中文。回答中提到的进位和最低消费只是可能性,未核实为供应商实际计费规则。
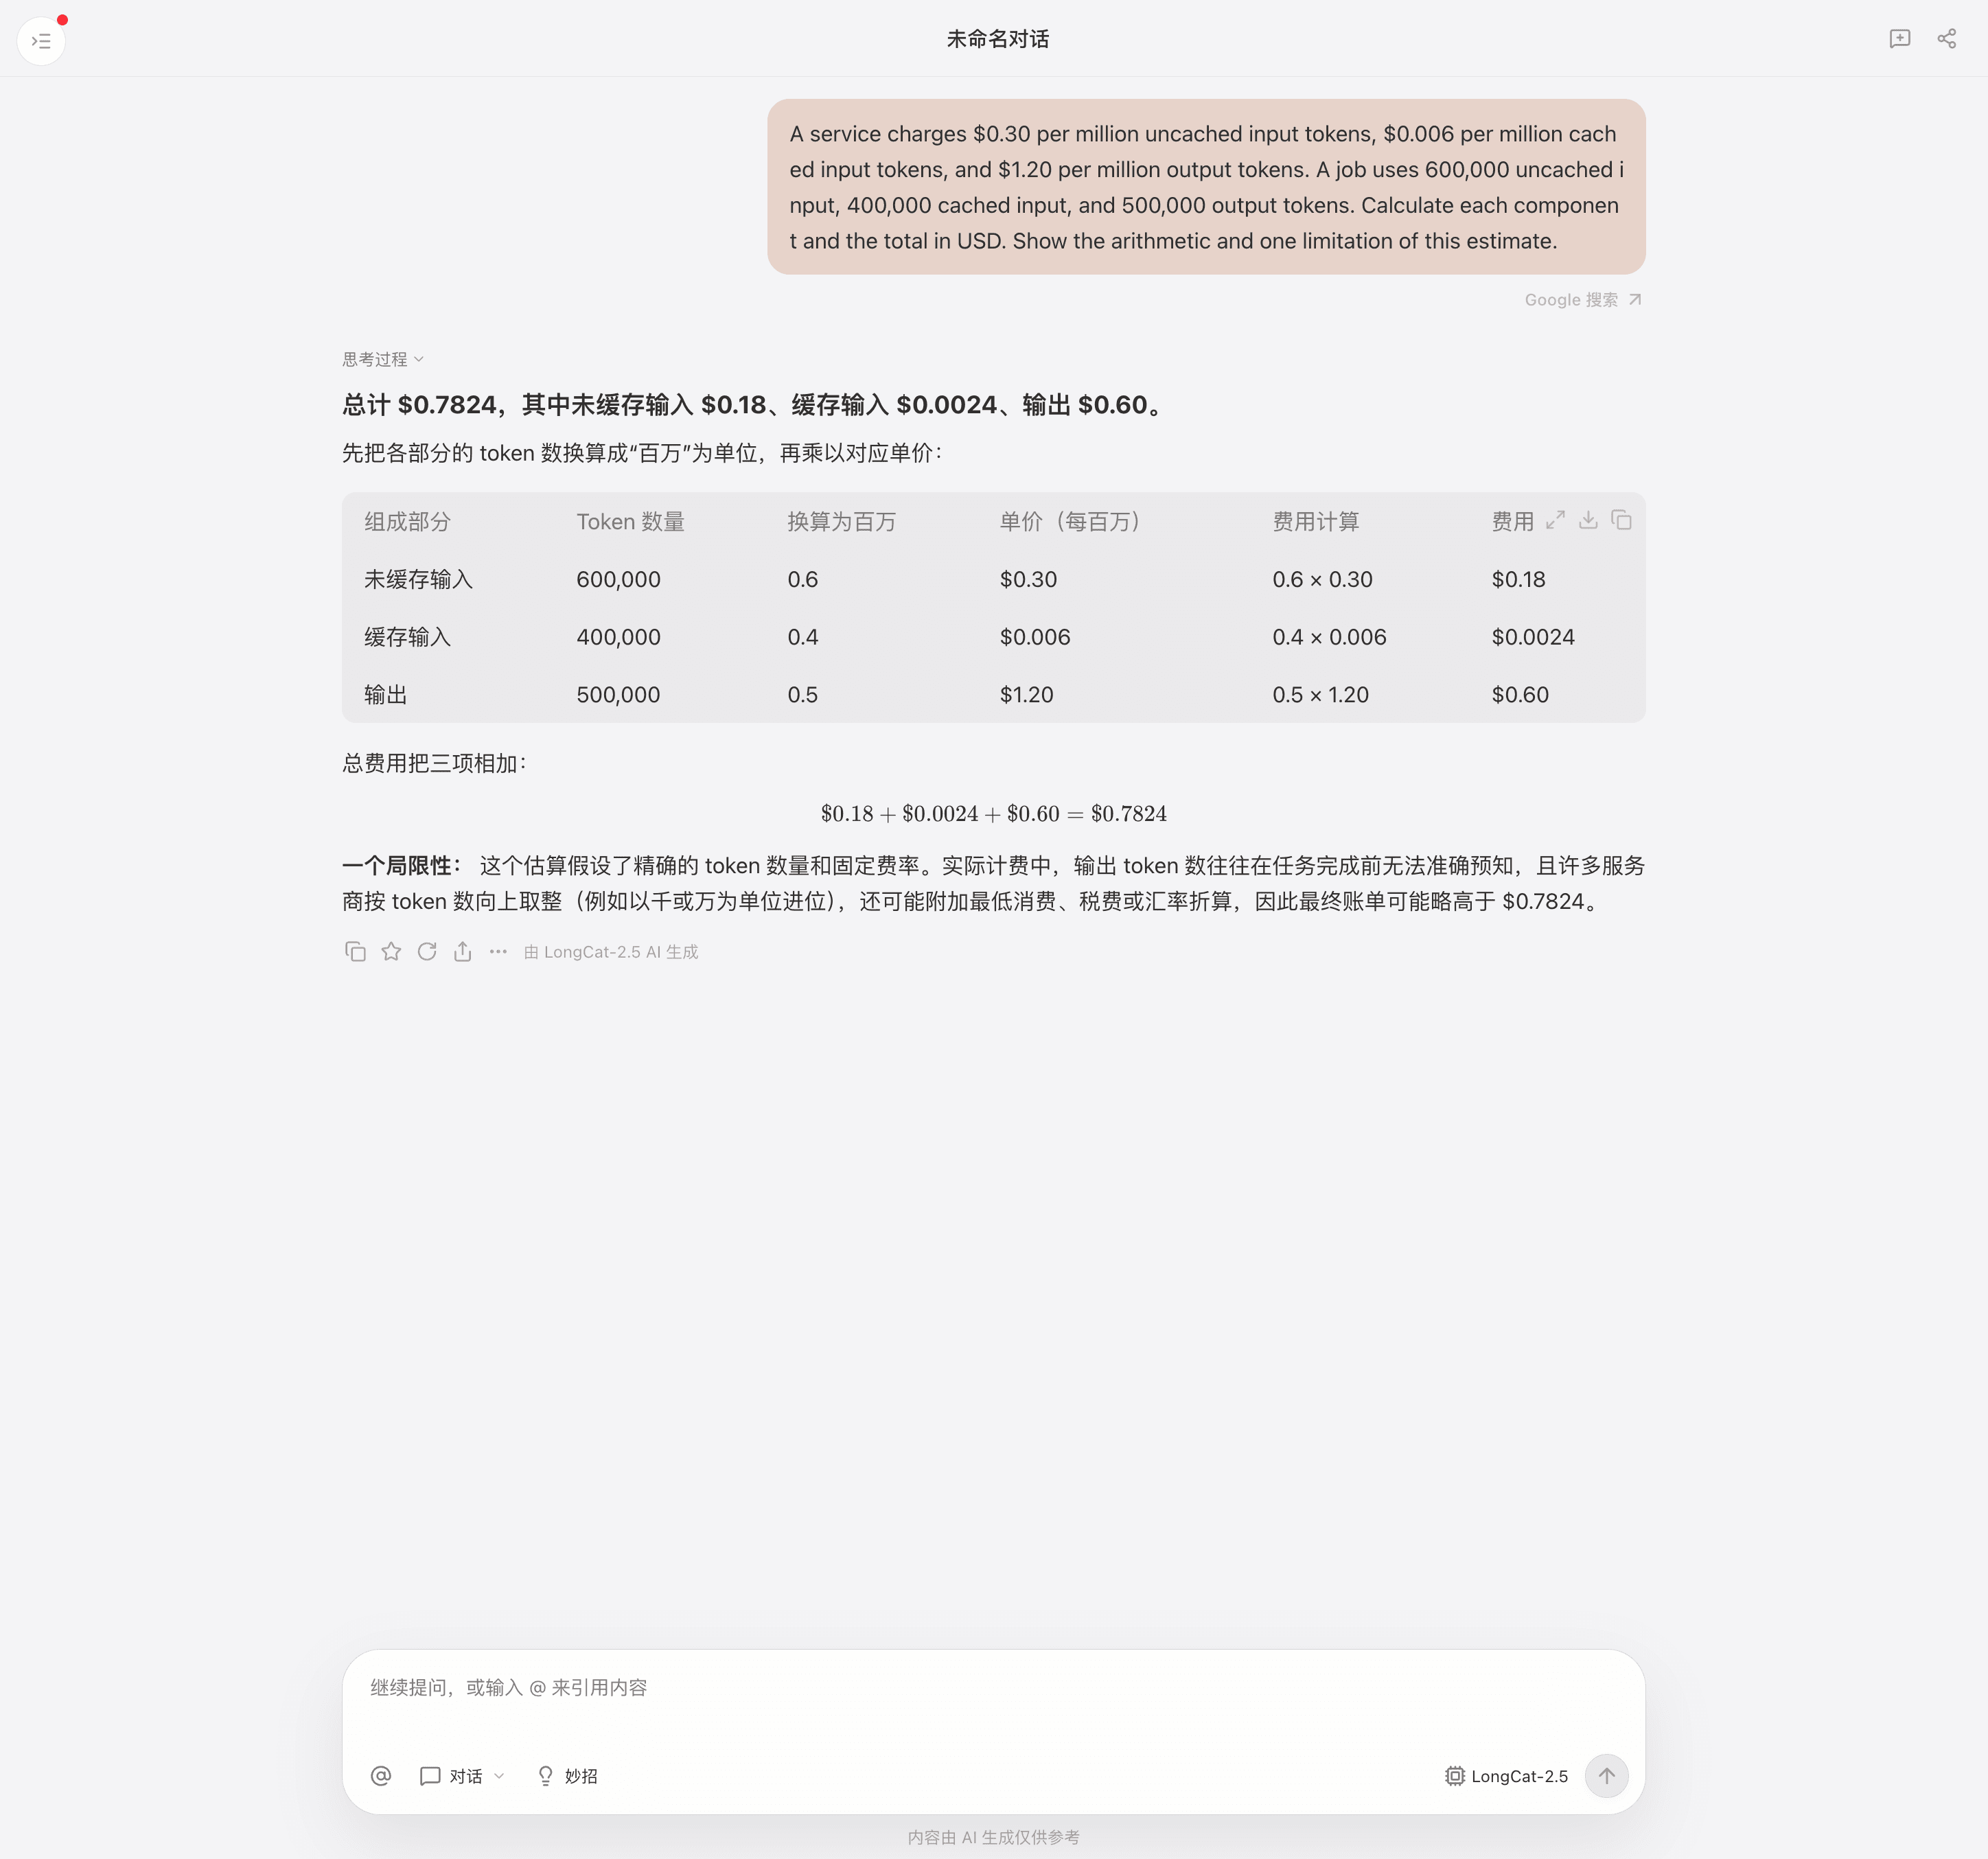
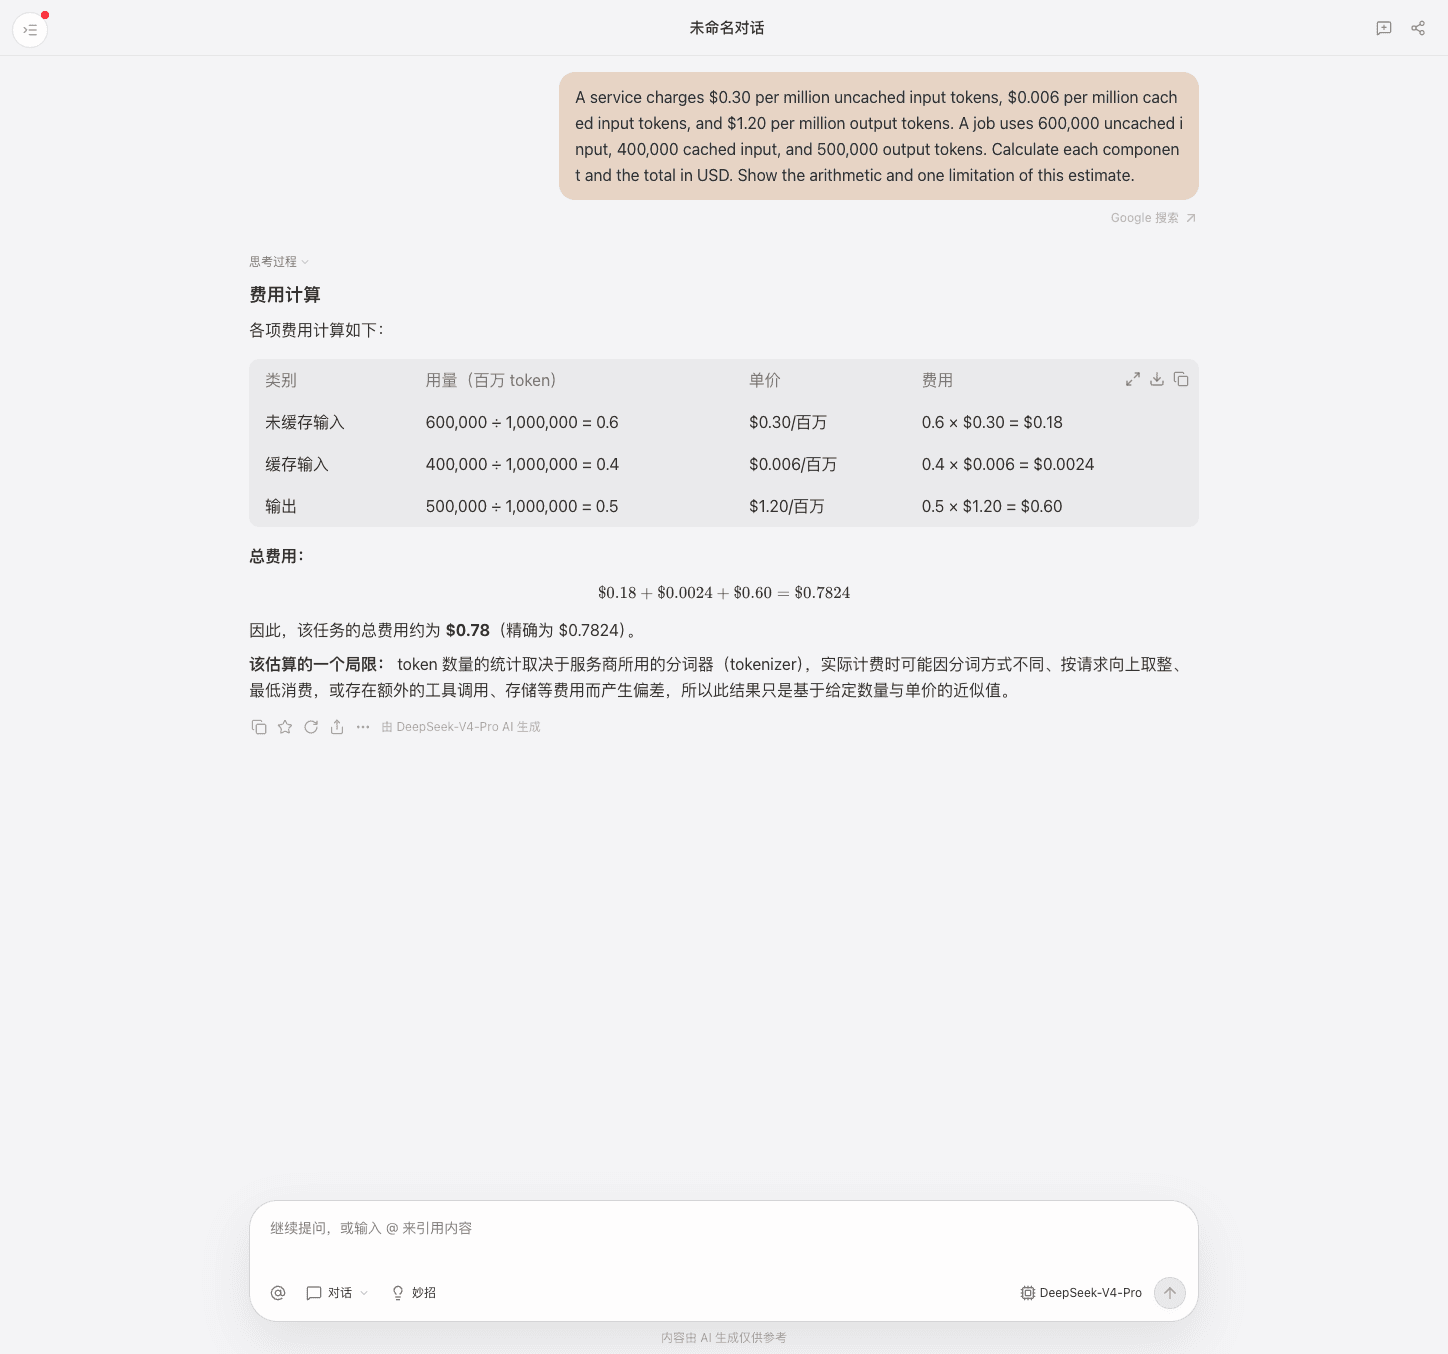
每个模型只有一次样本,不能衡量编程、视觉、速度或可靠性。界面显示了模型名称,但没有提供后端精确版本或推理配置。模型、额度和费用以使用账号的实时情况为准;客户端选择可参考 AI 浏览器对比。
 Tabbit Browser
最后怎么选?
| 你的约束 | 建议起点 | 决定前检查 |
|---|---|---|
| 需要直接输入截图或视频 | LongCat 2.5 | 文件格式、隐私条款和实际输出质量。 |
| 必须自己部署开放权重 | DeepSeek V4 Pro | 硬件、推理框架、许可证和部署成本。 |
| 优先考虑当前官方 API 单价 | LongCat 2.5 | 优惠期限、缓存、重试与总 token。 |
| 纯文本代码 Agent | 两者都测 | 相同代码库、工具、推理设置、预算和验收测试。 |
| 已接入 DeepSeek | V4 Pro 可能减少迁移工作 | 当前接口、供应商、峰谷时段和视觉步骤。 |
视觉输入和当前限时价格是 LongCat 的明确优势;必须使用开放权重时先考虑 V4 Pro。对于自主编码,在迁移生产流量前,用相同任务计算合格结果的成本。Tabbit 可以帮助整理文档与测试,但仍需核对目标账号的实时模型列表。

常见问题
LongCat 2.5 和 DeepSeek V4 Pro 怎么选?
需要直接输入图片或视频,或者更关注当前官方 API 费率时,可以先试 LongCat 2.5。如果需要自行部署已公开的权重,或自己的文本任务测试证明 Pro 值得更高成本,可以选 DeepSeek V4 Pro。同条件测试不足以证明谁在所有任务上更强。
DeepSeek V4 Pro 能识别图片吗?
DeepSeek 当前官方 API 价格页将 V4 Pro 的视觉输入列为不支持。LongCat 官方文档则说明 LongCat 2.5 可以接收图片和视频。
LongCat 2.5 比 DeepSeek V4 Pro 便宜吗?
截至 2026 年 11 月 3 日,LongCat 的官方限时价在未缓存输入、缓存输入和输出三项上均低于 V4 Pro 官方峰时及非峰时价格。实际任务成本还取决于 token 用量、重试、工具和服务商。
这两个模型可以自己部署吗?
DeepSeek 已按 MIT 许可证发布 V4 Pro 权重。LongCat 2.5 发布资料标注权重即将推出,规划部署前应查看官方仓库是否更新以及适用的许可证。
两个模型的上下文都是一百万 token 吗?
DeepSeek 官方 API 为 V4 Pro 标注 1M 上下文,LongCat 文档为 2.5 标注 1,048,576 token。上下文上限相同不代表模型在整个窗口内的检索准确率相同。
预览版反馈能代表 LongCat 2.5 正式版吗?
不能直接代表。预览版用户既报告过有用的窄范围工作流,也报告过循环和不相关修改。这些反馈涉及特定版本与工具,应在自己的环境中测试正式版。